Les avatars parlants exigeaient autrefois un studio de production, un acteur réel et une équipe de postproduction. Aujourd’hui, vous pouvez prendre une photo générée par IA, lui donner un extrait vocal et obtenir un avatar parlant convaincant en moins de deux minutes. La barrière est tombée très vite. Ce qui surprend le plus, c’est le nombre de ces outils qui sont totalement gratuits ou accessibles via des offres gratuites, et l’écart de qualité entre les versions gratuites et payantes s’est nettement réduit en 2027. Cet article détaille le flux de travail exact, les modèles gratuits les plus performants et les erreurs à éviter avant de perdre du temps avec une mauvaise entrée.
Pourquoi les avatars parlants sont partout en ce moment
La multiplication des contenus avec avatars parlants n’a rien d’un hasard. Trois évolutions se sont produites en même temps : les générateurs d’images IA sont devenus assez performants pour produire des portraits humains crédibles, les modèles de synthèse vocale ont commencé à sonner véritablement humains, et l’IA de synchronisation labiale a appris à associer l’audio aux mouvements du visage avec une précision image par image. Ensemble, ces trois avancées permettent de créer une vidéo complète de personne qui parle à partir d’une seule photo et d’un script texte, entièrement gratuitement, dans un navigateur.
Les cas d’usage réels
Les cas d’usage concrets sont plus variés que ce que la plupart des gens imaginent :
- Contenus pour les réseaux sociaux où un personnage virtuel cohérent raconte les vidéos sans montrer un visage réel
- E-learning où un avatar formateur qui parle diffuse le contenu de cours dans n’importe quelle langue
- Vidéos marketing qui ont besoin d’un porte-parole sans en embaucher un
- Doublage multilingue où un avatar issu d’une photo prononce une piste doublée avec des mouvements de lèvres correspondants
- Image de marque personnelle pour les créateurs qui veulent une version IA stylisée d’eux-mêmes à l’écran
- Vidéos explicatives pour les startups qui ont besoin d’une vidéo professionnelle avec un budget nul
💡 Le cas d’usage le plus pratique aujourd’hui : associer un portrait IA de haute qualité à une voix clonée ou synthétique pour produire des vidéos explicatives dans n’importe quelle langue, à coût zéro. Le résultat est indiscernable d’un extrait de porte-parole enregistré par un professionnel lorsqu’on le regarde de loin, comme on le fait d’ordinaire.
Ce qui rend un avatar convaincant
Trois facteurs distinguent un avatar parlant convaincant d’un faux évident :
- Qualité audio : un son compressé avec des artefacts brise l’illusion immédiatement. La voix doit sonner véritablement humaine, et non synthétique.
- Précision des contours des lèvres : la forme de la bouche doit correspondre au phonème, sans simplement s’en approcher. Des formes de bouche floues ou approximatives paraissent fausses, même aux spectateurs qui ne sauraient pas expliquer pourquoi.
- Micro-mouvements des yeux et de la tête : des yeux totalement figés paraissent non naturels. Les modèles qui ajoutent des clignements subtils et un léger balancement de la tête font disparaître rapidement l’effet de vallée de l’étrange.
Les meilleurs outils gratuits disponibles en 2027 maîtrisent bien ces trois critères. La question est de savoir lesquels utiliser en premier.
Étape 1 : créer la voix
Avant toute synchronisation labiale, il vous faut de l’audio. La qualité de cet audio détermine le plafond du résultat final. Une voix trouble ou robotique produira un avatar trouble ou robotique, quelle que soit la qualité du modèle de synchronisation labiale. C’est l’étape à laquelle les débutants consacrent le moins de temps, et cela se voit dans le résultat.
Modèles TTS gratuits qui sonnent vraiment humains
PicassoIA héberge plusieurs modèles de synthèse vocale qui produisent un audio suffisamment convaincant pour alimenter un flux de synchronisation labiale. Voici ceux qui valent la peine d’être utilisés spécifiquement pour les avatars parlants :
ElevenLabs v3 est le benchmark actuel pour la synthèse vocale expressive. Il gère mieux que tout concurrent de sa catégorie l’étendue émotionnelle, les variations de rythme et les hésitations naturelles. Si le script a la moindre charge émotionnelle, c’est par là qu’il faut commencer. Le modèle respecte aussi la ponctuation comme le ferait un locuteur humain, avec des pauses naturelles aux virgules et des pauses un peu plus longues aux points, plutôt qu’une diction plate et métronomique.
MiniMax Speech 2.8 HD produit une sortie de qualité studio avec une synthèse plus rapide que le temps réel. La texture de la voix est dense et chaleureuse, loin de la qualité fine et légèrement creuse qui trahit les modèles moins chers. Il gère les scripts longs sans la dérive que l’on remarque parfois vers la deuxième minute, où le rythme des phrases commence à s’aplatir. Pour les contenus d’entreprise ou pédagogiques, c’est l’option au rendu le plus professionnel à coût zéro.
Resemble AI Chatterbox est la meilleure option si vous voulez contrôler l’émotion tout en clonant une voix. Vous pouvez fournir un extrait de référence de n’importe quelle voix, et Chatterbox le clonera avec son intonation émotionnelle intacte. C’est utile pour créer un avatar parlant qui ressemble à une personne précise, à la voix d’une marque ou même à un personnage fictif doté d’une personnalité vocale définie. Le curseur de contrôle émotionnel est une fonctionnalité que la plupart des modèles gratuits concurrents n’offrent pas.
Qwen3 TTS est le joker de la liste. Plutôt que de cloner des voix existantes, il peut concevoir des voix entièrement nouvelles à partir d’une description textuelle, et il gère bien les cadences non standard. Il convient aux personnages fictifs ou aux avatars qui ont besoin d’une signature vocale distinctive et légèrement inhabituelle, qu’aucun humain réel ne possède.
ElevenLabs Flash v2.5 est l’option optimisée pour la vitesse, lorsque vous avez besoin d’itérer rapidement. Si vous testez plusieurs scripts ou ajustez la diction, le temps de rendu plus court vous permet d’essayer des options sans attendre.
| Modèle | Idéal pour | Clonage vocal | Langues |
|---|
| ElevenLabs v3 | Narration expressive | Oui | 30+ |
| MiniMax Speech 2.8 HD | Longs scripts de qualité studio | Non | Multiples |
| Chatterbox | Clonage à contrôle émotionnel | Oui | Principalement anglais |
| Qwen3 TTS | Conception de voix originales | Oui | Multiples |
| ElevenLabs Flash v2.5 | Itération rapide et tests | Oui | 32 |
Le format de sortie compte : la plupart des modèles de synchronisation labiale attendent un fichier WAV ou MP3 propre, avec un minimum de bruit de fond. Générez d’abord l’audio, écoutez-le, puis coupez les silences au début et à la fin avant de l’importer à l’étape de synchronisation labiale. Un silence en début de fichier audio fait démarrer les modèles de synchronisation labiale avec une bouche fermée et figée, qui ressemble à un chargement bloqué.
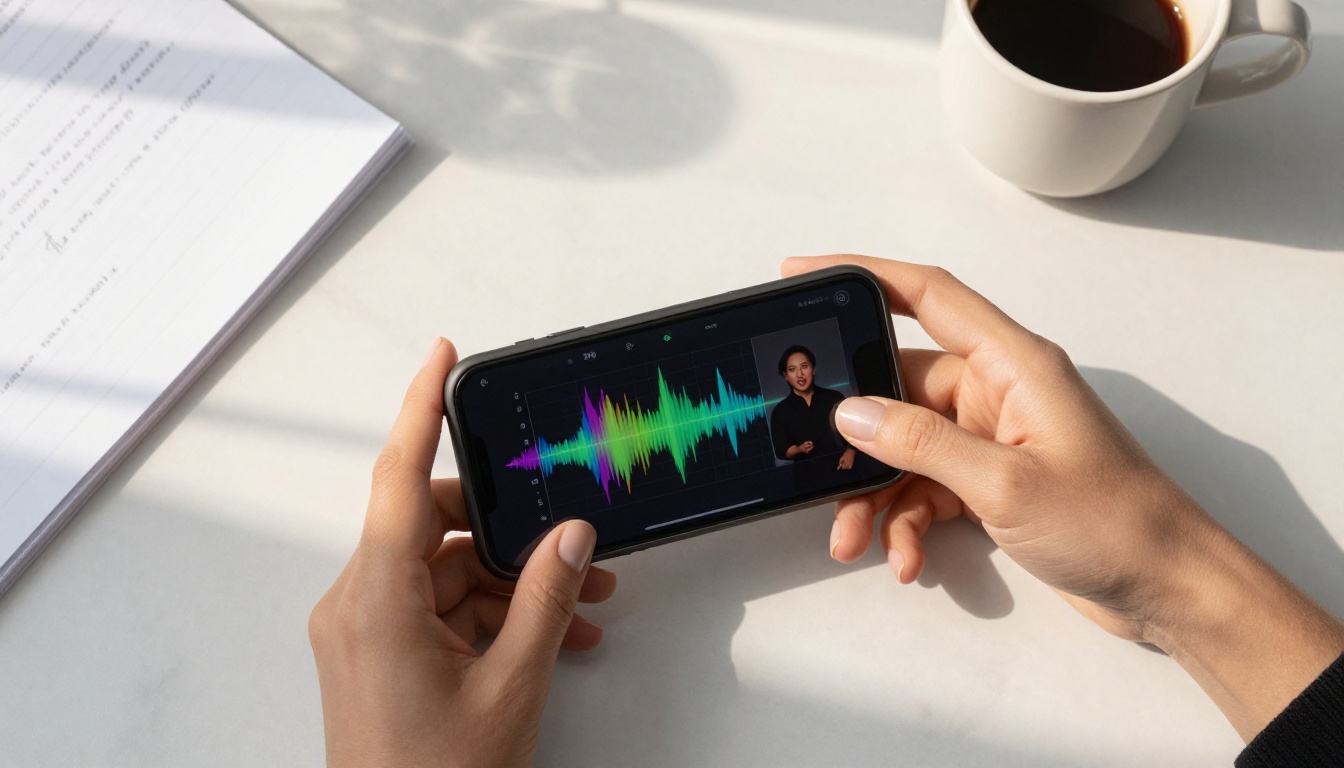
Étape 2 : synchroniser la voix sur un visage
La synchronisation labiale par IA prend deux entrées : un visage (image fixe ou courte vidéo) et un fichier audio. Elle produit une vidéo de ce visage qui parle en synchronisation avec l’audio. Le défi technique consiste à faire correspondre la forme de la bouche à chaque image au phonème correspondant de la piste audio, avec assez de régularité pour que le résultat passe pour une parole humaine naturelle.
Ce que fait réellement la synchronisation labiale par IA
Les modèles de synchronisation labiale modernes utilisent des réseaux de correspondance audio-visuelle entraînés sur des milliers d’heures de séquences de visages qui parlent. Ils prédisent la forme exacte de la bouche, la position de la mâchoire et la visibilité des dents pour chaque image audio, puis composent ce résultat sur le visage source en préservant les traits environnants et les conditions d’éclairage.
Les meilleurs modèles gèrent aussi :
- L’occlusion (cheveux ou mains partiellement devant la bouche dans l’image source)
- La cohérence de l’éclairage (pour que la zone animée de la bouche corresponde à la couleur et à la luminosité du reste du visage)
- Les mouvements de tête (hochements et inclinaisons subtils qui suivent le rythme de la parole au lieu de rester figés comme un robot)
- Le clignement (insertion automatique de clignements pour éviter l’effet de regard vide qui paraît aussitôt artificiel)
Les meilleurs modèles de synchronisation labiale gratuits sur PicassoIA
PicassoIA héberge 12 modèles de synchronisation labiale sur sa plateforme. Tous ne conviennent pas à une entrée de photo IA, car certains sont conçus pour le doublage vidéo plutôt que pour l’animation de portraits fixes. Les modèles ci-dessous sont les plus performants spécifiquement pour transformer un portrait IA fixe en avatar parlant.
Omni Human 1.5
Omni Human 1.5 by ByteDance est actuellement le modèle le plus performant dans cette catégorie. Il accepte un seul portrait photo et n’importe quel extrait audio, et produit une vidéo avec une synchronisation labiale précise, des mouvements de tête naturels et des micro-expressions qui donnent au résultat une véritable impression de vie. Le modèle a été spécialement conçu pour l’animation réaliste de photos, et non seulement pour le doublage vidéo, ce qui constitue la distinction essentielle.
Ce qui le distingue des anciens modèles, c’est qu’il ne produit pas cet effet d’animation de la seule bouche où tout le reste du visage paraît figé. Tout le visage participe à la parole. Les mouvements des sourcils, la tension de la mâchoire et l’activité subtile des joues réagissent à l’audio d’une façon que les modèles précédents ne produisaient tout simplement pas.
Son prédécesseur, Omni Human, vaut toujours le détour pour les clips courts où un mouvement un peu plus stylisé convient mieux à l’esthétique.
P Video Avatar
P Video Avatar by PrunaAI est optimisé pour la vitesse sans sacrifier trop de qualité. C’est le choix pratique lorsque vous devez produire plusieurs clips d’avatar au cours d’une même session plutôt qu’un seul rendu parfait. La précision de la synchronisation labiale est solide sur les portraits de face, ce qui correspond exactement au résultat que produit la plupart des générateurs d’images IA.
Fabric 1.0
Fabric 1.0 by VEED aborde le défi de faire parler des photos avec une attention particulière portée aux dents et à la région intérieure de la bouche. Beaucoup de modèles de synchronisation labiale produisent une tache sombre et floue là où devraient se trouver les dents. Fabric 1.0 génère une véritable géométrie dentaire en fonction du phonème audio, ce qui constitue une différence de qualité perceptible sur les gros plans où la bouche occupe une grande partie de l’image.
Kling Lip Sync
Kling Lip Sync by KwaiVGI est la meilleure option pour un audio non anglais. Si la voix générée à l’étape 1 est dans une langue aux combinaisons de phonèmes inhabituelles, Kling gère la géométrie de la bouche avec plus de précision que les modèles entraînés majoritairement sur l’anglais. Il est aussi performant pour l’anglais avec accent, lorsque les schémas d’accentuation diffèrent de l’anglais américain ou britannique standard.
React 1 et Lipsync 2 Pro
React 1 by Sync est conçu spécifiquement pour ajouter une synchronisation labiale réaliste à des contenus vidéo existants, mais il fonctionne tout aussi bien sur des photos animées. C’est le modèle le plus précis pour les groupes de consonnes denses et la parole très rapide.
Lipsync 2 Pro by Sync est le palier de raffinement au-dessus de Lipsync 2, avec une précision améliorée sur les contours des lèvres, ce qui réduit l’artefact de fantôme qui apparaît parfois au bord de la bouche lors des consonnes occlusives.
💡 Pour obtenir le résultat de meilleure qualité sur un portrait IA de face, le flux de travail est le suivant : générez l’audio avec ElevenLabs v3, puis transmettez-le à Omni Human 1.5. Cette combinaison surpasse systématiquement toutes les autres associations gratuites pour ce qui est du mouvement naturel et de la précision labiale.
Modèles de vidéo d’avatar parlant à essayer
Au-delà de la catégorie dédiée à la synchronisation labiale, PicassoIA héberge plusieurs modèles de génération vidéo spécialement conçus pour créer des avatars. Ils fonctionnent différemment : au lieu de synchroniser un audio sur une photo fixe, ils génèrent une vidéo complète de personne qui parle à partir d’une seule image d’entrée et d’un prompt texte ou d’un extrait audio, le mouvement étant intégré au processus de génération plutôt qu’appliqué en post-traitement.
HeyGen Avatar V et Avatar IV
HeyGen Avatar V est conçu spécifiquement pour la génération de vidéos d’avatars parlants. Vous fournissez une photo et un script, et il produit une vidéo soignée de cette personne qui parle. Le résultat ressemble systématiquement à un contenu de porte-parole professionnel plutôt qu’à une synchronisation labiale brute, avec un contact visuel naturel, un balancement de tête maîtrisé et une composition propre de la bouche.
HeyGen Avatar IV est la génération précédente, mais il gère mieux certaines conditions d’éclairage, en particulier les éclairages très contrastés ou dramatiques sur la photo source, où le modèle plus récent lisse parfois trop l’image.
Kling Avatar v2
Kling Avatar v2 by KwaiVGI anime n’importe quel visage en une vidéo avec une forte fidélité du mouvement. Il excelle particulièrement à préserver l’identité visuelle exacte d’un visage généré par IA, ce qui peut être un défi avec les modèles qui appliquent leur propre biais esthétique pendant la génération et modifient subtilement l’apparence du personnage d’une image à l’autre.
Dreamactor M2.0
Dreamactor M2.0 by ByteDance pousse plus loin l’animation de personnages en prenant en charge des personnages non standard, y compris les visages stylisés ou partiellement idéalisés. Si la photo IA de départ présente des traits exagérés ou accentués, Dreamactor gère l’animation plus élégamment que les modèles de synchronisation labiale standard, entraînés principalement sur des photographies naturalistes.
Comme Omni Human 1.5 est l’outil gratuit le plus performant pour cette tâche précise, voici le flux de travail exact pour passer d’un portrait IA brut à une vidéo d’avatar parlant finalisée.
Préparer l’image source
La photo source doit présenter un visage clairement visible, les yeux ouverts et la bouche dans une position neutre ou légèrement entrouverte. Les profils et les angles extrêmes donnent des résultats plus faibles. L’entrée idéale est un portrait de face ou aux trois quarts, avec un éclairage uniforme et sans filtre de beauté appuyé.
Si vous n’en avez pas, générez un portrait avec n’importe quel modèle d’image sur PicassoIA, puis recadrez étroitement sur le visage avant de l’importer dans Omni Human 1.5. Plus le recadrage est serré, plus la géométrie labiale tend à être précise, car le modèle n’a pas à résoudre de fins détails spatiaux sur un cadre large.
Générer l’audio
Rendez-vous sur ElevenLabs v3 sur PicassoIA. Saisissez le script que vous voulez faire dire à l’avatar. Choisissez une voix qui correspond au caractère de votre portrait. Téléchargez le fichier MP3 généré.
Écoutez l’intégralité du résultat avant de continuer. Vérifiez :
- les pauses anormales aux signes de ponctuation qui créent un rythme irrégulier
- tout artefact robotique sur les consonnes dures comme T, K ou P
- les silences au début ou à la fin (à couper avant l’import)
Un fichier audio propre fait une différence mesurable sur la qualité de la synchronisation labiale.
Lancer la synchronisation labiale
Ouvrez Omni Human 1.5 sur PicassoIA :
- Importez la photo du portrait comme visage source
- Importez le fichier audio comme audio de pilotage
- Réglez la résolution sur 720p pour un bon équilibre entre qualité et vitesse de rendu
- Lancez la tâche
Le temps de rendu est généralement de 30 à 90 secondes selon la durée de l’audio. Le résultat est un fichier MP4 dans lequel le visage est entièrement animé pour correspondre à l’audio, mouvements de tête compris.
Affiner si nécessaire
Si le premier résultat présente des images floues ou des phonèmes mal synchronisés sur certains mots :
- Recoupez l’audio pour retirer le segment problématique, puis relancez
- Essayez Lipsync 2 Pro by Sync comme second passage sur le clip vidéo exporté
- Ajustez le rythme à l’étape de synthèse vocale pour que les syllabes accentuées tombent plus nettement sur les temps naturels de la parole
Gratuit ou payant : ce que vous obtenez vraiment
Une question revient souvent : les outils gratuits sont-ils vraiment utilisables, ou l’offre gratuite n’est-elle qu’un aperçu destiné à vous pousser vers un abonnement ? La réponse honnête en 2025 : l’offre gratuite de la plupart de ces modèles produit des résultats publiables. Les offres payantes ajoutent :
| Fonctionnalité | Offre gratuite | Offre payante |
|---|
| Résolution | Jusqu’à 720p en général | 1080p+ |
| Durée du clip | 15 à 30 secondes | 2+ minutes |
| Tâches simultanées | 1 à la fois | Multiples |
| Filigrane | Parfois présent | Supprimé |
| Priorité dans la file | Standard | Plus rapide |
| Clonage vocal personnalisé | Générations limitées | Accès complet |
Pour la plupart des cas d’usage, le 720p et les clips de 30 secondes suffisent largement. Un clip pour les réseaux sociaux, une courte démo ou une vidéo explicative de produit n’ont pas besoin de davantage. Une vidéo de cours complète ou une série avec un porte-parole professionnel est le moment où l’offre payante commence à se justifier économiquement.
💡 Construisez d’abord le flux de travail avec des outils gratuits. Vérifiez que le résultat répond à vos exigences, puis décidez si une version payante se justifie pour le volume dont vous avez besoin. La plupart des personnes qui commencent par le payant découvrent qu’elles devaient de toute façon corriger quelque chose dans leur flux de travail d’entrée.
4 erreurs qui gâchent le résultat
Même avec les bons outils, certains choix de départ donnent systématiquement de mauvais résultats. Voici les plus courants :
1. Utiliser une photo source fortement filtrée ou retouchée. Les filtres de lissage de la peau et les retouches de beauté créent des surfaces qui paraissent fausses lorsque le modèle de synchronisation génère les mouvements de la bouche. La composition se brise au bord de la zone animée. Une texture de peau naturelle se fond bien mieux.
2. Du bruit de fond dans l’audio. Un bourdonnement ambiant, le bruit d’une climatisation ou la réverbération dans la sortie de synthèse vocale seront audibles dans la vidéo finale et peuvent aussi perturber la détection des phonèmes. Regénérez l’audio en une passe propre ou appliquez une réduction de bruit avant l’import.
3. Une durée qui ne correspond pas. Si l’audio dure 60 secondes mais que la vidéo source n’en dure que 10, le modèle doit répéter la source en mosaïque, ce qui crée des coutures visibles et des répétitions qui paraissent artificielles. Adaptez la durée de la source à celle de l’audio avant de lancer le traitement, ou utilisez une photo fixe comme source pour ne subir aucune contrainte de durée.
4. Les portraits de profil. Les modèles de synchronisation labiale doivent voir les deux côtés de la bouche pour générer une géométrie phonémique précise. Les profils produisent des mouvements de bouche asymétriques ou flous. Les vues de face ou aux trois quarts donnent systématiquement de meilleurs résultats sur tous les modèles testés.
Créez votre premier avatar parlant sur PicassoIA
Tout ce qui est décrit dans cet article est disponible dès maintenant sur PicassoIA, sans compte nécessaire pour commencer à expérimenter. La plateforme réunit au même endroit tous les modèles mentionnés ici : Omni Human 1.5, ElevenLabs v3, HeyGen Avatar V, Kling Avatar v2, Fabric 1.0 et MiniMax Speech 2.8 HD.
Le moyen le plus rapide de commencer : prenez un portrait IA que vous avez déjà, rédigez un script de deux phrases, générez la voix avec MiniMax Speech 2.8 HD, puis déposez les deux fichiers dans Omni Human 1.5. Le processus complet prend environ cinq minutes. Le résultat vous indiquera immédiatement si la qualité répond à vos besoins, sans rien investir d’autre que du temps.
Si vous voulez comparer les modèles côte à côte, parcourez les catégories complètes de synchronisation labiale et de synthèse vocale sur picassoia.com/en/all-models et faites passer la même entrée dans trois modèles différents. Les écarts de qualité entre Omni Human 1.5, Fabric 1.0 et Kling Lip Sync sont réels, mais ils dépendent aussi du contexte. Le bon outil varie selon le type de portrait, la langue de l’audio et la résolution visée.
La barrière vers un avatar parlant soigné n’est plus votre budget, c’est votre script.


