Avatares falantes costumavam exigir um estúdio de produção, um ator de verdade e uma equipe de pós-produção. Agora você pode pegar uma foto gerada por IA, enviar um trecho de voz e ter um avatar falante convincente em menos de dois minutos. A barreira caiu rápido. O que surpreende a maioria das pessoas é quantas dessas ferramentas são totalmente gratuitas ou acessíveis por meio de planos gratuitos, e a diferença de qualidade entre o gratuito e o pago diminuiu muito em 2027. Este artigo mostra o passo a passo exato, os modelos gratuitos mais fortes e os erros que vale evitar antes de perder tempo com uma entrada ruim.
Por que os avatares falantes estão em toda parte agora
O aumento de conteúdo com avatares falantes não é por acaso. Três coisas convergiram ao mesmo tempo: os geradores de imagem por IA ficaram bons o suficiente para produzir retratos humanos verossímeis, os modelos de texto para fala começaram a soar genuinamente humanos e a IA de sincronização labial aprendeu a mapear áudio para movimentos faciais com precisão de quadro a quadro. Juntos, esses três avanços tornam possível criar um vídeo de cabeça falante completo a partir de uma única foto e de um roteiro de texto, totalmente de graça, direto no navegador.
Os casos de uso reais
Os casos de uso reais são mais amplos do que a maioria das pessoas imagina:
- Conteúdo para redes sociais, em que uma persona virtual consistente narra os vídeos sem mostrar um rosto real
- Ensino a distância, em que um avatar instrutor falante transmite o material do curso em qualquer idioma
- Vídeos de marketing que precisam de um porta-voz sem contratar um
- Dublagem multilíngue, em que um avatar baseado em foto fala uma faixa dublada com movimento labial compatível
- Marca pessoal para criadores que querem uma versão de si mesmos estilizada por IA diante da câmera
- Vídeos explicativos para startups que precisam de vídeo profissional com orçamento zero
💡 O caso de uso mais prático agora: combinar um retrato de IA de alta qualidade com uma voz clonada ou sintética para produzir vídeos explicativos em qualquer idioma, sem custo. O resultado é indistinguível de um clipe de porta-voz gravado profissionalmente em distâncias de visualização casuais.
O que torna um avatar convincente
Três fatores separam um avatar falante convincente de uma imitação óbvia:
- Qualidade do áudio: áudio comprimido com artefatos quebra a ilusão imediatamente. A voz precisa soar genuinamente humana, não sintetizada.
- Precisão da fronteira labial: o formato da boca precisa corresponder ao fonema, não apenas aproximá-lo. Formatos de boca borrados ou genéricos parecem errados até para quem não consegue explicar o motivo.
- Micromovimentos dos olhos e da cabeça: olhos completamente parados parecem não naturais. Modelos que acrescentam piscadas sutis e leves balanços de cabeça fecham rapidamente o vale da estranheza.
As melhores ferramentas gratuitas disponíveis em 2027 lidam bem com os três. A questão é por qual delas começar.
Passo 1: crie a voz
Antes de qualquer sincronização labial, você precisa de áudio. A qualidade desse áudio define o teto do resultado final. Uma voz embolada ou robótica vai gerar um avatar embolado e robótico, não importa quão bom seja o modelo de sincronização labial. É nesta etapa que a maioria dos iniciantes dedica pouco tempo, e isso aparece no resultado.
Modelos gratuitos de TTS que realmente soam humanos
A PicassoIA hospeda vários modelos de texto para fala que produzem áudio convincente o bastante para alimentar um pipeline de sincronização labial. Os que valem a pena para avatares falantes especificamente:
ElevenLabs v3 é o benchmark atual para síntese de fala expressiva. Ele lida melhor com variação emocional, ritmo e hesitações naturais do que qualquer concorrente da sua faixa. Se o roteiro tiver algum peso emocional, comece por aqui. O modelo também respeita a pontuação da forma como um falante humano faria, produzindo pausas naturais nas vírgulas e pausas um pouco mais longas nos pontos finais, em vez de uma entrega plana e monótona.
MiniMax Speech 2.8 HD produz saída com qualidade de estúdio e síntese mais rápida que o tempo real. A textura da voz é densa e calorosa, sem a qualidade fina e levemente oca que denuncia modelos mais baratos. Ele lida com roteiros longos sem a deriva que às vezes aparece por volta dos dois minutos, quando o ritmo das frases começa a achatar. Para conteúdo corporativo ou instrucional, é a opção de som mais profissional com custo zero.
Resemble AI Chatterbox é a melhor opção se você quer controle de emoção com clonagem de voz. Você pode fornecer um trecho de referência de qualquer voz e o Chatterbox a clona com a inflexão emocional preservada. Útil para criar um avatar falante que soe como uma pessoa específica, uma voz de marca ou até um personagem fictício com uma personalidade vocal definida. O controle deslizante de emoção é um recurso que a maioria dos modelos gratuitos concorrentes não oferece.
Qwen3 TTS é a carta coringa. Em vez de clonar vozes existentes, ele pode criar vozes totalmente novas a partir de uma descrição em texto, e lida bem com cadências fora do padrão. Bom para personagens fictícios ou avatares que precisem de uma assinatura vocal distintiva e levemente incomum, que nenhum humano real tenha.
ElevenLabs Flash v2.5 é a opção otimizada para velocidade, para quando você precisa iterar rápido. Se você está testando vários roteiros ou ajustando a entrega, o tempo de renderização mais curto permite experimentar opções sem esperar.
| Modelo | Melhor para | Clonagem de voz | Idiomas |
|---|
| ElevenLabs v3 | Narração expressiva | Sim | 30+ |
| MiniMax Speech 2.8 HD | Roteiros longos com qualidade de estúdio | Não | Vários |
| Chatterbox | Clonagem com controle de emoção | Sim | Principalmente inglês |
| Qwen3 TTS | Criação de vozes inéditas | Sim | Vários |
| ElevenLabs Flash v2.5 | Iteração rápida e testes | Sim | 32 |
O formato do arquivo importa: a maioria dos modelos de sincronização labial espera um arquivo WAV ou MP3 limpo, com pouco ruído de fundo. Gere o áudio primeiro, ouça e corte qualquer silêncio no início e no fim antes de enviá-lo para a etapa de sincronização. Silêncio no começo do arquivo faz os modelos de sincronização começarem com uma boca fechada e estática, que parece travamento.
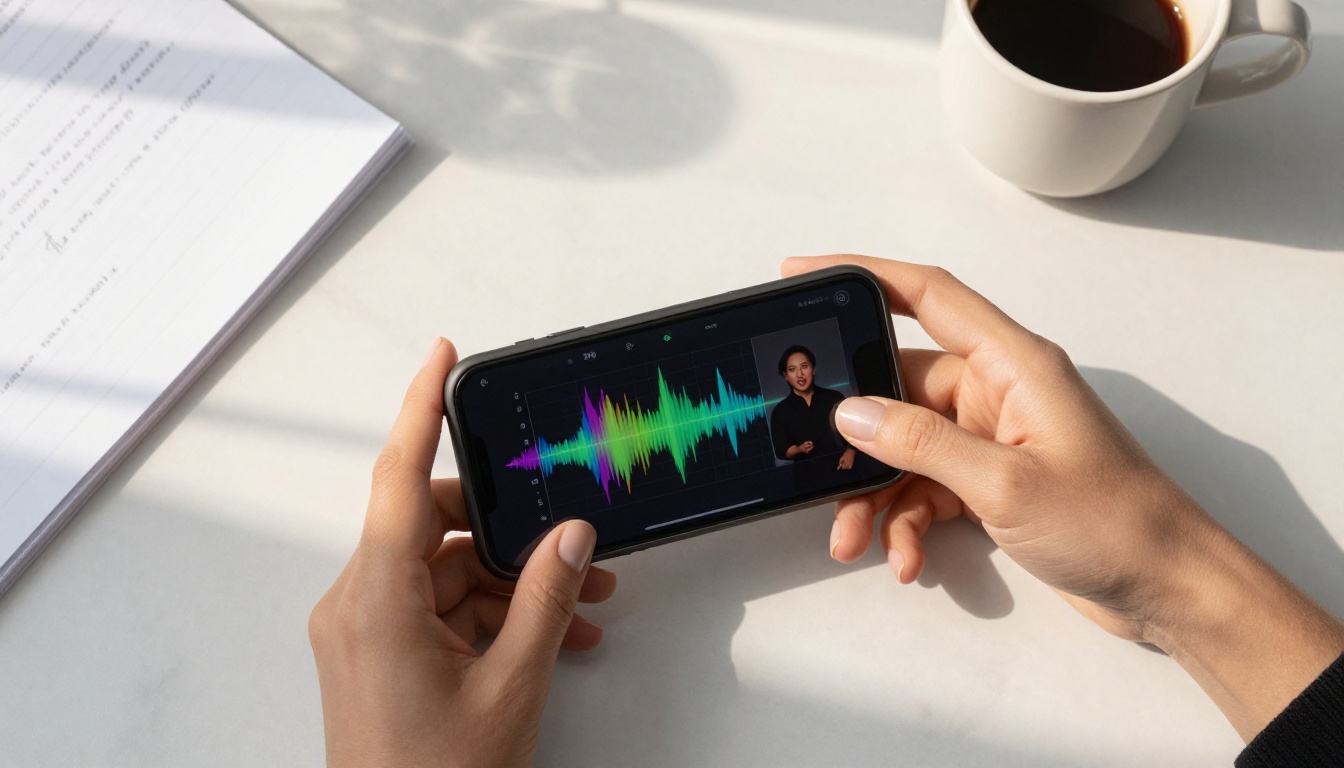
A IA de sincronização labial recebe duas entradas: um rosto (imagem estática ou um clipe curto de vídeo) e um arquivo de áudio. Ela gera um vídeo desse rosto falando em sincronia com o áudio. O desafio técnico é combinar o formato da boca em cada quadro com o fonema correspondente na faixa de áudio, com consistência suficiente para que o resultado passe por fala humana natural.
O que a IA de sincronização labial realmente faz
Os modelos modernos de sincronização labial usam redes de correspondência audiovisual treinadas com milhares de horas de imagens de cabeças falantes. Eles preveem o formato exato da boca, a posição da mandíbula e a visibilidade dos dentes para cada quadro de áudio e, então, compõem isso sobre o rosto de origem, preservando os traços faciais ao redor e as condições de iluminação.
Os melhores modelos também lidam com:
- Oclusão (cabelo ou mãos parcialmente na frente da boca na imagem de origem)
- Consistência de iluminação (para que a região animada da boca combine em cor e brilho com o resto do rosto)
- Movimento da cabeça (acenos e inclinações sutis que acompanham o ritmo da fala, em vez de permanecer roboticamente parados)
- Piscadas (inserção automática de piscadas para evitar o efeito de olhos mortos, que logo parece artificial)
Os melhores modelos gratuitos de sincronização labial na PicassoIA
A PicassoIA hospeda 12 modelos de sincronização labial em sua plataforma. Nem todos são adequados para entrada de fotos de IA, pois alguns foram feitos para dublagem de vídeo e não para animar retratos estáticos. Os abaixo são os de melhor desempenho especificamente para transformar um retrato de IA estático em um avatar falante.
Omni Human 1.5
Omni Human 1.5 da ByteDance é o modelo de melhor desempenho nesta categoria no momento. Ele aceita uma única foto de retrato e qualquer trecho de áudio e produz um vídeo com sincronização labial precisa, movimento natural da cabeça e microexpressões que deixam o resultado com aparência genuinamente viva. O modelo foi criado especificamente para a animação realista de fotos, não apenas para dublagem de vídeo, e essa é a distinção decisiva.
O que o separa dos modelos mais antigos é que ele não produz o efeito de animação apenas na boca, em que tudo, exceto os lábios, parece congelado. O rosto inteiro participa da fala. O movimento das sobrancelhas, a tensão da mandíbula e a atividade sutil das bochechas respondem ao áudio de uma forma que os modelos anteriores simplesmente não produziam.
Seu antecessor, o Omni Human, ainda vale a pena para clipes mais curtos em que um movimento levemente mais estilizado combina melhor com a estética.
P Video Avatar
P Video Avatar da PrunaAI é otimizado para velocidade sem sacrificar muito a qualidade. É a escolha prática quando você precisa produzir vários clipes de avatar em uma sessão, em vez de renderizar um único vídeo perfeito. A precisão da sincronização labial é forte em retratos de frente, que é exatamente o tipo de saída que a maioria dos geradores de imagem por IA produz.
Fabric 1.0
Fabric 1.0 da VEED enfrenta o desafio de fazer fotos falarem com atenção especial aos dentes e à região interna da boca. Muitos modelos de sincronização labial produzem uma mancha escura e borrada onde deveriam estar os dentes. O Fabric 1.0 gera geometria real dos dentes com base no fonema do áudio, uma diferença de qualidade perceptível em closes nos quais a boca ocupa uma parte grande do quadro.
Kling Lip Sync
Kling Lip Sync da KwaiVGI é a melhor opção para áudio em idiomas que não o inglês. Se a voz que você gerou no Passo 1 estiver em um idioma com combinações de fonemas incomuns, o Kling lida com a geometria da boca com mais precisão do que modelos treinados predominantemente em inglês. Também é forte em inglês com sotaque, quando os padrões de acentuação diferem da fala americana ou britânica padrão.
React 1 e Lipsync 2 Pro
React 1 da Sync foi criado especificamente para adicionar sincronização labial realista a conteúdo de vídeo existente, mas funciona igualmente bem em fotos animadas. É o modelo mais preciso para grupos densos de consoantes e fala acelerada.
Lipsync 2 Pro da Sync é a camada de refinamento acima do Lipsync 2, com precisão melhorada nas bordas da fronteira labial, reduzindo o artefato de fantasma que às vezes aparece na borda da boca durante sons oclusivos.
💡 Para o resultado de maior qualidade em um retrato frontal de IA, o fluxo de trabalho é: gerar o áudio com o ElevenLabs v3 e depois enviá-lo para o Omni Human 1.5. Essa combinação supera consistentemente qualquer outra dupla gratuita em termos de movimento natural e precisão labial.
Modelos de vídeo de avatar falante que valem a pena testar
Além da categoria de sincronização labial, a PicassoIA hospeda vários modelos de geração de vídeo criados especificamente para a criação de avatares. Eles funcionam de outra forma: em vez de sincronizar um áudio com uma foto estática, geram um vídeo completo de cabeça falante a partir de uma única imagem de entrada e de um prompt de texto ou trecho de áudio, com o movimento incorporado ao processo de geração, e não aplicado como pós-processamento.
HeyGen Avatar V e Avatar IV
HeyGen Avatar V foi feito especificamente para a geração de vídeos de avatares falantes. Você fornece uma foto e um roteiro, e ele produz um vídeo bem-acabado dessa pessoa falando. O resultado tem consistentemente a aparência de conteúdo de porta-voz profissional, e não de sincronização labial bruta, com contato visual natural, balanço de cabeça controlado e composição limpa da boca.
HeyGen Avatar IV é a geração anterior, mas lida melhor com certas condições de iluminação, especialmente iluminação de alto contraste ou dramática na foto de origem, em que o modelo mais novo às vezes suaviza demais.
Kling Avatar v2
Kling Avatar v2 da KwaiVGI anima qualquer rosto em um vídeo com forte fidelidade de movimento. É especialmente bom em preservar a identidade visual exata de um rosto gerado por IA, algo que pode ser um desafio com modelos que aplicam seu próprio viés estético durante a geração e alteram sutilmente a aparência do personagem entre os quadros.
Dreamactor M2.0
Dreamactor M2.0 da ByteDance leva a animação de personagens mais longe ao oferecer suporte a personagens fora do padrão, incluindo rostos estilizados ou parcialmente idealizados. Se a foto de IA com que você começa tiver traços exagerados ou acentuados, o Dreamactor lida com a animação com mais naturalidade do que os modelos padrão de sincronização labial, treinados predominantemente com fotografia naturalista.
Como usar o Omni Human 1.5 na PicassoIA
Como o Omni Human 1.5 é a ferramenta gratuita mais forte para esta tarefa específica, aqui está o fluxo de trabalho exato, de um retrato de IA bruto até um vídeo finalizado de avatar falante.
Prepare a imagem de origem
A foto de origem precisa de um rosto claramente visível, com os olhos abertos e a boca em posição neutra ou levemente aberta. Perfis e ângulos extremos produzem resultados mais fracos. A entrada ideal é um retrato de frente ou de três quartos, com iluminação uniforme e sem filtro de beleza pesado.
Se você não tiver uma, gere um retrato com qualquer modelo de imagem na PicassoIA e depois recorte bem de perto o rosto antes de enviar para o Omni Human 1.5. Quanto mais apertado o recorte, mais precisa tende a ser a geometria da sincronização labial, porque o modelo não precisa resolver detalhes espaciais finos em um quadro amplo.
Gere o áudio
Acesse o ElevenLabs v3 na PicassoIA. Digite o roteiro que você quer que o avatar fale. Selecione uma voz que combine com o caráter do seu retrato. Baixe o MP3 gerado.
Ouça a saída completa antes de prosseguir. Verifique:
- Pausas não naturais em sinais de pontuação que criem um ritmo irregular
- Qualquer artefato robótico em consoantes duras como T, K ou P
- Silêncio no início ou no fim (corte isso antes de enviar)
Um arquivo de áudio limpo faz uma diferença mensurável na qualidade da sincronização labial.
Execute a sincronização labial
Abra o Omni Human 1.5 na PicassoIA:
- Envie a foto do retrato como entrada do rosto de origem
- Envie o arquivo de áudio como áudio condutor
- Defina a resolução como 720p para um bom equilíbrio entre qualidade e velocidade de renderização
- Envie a tarefa
O tempo de renderização costuma ser de 30 a 90 segundos, dependendo da duração do áudio. A saída é um arquivo MP4 com o rosto totalmente animado para combinar com o áudio, incluindo o movimento da cabeça.
Faça ajustes finos, se necessário
Se o primeiro resultado tiver quadros com falhas ou fonemas descompassados em palavras específicas:
- Corte novamente o áudio para remover o trecho problemático e rode de novo
- Experimente o Lipsync 2 Pro da Sync como uma segunda passagem sobre o clipe de vídeo exportado
- Ajuste o ritmo na etapa de TTS para que as sílabas tônicas caiam com mais clareza nos pontos naturais da fala
Gratuito ou pago: o que você realmente leva
Uma dúvida comum é se as ferramentas gratuitas são de fato utilizáveis ou se o plano gratuito é apenas uma amostra que empurra você para uma assinatura. A resposta honesta para 2025: o plano gratuito da maioria desses modelos produz resultados publicáveis. Os planos pagos acrescentam:
| Recurso | Plano gratuito | Plano pago |
|---|
| Resolução | Até 720p, normalmente | 1080p+ |
| Duração do clipe | 15 a 30 segundos | 2+ minutos |
| Tarefas simultâneas | 1 por vez | Várias |
| Marca d’água | Às vezes presente | Removida |
| Prioridade na fila | Padrão | Mais rápida |
| Clonagem de voz personalizada | Gerações limitadas | Acesso completo |
Para a maioria dos casos de uso, 720p e clipes de 30 segundos são perfeitamente adequados. Um clipe para redes sociais, um vídeo de demonstração curto ou um explicativo de produto não precisam de mais do que isso. Um vídeo de curso de duração completa ou uma série com porta-voz profissional é onde o plano pago começa a fazer sentido econômico.
💡 Construa o fluxo de trabalho com ferramentas gratuitas primeiro. Valide se o resultado atende aos seus padrões e só então decida se um upgrade pago se justifica para o volume que você precisa. A maioria das pessoas que começam pagando descobre que precisava corrigir algo no próprio fluxo de entrada de qualquer forma.
4 erros que estragam o resultado
Mesmo com as ferramentas certas, certas escolhas na entrada produzem resultados ruins de forma consistente. Estes são os mais comuns:
1. Usar uma foto de origem com muito filtro ou retoque. Filtros de pele lisa e retoques de beleza criam superfícies que parecem erradas quando o modelo de sincronização gera o movimento da boca. A composição se quebra na borda da região animada. A textura natural da pele se mistura muito melhor.
2. Ruído de fundo no áudio. Zumbido ambiente, ruído de ar-condicionado ou reverberação na saída do TTS vão ser audíveis no vídeo final e ainda podem atrapalhar a detecção de fonemas. Gere o áudio novamente em uma passagem limpa ou aplique uma etapa de redução de ruído antes do envio.
3. Duração incompatível. Se o áudio tem 60 segundos, mas o vídeo de origem tem 10, o modelo precisa repetir a origem em mosaico, o que cria emendas visíveis e repetição que parecem artificiais. Ajuste a duração da origem à duração do áudio antes de enviar, ou use uma foto estática como origem, para não haver restrição de duração.
4. Retratos de perfil. Os modelos de sincronização labial precisam ver os dois lados da boca para gerar uma geometria precisa dos fonemas. Perfis produzem movimentos de boca assimétricos ou borrados. Vistas de frente ou de três quartos produzem resultados melhores de forma consistente em todos os modelos testados.
Crie seu primeiro avatar falante na PicassoIA
Tudo o que é descrito neste artigo está disponível agora na PicassoIA, sem necessidade de conta para começar a testar. A plataforma reúne todos os modelos citados aqui em um só lugar: Omni Human 1.5, ElevenLabs v3, HeyGen Avatar V, Kling Avatar v2, Fabric 1.0 e MiniMax Speech 2.8 HD.
A forma mais rápida de começar: pegue qualquer retrato de IA que você já tenha, escreva um roteiro de duas frases, gere a voz com o MiniMax Speech 2.8 HD e envie os dois arquivos para o Omni Human 1.5. O processo inteiro leva cerca de cinco minutos. O resultado vai mostrar imediatamente se a qualidade atende ao que você precisa, sem nada investido além do tempo.
Se você quer comparar modelos lado a lado, explore as categorias completas de sincronização labial e de texto para fala em picassoia.com/en/all-models e rode a mesma entrada em três modelos diferentes. As diferenças de qualidade entre o Omni Human 1.5, o Fabric 1.0 e o Kling Lip Sync são reais, mas também dependem do contexto. A ferramenta certa varia conforme o tipo de retrato, o idioma do áudio e a resolução de saída desejada.
A barreira para um avatar falante bem-acabado agora é o seu roteiro, não o seu orçamento.


