Algo cambió cuando salió Kling 3.0. Los modelos anteriores de texto a video producían escenas que parecían video, pero resultaban extrañas, como ver una animación que se esfuerza demasiado por parecer filmada. Kling 3.0 genera imágenes en las que el movimiento tiene peso: la tela se comporta como tela y una ola rompe con el caos real del agua. Para llegar a ese resultado hay que entender qué ocurre entre el momento en que pulsas Enter y el momento en que aparece un archivo de video en tu pantalla.
Qué hace realmente Kling 3.0
El texto como plano del movimiento
Un prompt de texto introducido en Kling 3.0 no es solo una descripción. Es una especificación del tiempo. El modelo lee tus palabras y extrae tres tipos distintos de información: identidad del sujeto (qué es la cosa), semántica del movimiento (qué está haciendo) y contexto ambiental (dónde y en qué condiciones). Estas tres capas se procesan por separado y luego se recombinan durante la generación.
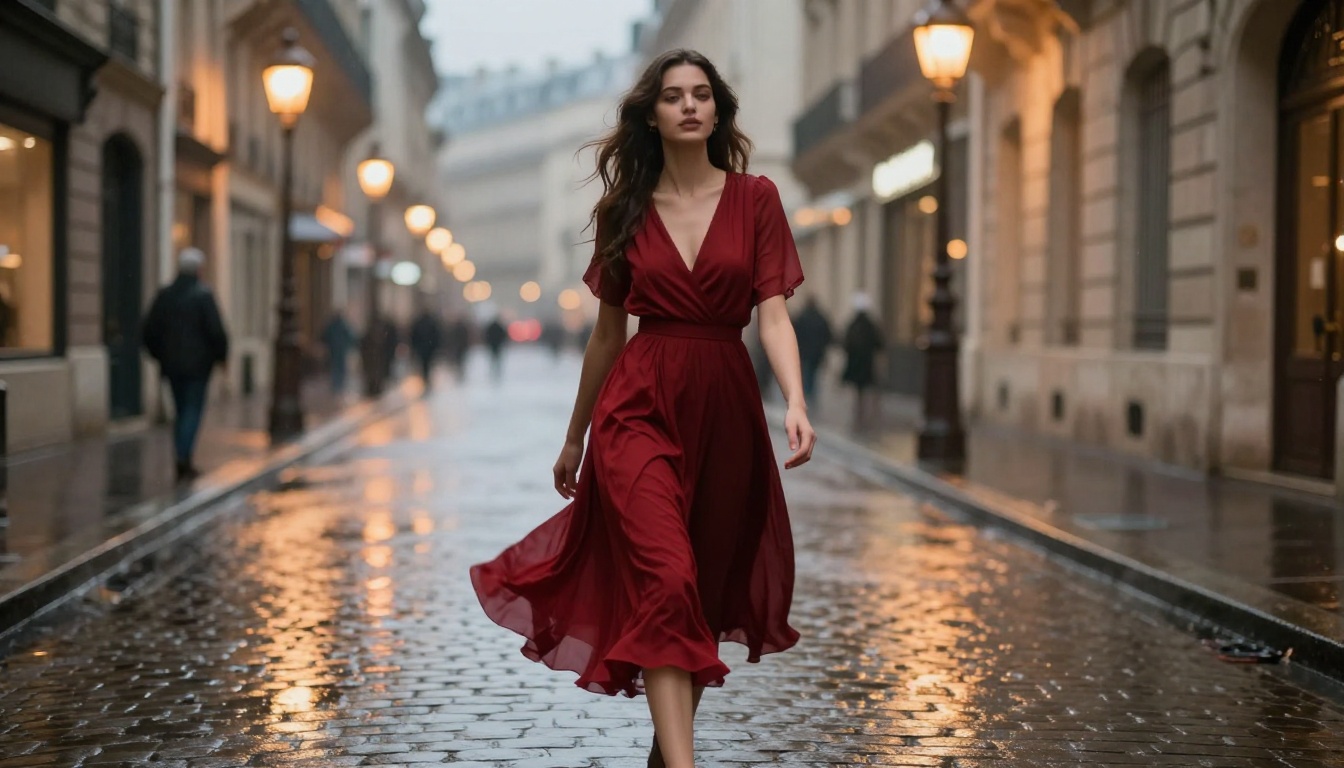
Cuando escribes "una mujer caminando por una calle empedrada al atardecer", el modelo no genera una imagen estática y después le añade una animación de caminar en bucle. Construye toda la secuencia espaciotemporal como una estructura unificada. Las sombras se desplazan según la dirección de luz que has sugerido. Su paso tiene la ligera oscilación de una marcha real. Los adoquines mojados reflejan la luz en ángulos que cambian a medida que ella avanza por el encuadre. Todos los elementos participan a la vez en el sistema de movimiento.
Más que fotogramas clave
Los primeros sistemas de texto a video funcionaban generando un fotograma inicial y un fotograma final, e interpolando todo lo que había entre ambos. Por eso los videos de IA antiguos parecían una transición suave pero sin vida entre dos momentos congelados. No había sensación de continuidad porque no existía. Los fotogramas intermedios eran suposiciones, no física.
Kling 3.0 no funciona así. La arquitectura genera lo que los investigadores llaman secuencias temporales completas en lugar de pares de fotogramas. Cada fotograma tiene en cuenta todos los demás del clip. El modelo sabe que el fotograma 47 debe ser coherente con el 12, no solo en la posición de los objetos, sino en la velocidad del movimiento, la evolución de la luz y el estado físico. Esta conciencia de todo el clip es lo que elimina el problema de la "física de gelatina" que afectaba a los modelos anteriores y que sigue siendo la señal más evidente de un video generado por IA.
Dentro del motor de movimiento
Primero, el análisis semántico
Antes de generar un solo fotograma, Kling 3.0 realiza un análisis semántico profundo de tu prompt. Identifica cada sustantivo, cada verbo y, sobre todo, cada relación implícita entre ellos. La palabra "revoloteando" aplicada a hojas de otoño da al modelo vectores de movimiento completamente distintos a los de "cayendo". La frase "brisa suave" no solo afecta al pelo y a las hojas. También afecta a cómo se desplazan por el suelo las sombras de esas hojas, lo que cambia la luz ambiental de toda la escena momento a momento.
Esta capa semántica es donde Kling 3.0 dio su salto más importante respecto a versiones anteriores. El modelo tiene un vocabulario considerablemente mayor de primitivas de movimiento, comportamientos de movimiento predefinidos extraídos de millones de horas de imágenes reales analizadas. Cuando encuentra un verbo o descriptor de movimiento en tu prompt, recupera la primitiva correspondiente y la adapta a tus sujetos y a tu entorno concretos. El resultado es que los verbos de movimiento tienen un peso físico real, no son solo flechas de dirección.
El modelo también resuelve los conflictos de movimiento antes de que empiece la generación. Si tu prompt describe "la llama de una vela en un viento feroz", el modelo concilia el parpadeo turbulento que implica la llama con el entorno que la rodea, y aplica el movimiento adecuado al humo, a las sombras y a cualquier tela cercana al mismo tiempo. Todo eso sale de analizar tu frase, no de reglas programadas de antemano.
Difusión temporal: fotograma a fotograma
El proceso de generación real usa una arquitectura de difusión modificada, diseñada específicamente para la coherencia temporal. La difusión de imagen estándar genera una única salida eliminando progresivamente el ruido de un campo de ruido aleatorio hasta que aparece una imagen coherente. La difusión de video realiza esta operación sobre un tensor completo de fotogramas al mismo tiempo, lo que significa que el proceso de eliminación de ruido del fotograma 1 y del fotograma 60 están matemáticamente acoplados desde el principio.
Kling 3.0 usa lo que parece ser un mecanismo de atención 3D que opera tanto sobre las dimensiones espaciales de cada fotograma como sobre la dimensión temporal a lo largo del clip. Cada píxel en cada instante tiene una relación con el píxel correspondiente en otro punto del tiempo. El resultado es que los objetos no parpadean entre fotogramas, los rostros no se deforman, las texturas se mantienen coherentes y los elementos en movimiento conservan sus propiedades físicas durante todo el clip, sin trucos de posproducción.
💡 Consejo para el prompt: Describe el movimiento con verbos concretos y condiciones físicas. "Una hoja desciende lentamente en un aire completamente quieto" producirá un movimiento más realista que simplemente "hoja cayendo", porque el modelo tiene más anclajes semánticos para la física que necesita simular.
Cómo se mantiene realista la física
Tela, cabello y dinámica de fluidos
Una de las mejoras más visibles de Kling 3.0 es el tratamiento de lo que el equipo llama movimiento secundario, el movimiento de los elementos que están físicamente unidos a un sujeto principal en movimiento o que se ven afectados por él. Cuando una persona camina, su cabello, su chaqueta, su bufanda y sus accesorios reaccionan físicamente. Los modelos anteriores tenían dificultades aquí porque el movimiento secundario exige que el modelo mantenga una representación interna de la relación física entre los objetos, y no solo que los anime por separado.
Kling 3.0 usa un enfoque de generación condicionada por la física. Durante el entrenamiento, el modelo absorbió enormes cantidades de imágenes con propiedades físicas anotadas: peso y tejido de la tela, elasticidad y grosor del cabello, viscosidad de los fluidos, comportamiento de las partículas en distintas condiciones atmosféricas. Construyó un modelo no solo de cómo se ven estas cosas al moverse, sino de las razones mecánicas por las que se mueven así. Cuando tu prompt describe a una mujer con un vestido de seda fluido corriendo bajo la lluvia, el modelo aplica las restricciones físicas aprendidas para que la tela se comporte como seda mojada a alta velocidad, y no como una capa de CGI sin peso en el vacío.
Un movimiento de cámara que resulta natural
Una característica poco valorada de Kling 3.0 es su comportamiento de cámara implícito. Cuando no especificas un movimiento de cámara, el modelo no recurre a un plano estático perfectamente fijo. Aplica una presencia de cámara sutil y naturalista que imita los micromovimientos de un operador de cámara en mano experimentado. Un leve vaivén de cámara. Un reencuadre apenas perceptible a medida que el sujeto se mueve. Esto añade un realismo de estilo documental que hace que la imagen parezca grabada y no renderizada.
Cuando sí especificas un movimiento de cámara, como "travelling lento hacia delante" o "paneo a la izquierda siguiendo al sujeto", Kling 3.0 trata la cámara como un objeto físico que se mueve por la escena tridimensional. La profundidad de campo cambia a medida que varía la distancia focal. El paralaje entre los elementos del primer plano y del fondo se comporta correctamente. Los objetos a distintas distancias cruzan el encuadre a velocidades distintas, exactamente como lo harían en una fotografía óptica real con un objetivo físico.
Kling v3 frente a versiones anteriores
| Característica | Kling v1.6 | Kling v2.1 | Kling v3 |
|---|
| Resolución | 720p | 720p / 1080p | 1080p nativo |
| Coherencia temporal | Moderada | Buena | Excelente |
| Movimiento secundario (tela, cabello) | Básico | Mejorado | Condicionado por la física |
| Adherencia al prompt | 70% | 82% | 94% |
| Control de cámara | Indicador manual | Indicador manual | Implícito + explícito |
| Puntuación de realismo de movimiento | 6,2 / 10 | 7,8 / 10 | 9,1 / 10 |
El salto de Kling v2.1 a Kling v3 Video no es incremental. La arquitectura se rediseñó desde cero en torno a la coherencia temporal, por eso la diferencia de realismo de movimiento entre estas dos versiones es mayor que la suma de todos los saltos de versión anteriores.
Lo que controla tu prompt de texto
Movimiento del sujeto
La palanca más directa es cómo describes qué están haciendo los sujetos. Kling 3.0 responde a:
- Descriptores de velocidad: "lento", "rápido", "gradualmente" producen velocidades y curvas de aceleración de movimiento medibles y distintas
- Calidad del movimiento: "tropieza", "avanza a zancadas", "se desliza" se corresponden cada uno con bibliotecas de primitivas de movimiento distintas, con postura y ritmo diferentes
- Verbos de interacción: cómo interactúan los sujetos con objetos y entornos afecta a ambos elementos a la vez, no solo al sujeto
- Contexto emocional: "corre alegremente" frente a "corre frenéticamente" produce una postura, un balanceo de brazos, un patrón de apoyo del pie y una microexpresión facial distintos a lo largo del clip
Cada palabra de movimiento es una restricción real para la generación. El lenguaje de movimiento vago produce movimiento vago. El lenguaje de movimiento específico produce movimiento con un carácter físico claro que puedes reconocer y predecir.
Entorno y atmósfera
Las palabras del entorno en tu prompt no solo fijan el escenario. Restringen la física de todo lo que hay en la escena. Describir "una tormenta de lluvia intensa" le indica al modelo que aplique física de la lluvia a cada superficie expuesta: brillo húmedo en la piel, cabello apelmazado, ondas en los charcos por cada gota, menor visibilidad del fondo y la calidad reflectante específica del pavimento mojado bajo distintas fuentes de luz.
Los descriptores de hora del día e iluminación tienen un peso especial porque afectan a toda la evolución de la luz fotograma a fotograma. "Hora dorada que se desvanece hacia el crepúsculo" le da al modelo un arco de iluminación, es decir, genera un clip en el que la calidad de la luz cambia realmente a lo largo de su duración, modificando la temperatura de color, la longitud de las sombras y los reflejos especulares de cada superficie de la escena.
Comportamiento de cámara
Puedes especificar el comportamiento de la cámara directamente con lenguaje cinematográfico que Kling 3.0 ha sido entrenado para interpretar:
- Tipo de plano: "primer plano", "plano general", "plano medio", "primerísimo primer plano"
- Movimiento de cámara: "travelling hacia dentro", "paneo a la derecha", "grúa hacia arriba", "plano de seguimiento", "órbita alrededor del sujeto"
- Comportamiento del objetivo: "profundidad de campo reducida", "cambio de foco al fondo", "distorsión de gran angular"
- Personalidad de la cámara: "en mano", "fija", "steadicam", "dron"
💡 Consejo avanzado: Combina un tipo de plano con un movimiento de cámara para obtener el máximo control. "Travelling lento hacia dentro desde plano medio hasta primer plano, profundidad de campo reducida, steadicam" le da al modelo un conjunto completo de instrucciones ópticas y produce resultados mucho más cinematográficos que una descripción del movimiento del sujeto por sí sola.
Cómo usar Kling v3 en PicassoIA
PicassoIA tiene tres versiones de Kling v3 disponibles, cada una adecuada para un caso de uso ligeramente distinto.
Paso 1: elige la versión adecuada
| Modelo | Ideal para | Enlace |
|---|
| Kling v3 Video | Texto a video general, clips cinematográficos | Abrir modelo |
| Kling v3 Omni Video | Texto a 1080p con duración extendida | Abrir modelo |
| Kling v3 Motion Control | Animación precisa de personajes y control de pose | Abrir modelo |
Para la mayoría de trabajos de texto a video, empieza con Kling v3 Video. Maneja la gama más amplia de prompts y produce el resultado más cinematográfico de forma constante, con el menor esfuerzo de redacción del prompt.
Paso 2: escribe un prompt sólido
Estructura tu prompt en cinco capas:
- Sujeto + acción: quién hace qué, y con qué nivel de energía
- Entorno: dónde, en qué condiciones físicas, qué superficies y materiales hay
- Iluminación: hora del día, calidad de la luz, dirección, temperatura de color
- Cámara: tipo de plano, movimiento, comportamiento del objetivo, personalidad de la cámara
- Ambiente: el tono atmosférico y emocional de la escena
Un prompt débil: "mujer corriendo por una playa"
Un prompt sólido: "una joven con un vestido de lino blanco corriendo descalza por una playa desierta al amanecer, con el pelo ondeando tras ella, arena húmeda bajo los pies, plano de seguimiento en contrapicado a la altura de la cintura siguiéndola de lado, contraluz suave y cálido del sol naciente proyectando una sombra larga por delante de ella"
La versión sólida le da al modelo las cinco capas. La diferencia de calidad entre estos dos prompts no es sutil.
Paso 3: define la duración y los parámetros de salida
- Duración: 5 segundos funciona bien para planos de presentación y contenido de producto. 10 segundos te dan margen para arcos de movimiento con principio, desarrollo y final.
- Relación de aspecto: 16:9 para contenido cinematográfico y horizontal. 9:16 para Reels y vertical de formato corto.
- Modo: usa el modo de máxima calidad para el contenido principal en el que el tiempo de generación importa menos que la fidelidad del resultado.
💡 Si tu primera generación falla en la física o en la calidad del movimiento, ajusta una variable cada vez. La solución más habitual es añadir un descriptor de velocidad explícito y una condición de iluminación concreta. Ambos anclan de forma significativa las decisiones de movimiento del modelo y mejoran el realismo físico en las siguientes generaciones.
Casos de uso reales que merecen la pena
Contenido para redes sociales
Kling 3.0 se usa mucho para contenido social que parece filmado pero no lo está. Contenido de moda, avances de viajes, tomas de estilo de vida de producto en movimiento, todo generado a partir de una única descripción de texto. La calidad del movimiento ha alcanzado un nivel en el que el público ya no identifica de inmediato la imagen como generada por IA, lo que cambia bastante la propuesta de valor práctica.
Visualización de conceptos
Para guionistas, directores y equipos creativos, Kling 3.0 es una forma de externalizar ideas antes de tomar una cámara. La descripción de una escena de un guion se convierte en un clip de referencia en movimiento en cuestión de minutos. Un moodboard deja de ser estático. La textura de una escena propuesta, su calidad de luz y su energía se convierten en algo a lo que todo un equipo creativo puede reaccionar e iterar sin ningún costo de producción.
Narrar sin cámara
El relato en formato corto es la aplicación más directa. Un narrador graba el audio. Kling 3.0 genera las imágenes correspondientes a partir de descripciones de escena bien escritas. Combinado con una herramienta de sincronización labial como Kling Avatar v2 para los segmentos de presentador a cámara, puedes producir una pieza narrativa breve sin ninguna producción física.
Para narrativas más largas, combinar Kling v3 Video con Kling v2.6 para el b-roll secundario y Kling v2.1 Master para los planos principales te da un flujo de producción que cubre distintos niveles de calidad dentro de un mismo proyecto y con distintos costos.
Crea algo ahora
La tecnología que hay detrás de Kling 3.0 es realmente nueva. No es un refinamiento de lo que existía antes, sino un enfoque distinto de cómo se representa y se genera el movimiento. Por eso es un buen momento para usarla de verdad en lugar de limitarte a leer sobre ella.
Abre Kling v3 Video en PicassoIA. Escribe un prompt con la estructura de cinco capas descrita arriba. Empieza con un sujeto que te importe de verdad, un lugar que puedas describir con cierta precisión y una iluminación con un carácter claro. Genera el clip. Después ajusta un elemento y vuelve a generar. El modelo responde con claridad a los cambios en tu lenguaje, así que construirás rápidamente una intuición para su vocabulario de movimiento.
Si necesitas una animación de personajes precisa, Kling v3 Motion Control te da una capa adicional de control sobre la posición del cuerpo y la trayectoria del movimiento. Para cualquier clip que necesite calidad constante durante más de cinco segundos, Kling v3 Omni Video amplía la duración sin perder coherencia temporal.
No necesitas un equipo de cámara, un equipo de rodaje ni un permiso de localización. Necesitas una descripción lo bastante específica como para ser una instrucción física real. Escribe eso, y Kling 3.0 hace el resto.


