Algo mudou quando o Kling 3.0 foi lançado. Os modelos anteriores de texto para vídeo produziam cenas que pareciam vídeo, mas que pareciam estranhas, como assistir a uma animação se esforçando demais para parecer filmada. O Kling 3.0 produz imagens em que o movimento tem peso: o tecido se comporta como tecido e uma onda quebra com o caos real da água. Chegar a esse resultado exige entender o que acontece entre o momento em que você pressiona Enter e o momento em que um arquivo de vídeo aparece na sua tela.
O que o Kling 3.0 realmente faz
O texto como uma planta de movimento
Um prompt de texto enviado ao Kling 3.0 não é apenas uma descrição. Ele é uma especificação para o tempo. O modelo lê suas palavras e extrai três tipos distintos de informação: identidade do sujeito (o que é a coisa), semântica do movimento (o que ela está fazendo) e contexto ambiental (onde e em que condições). Essas três camadas são processadas separadamente e depois recombinadas durante a geração.
Quando você escreve "uma mulher caminhando por uma rua de paralelepípedos ao entardecer", o modelo não gera uma imagem estática e depois acrescenta uma animação de caminhada por cima. Ele constrói a sequência espaçotemporal inteira como uma estrutura unificada. As sombras se movem na direção da luz que você sugeriu. O passo dela tem a microoscilação de uma marcha real. Os paralelepípedos molhados refletem a luz em ângulos que mudam conforme ela atravessa o quadro. Cada elemento participa do sistema de movimento ao mesmo tempo.
Mais do que quadros-chave
Os primeiros sistemas de texto para vídeo funcionavam gerando um quadro inicial e um quadro final e depois interpolando tudo o que havia entre eles. Por isso os vídeos de IA antigos pareciam uma transformação suave, mas sem vida, entre dois momentos congelados. Não havia sensação de continuidade porque ela simplesmente não existia. Os quadros intermediários eram palpites, não física.
O Kling 3.0 não funciona assim. A arquitetura gera o que os pesquisadores chamam de sequências temporais completas, em vez de pares de quadros. Cada quadro está ciente de todos os outros quadros do clipe. O modelo sabe que o quadro 47 precisa ser coerente com o quadro 12, não apenas em termos de posição dos objetos, mas também em termos de velocidade do movimento, evolução da iluminação e estado físico. Essa consciência ao longo de todo o clipe é o que elimina o problema da "física de gelatina", que afligia os modelos anteriores e continua sendo o sinal mais óbvio de vídeo gerado por IA.
Por dentro do motor de movimento
Análise semântica primeiro
Antes que um único quadro seja gerado, o Kling 3.0 faz uma análise semântica profunda do seu prompt. Ele identifica cada substantivo, cada verbo e, de forma decisiva, cada relação implícita entre eles. A palavra "tombando" aplicada a folhas de outono dá ao modelo vetores de movimento completamente diferentes de "caindo". A expressão "brisa suave" não afeta apenas cabelos e folhas. Ela afeta como as sombras dessas folhas se movem pelo chão, o que muda a iluminação ambiente em toda a cena, momento a momento.
Essa camada semântica é onde o Kling 3.0 deu seu maior salto em relação às versões anteriores. O modelo tem um vocabulário substancialmente maior de primitivas de movimento, comportamentos de movimento predefinidos extraídos de milhões de horas de filmagens do mundo real analisadas. Quando encontra um verbo ou descritor de movimento no seu prompt, ele recupera a primitiva correspondente e a adapta aos seus sujeitos e ao seu ambiente específicos. O resultado é que os verbos de movimento carregam peso físico real, e não apenas setas de direção.
O modelo também resolve conflitos de movimento antes de a geração começar. Se o seu prompt descreve "a chama de uma vela em um vento forte", o modelo concilia a turbulência de cintilação implícita da chama com o ambiente ao redor e aplica movimento adequado à fumaça, às sombras e a qualquer tecido próximo ao mesmo tempo. Tudo isso vem da análise da sua frase, e não de regras fixas no código.
Difusão temporal: quadro a quadro
O processo de geração em si usa uma arquitetura de difusão modificada, projetada especificamente para a consistência temporal. A difusão de imagens padrão gera uma saída única ao remover ruído progressivamente de um campo de ruído aleatório até surgir uma imagem coerente. A difusão de vídeo realiza essa operação sobre um tensor inteiro de quadros ao mesmo tempo, o que significa que o processo de remoção de ruído do quadro 1 e do quadro 60 estão matematicamente acoplados desde o início.
O Kling 3.0 usa o que parece ser um mecanismo de atenção 3D, que opera nas dimensões espaciais de cada quadro e na dimensão temporal ao longo do clipe. Cada pixel em cada instante tem uma relação com o pixel correspondente em outro momento. O resultado é que os objetos não piscam entre os quadros, os rostos não se deformam, as texturas se mantêm consistentes e os elementos em movimento preservam suas propriedades físicas ao longo de todo o clipe, sem nenhum truque de pós-processamento.
💡 Dica de prompt: Descreva o movimento com verbos específicos e condições físicas. "Uma folha desce lentamente em um ar completamente parado" vai produzir um movimento mais realista do que simplesmente "folha caindo", porque o modelo tem mais âncoras semânticas para a física que precisa simular.
Como a física se mantém real
Tecido, cabelo e dinâmica de fluidos
Uma das melhorias mais visíveis no Kling 3.0 está no tratamento do que a equipe chama de movimento secundário, o movimento de elementos fisicamente presos a um sujeito principal em movimento ou afetados por ele. Quando uma pessoa anda, o cabelo, a jaqueta, o cachecol e os acessórios dela se movem em resposta física. Os modelos anteriores tinham dificuldade com isso porque o movimento secundário exige que o modelo mantenha uma representação interna da relação física entre os objetos, e não apenas animá-los de forma independente.
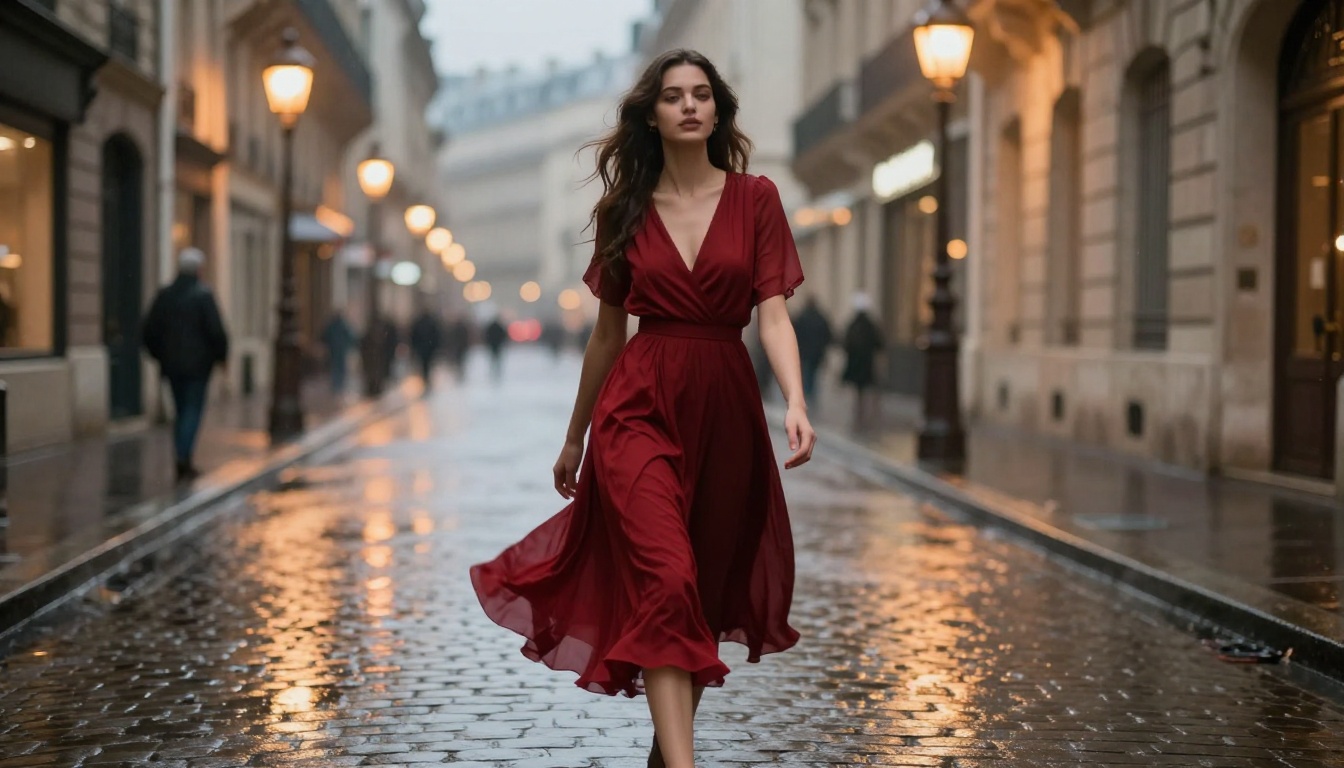
O Kling 3.0 usa uma abordagem de geração condicionada pela física. Durante o treinamento, o modelo absorveu enormes quantidades de imagens com propriedades físicas anotadas: peso e trama do tecido, elasticidade e espessura do cabelo, viscosidade de fluidos, comportamento de partículas em diferentes condições atmosféricas. Ele construiu um modelo não apenas de como essas coisas parecem quando se movem, mas das razões mecânicas pelas quais se movem do jeito que se movem. Quando seu prompt descreve uma mulher com um vestido de seda fluido correndo sob a chuva, o modelo aplica as restrições físicas aprendidas para garantir que o tecido se comporte como seda molhada em velocidade, e não como uma capa de CGI sem peso no vácuo.
Movimento de câmera que parece natural
Um recurso pouco valorizado do Kling 3.0 é o seu comportamento implícito de câmera. Quando você não especifica nenhum movimento de câmera, o modelo não recorre a um plano estático perfeitamente travado. Ele aplica uma presença de câmera sutil e naturalista, que imita os micromovimentos de um operador experiente com câmera na mão. Um pequeno movimento de respiração. Um reenquadramento quase imperceptível conforme o sujeito se move. Isso acrescenta um realismo de estilo documental que faz a imagem parecer gravada, e não renderizada.
Quando você especifica um movimento de câmera, como "travelling lento para frente" ou "panorâmica para a esquerda seguindo o sujeito", o Kling 3.0 trata a câmera como um objeto físico que se move pela cena tridimensional. A profundidade de campo muda conforme a distância focal se altera. O paralaxe entre elementos de primeiro e de segundo plano se comporta corretamente. Objetos a diferentes distâncias atravessam o quadro em velocidades diferentes, exatamente como aconteceria na fotografia óptica real com uma lente física.
| Recurso | Kling v1.6 | Kling v2.1 | Kling v3 |
|---|
| Resolução | 720p | 720p / 1080p | 1080p nativo |
| Consistência temporal | Moderada | Boa | Excelente |
| Movimento secundário (tecido, cabelo) | Básico | Melhorado | Condicionado pela física |
| Aderência ao prompt | 70% | 82% | 94% |
| Controle de câmera | Marcação manual | Marcação manual | Implícito + explícito |
| Pontuação de realismo de movimento | 6,2 / 10 | 7,8 / 10 | 9,1 / 10 |
A passagem do Kling v2.1 para o Kling v3 Video não é incremental. A arquitetura foi redesenhada em torno da coerência temporal desde a base, e é por isso que a diferença de realismo de movimento entre essas duas versões é maior do que a soma de todas as passagens de versão anteriores.
O que o seu prompt de texto controla
Movimento do sujeito
A alavanca mais direta é a forma como você descreve o que os sujeitos estão fazendo. O Kling 3.0 responde a:
- Descritores de velocidade: "lentamente", "rapidamente", "gradualmente" produzem velocidades de movimento e curvas de aceleração mensuravelmente diferentes
- Qualidade do movimento: "tropeça", "anda com passos largos", "desliza" cada um mapeia para bibliotecas distintas de primitivas de movimento, com postura e ritmo diferentes
- Verbos de interação: a forma como os sujeitos interagem com objetos e ambientes afeta os dois elementos ao mesmo tempo, não apenas o sujeito
- Contexto emocional: "corre alegremente" versus "corre freneticamente" produz postura, balanço dos braços, padrão de apoio dos pés e microexpressões faciais diferentes ao longo do clipe
Cada palavra de movimento é uma restrição real para a geração. Linguagem de movimento vaga produz movimento vago. Linguagem de movimento específica produz movimento com um caráter físico claro, que você consegue reconhecer e prever.
Ambiente e atmosfera
As palavras ambientais no seu prompt não servem apenas para montar o cenário. Elas restringem a física de tudo o que está na cena. Descrever "uma tempestade de chuva intensa" instrui o modelo a aplicar física de chuva a cada superfície exposta: brilho molhado na pele, cabelo embaraçado, ondulações nas poças causadas por cada gota, visibilidade reduzida do fundo e a qualidade refletiva específica do pavimento molhado sob diferentes fontes de luz.
Os descritores de hora do dia e de iluminação têm peso especial porque afetam toda a evolução da luz quadro a quadro. "Hora dourada que se transforma em entardecer" dá ao modelo um arco de iluminação, ou seja, ele gera um clipe em que a qualidade da luz realmente muda ao longo da duração, alterando a temperatura de cor, o comprimento das sombras e os brilhos especulares de cada superfície da cena.
Comportamento da câmera
Você pode especificar o comportamento da câmera diretamente usando a linguagem cinematográfica que o Kling 3.0 foi treinado para interpretar:
- Tipo de plano: "close-up", "plano geral", "plano médio", "close-up extremo"
- Movimento de câmera: "dolly in", "panorâmica para a direita", "grua para cima", "plano de acompanhamento", "órbita em torno do sujeito"
- Comportamento da lente: "profundidade de campo rasa", "troca de foco para o fundo", "distorção de grande-angular"
- Personalidade da câmera: "câmera na mão", "travada", "steadicam", "drone"
💡 Dica avançada: Combine um tipo de plano com um movimento de câmera para obter o máximo de controle. "Dolly in lento de plano médio até close-up, profundidade de campo rasa, steadicam" dá ao modelo um conjunto completo de instruções ópticas e produz resultados muito mais cinematográficos do que uma descrição de movimento do sujeito isolada.
Como usar o Kling v3 no PicassoIA
O PicassoIA tem três versões do Kling v3 disponíveis, cada uma adequada a um caso de uso ligeiramente diferente.
Passo 1: escolha a versão certa
| Modelo | Melhor para | Link |
|---|
| Kling v3 Video | Texto para vídeo geral, clipes cinematográficos | Abrir modelo |
| Kling v3 Omni Video | Texto para 1080p com duração estendida | Abrir modelo |
| Kling v3 Motion Control | Animação precisa de personagens e controle de pose | Abrir modelo |
Para a maioria dos trabalhos de texto para vídeo, comece com o Kling v3 Video. Ele lida com a maior variedade de prompts e produz o resultado mais consistentemente cinematográfico com o menor esforço de ajuste do prompt.
Passo 2: escreva um prompt forte
Estruture seu prompt em cinco camadas:
- Sujeito + ação: quem está fazendo o quê, e com que nível de energia
- Ambiente: onde, sob quais condições físicas, quais superfícies e materiais estão presentes
- Iluminação: hora do dia, qualidade da luz, direção, temperatura de cor
- Câmera: tipo de plano, movimento, comportamento da lente, personalidade da câmera
- Clima: o tom atmosférico e emocional da cena
Um prompt fraco: "mulher correndo em uma praia"
Um prompt forte: "uma jovem de vestido branco de linho correndo descalça por uma praia deserta ao amanhecer, o cabelo esvoaçando atrás dela, areia molhada sob os pés, plano de acompanhamento em ângulo baixo, na altura da cintura, seguindo ao lado dela, contraluz suave e quente do sol nascente projetando uma sombra longa à sua frente"
A versão forte dá ao modelo todas as cinco camadas. A diferença de qualidade do resultado entre esses dois prompts não é sutil.
Passo 3: defina a duração e os parâmetros de saída
- Duração: 5 segundos funcionam bem para planos de estabelecimento e conteúdo de produto. 10 segundos dão espaço para arcos de movimento com começo, meio e fim.
- Proporção: 16:9 para conteúdo cinematográfico e paisagístico. 9:16 para Reels e vídeos curtos na vertical.
- Modo: Use o modo de maior qualidade para conteúdo principal, quando o tempo de geração importa menos do que a fidelidade da saída.
💡 Se a sua primeira geração falhar na física ou na qualidade do movimento, ajuste uma variável por vez. A correção mais comum é acrescentar um descritor de velocidade explícito e uma condição de iluminação específica. Os dois ancoram bastante as escolhas de movimento do modelo e melhoram o realismo físico nas gerações seguintes.
Casos de uso reais que vale conhecer
Conteúdo para redes sociais
O Kling 3.0 está sendo muito usado para conteúdo social que parece filmado, mas não foi. Conteúdo de moda, teasers de viagem, fotos de estilo de vida de produtos em movimento, tudo gerado a partir de uma única descrição em texto. A qualidade do movimento chegou a um nível em que o público já não identifica imediatamente as imagens como geradas por IA, o que muda consideravelmente a proposta de valor prática.
Visualização de conceitos
Para roteiristas, diretores e equipes criativas, o Kling 3.0 é uma forma de externalizar ideias antes de alguém pegar uma câmera. A descrição de uma cena de roteiro vira um clipe de referência em movimento em minutos. Um painel de referências deixa de ser estático. A textura de uma cena proposta, sua qualidade de luz, sua energia, passa a ser algo sobre o que toda a equipe criativa pode reagir e iterar, sem nenhum custo de produção.
Contar histórias sem câmera
A narrativa de formato curto é a aplicação mais direta. Um narrador grava o áudio. O Kling 3.0 gera as imagens correspondentes a partir de descrições de cena bem escritas. Combinado com uma ferramenta de sincronização labial, como o Kling Avatar v2, para segmentos de apresentador falando para a câmera, você pode produzir uma peça narrativa curta sem nenhuma produção física.
Para narrativas mais longas, combinar o Kling v3 Video com o Kling v2.6 para b-roll secundário e o Kling v2.1 Master para os planos principais oferece um pipeline de produção que cobre diferentes níveis de qualidade dentro de um mesmo projeto, em diferentes pontos de custo.
Crie algo agora
A tecnologia por trás do Kling 3.0 é realmente nova. Não é um refinamento do que existia antes, mas uma abordagem diferente de como o movimento é representado e gerado. Isso torna este um bom momento para de fato usá-la, em vez de apenas ler sobre ela.
Abra o Kling v3 Video no PicassoIA. Escreva um prompt usando a estrutura de cinco camadas descrita acima. Comece com um sujeito que realmente importa para você, um local que você consiga descrever com alguma especificidade e uma iluminação com um caráter claro. Gere o clipe. Depois ajuste um elemento e gere de novo. O modelo responde com clareza a mudanças na sua linguagem, o que significa que você desenvolve rapidamente uma intuição sobre o vocabulário de movimento dele.
Se você precisar de animação precisa de personagens, o Kling v3 Motion Control oferece uma camada extra de influência sobre a posição do corpo e a trajetória do movimento. Para qualquer coisa que exija imagens consistentes além de cinco segundos, o Kling v3 Omni Video estende a duração sem perder a coerência temporal.
Você não precisa de equipamento de câmera, de equipe nem de autorização para filmar em locação. Precisa de uma descrição específica o bastante para ser uma instrução física real. Escreva isso, e o Kling 3.0 faz o resto.


