Quelque chose a changé avec la sortie de Kling 3.0. Les modèles de texte vers vidéo précédents produisaient des scènes qui ressemblaient à de la vidéo mais qui paraissaient fausses, comme une animation qui s’efforce trop de passer pour une prise de vue réelle. Kling 3.0 produit des séquences où le mouvement lui-même a du poids : le tissu se comporte comme du tissu, et une vague se brise avec le chaos véritable de l’eau. Pour obtenir ce résultat, il faut comprendre ce qui se passe entre le moment où vous appuyez sur Entrée et celui où un fichier vidéo apparaît à l’écran.
Ce que fait réellement Kling 3.0
Le texte comme plan de mouvement
Un prompt texte envoyé à Kling 3.0 n’est pas une simple description. C’est une spécification du temps. Le modèle lit vos mots et en extrait trois types d’informations distincts : l’identité du sujet (ce qu’est la chose), la sémantique du mouvement (ce qu’elle fait) et le contexte environnemental (où et dans quelles conditions). Ces trois couches sont traitées séparément avant d’être recombinées pendant la génération.
Lorsque vous écrivez « a woman walking along a cobblestone street at dusk », le modèle ne génère pas une image fixe pour y ajouter ensuite une boucle d’animation de marche. Il construit la séquence spatio-temporelle entière comme une structure unifiée. Les ombres se déplacent selon la direction de la lumière que vous avez suggérée. Sa démarche présente les micro-oscillations d’une marche réelle. Les pavés mouillés captent la lumière selon des angles qui changent à mesure qu’elle traverse le cadre. Chaque élément participe simultanément au système de mouvement.
Bien plus que des images clés
Les premiers systèmes de texte vers vidéo fonctionnaient en générant une image de début et une image de fin, puis en interpolant tout ce qui se trouvait entre les deux. C’est pourquoi les anciennes vidéos IA ressemblaient à un morphing fluide mais sans vie entre deux instants figés. Il n’y avait aucun sens de la continuité, car il n’y en avait aucune. Les images intermédiaires étaient des suppositions, pas de la physique.
Kling 3.0 ne fonctionne pas de cette façon. L’architecture génère ce que les chercheurs appellent des séquences temporelles complètes, plutôt que des paires d’images. Chaque image a connaissance de toutes les autres images du clip. Le modèle sait que l’image 47 doit être cohérente avec l’image 12, non seulement en termes de position des objets, mais aussi en termes de vitesse de mouvement, d’évolution de l’éclairage et d’état physique. Cette cohérence sur l’ensemble du clip est ce qui élimine le problème de « physique gélatineuse » qui affectait les modèles précédents et reste le signe le plus évident d’une vidéo générée par IA.
À l’intérieur du moteur de mouvement
L’analyse sémantique d’abord
Avant qu’une seule image ne soit générée, Kling 3.0 effectue une analyse sémantique approfondie de votre prompt. Il identifie chaque nom, chaque verbe et, surtout, chaque relation implicite entre eux. Le verbe « tumbling » (dégringoler) appliqué à des feuilles d’automne donne au modèle des vecteurs de mouvement complètement différents de « falling » (tomber). L’expression « gentle breeze » n’affecte pas seulement les cheveux et les feuilles. Elle modifie aussi la manière dont les ombres de ces feuilles se déplacent sur le sol, ce qui change l’éclairage ambiant de toute la scène, instant après instant.
Cette couche sémantique est celle où Kling 3.0 a fait son plus grand bond par rapport aux versions précédentes. Le modèle dispose d’un vocabulaire nettement plus large de primitives de mouvement, c’est-à-dire de comportements de mouvement prédéfinis issus de millions d’heures de séquences réelles analysées. Lorsqu’il rencontre un verbe ou un descripteur de mouvement dans votre prompt, il récupère la primitive correspondante et l’adapte à vos sujets et à votre environnement précis. Résultat : les verbes de mouvement portent un poids physique réel, et pas seulement des flèches directionnelles.
Le modèle résout aussi les conflits de mouvement avant que la génération ne commence. Si votre prompt décrit « a candle flame in a fierce wind », le modèle concilie la turbulence de vacillement impliquée par la flamme avec l’environnement, et applique simultanément le mouvement approprié à la fumée, aux ombres et à tout tissu voisin. Tout cela découle de l’analyse de votre phrase, et non de règles codées en dur.
Diffusion temporelle : image par image
Le processus de génération proprement dit repose sur une architecture de diffusion modifiée, conçue spécifiquement pour la cohérence temporelle. La diffusion d’images classique génère une seule sortie en débruitant progressivement un champ de bruit aléatoire jusqu’à l’émergence d’une image cohérente. La diffusion vidéo effectue cette opération sur un tenseur entier d’images en même temps, ce qui signifie que le débruitage de l’image 1 et celui de l’image 60 sont mathématiquement couplés dès le départ.
Kling 3.0 utilise ce qui semble être un mécanisme d’attention 3D, qui opère à la fois sur les dimensions spatiales de chaque image et sur la dimension temporelle à travers le clip. Chaque pixel, à chaque instant, entretient une relation avec le pixel correspondant à un autre moment. Il en résulte que les objets ne scintillent pas d’une image à l’autre, les visages ne se déforment pas, les textures restent cohérentes, et les éléments en mouvement conservent leurs propriétés physiques pendant toute la durée du clip, sans aucun artifice de post-traitement.
💡 Conseil prompt : Décrivez le mouvement avec des verbes précis et des conditions physiques. "A leaf drifts slowly downward in completely still air" produira un mouvement plus réaliste que la simple formule "falling leaf", car le modèle dispose de davantage d’ancrages sémantiques pour la physique qu’il doit simuler.
Tissu, cheveux et dynamique des fluides
L’une des améliorations les plus visibles de Kling 3.0 concerne la gestion de ce que l’équipe appelle le mouvement secondaire, c’est-à-dire le mouvement des éléments physiquement attachés à un sujet principal en mouvement ou affectés par lui. Lorsqu’une personne marche, ses cheveux, sa veste, son écharpe et ses accessoires réagissent physiquement. Les modèles précédents peinaient ici, car le mouvement secondaire exige que le modèle conserve une représentation interne de la relation physique entre les objets, et pas seulement qu’il les anime séparément.
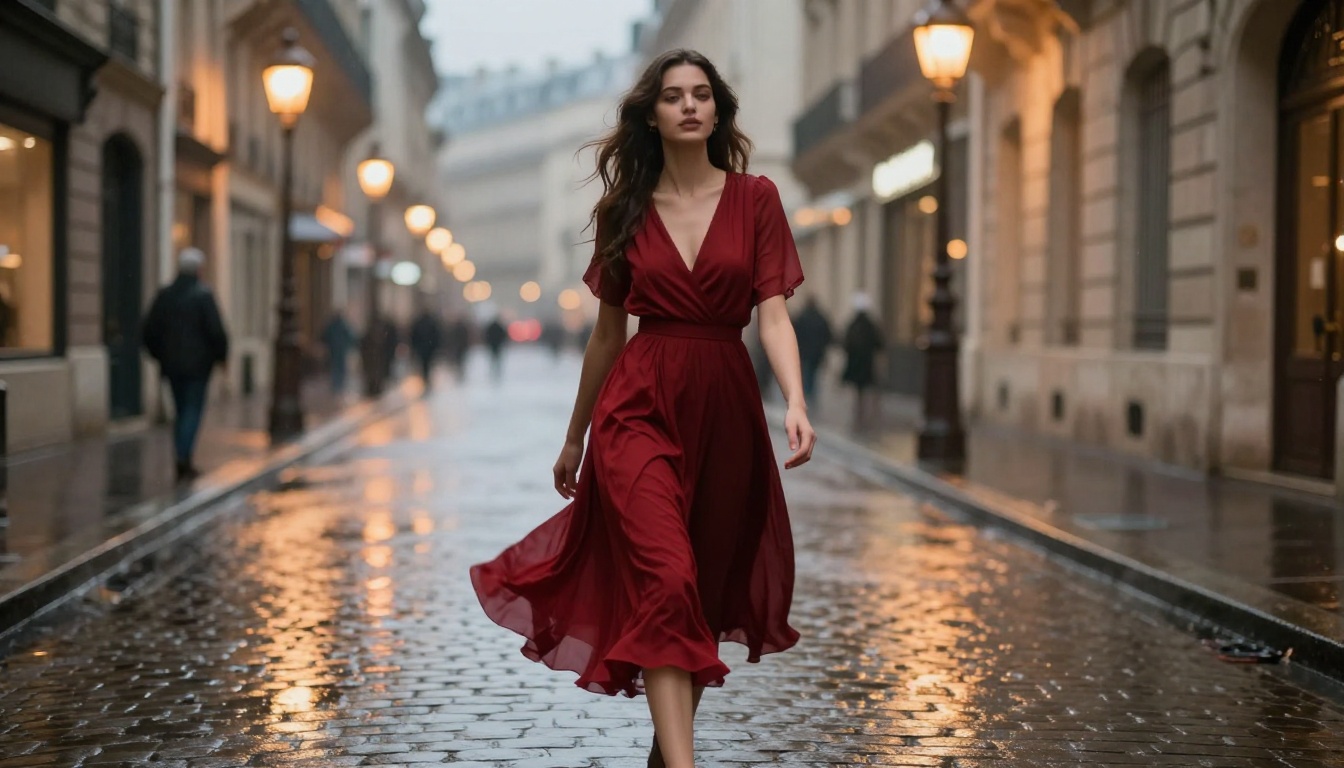
Kling 3.0 utilise une approche de génération conditionnée par la physique. Pendant l’entraînement, le modèle a absorbé d’énormes quantités de séquences accompagnées de propriétés physiques annotées : poids et tissage des étoffes, élasticité et épaisseur des cheveux, viscosité des fluides, comportement des particules dans différentes conditions atmosphériques. Il a construit un modèle non seulement de l’apparence de ces éléments en mouvement, mais aussi des raisons mécaniques pour lesquelles ils bougent ainsi. Lorsque votre prompt décrit une femme en robe de soie fluide courant sous la pluie, le modèle applique les contraintes physiques apprises pour que le tissu se comporte comme de la soie mouillée à pleine vitesse, et non comme une cape CGI sans poids dans le vide.
Un mouvement de caméra naturel
Une caractéristique souvent sous-estimée de Kling 3.0 est son comportement implicite de caméra. Lorsque vous ne spécifiez aucun mouvement de caméra, le modèle ne retombe pas sur un plan fixe parfaitement immobile. Il applique une présence de caméra subtile et naturaliste qui imite les micro-mouvements d’un opérateur à l’épaule expérimenté. Une très légère respiration. Un recadrage à peine perceptible à mesure que le sujet se déplace. Cela ajoute un réalisme de style documentaire qui donne aux images l’impression d’avoir été enregistrées plutôt que générées.
Lorsque vous spécifiez un mouvement de caméra, par exemple "slow dolly forward" ou "pan left following the subject", Kling 3.0 traite la caméra comme un objet physique qui se déplace dans la scène tridimensionnelle. La profondeur de champ évolue à mesure que la distance focale change. La parallaxe entre les éléments du premier plan et de l’arrière-plan se comporte correctement. Les objets situés à des distances différentes traversent le cadre à des vitesses différentes, exactement comme dans une vraie photographie optique avec un objectif physique.
Kling v3 face aux versions antérieures
| Caractéristique | Kling v1.6 | Kling v2.1 | Kling v3 |
|---|
| Résolution | 720p | 720p / 1080p | 1080p natif |
| Cohérence temporelle | Modérée | Bonne | Excellente |
| Mouvement secondaire (tissu, cheveux) | De base | Amélioré | Conditionné par la physique |
| Respect du prompt | 70 % | 82 % | 94 % |
| Contrôle de la caméra | Indicateur manuel | Indicateur manuel | Implicite + explicite |
| Score de réalisme du mouvement | 6,2 / 10 | 7,8 / 10 | 9,1 / 10 |
Le passage de Kling v2.1 à Kling v3 Video n’est pas incrémental. L’architecture a été repensée autour de la cohérence temporelle dès le départ, ce qui explique pourquoi l’écart de réalisme du mouvement entre ces deux versions est plus grand que la somme de tous les sauts de version précédents.
Ce que contrôle votre prompt texte
Le mouvement des sujets
Le levier le plus direct est la manière dont vous décrivez ce que font les sujets. Kling 3.0 réagit à :
- Descripteurs de vitesse : "slowly", "rapidly", "gradually" produisent tous des vitesses de mouvement et des courbes d’accélération mesurablement différentes
- Qualité du mouvement : "stumbles", "strides", "glides" correspondent chacun à des bibliothèques de primitives de mouvement distinctes, avec des postures et un rythme différents
- Verbes d’interaction : la façon dont les sujets interagissent avec des objets et des environnements affecte les deux éléments simultanément, et pas seulement le sujet
- Contexte émotionnel : "runs joyfully" et "runs frantically" produisent une posture, un balancement des bras, un schéma d’appui du pied et une micro-expression faciale différents tout au long du clip
Chaque mot de mouvement est une véritable contrainte pour la génération. Un langage de mouvement vague produit un mouvement vague. Un langage de mouvement précis produit un mouvement qui a un caractère physique clair, que vous pouvez reconnaître et anticiper.
Environnement et atmosphère
Les mots décrivant l’environnement dans votre prompt ne se contentent pas de planter le décor. Ils contraignent la physique de tout ce qui se trouve dans la scène. Décrire "a heavy rainstorm" demande au modèle d’appliquer la physique de la pluie à chaque surface exposée : reflets humides sur la peau, cheveux plaqués, ondulations des flaques à chaque goutte, visibilité réduite de l’arrière-plan, et qualité réfléchissante particulière du pavé mouillé selon les différentes sources de lumière.
Les descripteurs d’heure de la journée et d’éclairage ont un poids particulier, car ils affectent l’évolution de la lumière image par image sur l’ensemble du cadre. "Golden hour fading to dusk" donne au modèle un arc lumineux, c’est-à-dire qu’il génère un clip dont la qualité de lumière évolue réellement pendant sa durée, en modifiant la température de couleur, la longueur des ombres et les reflets spéculaires sur chaque surface de la scène.
Comportement de la caméra
Vous pouvez spécifier directement le comportement de la caméra à l’aide du langage cinématographique que Kling 3.0 a appris à interpréter :
- Type de plan : "close-up", "wide shot", "medium shot", "extreme close-up"
- Mouvement de caméra : "dolly in", "pan right", "crane up", "tracking shot", "orbit around subject"
- Comportement de l’objectif : "shallow depth of field", "rack focus to background", "wide angle distortion"
- Personnalité de la caméra : "handheld", "locked off", "steadicam", "drone"
💡 Astuce pro : Combinez un type de plan avec un mouvement de caméra pour un contrôle maximal. "Slow dolly in from medium shot to close-up, shallow depth of field, steadicam" donne au modèle un jeu complet d’instructions optiques et produit des résultats bien plus cinématographiques qu’une description du mouvement du sujet seule.
PicassoIA propose trois versions de Kling v3, chacune adaptée à un cas d’usage légèrement différent.
Étape 1 : choisir la bonne version
| Modèle | Idéal pour | Lien |
|---|
| Kling v3 Video | Texte vers vidéo généraliste, clips cinématographiques | Ouvrir le modèle |
| Kling v3 Omni Video | Texte vers 1080p avec durée étendue | Ouvrir le modèle |
| Kling v3 Motion Control | Animation précise de personnages et contrôle des poses | Ouvrir le modèle |
Pour la plupart des travaux de texte vers vidéo, commencez par Kling v3 Video. Il couvre la plus grande variété de prompts et produit les résultats les plus constamment cinématographiques, avec le moins d’efforts de rédaction.
Étape 2 : rédiger un prompt efficace
Structurez votre prompt en cinq couches :
- Sujet + action : qui fait quoi, avec quel niveau d’énergie
- Environnement : où, dans quelles conditions physiques, quelles surfaces et quels matériaux sont présents
- Éclairage : moment de la journée, qualité de la lumière, direction, température de couleur
- Caméra : type de plan, mouvement, comportement de l’objectif, personnalité de la caméra
- Ambiance : le ton atmosphérique et émotionnel de la scène
Un prompt faible : "woman running on a beach"
Un prompt efficace : "a young woman in a white linen dress running barefoot along a deserted beach at dawn, her hair streaming behind her, wet sand underfoot, low-angle tracking shot at waist height following alongside her, soft warm backlight from the rising sun casting a long shadow ahead of her"
La version efficace fournit au modèle les cinq couches. La différence de qualité de sortie entre ces deux prompts n’est pas subtile.
Étape 3 : régler la durée et les paramètres de sortie
- Durée : 5 secondes conviennent aux plans d’établissement et aux vidéos de présentation de produits. 10 secondes laissent la place à des arcs de mouvement avec un début, un milieu et une fin.
- Format : 16:9 pour les contenus cinématographiques et en format paysage. 9:16 pour les Reels et le format vertical court.
- Mode : utilisez le mode de qualité maximale pour les contenus phares, lorsque le temps de génération compte moins que la fidélité de la sortie.
💡 Si votre première génération échoue sur la physique ou la qualité du mouvement, modifiez une variable à la fois. La correction la plus courante consiste à ajouter un descripteur de vitesse explicite et une condition d’éclairage précise. Ces deux éléments ancrent nettement les choix de mouvement du modèle et améliorent le réalisme physique des générations suivantes.
Cas d’usage concrets à connaître
Contenus pour les réseaux sociaux
Kling 3.0 est très utilisé pour des contenus sociaux qui paraissent filmés alors qu’ils ne le sont pas. Contenus de mode, teasers de voyage, plans de style de vie produits en mouvement, tout cela généré à partir d’une seule description textuelle. La qualité du mouvement a atteint un niveau tel que le public ne reconnaît plus immédiatement les images comme générées par IA, ce qui modifie considérablement la proposition de valeur concrète.
Visualisation de concepts
Pour les scénaristes, les réalisateurs et les équipes créatives, Kling 3.0 permet d’extérioriser des idées avant même de prendre une caméra en main. La description d’une scène tirée d’un scénario devient un clip de référence animé en quelques minutes. Un moodboard cesse d’être statique. La texture d’une scène envisagée, sa qualité de lumière, son énergie, devient quelque chose sur lequel toute une équipe créative peut réagir et itérer, sans aucun coût de production.
Raconter sans caméra
La narration courte est l’application la plus directe. Un narrateur enregistre l’audio. Kling 3.0 génère les visuels correspondants à partir de descriptions de scènes bien écrites. Combiné à un outil de synchronisation labiale comme Kling Avatar v2 pour les séquences de présentateur face caméra, vous pouvez produire une courte fiction sans aucune production physique.
Pour des récits plus longs, associer Kling v3 Video à Kling v2.6 pour les plans de coupe secondaires et à Kling v2.1 Master pour les plans phares vous offre un flux de production couvrant différents niveaux de qualité au sein d’un même projet, à différents coûts.
Créez quelque chose dès maintenant
La technologie derrière Kling 3.0 est véritablement nouvelle. Il ne s’agit pas d’un raffinement de ce qui existait, mais d’une approche différente de la manière dont le mouvement est représenté et généré. C’est donc le bon moment pour l’utiliser concrètement plutôt que de simplement en lire la description.
Ouvrez Kling v3 Video sur PicassoIA. Rédigez un prompt en suivant la structure en cinq couches décrite plus haut. Commencez par un sujet qui vous tient vraiment à cœur, un lieu que vous pouvez décrire avec une certaine précision, un éclairage au caractère bien défini. Générez le clip. Modifiez ensuite un élément et relancez la génération. Le modèle réagit clairement aux changements de votre langage, ce qui vous permet de développer rapidement une intuition de son vocabulaire de mouvement.
Si vous avez besoin d’une animation de personnage précise, Kling v3 Motion Control vous donne une couche d’influence supplémentaire sur la position du corps et la trajectoire du mouvement. Pour toute séquence cohérente au-delà de cinq secondes, Kling v3 Omni Video étend la durée sans perdre la cohérence temporelle.
Vous n’avez besoin ni de matériel de tournage, ni d’équipe, ni d’autorisation de tournage. Il vous faut une description suffisamment précise pour constituer une véritable instruction physique. Rédigez-la, et Kling 3.0 s’occupe du reste.


