Kling 3.0 llegó sin hacer ruido, pero lo que trajo cambió la forma en que los cineastas con IA piensan la narración. La coherencia de personajes, es decir, la capacidad de un modelo de video con IA de mantener a la misma persona exactamente igual en varias escenas y entornos, siempre fue la pieza que faltaba. Kling 3.0 hace que deje de parecer un parche técnico y pase a ser una capacidad natural integrada en el propio proceso de generación.
Si has intentado crear una historia de varias escenas con cualquier herramienta de video con IA, ya conoces la frustración. En un clip, tu personaje tiene la mandíbula, los ojos y la chaqueta correctos. En el siguiente, es otra persona por completo. Kling 3.0 se toma en serio ese problema, y los resultados son la prueba más clara hasta ahora de que el video generado con IA está listo para el trabajo narrativo real.
El problema que frenaba al video con IA
Qué es la deriva del personaje
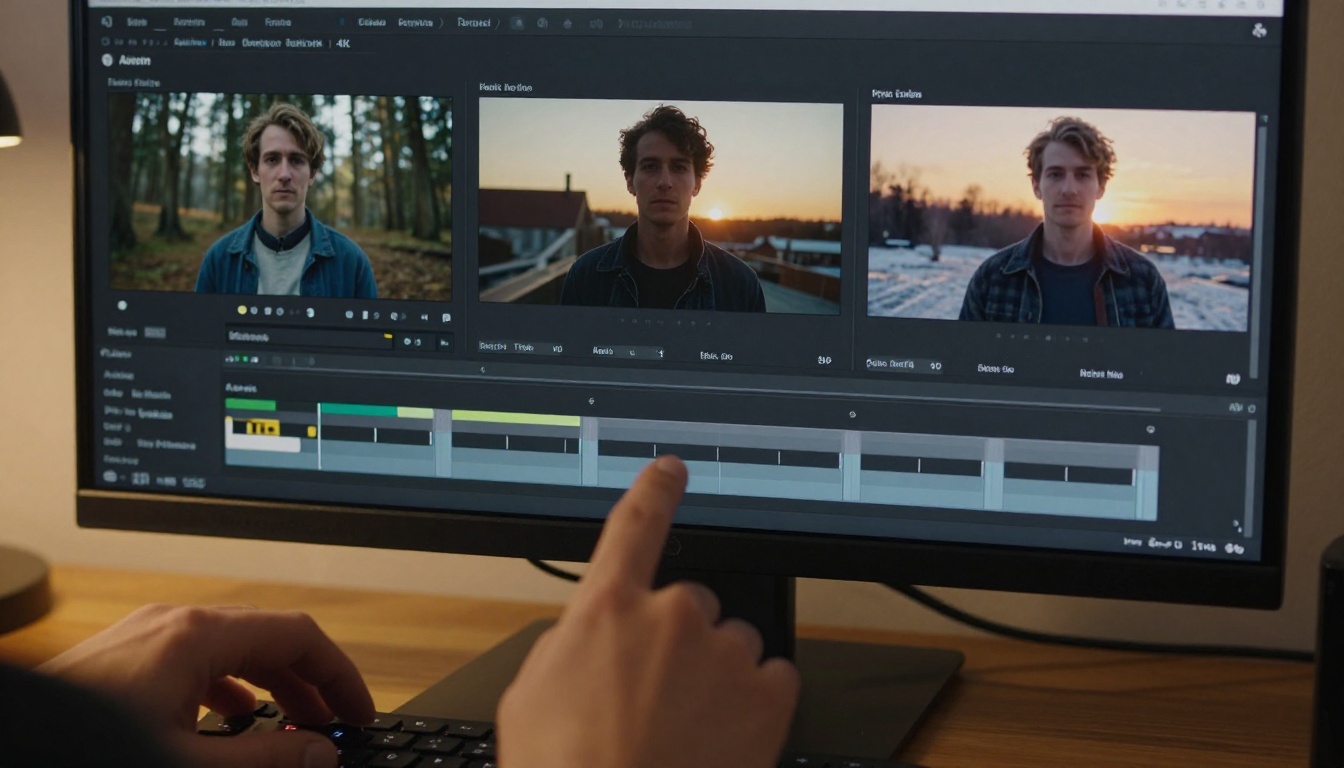
La deriva del personaje ocurre cuando un modelo de IA genera un nuevo clip que debería mostrar a la misma persona que un clip anterior, pero el resultado muestra a alguien sutil o notablemente distinto. La nariz cambia. El pelo se acorta. El tono de piel se desplaza. La chaqueta tiene otros botones.
No es un problema menor para quien intenta contar una historia en varios planos. Un protagonista que se ve distinto en cada escena no es un protagonista, es una persona diferente en cada clip. Esa pérdida de continuidad visual es la mayor barrera entre el video con IA y la narración cinematográfica real, y es la razón por la que la mayoría de las películas generadas con IA antes de Kling 3.0 parecían más reels de ambiente que narrativas coherentes.
Por qué fallaron los modelos anteriores
La mayoría de los modelos de video con IA anteriores generan cada clip como un evento aislado. Procesan un prompt de texto, generan fotogramas y entregan el video sin ninguna memoria persistente de quién era el personaje en el clip anterior. Incluso si usas exactamente el mismo prompt palabra por palabra, la naturaleza estocástica de los modelos de difusión hace que el resultado varíe, a veces ligeramente, a veces de forma notable.
Existían algunas soluciones alternativas: usar el último fotograma de un clip como primer fotograma del siguiente, o aplicar un anclaje de pose al estilo ControlNet para mantener la posición corporal. Pero eran frágiles. Se rompían con los cambios de iluminación, los cambios de ángulo de cámara y cada vez que el personaje se movía de forma notable fuera de una pose concreta.
💡 El problema de fondo: Los prompts de texto no contienen suficiente información de identidad como para anclar un rostro de forma fiable en varias generaciones. Una descripción como "mujer alta de pelo castaño rojizo" deja un margen enorme de interpretación, y cada generación la interpreta de forma distinta según la semilla aleatoria elegida en el momento de generar.
La dimensión del problema
Para entender lo grave que era esto, piensa en lo que requiere producir un cortometraje de tres minutos. A 10 segundos por clip, son al menos 18 clips. Incluso con una deriva moderada en cada generación, en el clip 10 tendrás a alguien que apenas se parece a tu personaje original. El trabajo de posproducción necesario para corregir esa deriva a mano (rotoscopia, igualación de color, plugins de corrección facial) hacía que el video con IA resultara caro justo en las áreas en las que se suponía que iba a ahorrar tiempo.
Anclaje de identidad basado en referencias
Kling 3.0 incorpora el condicionamiento por imagen de referencia como función principal. En lugar de depender solo del texto para describir quién es tu personaje, aportas una imagen de referencia real. El modelo analiza la geometría facial, la textura del pelo, el tono de piel y los rasgos identificativos de esa imagen y los usa como ancla persistente durante toda la generación.
No se trata de una simple animación de imagen a video en la que la imagen de referencia se convierte en el primer fotograma. El modelo extrae rasgos de identidad y los aplica a escenas completamente nuevas, con ángulos de cámara, poses e iluminación completamente nuevos. La imagen de referencia funciona como un pasaporte del personaje, no como un fotograma inicial.
Vinculación temporal entre escenas
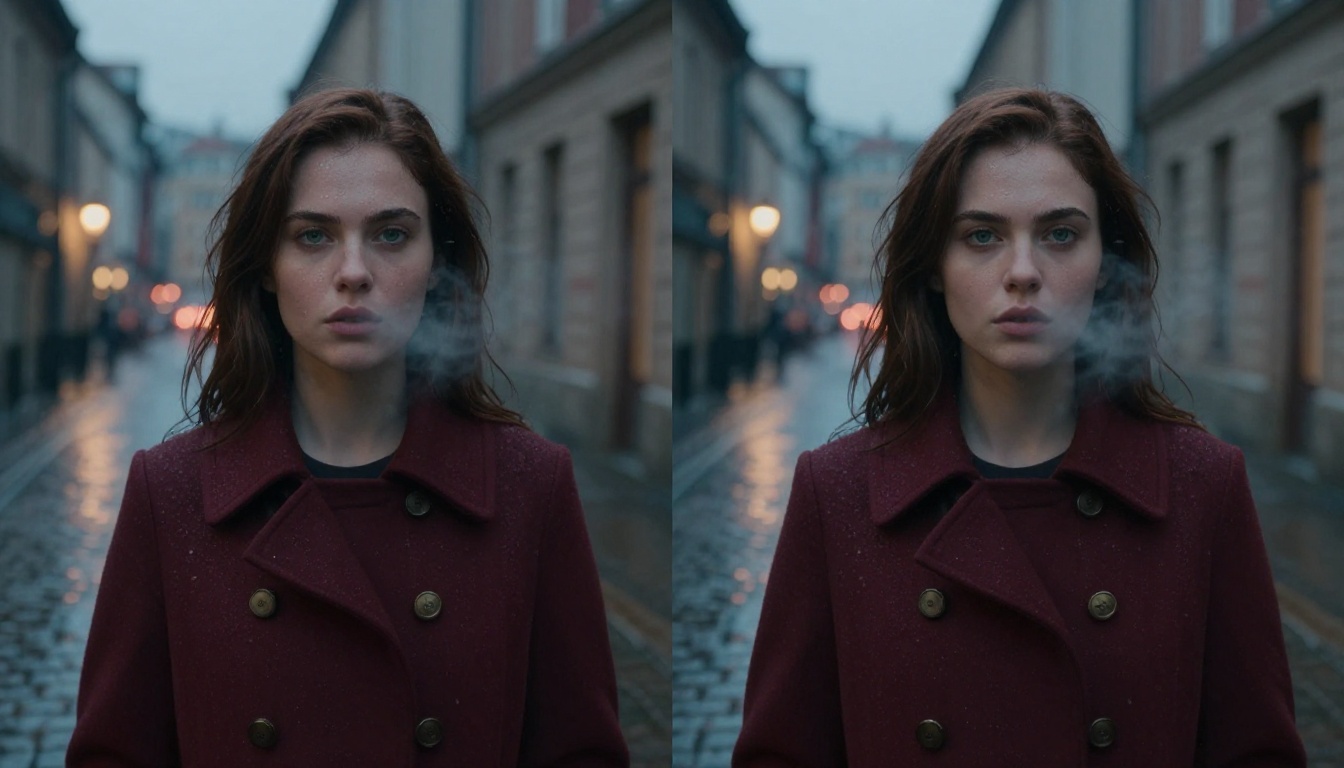
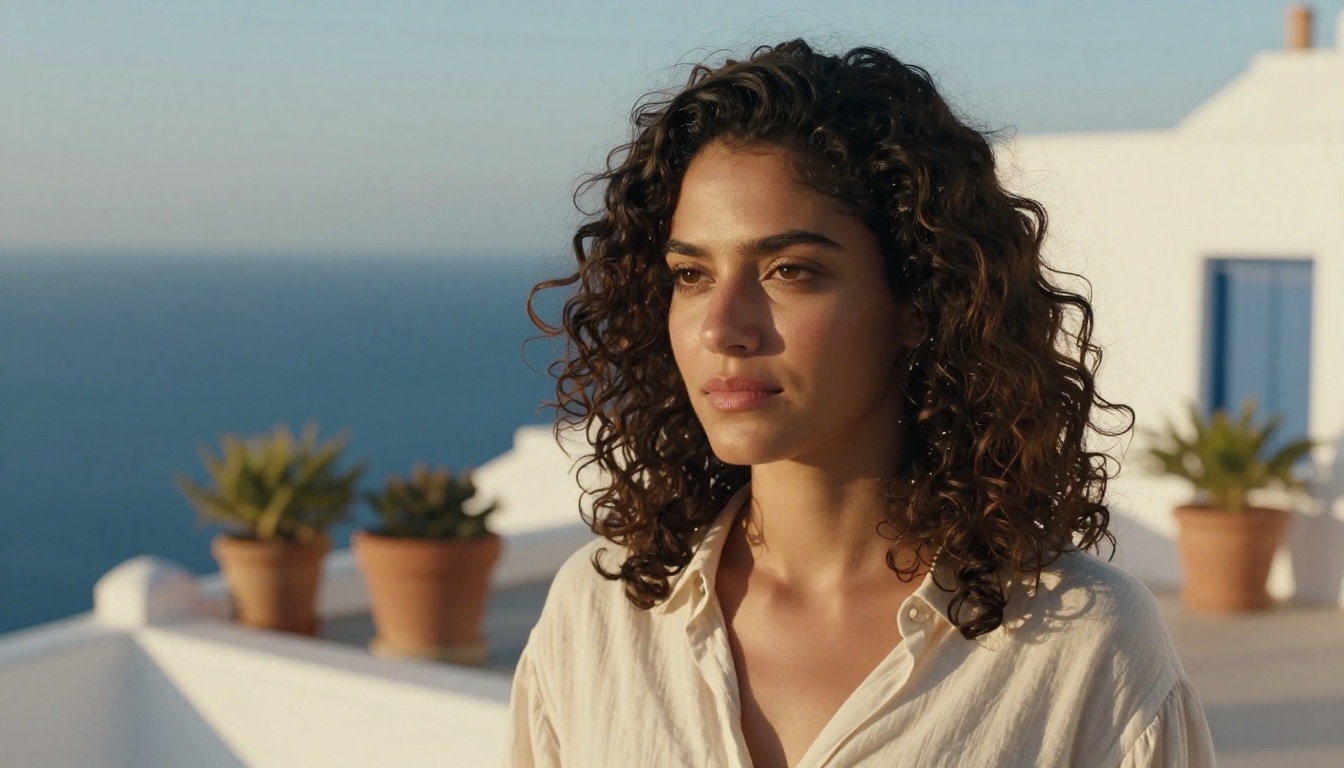
Cuando generas varios clips de una serie, Kling 3.0 te permite transferir el contexto de identidad de un clip al siguiente mediante la vinculación temporal entre escenas. El modelo no trata cada clip como una hoja en blanco. Conserva una representación codificada de la identidad visual del personaje, lo que garantiza que, aunque el fondo cambie de una calle europea lluviosa a un paisaje desértico luminoso, la persona en pantalla siga siendo visualmente coherente.
Esto se manifiesta de formas concretas y medibles:
- Puntos faciales (separación de los ojos, anchura del puente de la nariz, forma de la mandíbula) se mantienen dentro de márgenes estrechos entre clips
- Volumen y longitud del pelo se mantienen, salvo que se pida explícitamente un cambio
- Detalles de la ropa, como botones, tipo de cuello y textura de la tela, persisten entre cortes
- El tono de piel se mantiene estable bajo temperaturas de luz muy distintas
- Las proporciones corporales (anchura de hombros, altura en relación con el entorno) se mantienen dentro de la variación normal
Memoria de ropa y texturas
Uno de los aspectos más infravalorados del sistema de coherencia de Kling 3.0 es cómo gestiona la ropa y la textura de los materiales. Los modelos anteriores conservaban bastante bien el tono de piel, pero reinventaban por completo el atuendo del personaje entre clips, a veces cambiando el color por completo, otras añadiendo o quitando capas.
Kling 3.0 trata la identidad visual del personaje como una firma de cuerpo completo, no solo como una firma facial. Si tu personaje lleva un abrigo granate con botones de latón en la escena uno, ese abrigo, con esos botones y esa textura de tela, aparecerá en la escena dos aunque el resto del entorno sea totalmente distinto.
Modelos de Kling 3.0 que conviene conocer
PicassoIA ofrece acceso directo a todo el conjunto de herramientas de generación de Kling 3.0. Cada modelo gestiona la coherencia de personajes de forma ligeramente distinta según tu flujo de trabajo y el tipo de escenas que estés creando.
Kling V3 Video
Kling V3 Video es el modelo principal de texto a video de la generación 3.0. Acepta tanto un prompt de texto como una imagen de referencia opcional. Para trabajar la coherencia de personajes, este es tu punto de partida. Subes una imagen de referencia de tu personaje, escribes el prompt de la escena y el modelo produce un video que conserva la identidad de la referencia de principio a fin.
Maneja bien una amplia gama de situaciones: transiciones de interior a exterior, cambios de primer plano a plano general y cambios de luz de día a noche. El personaje sigue siendo reconocible en todos ellos. Para la mayoría de los proyectos narrativos con un solo personaje, Kling V3 Video es donde pasarás la mayor parte del tiempo de generación.
Kling V3 Omni Video
Kling V3 Omni Video amplía las capacidades del V3 básico con soporte para entradas de texto e imagen al mismo tiempo. Esto resulta especialmente útil cuando quieres establecer una escena visualmente y, a continuación, generar un video que mantenga tanto la identidad del personaje como el lenguaje visual del entorno.
Para proyectos de varias escenas en los que ya has generado imágenes de referencia de tus localizaciones, Kling V3 Omni Video te permite reunir personaje y entorno con un control de coherencia estricto en ambos extremos a la vez.
Kling V3 Motion Control
Kling V3 Motion Control añade una capa de control de pose y dirección de movimiento sobre el sistema de coherencia de personajes. Aquí es donde Kling 3.0 se vuelve realmente cinematográfico. Puedes especificar trayectorias de cámara, trayectorias de movimiento del personaje y dinámicas de interacción, mientras el modelo mantiene bloqueada la identidad visual del personaje.
Si tu historia requiere que un personaje camine por una escena, se vuelva hacia la cámara o interactúe físicamente con otro elemento, Kling V3 Motion Control se encarga de la coreografía del movimiento sin sacrificar la fidelidad de la identidad.
Cómo usar Kling 3.0 en PicassoIA
PicassoIA te da acceso a los tres modelos de Kling 3.0 desde una sola interfaz, sin configuración de API, sin requisitos de GPU local ni configuraciones complejas.
Paso 1: sube tu referencia de personaje
Antes de escribir un solo prompt, crea o busca una imagen de referencia clara de tu personaje. La calidad de esta imagen determina directamente lo coherente que será tu personaje entre escenas. Debe:
- Mostrar al personaje desde un ángulo neutro (más o menos a la altura de los ojos, mirando a la cámara)
- Incluir el rostro completo, sin sombras fuertes que oculten los rasgos identificativos
- Mostrar la ropa y los accesorios que quieras que se mantengan en todas las escenas
- Tener alta resolución para que el modelo disponga de suficiente detalle para extraer una firma de identidad fiable
Si no tienes una foto de partida, puedes generar primero esta imagen de referencia con cualquiera de los modelos de texto a imagen de PicassoIA. Genera un retrato limpio y bien iluminado y úsalo como ancla.
Paso 2: escribe prompts de escena vinculados al mismo personaje
Tus prompts de texto deben describir la escena y la acción, no volver a describir al personaje. Como la imagen de referencia lleva la información de identidad, tu prompt puede centrarse por completo en:
- El escenario (lugar, hora del día, clima, interior o exterior)
- La acción (lo que hace el personaje en esta escena concreta)
- El ángulo de cámara (primer plano, plano general de situación, contrapicado, plano aéreo)
- El ambiente (calidad de la luz, temperatura de color, atmósfera emocional)
Evita repetir descripciones físicas del personaje en tus prompts. Si escribes "mujer de pelo castaño rojizo" en el prompt y el modelo lo interpreta en parte con el texto en lugar de remitirse a la imagen de referencia, puede introducir una deriva sutil. Deja que la imagen haga todo el trabajo de identidad.
💡 Consejo: Escribe los prompts como si describieras una escena de cine a un director que ya sabe exactamente quién es el actor. Céntrate por completo en la dirección visual, el escenario, la acción y el trabajo de cámara. Nunca en el reparto.
Paso 3: genera y encadena tus escenas
Una vez generado tu primer clip, usa Kling V3 Omni Video para generar las escenas siguientes. Sube la misma imagen de referencia original junto con cada nuevo prompt de escena. No uses el último fotograma del clip anterior como referencia del siguiente, porque eso crea una deriva lenta que se acumula a lo largo de muchas escenas, ya que cada nueva "referencia" ya es ligeramente distinta de la original.
Para secuencias de movimiento complejas, cambia a Kling V3 Motion Control y añade los parámetros de movimiento manteniendo bloqueada la misma referencia original del personaje.
Dónde Kling 3.0 supera a la competencia
La coherencia de personajes es algo en lo que trabajan varias plataformas de video con IA, pero Kling 3.0 se distingue en varios aspectos concretos que más importan para la producción de varias escenas.
| Función | Kling 3.0 | Otros modelos |
|---|
| Condicionamiento por imagen de referencia | Nativo, integrado | Parcial o posprocesado |
| Coherencia de cuerpo completo | Sí (rostro + ropa) | Normalmente solo el rostro |
| Estabilidad de identidad con cambios de luz | Alta | Moderada |
| Movimiento sin perder la identidad | Sí (Motion Control) | Limitado |
| Flujo de encadenado de varias escenas | Sí | Centrado en un solo clip |
| Herramientas específicas para avatares | Sí (Kling Avatar V2) | Escasas |
La competencia maneja bastante bien la generación de personajes en un solo clip. Donde Kling 3.0 se adelanta es en los flujos de trabajo de varios clips y varios entornos, en los que necesitas que la misma persona recorra un arco narrativo completo a través de muchas escenas.
Modelos como Seedance 2.0 y Veo 3.1 ofrecen una calidad de video excepcional en bruto, pero no están optimizados específicamente para la persistencia del personaje entre escenas. Destacan en la calidad de cada clip individual. Kling 3.0 está diseñado desde la base para el caso de uso de producción de varias escenas.
Casos de uso reales
Cortometrajes y microseries
Los cineastas independientes usan ya de forma habitual Kling V3 Video para producir cortometrajes narrativos con personajes recurrentes. Un cortometraje de cinco minutos puede requerir entre 25 y 35 clips individuales. Sin coherencia de personajes, cada clip exige un trabajo intenso de corrección de color y de ajuste facial en posproducción para mantener la coherencia visual de toda la película. Kling 3.0 reduce drásticamente esa carga, de modo que una sola persona puede producir un cortometraje completamente coherente en una fracción del tiempo que antes se necesitaba.
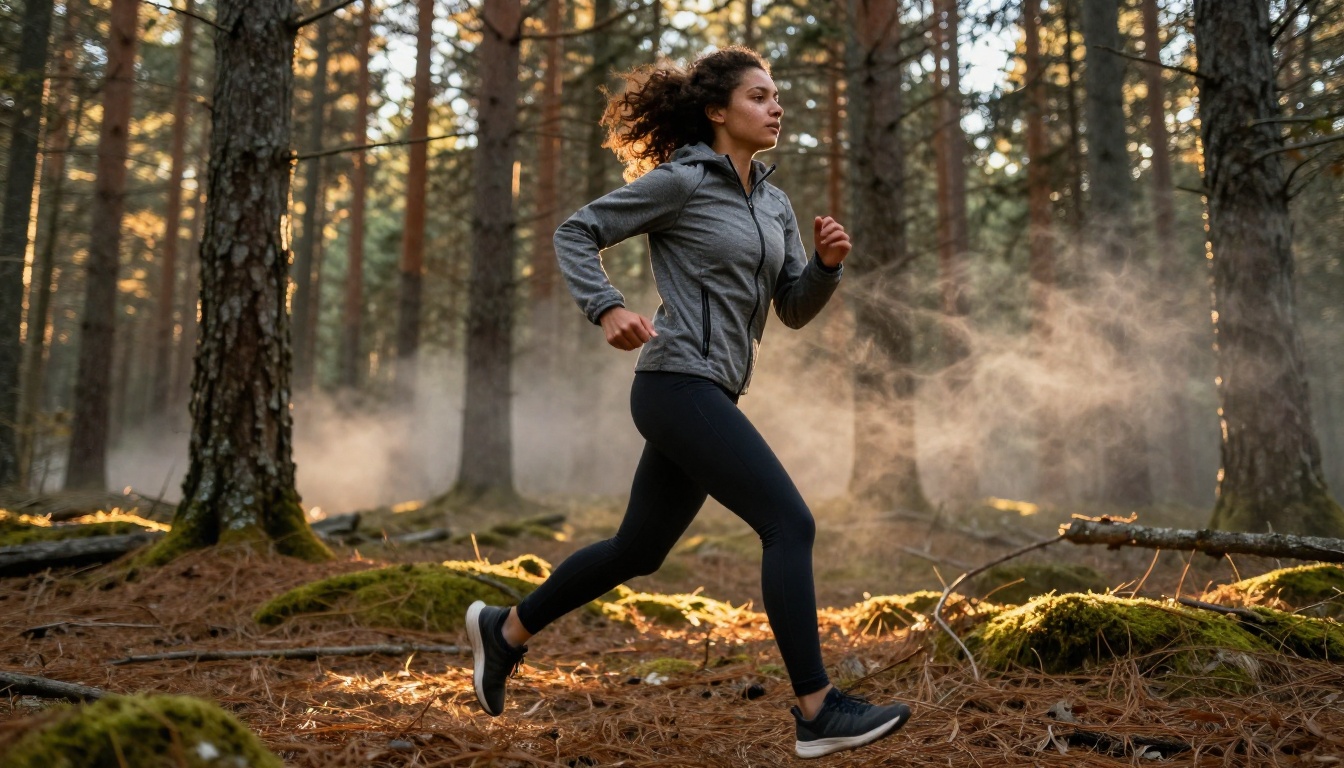
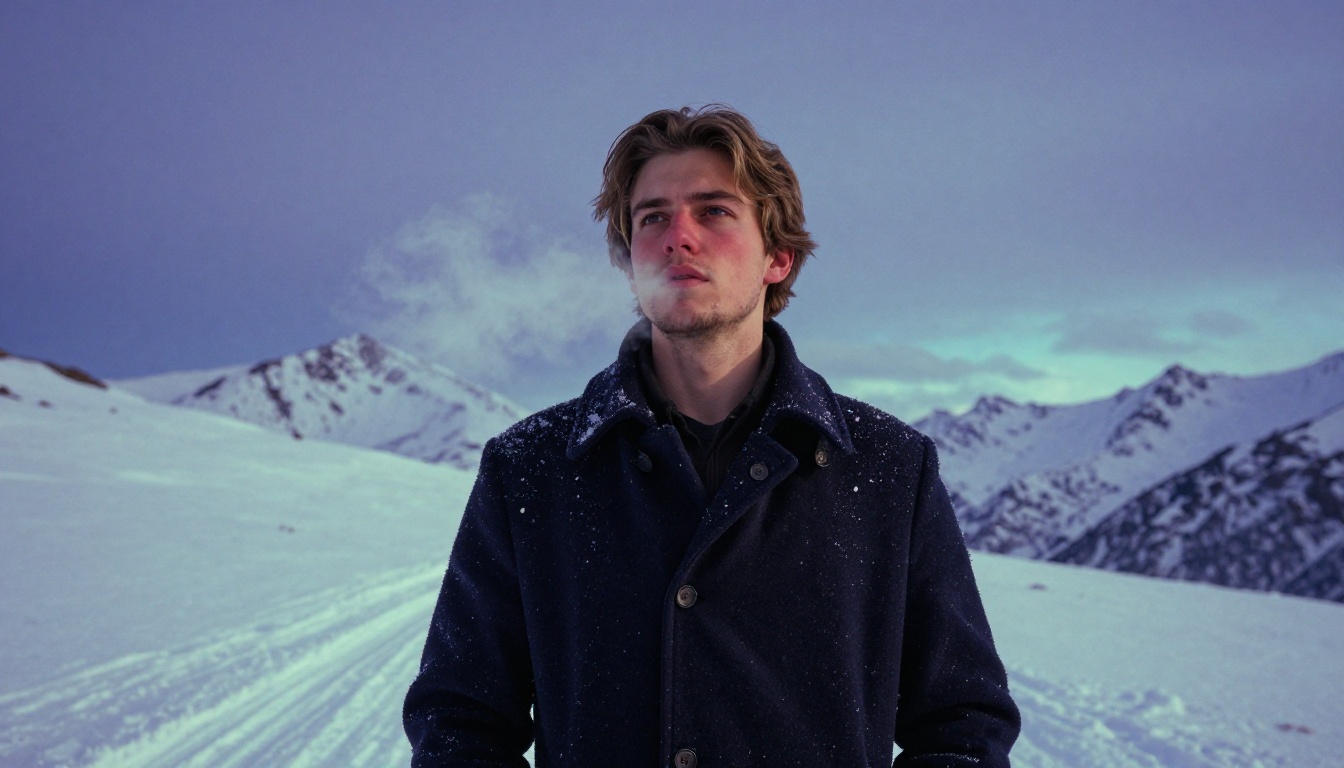
Un personaje puede entrar en un bosque, aparecer en una calle de la ciudad y llegar a un paso de montaña cubierto de nieve, todo en clips consecutivos, y verse exactamente igual en todos ellos.
Narración de marca
Para los equipos de marketing, la coherencia de personajes significa que la mascota o el portavoz de una marca pueda aparecer en varios anuncios, clips para redes sociales y contenido web sin rodajes costosos ni limitaciones rígidas de encuadre. El mismo rostro, la misma identidad de vestuario y la misma presencia física, aplicados al entorno que requiera la campaña para cada pieza de contenido.
Las implicaciones para las campañas de temporada son importantes. Un personaje de marca puede aparecer en contenido de playa de verano y en contenido navideño de invierno con la misma identidad visual en ambos, sin reservar un estudio, sin negociar la disponibilidad de un actor y sin buscar localizaciones.
Creación de contenido a escala
Los creadores que desarrollan series de YouTube, narrativas de Instagram o contenido episódico en redes sociales se benefician directamente del sistema de coherencia de Kling 3.0. Construir una audiencia en torno a un personaje ficticio exige que ese personaje sea reconocible al instante de miniatura en miniatura y de clip en clip. Kling 3.0 hace que ese reconocimiento sea fiable en lugar de fruto del azar.
Lo que Kling 3.0 todavía no puede hacer
La coherencia de personajes de Kling 3.0 es realmente impresionante, pero hay límites reales que conviene conocer antes de planificar una producción completa a partir de ella.
El cambio intencionado de personaje requiere intervención manual. Si tu historia exige que un personaje envejezca de forma visible a lo largo de las escenas, cambie de peinado a mitad de la narración o modifique de forma notable su ropa, tendrás que crear imágenes de referencia actualizadas para esas versiones del personaje. El sistema de coherencia interpreta cualquier desviación respecto a la referencia como algo que corregir, no como una decisión creativa.
Las escenas con varios personajes que tengan dos o más personajes coherentes son más complejas de gestionar. El modelo maneja bien el anclaje de identidad de un solo personaje. Cuando introduces un segundo personaje con su propia imagen de referencia, puede producirse una mezcla de identidades entre ambos en composiciones de dos personajes en primer plano, sobre todo si los dos comparten rasgos físicos parecidos.
Las perspectivas de cámara extremas desde posiciones que la imagen de referencia no cubre, directamente desde arriba, directamente desde atrás o contrapicados extremos bajo la barbilla, producen resultados menos fiables. La imagen de referencia ofrece información limitada sobre cómo se ve el personaje desde esas posiciones, así que el modelo rellena esos huecos con una interpretación más creativa.
💡 Nota: Estas son las limitaciones actuales de la generación V3. Cada versión de Kling ha ajustado sustancialmente las restricciones de coherencia. Según se informa, el control de identidad de varios personajes es un objetivo principal de la próxima iteración de su arquitectura.
Crea tus propios personajes ahora mismo
La tecnología para crear personajes completamente coherentes en escenas de video generadas con IA está disponible hoy, y PicassoIA la pone a tu alcance sin ninguna barrera técnica entre tú y un resultado de calidad de producción.
Abre Kling V3 Video en PicassoIA, sube una imagen de referencia del personaje alrededor del que quieras construir una historia y genera tu primera escena. Después, usa esa misma imagen de referencia para generar la escena siguiente en un entorno completamente distinto. La coherencia se notará de inmediato y el flujo de trabajo te resultará intuitivo desde el primer intento.
Para narrativas con movimientos complejos, prueba Kling V3 Motion Control para añadir movimiento de cámara y coreografía del personaje sobre el anclaje de identidad. Y si quieres llevar más lejos la personalización específica de avatares, Kling Avatar V2 ofrece una vía complementaria que merece la pena probar.
La era de los personajes de IA desechables, que se ven distintos en cada clip, ha terminado. Kling 3.0 hace que la identidad del personaje sea algo que realmente puedes conservar y sostener a lo largo de toda una historia, escena tras escena, entorno tras entorno, sin concesiones.


