Kling 3.0 चुपचाप आया, लेकिन इसने जो लाया उससे AI फ़िल्ममेकर्स के कहानी कहने के तरीके के बारे में सोचने का ढंग बदल गया। कैरेक्टर कंसिस्टेंसी, यानी AI वीडियो मॉडल की वह क्षमता कि वह कई सीन और माहौल में एक ही व्यक्ति को बिल्कुल एक जैसा दिखाए, हमेशा से वह हिस्सा था जो गायब था। Kling 3.0 इसे किसी तकनीकी जुगाड़ जैसा कम, और जनरेशन प्रक्रिया में ही गहराई से बनी एक स्वाभाविक क्षमता जैसा ज़्यादा महसूस कराता है।
अगर आपने किसी भी AI वीडियो टूल से कई सीन वाली कहानी बनाने की कोशिश की है, तो आप यह निराशा पहले ही जानते होंगे। एक क्लिप में आपके कैरेक्टर का जबड़ा, आँखें और जैकेट बिल्कुल सही होते हैं। अगली क्लिप में वह कोई और ही बन जाता है। Kling 3.0 इस समस्या को गंभीरता से लेता है, और नतीजे इस बात का अब तक का सबसे साफ़ सबूत हैं कि AI से बने वीडियो असली नैरेटिव काम के लिए तैयार हैं।
वह समस्या जिसने AI वीडियो को पीछे रखा
कैरेक्टर ड्रिफ़्ट क्या है
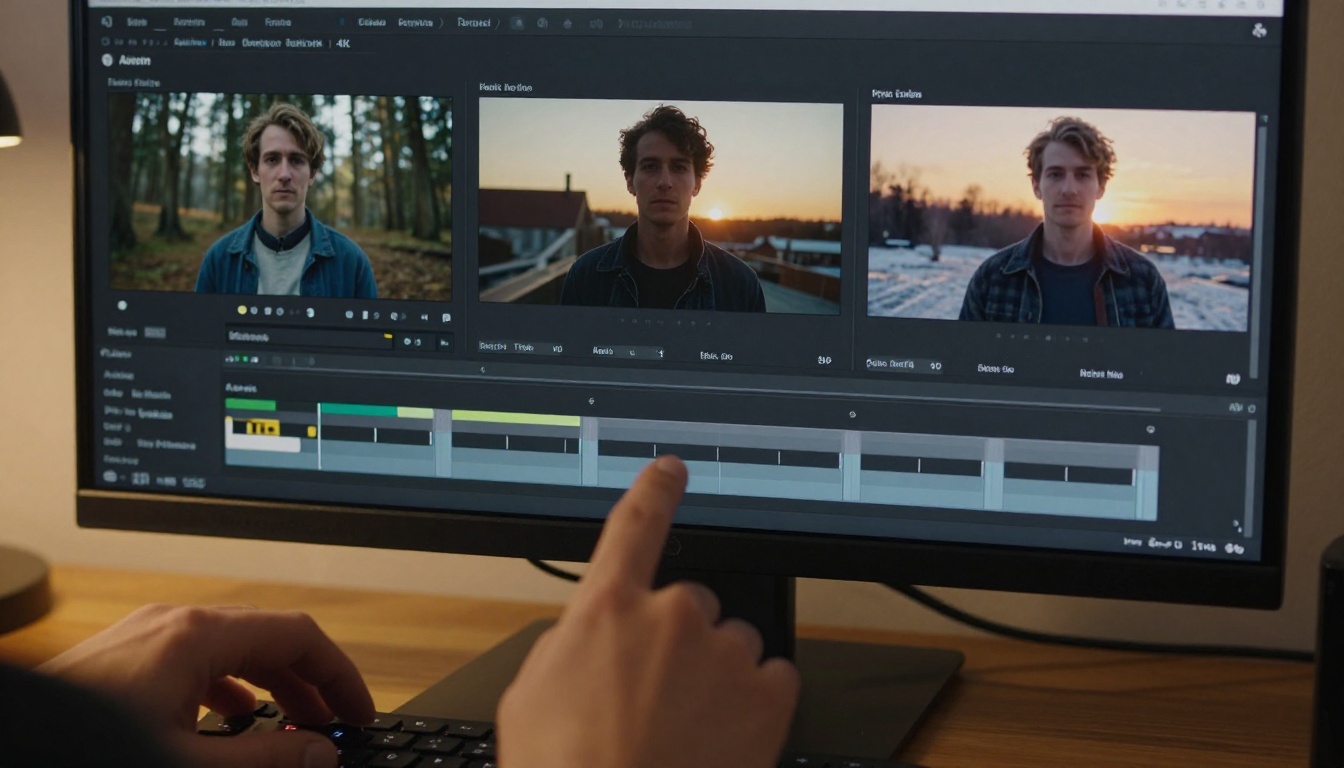
कैरेक्टर ड्रिफ़्ट तब होता है जब AI मॉडल एक नई वीडियो क्लिप बनाता है जिसमें उसे पिछली क्लिप वाला ही व्यक्ति दिखाना चाहिए, लेकिन आउटपुट में कोई हल्का या बड़ा अलग इंसान दिखता है। नाक बदल जाती है। बाल छोटे हो जाते हैं। त्वचा का रंग खिसक जाता है। जैकेट के बटन अलग हो जाते हैं।
कई शॉट्स में कहानी कहने की कोशिश करने वाले किसी भी व्यक्ति के लिए यह छोटी समस्या नहीं है। जो नायक हर सीन में अलग दिखता है, वह नायक नहीं रहता, हर क्लिप में वह एक अलग इंसान बन जाता है। विज़ुअल निरंतरता का यह टूटना AI वीडियो और असली सिनेमाई कहानी कहने के बीच सबसे बड़ी रुकावट है, और यही वजह है कि Kling 3.0 से पहले बनी ज़्यादातर AI फ़िल्में सुसंगत कहानियों के बजाय मूड रील जैसी लगती थीं।
पिछले मॉडल क्यों असफल रहे
ज़्यादातर पिछले AI वीडियो मॉडल हर क्लिप को एक अलग घटना की तरह बनाते हैं। वे टेक्स्ट प्रॉम्प्ट लेते हैं, फ़्रेम जनरेट करते हैं और वीडियो आउटपुट देते हैं, बिना इस बात की किसी स्थायी याद के कि पिछली क्लिप में कैरेक्टर कौन था। यहाँ तक कि अगर आप वही प्रॉम्प्ट शब्दशः दोहराएँ, तब भी डिफ़्यूज़न मॉडल की स्टोकेस्टिक प्रकृति के कारण आउटपुट बदलता है, कभी थोड़ा, कभी बहुत ज़्यादा।
कुछ जुगाड़ पहले भी मौजूद थे: एक क्लिप का आख़िरी फ़्रेम अगली क्लिप का पहला फ़्रेम बनाना, या शरीर की स्थिति बनाए रखने के लिए ControlNet-शैली पोज़ एंकरिंग इस्तेमाल करना। लेकिन ये नाज़ुक थे। ये रोशनी में बदलाव, कैमरा एंगल के खिसकने, और कैरेक्टर के किसी खास पोज़ से काफ़ी हटने पर टूट जाते थे।
💡 मुख्य समस्या: टेक्स्ट प्रॉम्प्ट में कई जनरेशन में चेहरे को भरोसेमंद ढंग से एंकर करने के लिए पर्याप्त पहचान की जानकारी नहीं होती। "लंबी ऑबर्न बालों वाली औरत" जैसे विवरण में व्याख्या की भारी गुंजाइश रहती है, और हर जनरेशन उसे जनरेशन के समय चुने गए रैंडम सीड के आधार पर अलग तरह से समझती है।
समस्या का पैमाना
यह कितना गंभीर था, यह समझने के लिए सोचें कि तीन मिनट की शॉर्ट फ़िल्म बनाने में क्या लगता है। हर 10 सेकंड की क्लिप के हिसाब से कम से कम 18 क्लिप। थोड़े-से भी कैरेक्टर ड्रिफ़्ट के साथ, क्लिप 10 तक आप ऐसे व्यक्ति तक पहुँच जाते हैं जो आपके मूल कैरेक्टर से मुश्किल से मिलता है। उस ड्रिफ़्ट को हाथ से ठीक करने के लिए ज़रूरी पोस्ट-प्रोडक्शन काम, जैसे रोटोस्कोपिंग, कलर मैचिंग और फ़ेस-करेक्शन प्लगइन, ठीक उन्हीं हिस्सों में AI वीडियो को महँगा बना देता था जहाँ उसे समय बचाना था।
Kling 3.0 अलग क्या करता है
रेफ़रेंस-आधारित पहचान एंकरिंग
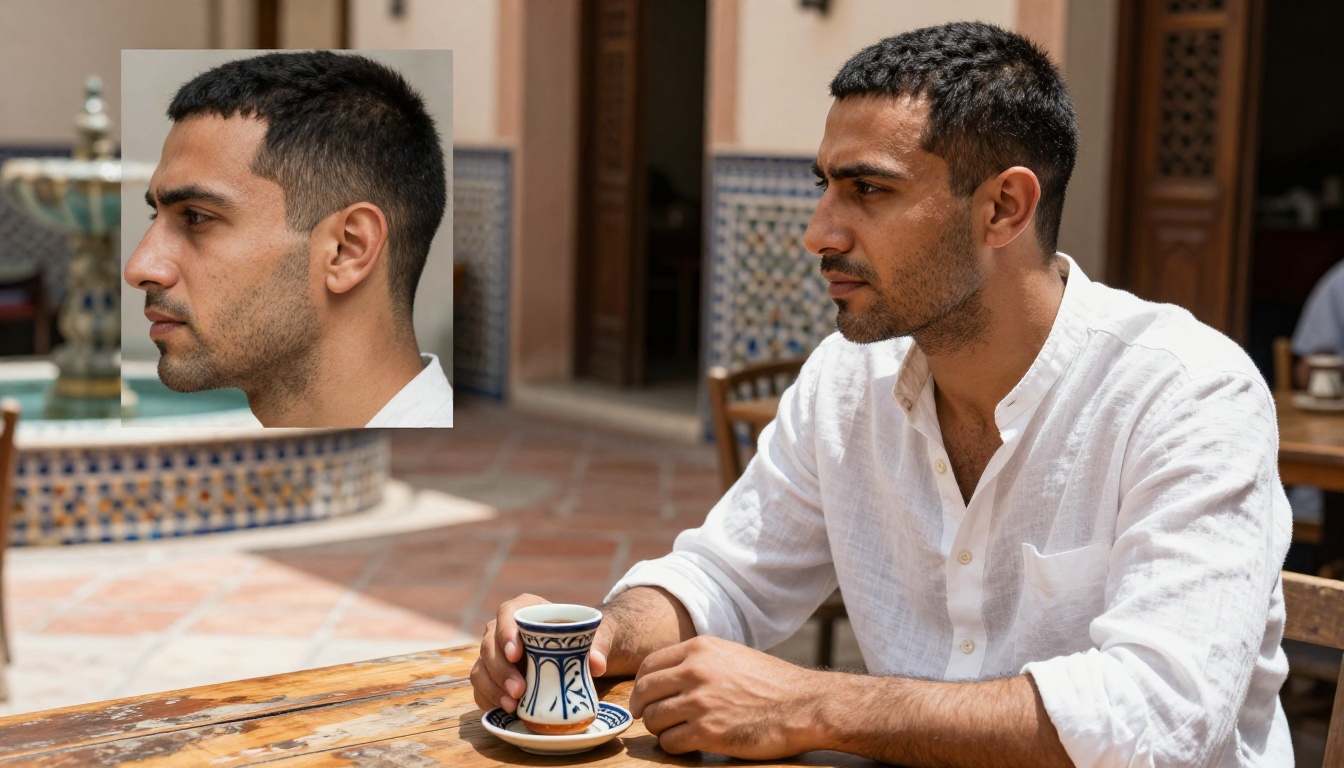
Kling 3.0 रेफ़रेंस इमेज कंडीशनिंग को एक प्रमुख फ़ीचर के रूप में पेश करता है। सिर्फ़ टेक्स्ट से यह बताने के बजाय कि आपका कैरेक्टर कौन है, आप एक असली रेफ़रेंस इमेज देते हैं। मॉडल उस इमेज से चेहरे की ज्यामिति, बालों की बनावट, त्वचा का रंग और पहचान की विशेषताएँ निकालता है और पूरी जनरेशन के दौरान उन्हें एक स्थायी एंकर की तरह इस्तेमाल करता है।
यह सीधा इमेज-टू-वीडियो एनिमेशन नहीं है जहाँ रेफ़रेंस इमेज पहला फ़्रेम बन जाती है। मॉडल पहचान की विशेषताएँ निकालता है और उन्हें बिल्कुल नए सीन, बिल्कुल नए कैमरा एंगल, पोज़ और रोशनी पर लागू करता है। रेफ़रेंस इमेज एक कैरेक्टर पासपोर्ट है, शुरुआती फ़्रेम नहीं।
सीन-दर-सीन टेम्पोरल बाइंडिंग
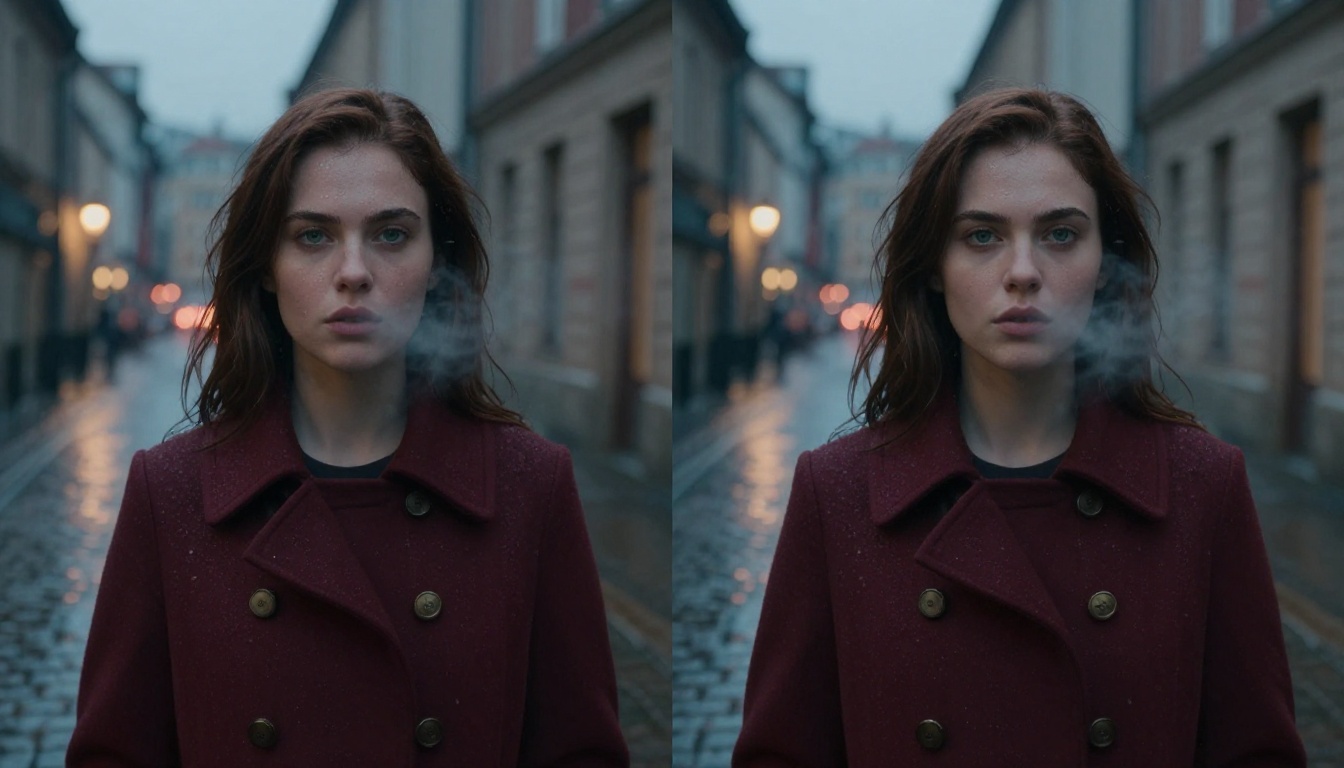
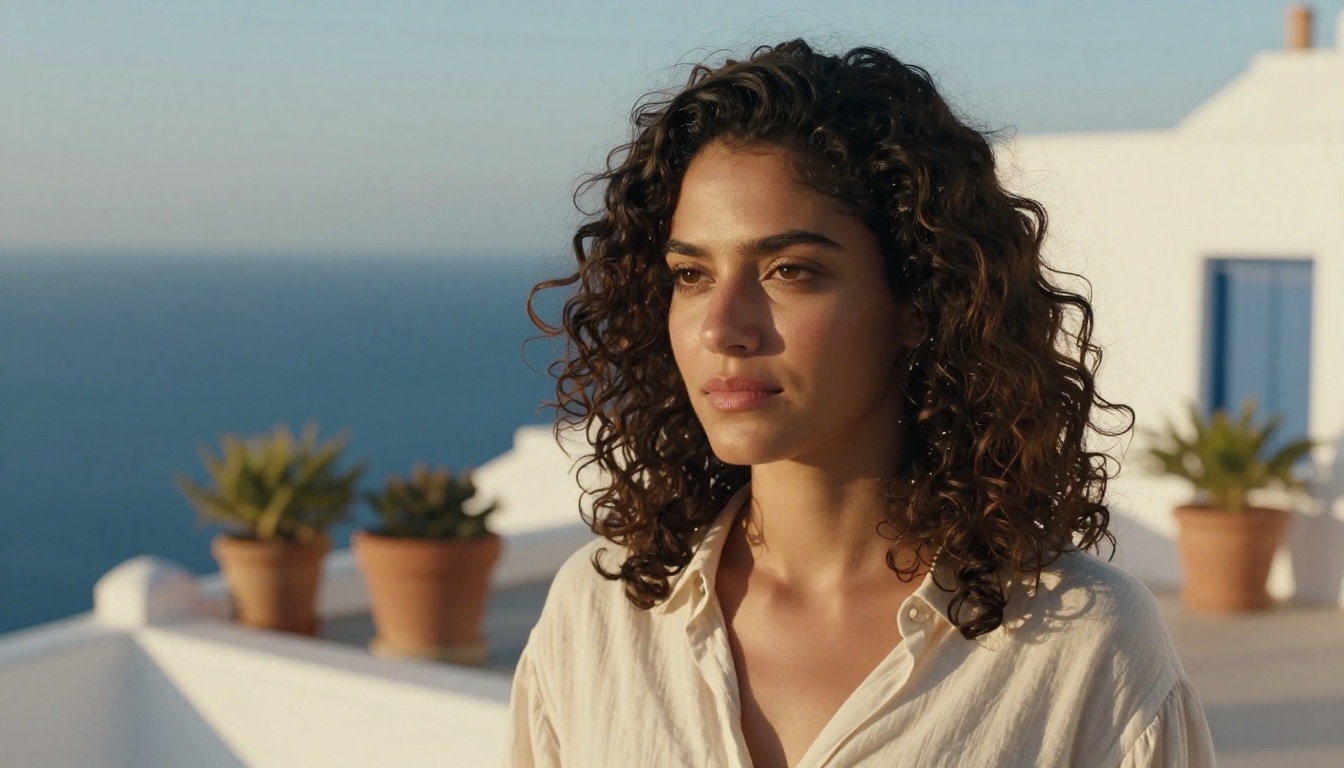
जब आप एक सीरीज़ में कई क्लिप जनरेट करते हैं, तो Kling 3.0 क्रॉस-सीन टेम्पोरल बाइंडिंग के ज़रिए पहचान का संदर्भ आगे ले जाने देता है। मॉडल हर क्लिप को खाली स्लेट की तरह नहीं लेता। वह कैरेक्टर की विज़ुअल पहचान का एन्कोडेड प्रतिनिधित्व आगे ले जाता है, ताकि पृष्ठभूमि बारिश वाली यूरोपीय गली से चमकते रेगिस्तानी लैंडस्केप में बदल जाए, तब भी स्क्रीन पर दिखने वाला व्यक्ति विज़ुअली एकसार बना रहे।
यह कुछ ठोस और मापने योग्य तरीकों से दिखता है:
- चेहरे के लैंडमार्क (आँखों के बीच की दूरी, नाक के पुल की चौड़ाई, जबड़े का आकार) क्लिप-दर-क्लिप संकीर्ण सीमाओं के भीतर रहते हैं
- बालों की मात्रा और लंबाई तब तक एक जैसी रहती है जब तक स्पष्ट रूप से बदलने का प्रॉम्प्ट न दिया जाए
- कपड़ों के विवरण, जिनमें बटन, कॉलर का प्रकार और कपड़े की बनावट शामिल हैं, कट्स के बावजूद बने रहते हैं
- त्वचा का रंग बहुत अलग-अलग रोशनी के तापमान में भी स्थिर रहता है
- शरीर का अनुपात (कंधों की चौड़ाई, माहौल के सापेक्ष ऊँचाई) सामान्य अंतर के भीतर रहता है
कपड़े और बनावट की स्मृति
Kling 3.0 के कंसिस्टेंसी सिस्टम का एक कम आँका गया पहलू यह है कि वह कपड़ों और मटीरियल की बनावट को कैसे संभालता है। पिछले मॉडल त्वचा के रंग को काफ़ी ठीक-ठाक बनाए रखते थे, लेकिन क्लिप के बीच कैरेक्टर की पोशाक को पूरी तरह नए सिरे से बना देते थे, कभी रंग पूरी तरह बदल देते थे, तो कभी परतें जोड़ या हटा देते थे।
Kling 3.0 कैरेक्टर की विज़ुअल पहचान को सिर्फ़ चेहरे का नहीं, बल्कि पूरे शरीर का हस्ताक्षर मानता है। अगर आपका कैरेक्टर पहले सीन में ब्रास बटन वाला बरगंडी कोट पहनता है, तो वह कोट, उन बटनों और उसी कपड़े की बनावट के साथ, दूसरे सीन में भी दिखेगा, भले ही बाकी माहौल पूरी तरह अलग हो।
Kling 3.0 के वे मॉडल जिन्हें जानना ज़रूरी है
PicassoIA आपको Kling 3.0 जनरेशन टूल्स के पूरे सेट तक सीधी पहुँच देता है। हर मॉडल कैरेक्टर कंसिस्टेंसी को आपके वर्कफ़्लो और आप किस तरह के सीन बना रहे हैं, उसके आधार पर थोड़ा अलग तरह से संभालता है।
Kling V3 Video
Kling V3 Video 3.0 जनरेशन का मुख्य टेक्स्ट-टू-वीडियो मॉडल है। यह टेक्स्ट प्रॉम्प्ट और वैकल्पिक रेफ़रेंस इमेज, दोनों स्वीकार करता है। कैरेक्टर कंसिस्टेंसी के काम के लिए यही आपकी शुरुआत है। आप अपने कैरेक्टर की रेफ़रेंस इमेज अपलोड करते हैं, अपना सीन प्रॉम्प्ट लिखते हैं, और मॉडल ऐसा वीडियो बनाता है जो पूरे समय रेफ़रेंस की पहचान बनाए रखता है।
यह कई तरह के परिदृश्यों को अच्छी तरह संभालता है: इनडोर से आउटडोर ट्रांज़िशन, क्लोज़-अप से वाइड-शॉट कैमरा बदलाव, और दिन से रात की रोशनी में बदलाव। इन सभी में कैरेक्टर पहचाना जाने लायक बना रहता है। ज़्यादातर सिंगल-कैरेक्टर नैरेटिव प्रोजेक्ट्स के लिए, Kling V3 Video वह जगह है जहाँ आप अपना ज़्यादातर जनरेशन समय बिताएँगे।
Kling V3 Omni Video
Kling V3 Omni Video टेक्स्ट और इमेज, दोनों इनपुट एक साथ सपोर्ट करके कोर V3 क्षमताओं को आगे बढ़ाता है। यह खास तौर पर तब उपयोगी है जब आप पहले किसी सीन को विज़ुअली स्थापित करना चाहते हैं और फिर ऐसा वीडियो बनाना चाहते हैं जो कैरेक्टर की पहचान और माहौल की विज़ुअल भाषा, दोनों बनाए रखे।
मल्टी-सीन प्रोजेक्ट्स के लिए, जहाँ आपने अपनी लोकेशन की रेफ़रेंस इमेज पहले ही बना ली हैं, Kling V3 Omni Video आपको दोनों सिरों पर एक साथ सख्त कंसिस्टेंसी कंट्रोल के साथ कैरेक्टर और माहौल को एक साथ लाने देता है।
Kling V3 Motion Control
Kling V3 Motion Control कैरेक्टर कंसिस्टेंसी सिस्टम के ऊपर पोज़ और मूवमेंट की दिशा की एक परत जोड़ता है। यहीं Kling 3.0 सचमुच सिनेमाई बन जाता है। आप कैमरा पाथ, कैरेक्टर की मूवमेंट ट्रैजेक्टरी और इंटरैक्शन डायनामिक्स तय कर सकते हैं, जबकि मॉडल कैरेक्टर की विज़ुअल पहचान को जगह पर बनाए रखता है।
अगर आपकी कहानी में कैरेक्टर को किसी सीन में चलना हो, कैमरे की ओर मुड़ना हो, या किसी दूसरे तत्व के साथ शारीरिक रूप से इंटरैक्ट करना हो, तो Kling V3 Motion Control पहचान की सटीकता से समझौता किए बिना मूवमेंट की कोरियोग्राफ़ी संभालता है।
PicassoIA पर Kling 3.0 कैसे इस्तेमाल करें
PicassoIA आपको एक ही इंटरफ़ेस से तीनों Kling 3.0 मॉडल तक पहुँच देता है, बिना किसी API सेटअप, लोकल GPU की ज़रूरत या जटिल कॉन्फ़िगरेशन के।
स्टेप 1: अपना कैरेक्टर रेफ़रेंस अपलोड करें
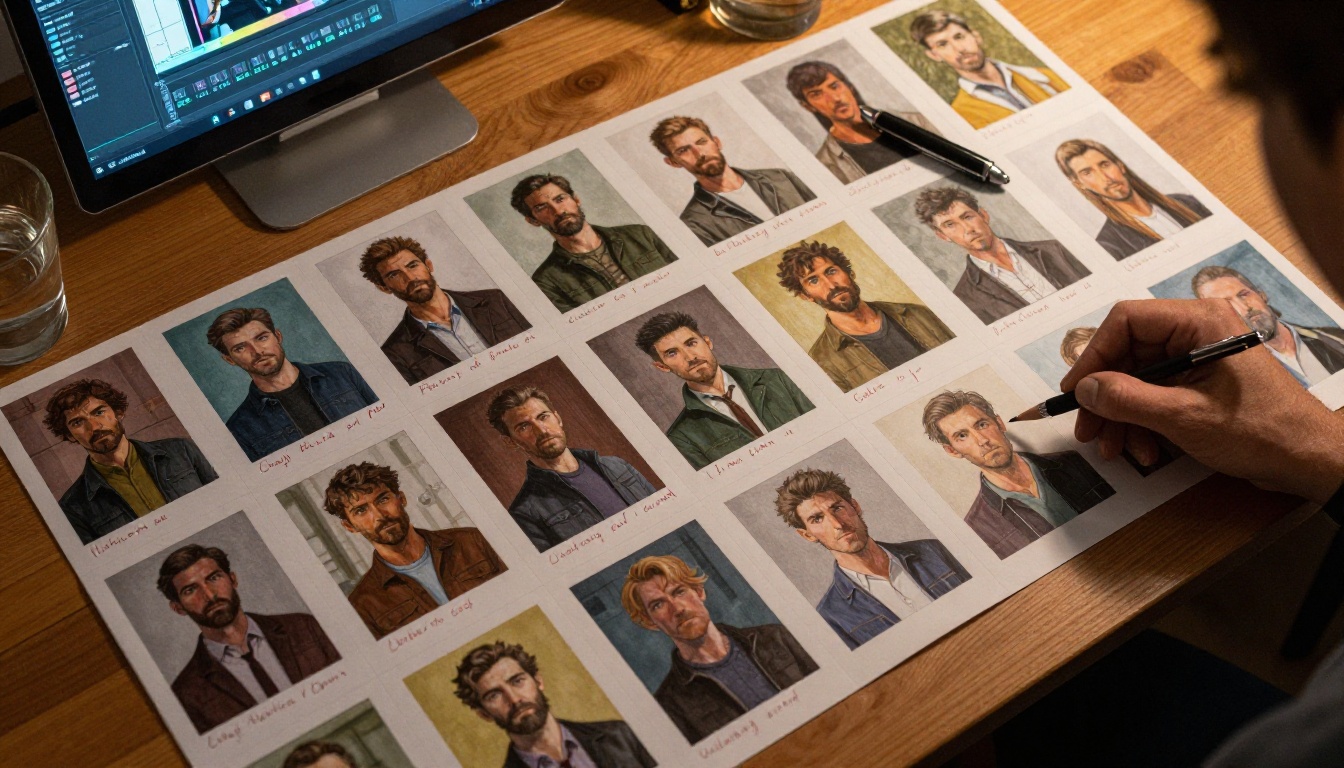
एक भी प्रॉम्प्ट लिखने से पहले, अपने कैरेक्टर की एक साफ़ रेफ़रेंस इमेज बनाएँ या ढूँढें। इस रेफ़रेंस इमेज की गुणवत्ता सीधे तय करती है कि सीन-दर-सीन आपका कैरेक्टर कितना एकसार रहेगा। इसे ऐसा होना चाहिए कि:
- कैरेक्टर को एक न्यूट्रल एंगल से दिखाए (लगभग आँखों के स्तर पर, कैमरे की ओर चेहरा करके)
- पूरा चेहरा दिखाए, जिसमें पहचान की विशेषताओं को ढकने वाली भारी परछाइयाँ न हों
- वे कपड़े और एक्सेसरी दिखाए जिन्हें आप सीन-दर-सीन बनाए रखना चाहते हैं
- हाई रिज़ॉल्यूशन हो, ताकि मॉडल के पास भरोसेमंद पहचान सिग्नेचर निकालने लायक पर्याप्त विवरण हों
अगर आपके पास कोई शुरुआती फ़ोटो नहीं है, तो आप पहले PicassoIA के किसी भी टेक्स्ट-टू-इमेज मॉडल से यह रेफ़रेंस इमेज बना सकते हैं। एक साफ़, अच्छी रोशनी वाला पोर्ट्रेट जनरेट करें और उसे अपना एंकर बनाएँ।
स्टेप 2: एक ही कैरेक्टर से जुड़े सीन प्रॉम्प्ट लिखें
आपके टेक्स्ट प्रॉम्प्ट में सीन और एक्शन का वर्णन होना चाहिए, कैरेक्टर का दोबारा वर्णन नहीं। चूँकि रेफ़रेंस इमेज पहचान की जानकारी रखती है, आपका प्रॉम्प्ट पूरी तरह इन पर केंद्रित हो सकता है:
- सेटिंग (लोकेशन, दिन का समय, मौसम, इनडोर बनाम आउटडोर)
- एक्शन (इस खास सीन में कैरेक्टर क्या कर रहा है)
- कैमरा एंगल (क्लोज़-अप, वाइड एस्टैब्लिशिंग शॉट, लो एंगल, एरियल)
- मूड (रोशनी की गुणवत्ता, कलर टेम्परेचर, भावनात्मक माहौल)
अपने प्रॉम्प्ट में कैरेक्टर के शारीरिक विवरण दोहराने से बचें। अगर आप प्रॉम्प्ट में "auburn-haired woman" लिखते हैं और मॉडल रेफ़रेंस इमेज पर भरोसा करने के बजाय उसे आंशिक रूप से टेक्स्ट में समझ लेता है, तो इससे सूक्ष्म ड्रिफ़्ट आ सकता है। पहचान का काम पूरी तरह इमेज को करने दें।
💡 टिप: प्रॉम्प्ट ऐसे लिखें जैसे किसी निर्देशक को फ़िल्म का सीन बता रहे हों, जो पहले से जानता है कि एक्टर कौन है। पूरा ध्यान विज़ुअल दिशा, सेटिंग, एक्शन और कैमरा वर्क पर रखें। कास्टिंग का ज़िक्र कभी न करें।
स्टेप 3: सीन जनरेट करें और उन्हें जोड़ें
एक बार आपकी पहली क्लिप बन जाए, तो बाद के सीन जनरेट करने के लिए Kling V3 Omni Video का इस्तेमाल करें। हर नए सीन प्रॉम्प्ट के साथ वही मूल रेफ़रेंस इमेज अपलोड करें। पिछली क्लिप के आख़िरी फ़्रेम को अगली क्लिप का रेफ़रेंस न बनाएँ, क्योंकि हर नया "रेफ़रेंस" पहले से थोड़ा अलग होता है, इसलिए इससे धीमा ड्रिफ़्ट बनता है जो कई सीन में जुड़ता जाता है।
जटिल मूवमेंट वाले सीक्वेंस के लिए, Kling V3 Motion Control पर जाएँ और मूवमेंट पैरामीटर जोड़ें, जबकि वही मूल कैरेक्टर रेफ़रेंस लॉक रहे।
जहाँ Kling 3.0 प्रतिस्पर्धा से आगे है
कैरेक्टर कंसिस्टेंसी पर कई AI वीडियो प्लेटफ़ॉर्म सक्रिय रूप से काम कर रहे हैं, लेकिन Kling 3.0 कुछ खास क्षेत्रों में खुद को अलग करता है, जो मल्टी-सीन प्रोडक्शन के लिए सबसे अहम हैं।
| फ़ीचर | Kling 3.0 | अन्य मॉडल |
|---|
| रेफ़रेंस इमेज कंडीशनिंग | नेटिव, इन-बिल्ट | आंशिक या पोस्ट-प्रोसेस |
| फ़ुल-बॉडी कंसिस्टेंसी | हाँ (चेहरा + कपड़े) | आमतौर पर सिर्फ़ चेहरा |
| अलग-अलग रोशनी में पहचान की स्थिरता | मज़बूत | मध्यम |
| पहचान बनाए रखते हुए मूवमेंट | हाँ (Motion Control) | सीमित |
| मल्टी-सीन चेनिंग वर्कफ़्लो | हाँ | सिंगल-क्लिप केंद्रित |
| अवतार-विशिष्ट टूल्स | हाँ (Kling Avatar V2) | दुर्लभ |
प्रतिस्पर्धी सिंगल-क्लिप कैरेक्टर जनरेशन को काफ़ी अच्छी तरह संभालते हैं। Kling 3.0 वहाँ आगे निकलता है जहाँ मल्टी-क्लिप, मल्टी-एनवायरनमेंट वर्कफ़्लो चाहिए, यानी जहाँ एक ही व्यक्ति को कई सीन में पूरी कहानी का आर्क निभाना हो।
Seedance 2.0 और Veo 3.1 जैसे मॉडल कच्ची वीडियो क्वालिटी में उत्कृष्ट हैं, लेकिन इन्हें सीन-दर-सीन कैरेक्टर की निरंतरता के लिए खास तौर पर अनुकूलित नहीं किया गया है। ये अलग-अलग क्लिप की क्वालिटी में आगे हैं। Kling 3.0 शुरुआत से ही मल्टी-सीन प्रोडक्शन के इस्तेमाल को ध्यान में रखकर बनाया गया है।
असली दुनिया के इस्तेमाल के मामले
शॉर्ट फ़िल्में और माइक्रो-सीरीज़
स्वतंत्र फ़िल्ममेकर अब नियमित रूप से बार-बार आने वाले कैरेक्टर के साथ छोटी नैरेटिव फ़िल्में बनाने के लिए Kling V3 Video का इस्तेमाल करते हैं। पाँच मिनट की एक शॉर्ट फ़िल्म में 25 से 35 अलग-अलग क्लिप लग सकती हैं। कैरेक्टर कंसिस्टेंसी के बिना, हर क्लिप को पूरी फ़िल्म में विज़ुअल एकरूपता बनाए रखने के लिए भारी पोस्ट-प्रोडक्शन कलर ग्रेडिंग और फ़ेस-मैचिंग की ज़रूरत पड़ती है। Kling 3.0 उस ओवरहेड को बहुत कम कर देता है, जिससे एक व्यक्ति पहले की तुलना में बहुत कम समय में पूरी तरह एकसार शॉर्ट फ़िल्म बना सकता है।
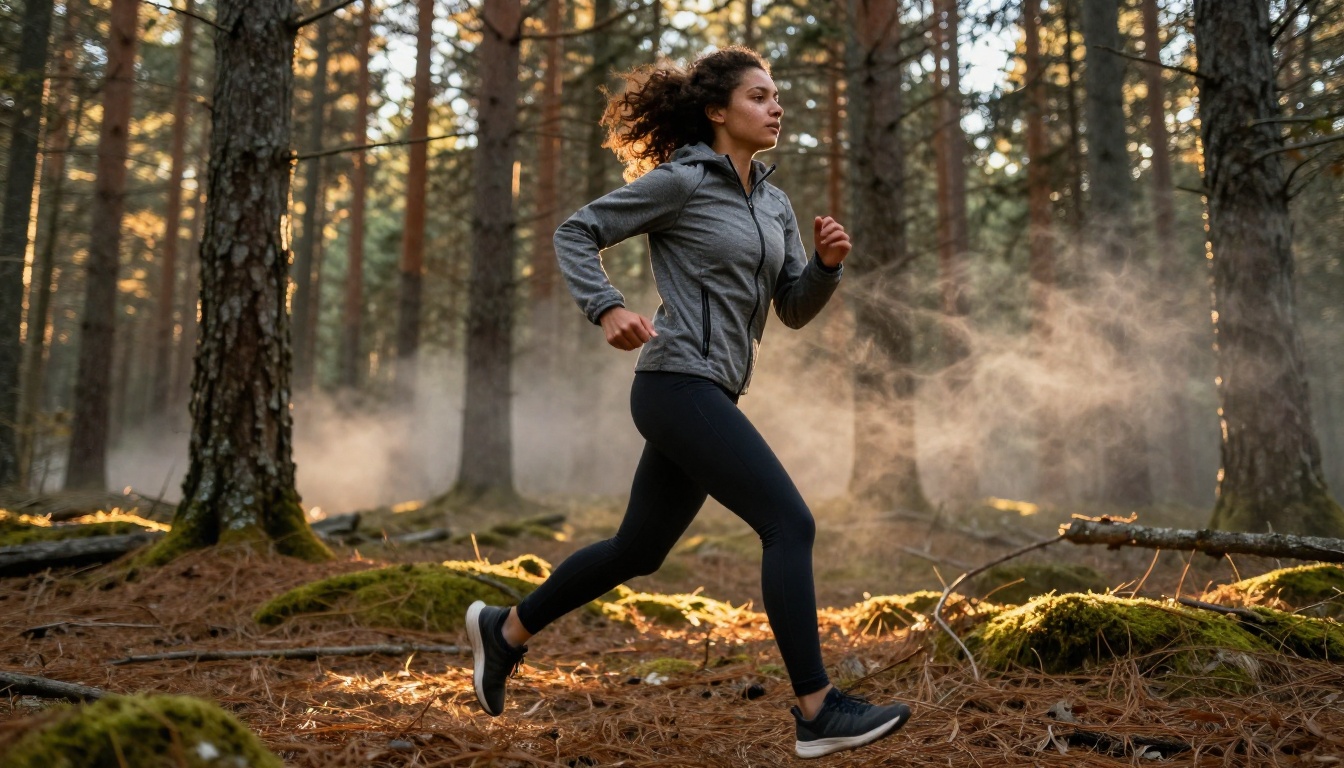
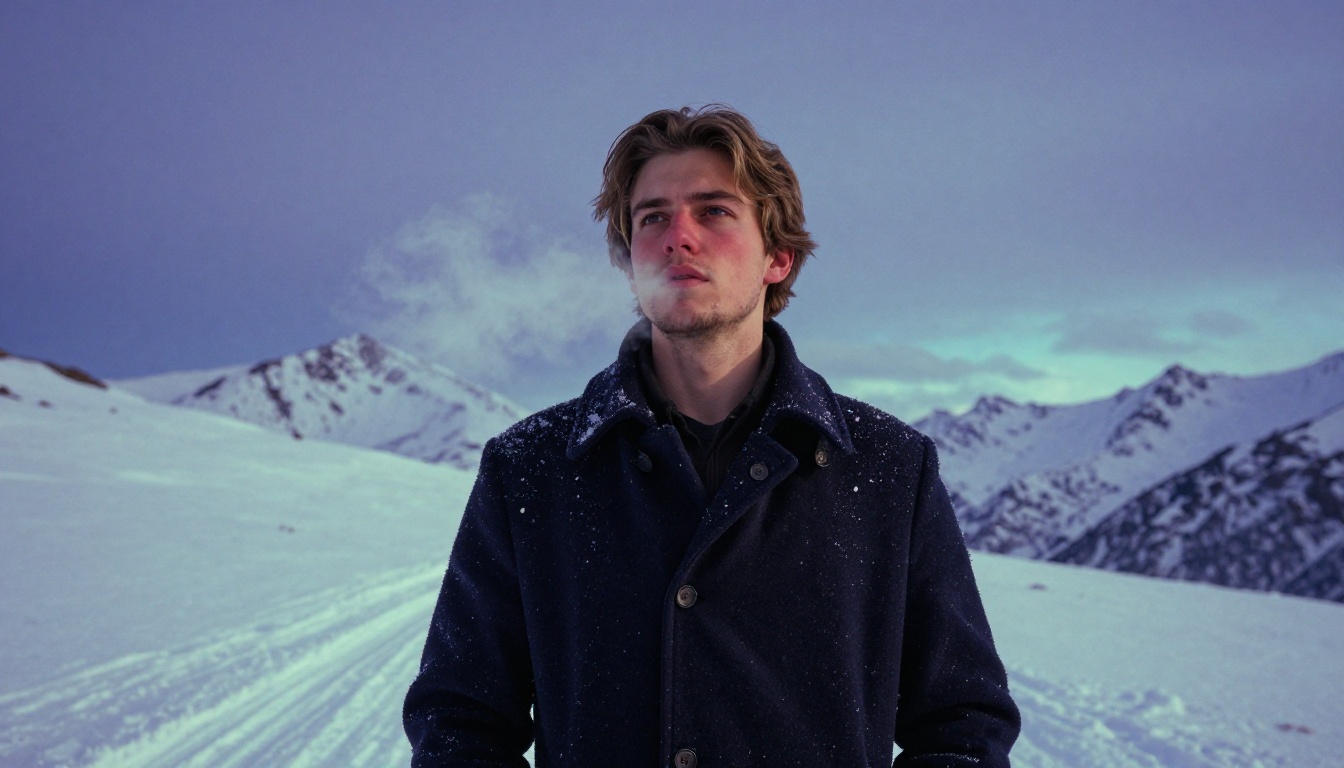
एक कैरेक्टर एक के बाद एक क्लिप में जंगल में चल सकता है, शहर की सड़क पर निकल सकता है, और बर्फ़ से ढके पहाड़ी दर्रे पर पहुँच सकता है, और पूरे समय बिल्कुल एक जैसा दिखता है।
ब्रांड स्टोरीटेलिंग
मार्केटिंग टीमों के लिए, कैरेक्टर कंसिस्टेंसी का मतलब है कि ब्रांड का मैस्कॉट या प्रवक्ता महँगी रीशूट या सख्त शॉट-मैचिंग बाधाओं के बिना कई विज्ञापन स्पॉट, सोशल क्लिप और वेब कंटेंट में दिखाई दे सकता है। वही चेहरा, वही पोशाक की पहचान, वही शारीरिक उपस्थिति, जो उस खास कंटेंट के लिए ज़रूरी माहौल पर लागू हो।
सीज़नल कैंपेन के लिए इसके मायने बड़े हैं। एक ब्रांड कैरेक्टर गर्मियों के समुद्र-तट वाले कंटेंट और सर्दियों की छुट्टियों वाले कंटेंट, दोनों में एक जैसी विज़ुअल पहचान के साथ दिख सकता है, न कोई स्टूडियो बुकिंग, न किसी एक्टर की उपलब्धता की बातचीत, न लोकेशन की खोज।
बड़े पैमाने पर कंटेंट निर्माण
YouTube सीरीज़, Instagram नैरेटिव या सोशल प्लेटफ़ॉर्म पर एपिसोडिक कंटेंट बनाने वाले क्रिएटर्स को Kling 3.0 के कंसिस्टेंसी सिस्टम से सीधा फ़ायदा होता है। किसी काल्पनिक कैरेक्टर के आसपास दर्शक बनाने के लिए ज़रूरी है कि वह कैरेक्टर थंबनेल से थंबनेल और क्लिप से क्लिप तुरंत पहचाना जा सके। Kling 3.0 उस पहचान को संयोग के बजाय भरोसेमंद बनाता है।
Kling 3.0 अब भी क्या नहीं कर सकता
Kling 3.0 की कैरेक्टर कंसिस्टेंसी सचमुच प्रभावशाली है, लेकिन किसी पूरे प्रोडक्शन की योजना उसके आधार पर बनाने से पहले कुछ असली सीमाएँ जानने लायक हैं।
जानबूझकर कैरेक्टर में बदलाव के लिए मैन्युअल हस्तक्षेप की ज़रूरत पड़ती है। अगर आपकी कहानी में कैरेक्टर को सीन-दर-सीन स्पष्ट रूप से बूढ़ा होना है, कहानी के बीच में उसका हेयरकट बदलना है, या कपड़े नाटकीय रूप से बदलने हैं, तो आपको कैरेक्टर के उन संस्करणों के लिए अपडेटेड रेफ़रेंस इमेज बनानी होंगी। कंसिस्टेंसी सिस्टम रेफ़रेंस से किसी भी विचलन को रचनात्मक चुनाव के बजाय सुधारने लायक चीज़ मानता है।
मल्टी-कैरेक्टर सीन जिनमें दो या अधिक एकसार कैरेक्टर हों, संभालना ज़्यादा जटिल है। मॉडल सिंगल-कैरेक्टर पहचान एंकरिंग को भरोसेमंद ढंग से संभालता है। जब आप अपनी अलग रेफ़रेंस इमेज वाला दूसरा कैरेक्टर जोड़ते हैं, तो दो-शॉट कंपोज़िशन में दोनों कैरेक्टर के बीच पहचान का मिश्रण हो सकता है, खासकर तब जब दोनों के शारीरिक लक्षण मिलते-जुलते हों।
अत्यधिक कैमरा परिप्रेक्ष्य जिन स्थितियों को रेफ़रेंस इमेज कवर नहीं करती, जैसे सीधे ऊपर से, ठीक पीछे से, या ठोड़ी के नीचे से बहुत नीचे का एंगल, उनमें परिणाम कम भरोसेमंद होते हैं। रेफ़रेंस इमेज उन स्थितियों से कैरेक्टर कैसा दिखता है, इसकी सीमित जानकारी देती है, इसलिए मॉडल उन खाली जगहों को ज़्यादा रचनात्मक व्याख्या से भरता है।
💡 नोट: ये V3 जनरेशन की मौजूदा सीमाएँ हैं। Kling के हर रिलीज़ ने कंसिस्टेंसी की बाधाओं को काफ़ी कसा है। मल्टी-कैरेक्टर पहचान नियंत्रण को उनके अगले आर्किटेक्चर संस्करण का मुख्य फ़ोकस बताया गया है।
अभी अपने कैरेक्टर खुद बनाएँ
AI-जनरेटेड वीडियो सीन में पूरी तरह एकसार कैरेक्टर बनाने की तकनीक आज उपलब्ध है, और PicassoIA आपके और प्रोडक्शन-क्वालिटी आउटपुट के बीच कोई तकनीकी बाधा रखे बिना इसे आपकी पहुँच में ले आता है।
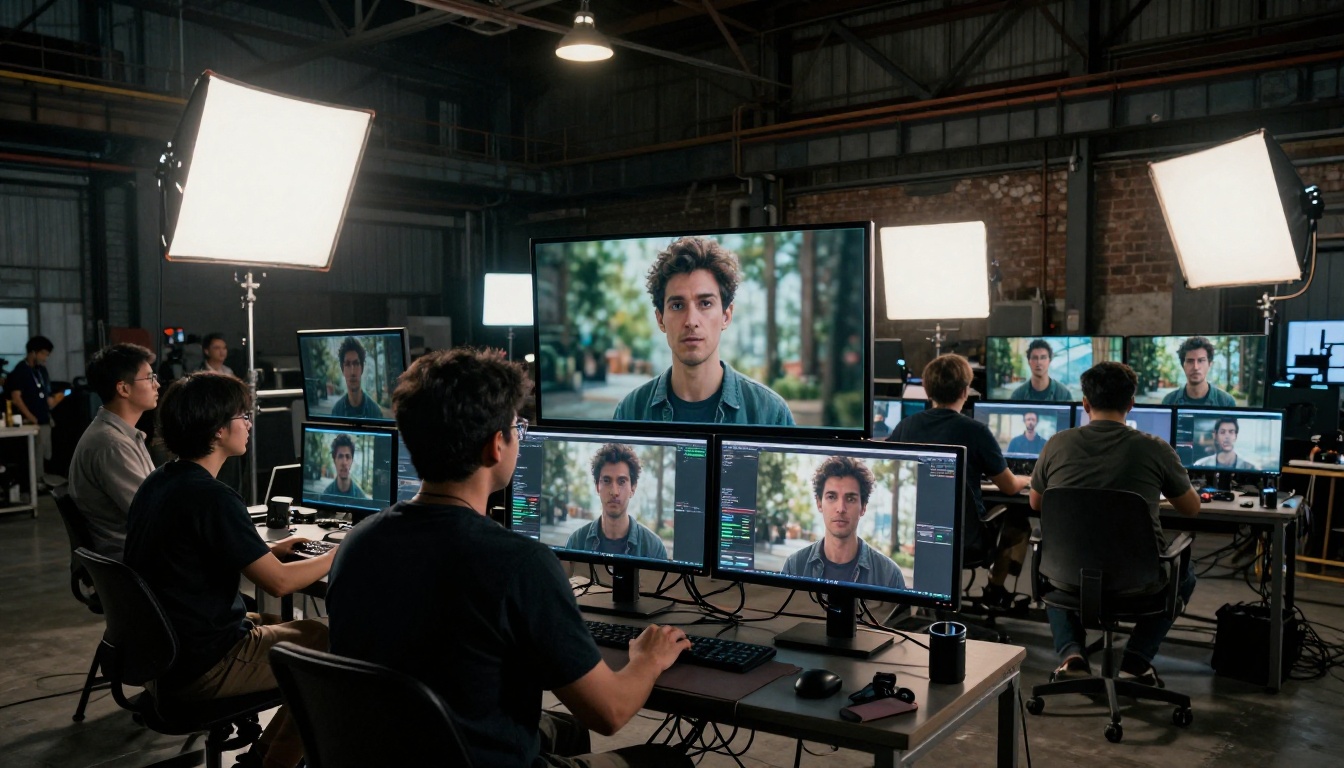
PicassoIA पर Kling V3 Video खोलें, उस कैरेक्टर की रेफ़रेंस इमेज अपलोड करें जिसके इर्द-गिर्द आप कहानी बनाना चाहते हैं, और अपना पहला सीन जनरेट करें। फिर वही रेफ़रेंस इमेज लेकर बिल्कुल अलग माहौल में अगला सीन जनरेट करें। कंसिस्टेंसी तुरंत साफ़ दिखेगी, और वर्कफ़्लो पहली कोशिश से ही सहज लगेगा।
जटिल मूवमेंट वाली कहानियों के लिए, पहचान एंकरिंग के ऊपर कैमरा मूवमेंट और कैरेक्टर कोरियोग्राफ़ी जोड़ने के लिए Kling V3 Motion Control आज़माएँ। और अगर आप अवतार-विशिष्ट पर्सनलाइज़ेशन को और आगे ले जाना चाहते हैं, तो Kling Avatar V2 कैरेक्टर पर्सनलाइज़ेशन को एक पूरक दिशा में ले जाता है, जिसे आज़माने लायक है।
ऐसे डिस्पोज़ेबल AI कैरेक्टर का दौर खत्म हो चुका है जो हर क्लिप में अलग दिखते थे। Kling 3.0 कैरेक्टर की पहचान को ऐसी चीज़ बनाता है जिसे आप सचमुच अपना बना सकते हैं और पूरी कहानी में, सीन दर सीन, माहौल दर माहौल, बिना समझौते के बनाए रख सकते हैं।


