Kling 3.0 est arrivé discrètement, mais ce qu’il apporte change la façon dont les réalisateurs qui travaillent avec l’IA pensent la narration. La cohérence des personnages, c’est-à-dire la capacité d’un modèle de vidéo par IA à garder exactement le même visage sur plusieurs scènes et environnements, était toujours la pièce manquante. Kling 3.0 fait en sorte qu’elle ressemble moins à un contournement technique et davantage à une capacité naturelle, intégrée directement au processus de génération.
Si vous avez déjà tenté de construire une histoire en plusieurs scènes avec un outil de vidéo par IA, vous connaissez déjà la frustration. Dans un premier plan, votre personnage a la bonne mâchoire, les bons yeux, la bonne veste. Dans le plan suivant, c’est quelqu’un d’autre. Kling 3.0 prend ce problème au sérieux, et les résultats sont la preuve la plus claire à ce jour que la vidéo générée par IA est prête pour un véritable travail narratif.
Le problème qui freinait la vidéo par IA
Qu’est-ce que la dérive de personnage
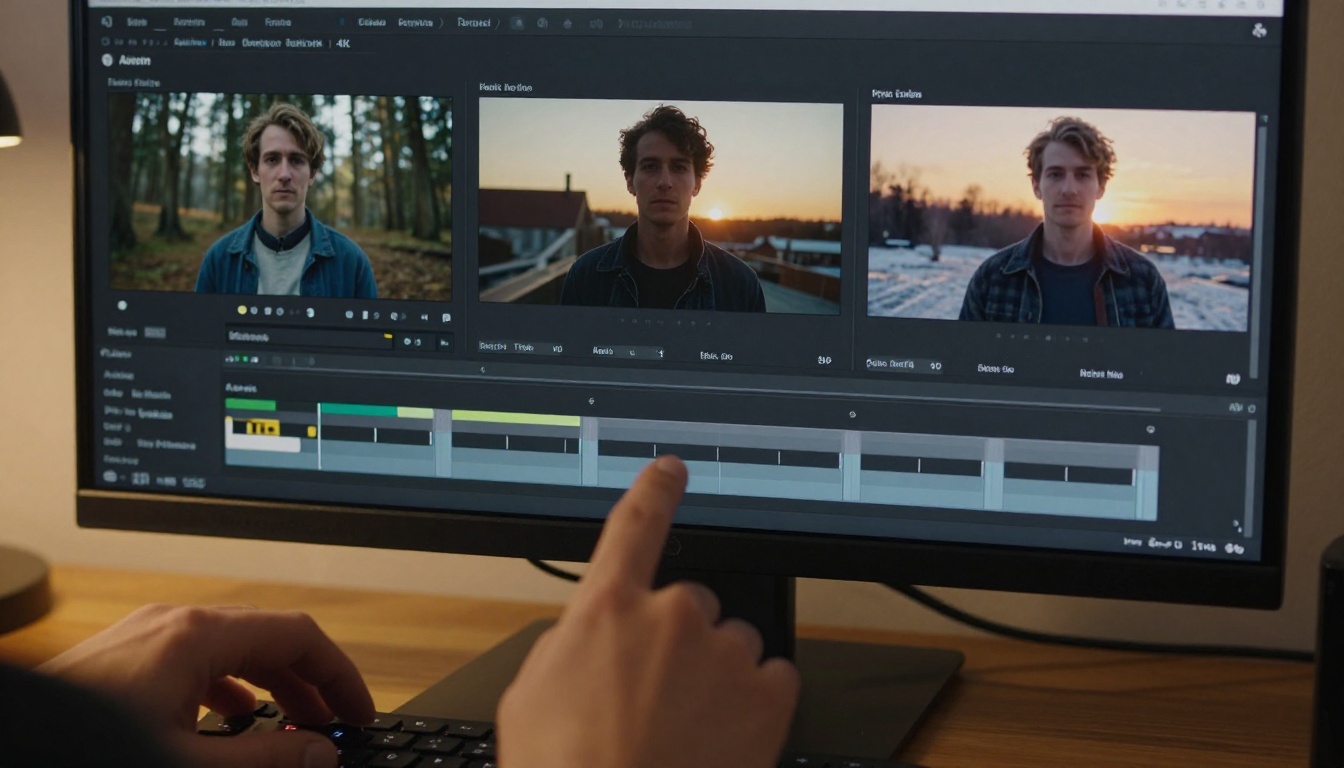
La dérive de personnage se produit lorsqu’un modèle d’IA génère un nouveau plan vidéo censé présenter la même personne qu’un plan précédent, mais que le résultat montre quelqu’un de subtilement ou radicalement différent. Le nez change. Les cheveux raccourcissent. Le teint se modifie. La veste a des boutons différents.
Ce n’est pas un petit problème pour quiconque essaie de raconter une histoire à travers plusieurs plans. Un protagoniste qui change d’apparence à chaque scène n’est pas un protagoniste : c’est une personne différente à chaque plan. Cette rupture de continuité visuelle est le plus grand obstacle entre la vidéo par IA et une véritable narration cinématographique, et c’est pourquoi la plupart des films générés par IA avant Kling 3.0 ressemblaient davantage à des montages d’ambiance qu’à des récits cohérents.
Pourquoi les modèles précédents échouaient
La plupart des modèles de vidéo par IA antérieurs génèrent chaque plan comme un événement isolé. Ils traitent un prompt textuel, génèrent des images et produisent une vidéo sans aucune mémoire persistante de l’identité du personnage dans le plan précédent. Même si vous utilisez le même prompt mot pour mot, la nature stochastique des modèles de diffusion fait varier le résultat, parfois légèrement, parfois de façon spectaculaire.
Quelques solutions de contournement existaient : fournir la dernière image d’un plan comme première image du suivant, ou utiliser un ancrage de pose de type ControlNet pour maintenir la position du corps. Mais elles étaient fragiles. Elles cédaient face aux changements d’éclairage, aux variations d’angle de caméra et à tout mouvement important qui faisait sortir le personnage d’une pose donnée.
💡 Le problème central : les prompts textuels ne transportent pas assez d’informations d’identité pour ancrer un visage de façon fiable à travers plusieurs générations. Une description comme « femme grande aux cheveux auburn » laisse une marge d’interprétation énorme, et chaque génération l’interprète différemment selon le seed choisi au moment de la génération.
L’ampleur du problème
Pour mesurer la gravité de la situation, pensez à ce que demande la production d’un court-métrage de trois minutes. À raison de 10 secondes par plan, il faut au minimum 18 plans. Avec une dérive modeste à chaque génération, au plan 10, vous obtenez quelqu’un qui ressemble à peine à votre personnage d’origine. Le travail de post-production nécessaire pour corriger manuellement cette dérive (rotoscopie, étalonnage des couleurs, plugins de correction de visage) rendait la vidéo par IA coûteuse précisément dans les domaines où elle était censée faire gagner du temps.
Ce que Kling 3.0 fait différemment
Ancrage d’identité par référence
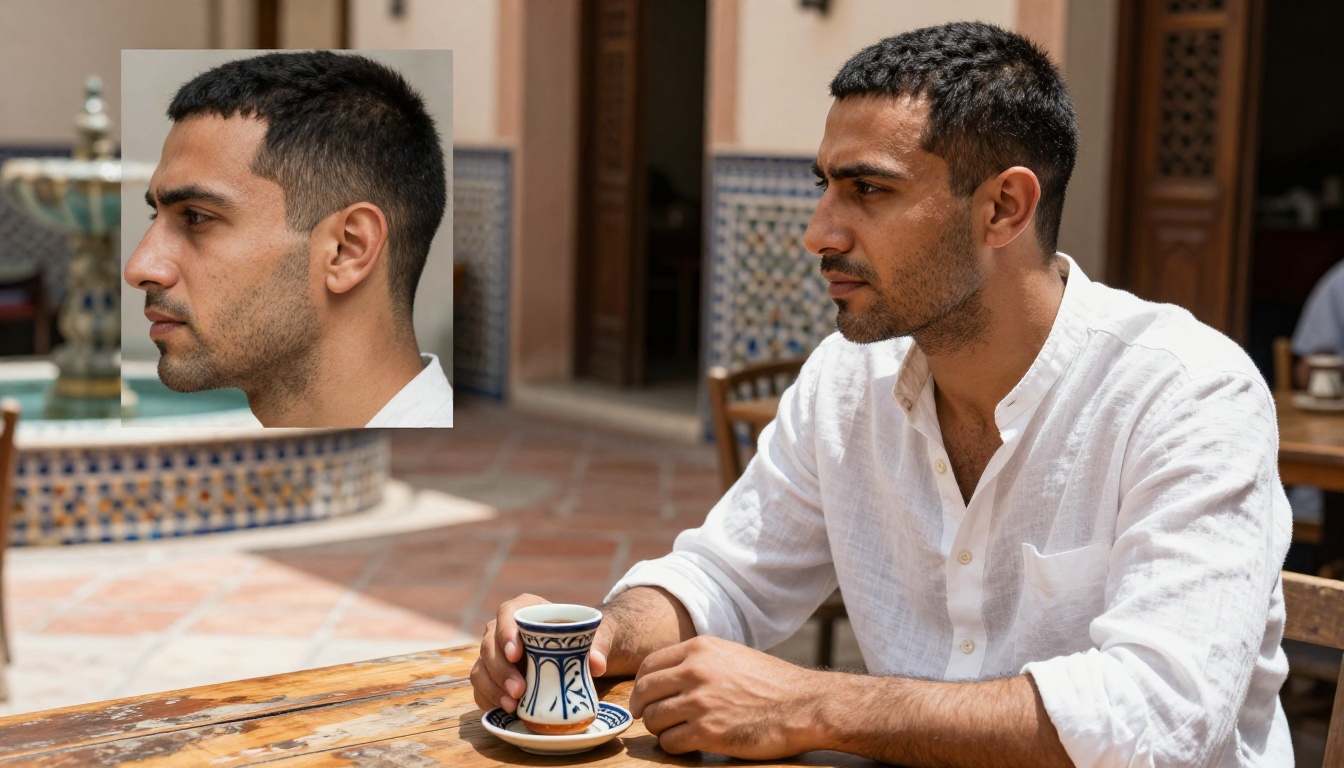
Kling 3.0 introduit le conditionnement par image de référence comme fonctionnalité de premier plan. Au lieu de s’appuyer uniquement sur le texte pour décrire votre personnage, vous fournissez une véritable image de référence. Le modèle analyse la géométrie du visage, la texture des cheveux, le teint et les traits identifiants de cette image, puis les utilise comme ancre persistante tout au long de la génération.
Il ne s’agit pas d’une simple animation d’image vers vidéo où l’image de référence devient la première image. Le modèle extrait des caractéristiques d’identité et les applique à des scènes entièrement nouvelles, avec des angles de caméra, des poses et des conditions d’éclairage entièrement nouveaux. L’image de référence est un passeport d’identité pour le personnage, et non une image de départ.
Liaison temporelle inter-scènes
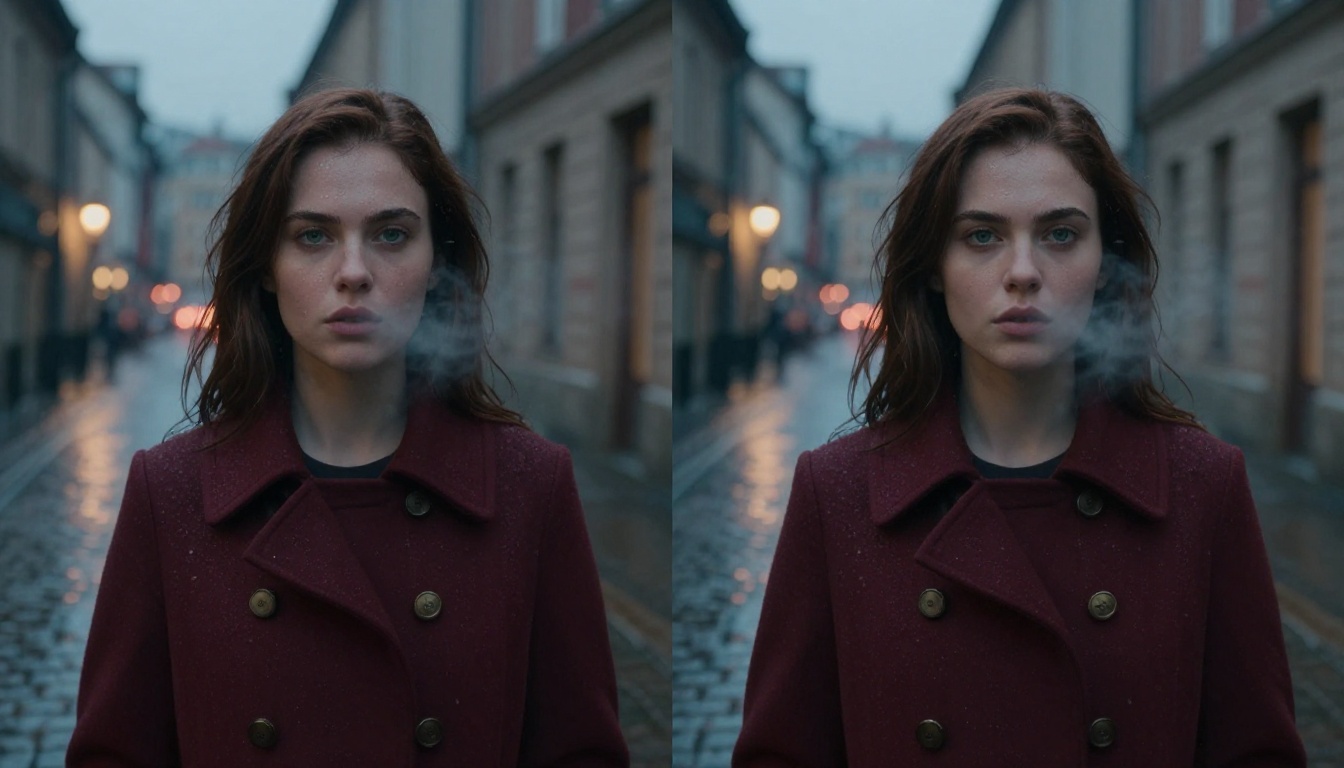
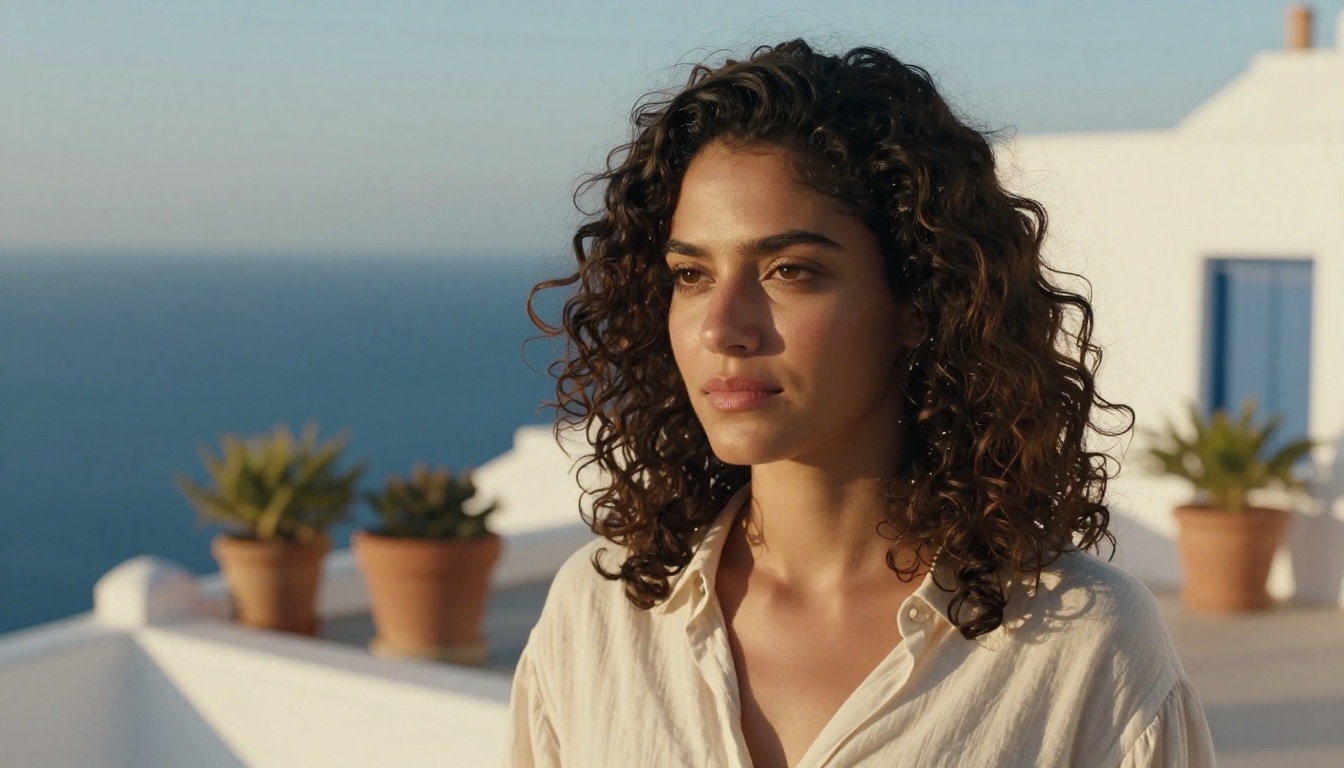
Lorsque vous générez plusieurs plans d’une même série, Kling 3.0 vous permet de transmettre le contexte d’identité d’un plan à l’autre grâce à la liaison temporelle inter-scènes. Le modèle ne traite pas chaque plan comme une page blanche. Il conserve une représentation encodée de l’identité visuelle du personnage, ce qui garantit que, même lorsque l’arrière-plan passe d’une rue européenne pluvieuse à un paysage désertique lumineux, la personne à l’écran reste visuellement cohérente.
Cela se traduit par des effets précis et mesurables :
- Les repères faciaux (écart entre les yeux, largeur de l’arête du nez, forme de la mâchoire) restent dans des marges étroites d’un plan à l’autre
- Le volume et la longueur des cheveux restent constants, sauf si vous demandez explicitement un changement
- Les détails vestimentaires, y compris les boutons, le type de col et la texture du tissu, persistent d’un plan à l’autre
- Le teint reste stable malgré des températures de lumière très différentes
- Les proportions du corps (largeur des épaules, taille par rapport à l’environnement) restent dans une variation normale
Mémoire des vêtements et des textures
L’un des aspects les plus sous-estimés du système de cohérence de Kling 3.0 concerne la gestion des vêtements et des textures des matières. Les modèles précédents conservaient assez bien le teint, mais réinventaient complètement la tenue du personnage d’un plan à l’autre, en changeant parfois la couleur, en ajoutant ou en retirant des couches.
Kling 3.0 traite l’identité visuelle du personnage comme une signature de tout le corps, et pas seulement comme une signature du visage. Si votre personnage porte un manteau bordeaux à boutons en laiton dans la première scène, ce manteau, avec ces boutons et cette texture de tissu, réapparaîtra dans la deuxième scène, même si le reste de l’environnement est entièrement différent.
Les modèles Kling 3.0 à connaître
PicassoIA vous donne un accès direct à l’ensemble des outils de génération Kling 3.0. Chaque modèle gère la cohérence des personnages un peu différemment, selon votre flux de travail et le type de scènes que vous construisez.
Kling V3 Video
Kling V3 Video est le modèle principal de texte vers vidéo de la génération 3.0. Il accepte à la fois un prompt textuel et une image de référence facultative. Pour un travail sur la cohérence des personnages, c’est votre point de départ. Vous importez une image de référence de votre personnage, rédigez le prompt de votre scène, et le modèle produit une vidéo qui préserve l’identité de la référence tout au long du plan.
Il gère bien un large éventail de situations : transitions d’intérieur à extérieur, passages du gros plan au plan large, et changements d’éclairage du jour à la nuit. Le personnage reste reconnaissable dans tous ces cas. Pour la plupart des projets narratifs à un seul personnage, Kling V3 Video est l’outil auquel vous consacrerez la majorité de votre temps de génération.
Kling V3 Omni Video
Kling V3 Omni Video étend les capacités de base de V3 avec la prise en charge simultanée d’entrées textuelles et d’images. Cela le rend particulièrement utile lorsque vous voulez d’abord établir visuellement une scène, puis générer une vidéo qui conserve à la fois l’identité du personnage et le langage visuel de l’environnement.
Pour les projets en plusieurs scènes où vous avez déjà généré des images de référence de vos lieux, Kling V3 Omni Video vous permet de réunir le personnage et l’environnement avec un contrôle serré de la cohérence des deux côtés à la fois.
Kling V3 Motion Control
Kling V3 Motion Control ajoute une couche de contrôle de la pose et de la direction du mouvement par-dessus le système de cohérence des personnages. C’est là que Kling 3.0 devient véritablement cinématographique. Vous pouvez spécifier des trajectoires de caméra, des trajectoires de mouvement du personnage et des dynamiques d’interaction, tandis que le modèle maintient l’identité visuelle du personnage verrouillée.
Si votre histoire exige qu’un personnage traverse une scène, se tourne vers la caméra ou interagisse physiquement avec un autre élément, Kling V3 Motion Control gère la chorégraphie du mouvement sans sacrifier la fidélité de l’identité.
PicassoIA vous donne accès aux trois modèles Kling 3.0 depuis une seule interface, sans configuration d’API, sans GPU local et sans paramétrage complexe.
Étape 1 : importer la référence de votre personnage
Avant de rédiger le moindre prompt, créez ou trouvez une image de référence claire de votre personnage. La qualité de cette image de référence détermine directement à quel point votre personnage restera cohérent d’une scène à l’autre. Elle doit :
- Montrer le personnage sous un angle neutre (à peu près à hauteur des yeux, face à la caméra)
- Inclure le visage entier, sans ombres marquées masquant les traits identifiants
- Présenter les vêtements et accessoires que vous voulez conserver d’une scène à l’autre
- Être en haute résolution afin que le modèle dispose de suffisamment de détails pour extraire une signature d’identité fiable
Vous pouvez d’abord générer cette image de référence avec l’un des modèles de texte vers image de PicassoIA si vous n’avez pas de photo de départ. Générez un portrait net et bien éclairé, et utilisez-le comme ancre.
Étape 2 : rédiger des prompts de scène liés au même personnage
Vos prompts textuels doivent décrire la scène et l’action, pas redécrire le personnage. Puisque l’image de référence porte les informations d’identité, votre prompt peut se concentrer entièrement sur :
- Le décor (lieu, moment de la journée, météo, intérieur ou extérieur)
- L’action (ce que fait le personnage dans cette scène précise)
- L’angle de caméra (gros plan, plan d’ensemble large, contre-plongée, vue aérienne)
- L’ambiance (qualité de la lumière, température de couleur, atmosphère émotionnelle)
Évitez de répéter des descriptions physiques du personnage dans vos prompts. Si vous écrivez « femme aux cheveux auburn » dans le prompt et que le modèle interprète cela partiellement par le texte au lieu de s’en remettre à l’image de référence, il peut introduire une dérive subtile. Laissez l’image faire tout le travail d’identité.
💡 Astuce : rédigez vos prompts comme si vous décriviez une scène de film à un réalisateur qui connaît déjà parfaitement l’acteur. Concentrez-vous entièrement sur la direction visuelle, le décor, l’action et le travail de caméra. Jamais le casting.
Étape 3 : générer et enchaîner vos scènes
Une fois votre premier plan généré, utilisez Kling V3 Omni Video pour générer les scènes suivantes. Importez la même image de référence d’origine avec chaque nouveau prompt de scène. N’utilisez pas la dernière image du plan précédent comme référence pour le suivant : cela crée une dérive lente qui s’accumule sur de nombreuses scènes, puisque chaque nouvelle « référence » est déjà légèrement différente de l’originale.
Pour les séquences à mouvements complexes, passez à Kling V3 Motion Control et ajoutez les paramètres de mouvement tout en gardant la même référence d’origine du personnage verrouillée.
Où Kling 3.0 devance la concurrence
La cohérence des personnages est un sujet sur lequel plusieurs plateformes de vidéo par IA travaillent activement, mais Kling 3.0 se distingue dans plusieurs domaines précis qui comptent le plus pour la production en plusieurs scènes.
| Fonctionnalité | Kling 3.0 | Autres modèles |
|---|
| Conditionnement par image de référence | Natif, intégré | Partiel ou en post-traitement |
| Cohérence du corps entier | Oui (visage + vêtements) | Généralement le visage seulement |
| Stabilité de l’identité selon l’éclairage | Forte | Modérée |
| Mouvement tout en préservant l’identité | Oui (Motion Control) | Limité |
| Flux de travail d’enchaînement multi-scènes | Oui | Centré sur un seul plan |
| Outils spécifiques aux avatars | Oui (Kling Avatar V2) | Rare |
La concurrence gère assez bien la génération de personnages sur un seul plan. Là où Kling 3.0 prend de l’avance, c’est dans les flux de travail multi-plans et multi-environnements, où la même personne doit porter un arc narratif complet à travers de nombreuses scènes.
Des modèles comme Seedance 2.0 et Veo 3.1 offrent une qualité vidéo brute exceptionnelle, mais ne sont pas spécifiquement optimisés pour la persistance des personnages d’une scène à l’autre. Ils excellent sur la qualité de chaque plan pris isolément. Kling 3.0 est conçu dès l’origine pour la production en plusieurs scènes.
Cas d’usage concrets
Courts-métrages et micro-séries
Les réalisateurs indépendants utilisent désormais régulièrement Kling V3 Video pour produire des courts-métrages narratifs avec des personnages récurrents. Un court-métrage de cinq minutes peut nécessiter entre 25 et 35 plans individuels. Sans cohérence des personnages, chaque plan demande un étalonnage et un travail de correspondance des visages lourds en post-production pour maintenir la cohérence visuelle du film. Kling 3.0 réduit considérablement cette charge, permettant à une seule personne de produire un court-métrage parfaitement cohérent en une fraction du temps auparavant nécessaire.
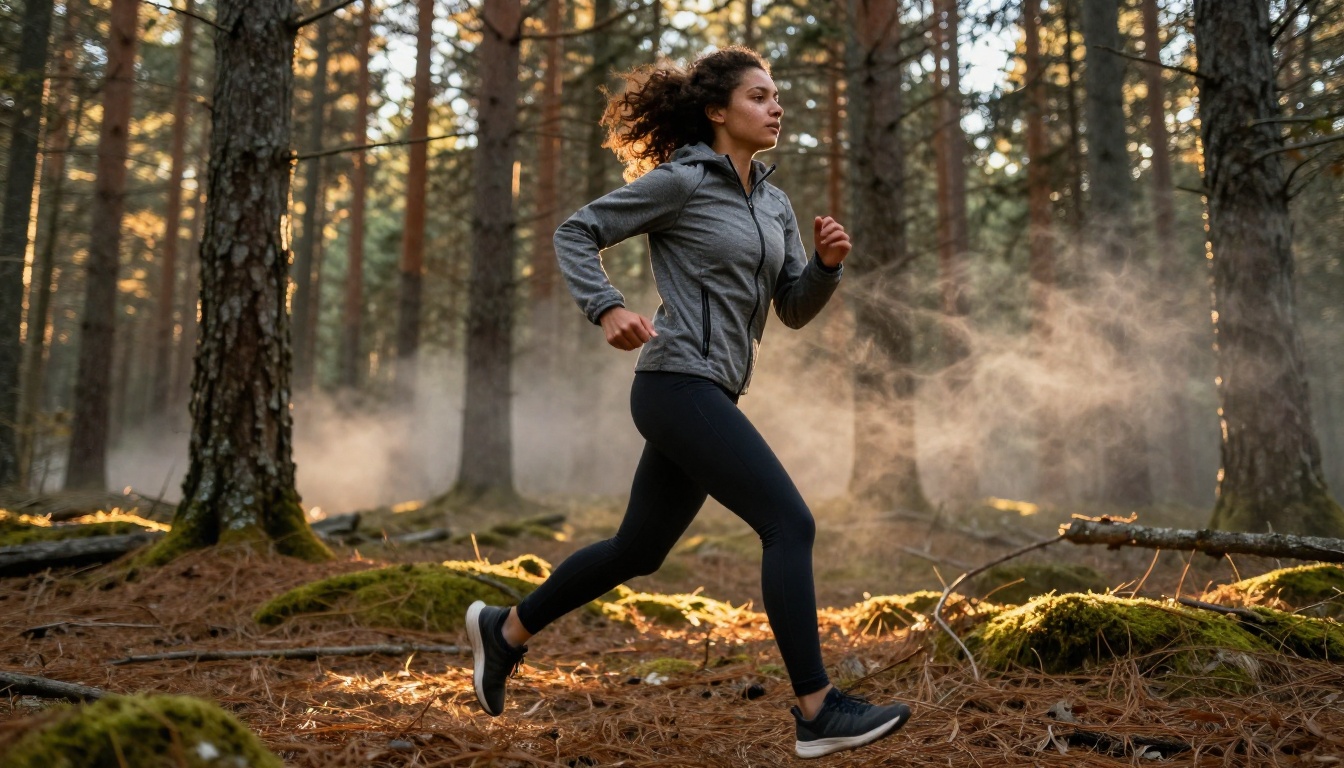
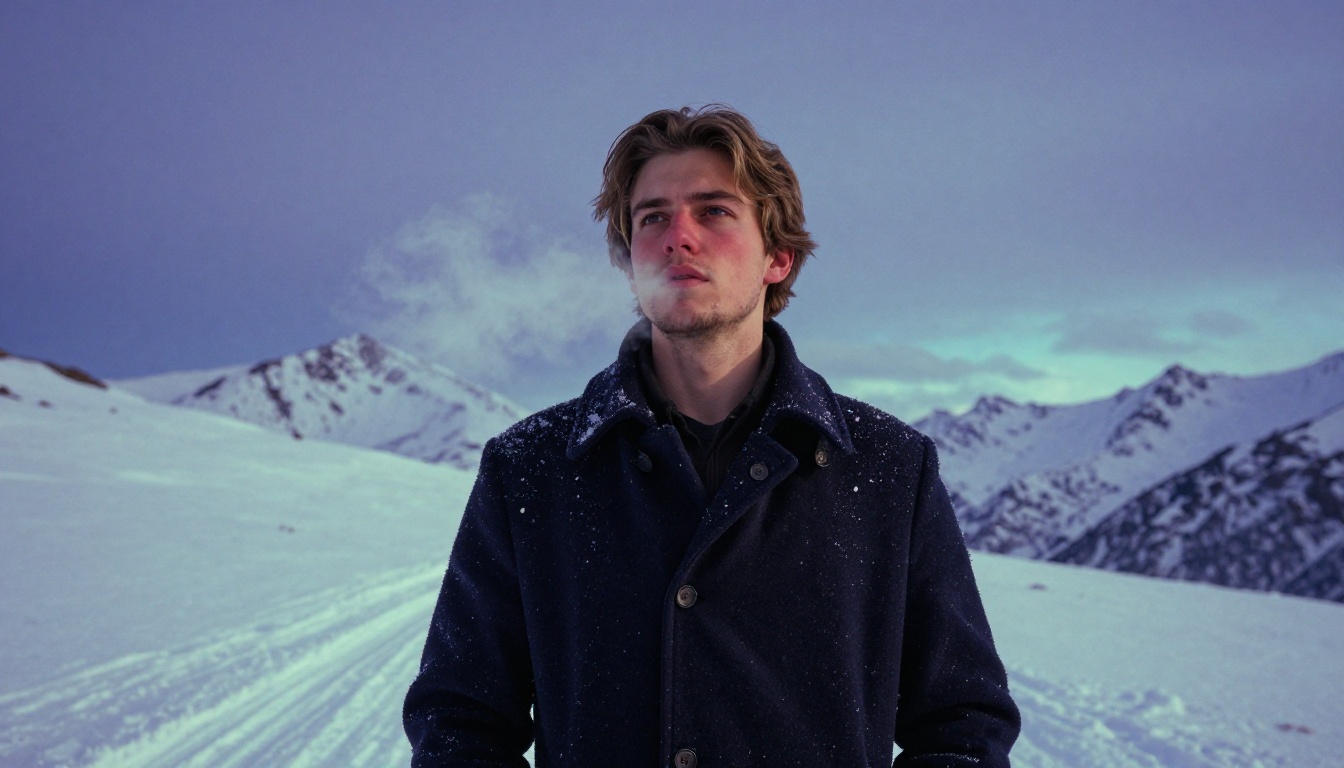
Un personnage peut entrer dans une forêt, émerger dans une rue de ville et arriver à un col enneigé, le tout en plans consécutifs, et rester exactement le même du début à la fin.
Storytelling de marque
Pour les équipes marketing, la cohérence des personnages signifie qu’une mascotte ou un porte-parole de marque peut apparaître dans plusieurs spots publicitaires, clips pour les réseaux sociaux et contenus web sans tournages coûteux ni contraintes rigides de correspondance de plans. Le même visage, la même identité vestimentaire, la même présence physique, appliqués à l’environnement, quel qu’il soit, dont la campagne a besoin pour chaque contenu.
Les implications pour les campagnes saisonnières sont importantes. Un personnage de marque peut apparaître dans un contenu de plage estival et dans un contenu de fêtes d’hiver, avec une identité visuelle identique dans les deux cas, sans réservation de studio, sans négociation de disponibilité d’acteur et sans repérage de lieux.
Création de contenu à grande échelle
Les créateurs qui développent des séries YouTube, des récits Instagram ou des contenus épisodiques sur les réseaux sociaux profitent directement du système de cohérence de Kling 3.0. Bâtir une audience autour d’un personnage fictif exige que ce personnage soit immédiatement reconnaissable de vignette en vignette et de plan en plan. Kling 3.0 rend cette reconnaissance fiable plutôt que fortuite.
Ce que Kling 3.0 ne peut toujours pas faire
La cohérence des personnages de Kling 3.0 est véritablement impressionnante, mais il existe des limites réelles qu’il vaut mieux connaître avant de planifier une production entière autour de cet outil.
Un changement intentionnel de personnage exige une intervention manuelle. Si votre histoire demande qu’un personnage vieillisse visiblement d’une scène à l’autre, change de coiffure en cours de récit ou modifie radicalement sa tenue, vous devrez créer des images de référence mises à jour pour ces versions du personnage. Le système de cohérence interprète tout écart par rapport à la référence comme une chose à corriger, et non comme un choix créatif.
Les scènes à plusieurs personnages avec deux personnages cohérents ou plus sont plus complexes à gérer. Le modèle gère de façon fiable l’ancrage de l’identité d’un seul personnage. Lorsque vous introduisez un second personnage avec sa propre image de référence, une fuite d’identité entre les deux personnages peut survenir dans les compositions à deux personnages en plan serré, en particulier lorsque les deux partagent des traits physiques similaires.
Les perspectives de caméra extrêmes, dans des positions que l’image de référence ne couvre pas, comme directement au-dessus, directement derrière ou en contre-plongée extrême sous le menton, donnent des résultats moins fiables. L’image de référence fournit peu d’informations sur l’apparence du personnage vu de ces positions, si bien que le modèle comble ces lacunes par une interprétation plus créative.
💡 Remarque : ce sont les limites actuelles de la génération V3. Chaque version de Kling a sensiblement resserré les contraintes de cohérence. Le contrôle de l’identité pour plusieurs personnages serait l’un des principaux axes de la prochaine itération de leur architecture.
Créez dès maintenant vos propres personnages
La technologie permettant de créer des personnages parfaitement cohérents à travers des scènes de vidéo générées par IA est disponible aujourd’hui, et PicassoIA la rend accessible sans obstacle technique entre vous et une production de qualité.
Ouvrez Kling V3 Video sur PicassoIA, importez une image de référence du personnage autour duquel vous voulez construire une histoire, et générez votre première scène. Ensuite, reprenez cette même image de référence et générez la scène suivante dans un environnement totalement différent. La cohérence sera immédiatement visible et le flux de travail vous paraîtra intuitif dès la première tentative.
Pour les récits à mouvements complexes, essayez Kling V3 Motion Control afin d’ajouter un mouvement de caméra et une chorégraphie de personnage par-dessus l’ancrage d’identité. Et si vous voulez pousser plus loin la personnalisation d’avatar, Kling Avatar V2 propose une approche complémentaire qui mérite d’être testée.
L’époque des personnages d’IA jetables, qui changent d’apparence à chaque plan, est terminée. Kling 3.0 fait de l’identité d’un personnage quelque chose que vous pouvez réellement maîtriser et conserver sur toute une histoire, scène après scène, environnement après environnement, sans compromis.


