Seedream 5 Lite es de esos modelos que te hacen replantear lo que significa realmente la etiqueta "lite" en la IA generativa. Lanzado por ByteDance como un modelo de texto a imagen compacto pero capaz, tiene unos 2 000 millones de parámetros, una fracción de su hermano mayor. Sin embargo, en la práctica, la fidelidad visual que produce, sobre todo en la coherencia de estilo y el detalle fino, suele superar las expectativas para su categoría.
Si has trabajado con generación de imágenes por IA, sabes que la coherencia de estilo y la conservación del detalle son los puntos donde más modelos flaquean. Lograr que un modelo mantenga una identidad visual en una escena compleja, y al mismo tiempo renderice la textura del cabello, el tejido de una tela y la profundidad del fondo, es realmente difícil. Seedream 5 Lite aborda ambos problemas de una forma concreta, y merece la pena desglosar cómo funciona a nivel práctico.
La diferencia entre un modelo "lite" que solo sacrifica calidad por velocidad y uno que toma decisiones arquitectónicas más inteligentes es importante. Seedream 5 Lite está claramente en la segunda categoría. Este artículo desglosa los mecanismos detrás de sus capacidades de estilo y detalle, dónde rinde realmente bien y cuáles son los límites reales en la práctica.
Qué es Seedream 5 Lite
La arquitectura de 2B parámetros
Seedream 5 Lite pertenece a la familia de modelos Seedream de ByteDance, que se ha posicionado como un competidor serio en el espacio de la generación de imágenes con IA, tanto en China como a nivel global. La designación "Lite" se refiere al número de parámetros del modelo: aproximadamente 2 000 millones, frente a la huella mayor del Seedream 5 completo.
No se trata solo de tamaño para hacerlo accesible. La arquitectura Lite refleja decisiones deliberadas sobre dónde asignar la capacidad del modelo. El equipo de ByteDance se centró en la eficiencia del entrenamiento y en la calidad de un conjunto de datos cuidadosamente seleccionado, en lugar de simplemente escalar los parámetros. El resultado es un modelo que produce una calidad perceptual muy por encima de lo que sugeriría su número de parámetros por sí solo.
| Especificación | Seedream 5 Lite | Modelo típico de escala completa |
|---|
| Parámetros | ~2B | 8B–12B |
| Datos de entrenamiento | Curados, de alta estética | Rastreados de la web en general |
| Renderizado de texto | Bilingüe (CN + EN) | Centrado en inglés |
| Velocidad de inferencia | Rápida | Más lenta |
| Precisión de estilo | Alta | Variable |
Por qué la arquitectura transformer cambia las cosas
La arquitectura de un modelo de difusión afecta directamente a lo que puede conservar sobre el estilo. Seedream 5 Lite usa un backbone de difusión basado en transformer, en lugar de la antigua arquitectura UNet que dominó las generaciones anteriores de modelos.
La diferencia práctica: las arquitecturas transformer usan autoatención global, lo que significa que cada posición espacial en el proceso de generación de la imagen puede atender a todas las demás. En un modelo UNet, la información fluye por una estructura jerárquica de codificador y decodificador, donde las posiciones distantes solo se influyen entre sí de forma indirecta. Para la coherencia de estilo en una composición completa, el enfoque transformer da resultados notablemente mejores.
Las ventanas de atención cruzada más grandes permiten al modelo relacionar partes distantes de una imagen entre sí, y así mantiene la coherencia estilística desde el primer plano hasta el fondo, desde el sujeto hasta el entorno. Esta es una de las razones por las que Seedream 5 Lite suele mostrar una integridad compositiva más sólida que los modelos basados en UNet con más parámetros.
💡 Por qué funciona: La autoatención transformer permite al modelo "ver" toda la imagen a la vez durante la generación, no solo vecindarios locales. Esto evita el aspecto desarticulado que aparece cuando un modelo renderiza un sujeto en un estilo y el fondo en otro.
El motor de estilo dentro de Seedream 5 Lite
Cómo la puntuación estética da forma al modelo
Uno de los aspectos más distintivos del pipeline de entrenamiento de Seedream 5 es el uso intensivo de la puntuación estética durante la curación del conjunto de datos. En lugar de entrenar con cada par imagen-texto disponible, el pipeline filtra por calidad visual, armonía de color, equilibrio compositivo y atractivo estético general.
Esto es una forma de entrenamiento ponderado por calidad: el modelo ve ejemplos limpios y de alta calidad con mucha más frecuencia que los mediocres. El efecto en la salida es real y medible. Seedream 5 Lite tiene una fuerte predisposición a producir imágenes con paletas de color de aspecto natural, iluminación bien equilibrada y composiciones que parecen intencionadas en lugar de accidentales.
Más allá de la curación, el proceso de entrenamiento de ByteDance incorpora la retroalimentación estética como señal de recompensa, de forma similar a como funciona el RLHF (aprendizaje por refuerzo a partir de retroalimentación humana) en los modelos de lenguaje, pero adaptado a la salida visual. Evaluadores humanos valoran las imágenes generadas, y esas valoraciones dan forma a la función de recompensa del modelo durante el ajuste fino. Por eso el modelo tiende a producir resultados visualmente agradables incluso cuando los prompts son ambiguos o están poco especificados.
Tokens de estilo y condicionamiento por texto
Seedream 5 Lite usa un codificador de texto sofisticado que procesa el lenguaje relacionado con el estilo con una precisión notable. Cuando escribes "acuarela sobre papel rugoso" o "grano de película, Kodak Portra 400", la vía de condicionamiento por texto del modelo ha sido entrenada para asociar esas frases con distribuciones visuales concretas.
Esta es la diferencia entre un modelo que aproxima vagamente un estilo y uno que realmente se compromete con él. La textura de una aguada de acuarela, la caída tonal concreta de una película fotográfica, la calidad de borde pictórica del óleo sobre lienzo: todo ello se traduce del prompt al píxel con más fidelidad de la que normalmente se ve con este número de parámetros.
Identidad visual coherente en toda una escena
Donde muchos modelos tienen dificultades es en mantener un estilo coherente en todos los elementos de una escena compleja. Un modelo puede renderizar el sujeto en un estilo fotorrealista mientras el fondo parece una estética completamente distinta. La atención global de Seedream 5 Lite permite que cada parche de la imagen influya en todos los demás durante la generación.
El resultado es una coherencia compositiva: la lógica de la iluminación se mantiene de principio a fin, desde el primer plano hasta el fondo, la gradación de color se aplica de manera uniforme y las texturas estilísticas no cambian de repente a mitad del encuadre. Cuando especificas un estilo visual, este se mantiene en toda la composición.
Cómo captura los detalles finos
Fidelidad de textura y superficie
El renderizado del detalle en los modelos de difusión depende de la capacidad del modelo para mantener la información de alta frecuencia a lo largo del proceso de eliminación de ruido. Los modelos de difusión funcionan eliminando el ruido de forma gradual, y los detalles finos, como los poros de la piel, el tejido de una tela o las nervaduras de una hoja, ocupan las bandas de frecuencia más altas de una imagen.
Seedream 5 Lite maneja esto mejor que la mayoría de los modelos de 2B parámetros gracias a su resolución de entrenamiento. El modelo se entrenó con recortes de imagen de alta resolución, lo que significa que ha visto y aprendido información visual de grano fino a un nivel de detalle que los modelos entrenados con recortes más pequeños simplemente no han llegado a encontrar.
El programa de eliminación de ruido también importa: cuántos pasos da el modelo para resolver el detalle a partir del ruido, y en qué punto se establece la estructura fina frente a la gruesa. Los calendarios de eliminación de ruido bien ajustados conservan mejor el detalle fino con el mismo número de pasos de inferencia. Esta es un área de optimización activa dentro de la familia Seedream.
Microdetalle en tejidos y cabello
Hay dos categorías de detalle que suelen poner al descubierto las debilidades de los modelos: los tejidos y el cabello. Ambos implican patrones complejos con información direccional (la dirección del tejido, el fluir del cabello), rasgos a escala subpíxel e interacciones con la luz que requieren modelar a la vez la geometría y las propiedades del material.
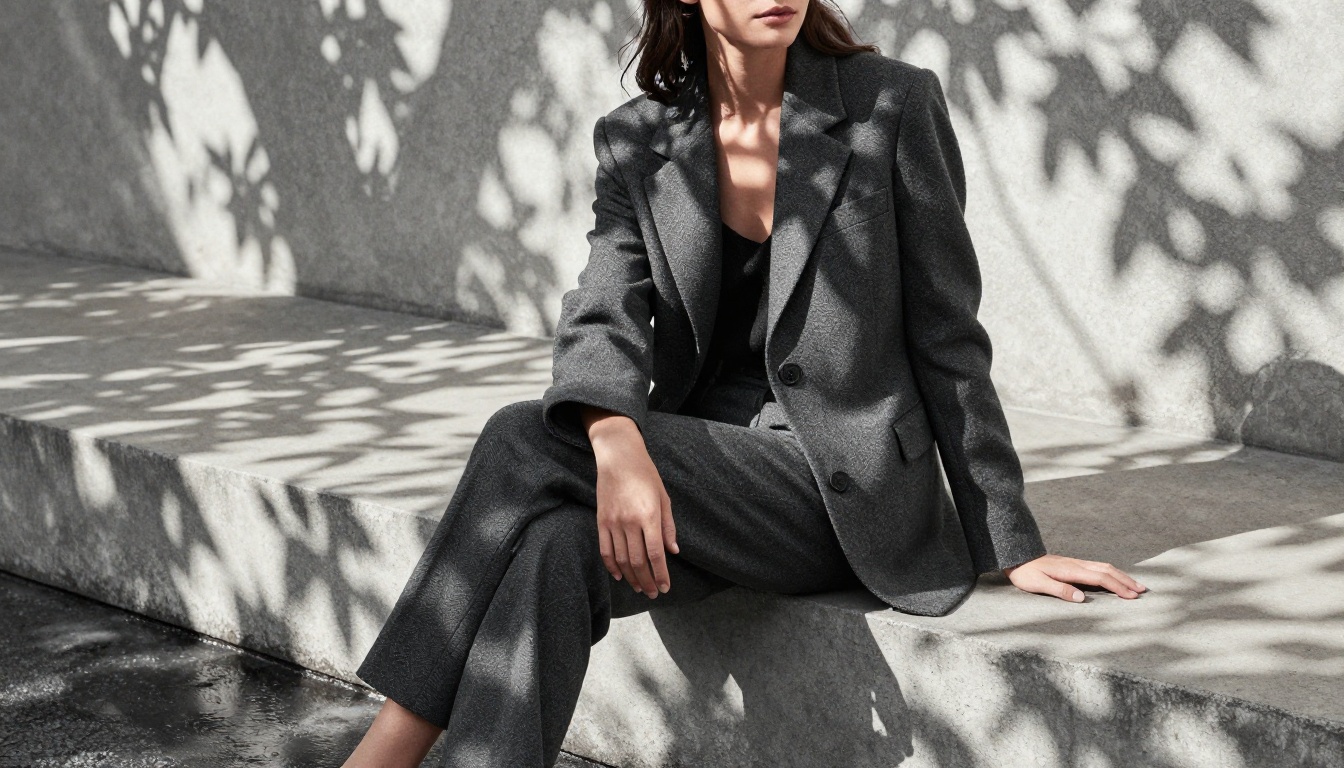
Seedream 5 Lite rinde bien en ambos. Las texturas de tela, sobre todo los materiales estructurados como el denim, el encaje y la lana, muestran patrones de tejido creíbles. El cabello se renderiza con un flujo direccional y una variación de microhebras adecuada, en lugar de la masa uniforme de aspecto pintado que producen los modelos más débiles.
Esto refleja tanto la calidad de los datos de entrenamiento como el campo receptivo efectivo del modelo, que le permite modelar patrones de textura locales y mantenerse coherente con el contexto estructural más amplio que los rodea.
💡 Consejo de prompt: Para sacar el máximo detalle de Seedream 5 Lite, describe la textura de forma explícita. Frases como "textura visible de tejido de lino" o "hebras de cabello individuales en foco nítido" activarán la capacidad de renderizado de alta frecuencia del modelo de forma más fiable que las palabras de estilo vagas.
Renderizado de texto bilingüe
Por qué el texto en las imágenes es difícil
Renderizar texto legible dentro de imágenes generadas es uno de los problemas realmente difíciles de la síntesis de imágenes basada en difusión. La razón es arquitectónica: los modelos de difusión generan las imágenes como un campo completo de píxeles, no como una composición semántica de elementos distintos. El texto, con sus formas de glifos precisas y sus relaciones espaciales, exige una precisión espacial extrema en los límites de los rasgos finos.
La mayoría de los modelos occidentales de imagen con IA se entrenaron sobre todo con datos en inglés y aún les cuesta generar texto de varias palabras dentro de las imágenes. El espaciado entre caracteres, la alineación de la línea base y la coherencia de la tipografía se degradan a medida que aumenta la complejidad del texto.
La ventaja chino-inglés
Seedream 5 Lite se entrenó de forma explícita en el renderizado de texto bilingüe, que abarca caracteres en chino simplificado y en inglés. Es una diferencia significativa para los creadores de contenido que trabajan en mercados asiáticos, o para cualquiera que necesite texto preciso incrustado en las imágenes generadas.
El modelo maneja señalización, etiquetas de productos, texto de carteles y tipografía decorativa con una precisión notable para su categoría. El renderizado de caracteres chinos es especialmente sólido, dada la complejidad de los trazos de los glifos chinos frente a las formas de letra latina. Los trazos de cada carácter mantienen sus formas diferenciadas en lugar de fundirse entre sí.
| Tipo de texto | Seedream 5 Lite | Modelo occidental típico |
|---|
| Texto corto en inglés | Excelente | Bueno |
| Frases largas en inglés | Bueno | Deficiente |
| Chino simplificado | Sólido | Muy deficiente |
| Bilingüe mixto | Sólido | Normalmente roto |
| Estilo manuscrito | Moderado | Deficiente |
Cómo escribir prompts que sacan el máximo de estilo y detalle
Especificidad frente a vaguedad
Una de las lecciones prácticas de trabajar con Seedream 5 Lite es que el modelo responde muy bien a un lenguaje específico y concreto. Los descriptores de estilo vagos como "bonito", "agradable" o "alta calidad" los procesa el codificador de texto, pero no aportan mucha información discriminativa. Las descripciones específicas de material y de óptica pesan mucho más.
En lugar de "pintura detallada", prueba "óleo sobre lienzo de lino, pincelada impasto visible, textura de espátula en las luces, subpintura de sombras frías". En lugar de "buena iluminación", prueba "luz única de ventana norte difusa, temperatura de color fría de 5500K, transición suave de sombra".
Este principio de especificidad se aplica a todas las categorías de descriptores de estilo:
- Películas fotográficas: "grano y reproducción de color de Kodak Portra 400" en lugar de "look de película"
- Características del objetivo: "85 mm f/1.8 con profundidad de campo reducida" en lugar de "fondo borroso"
- Texturas de superficie: "textura visible del tejido, definición de hilos individuales" en lugar de "texturizado"
- Condiciones atmosféricas: "neblina volumétrica de la mañana entre los pinos" en lugar de "con niebla"
Estructuración de prompts con varios elementos
En escenas complejas con varios requisitos de estilo, estructurar el prompt en capas le da a Seedream 5 Lite señales de condicionamiento más limpias:
- Sujeto y acción primero: quién o qué, haciendo qué
- Entorno en segundo lugar: dónde, con qué alrededores
- Iluminación en tercer lugar: fuente, dirección, calidad, temperatura de color
- Cámara y objetivo en cuarto lugar: distancia focal, apertura, ángulo de toma
- Textura y atmósfera en quinto lugar: detalles de superficie, efectos atmosféricos, características de la película
Este orden corresponde aproximadamente a la jerarquía de importancia visual de una imagen: primero la composición global, al final el detalle local. Cuando una generación falla en el estilo pero acierta en la composición, conserva los elementos estructurales de tu prompt y reescribe solo los descriptores de estilo.
Velocidad frente a calidad en los modelos Lite
Lo que realmente recorta "Lite"
La reducción de tamaño de un modelo de escala completa a uno Lite no es gratuita. En el caso de Seedream 5 Lite, las contrapartidas se notan sobre todo en:
- Escenas con muchos objetos: los modelos de escala completa pueden sostener más conceptos visuales distintos a la vez en un solo encuadre
- Detalle extremo en primeros planos de sujetos no humanos: el ornamento arquitectónico complejo y la maquinaria muestran más simplificación a niveles de detalle fino
- Techo de complejidad del prompt: los prompts muy largos y con muchas capas pueden perder parcialmente elementos especificados cuando entran en conflicto entre sí
Lo que no se sacrifica de forma notable: la coherencia de estilo, la calidad del detalle de un único sujeto, la fidelidad del color y el renderizado de texto bilingüe resisten bien frente a los modelos más grandes.
La velocidad de inferencia en la práctica
Gracias al menor número de parámetros, Seedream 5 Lite funciona notablemente más rápido que las alternativas de escala completa con el mismo hardware. Para quienes hacen trabajos de gran volumen, como retratos, fotos de producto o imágenes editoriales, una inferencia más rápida significa más iteraciones por hora, lo que suele dar mejores resultados finales que una única generación lenta de un modelo más pesado.
Aprovecha la ventaja de velocidad para probar de 5 a 10 variaciones de prompt y elegir la mejor, en lugar de gastar el mismo cómputo en una sola generación muy cuidada de un modelo más lento. La velocidad de iteración es en sí misma una herramienta creativa.
Resultados en el mundo real
Dónde rinde mejor
Seedream 5 Lite brilla especialmente en:
- Retrato y trabajo con figuras humanas: la anatomía humana, el detalle de la piel y la precisión de los rasgos faciales son notablemente sólidos en una amplia gama de estilos
- Imágenes de moda y textiles: el renderizado de tejidos es una de sus capacidades más claras, y los materiales estructurados como el denim, el encaje y la lana producen patrones de tejido creíbles
- Estéticas de fotografía estilizada: las simulaciones de grano de película, los estilos de gradación de color y los aspectos cinematográficos se reproducen con alta fidelidad a sus estéticas de origen
- Composiciones de foco único: imágenes con uno o dos sujetos frente a fondos contextuales, donde el modelo puede dedicar más capacidad al detalle del sujeto principal
- Estilos estéticos del este de Asia: los datos de entrenamiento se inclinan hacia el arte y la fotografía asiáticos de alta calidad, lo que da al modelo una fortaleza distintiva en esas tradiciones visuales
Dónde notarás los límites
Seedream 5 Lite muestra sus límites en:
- Manos con muchos dedos que interactúan: una debilidad persistente de los modelos de difusión, algo más visible con el número de parámetros de Lite
- Interiores arquitectónicos complejos: las escenas con muchos elementos y requisitos geométricos precisos tienden a suavizarse o simplificarse
- Animales en movimiento: sujetos no humanos dinámicos con articulación compleja de las extremidades
- Diseños de producto muy específicos: la geometría de objetos con requisitos estructurales o de marca precisos
Ser lúcido con estos límites forma parte de usar cualquier modelo de forma eficaz. Para sus casos de uso objetivo, las capacidades superan con creces las limitaciones.
Herramientas similares en PicassoIA
Si te interesan las capacidades de estilo y detalle de Seedream 5 Lite, varios modelos de PicassoIA ofrecen fortalezas comparables o complementarias para distintos flujos de trabajo creativos.
PicassoIA Image es el modelo propio de texto a imagen de la plataforma, con una alta fidelidad visual en una amplia gama de estilos y temas. Maneja bien el condicionamiento complejo por prompt y es especialmente fuerte en la salida fotorrealista de retratos y moda, con un énfasis similar en la calidad estética de su distribución de resultados.
Flux Redux Dev adopta un enfoque distinto: en lugar de partir solo del texto, crea variaciones a partir de una imagen de referencia y conserva la identidad visual central del original. Resulta valioso cuando tienes un estilo o una estética existente que quieres mantener en varias imágenes generadas, algo que encaja mucho con lo que Seedream 5 Lite logra desde el lado del prompt de texto.
PicassoIA Image Editor Pro añade capacidades de edición sobre la generación, y te permite refinar imágenes generadas con inpainting, outpainting y ediciones puntuales. Combina bien con cualquier modelo de generación principal cuando necesitas corregir problemas de detalle concretos en un resultado por lo demás sólido sin volver a generar desde cero.
Crea tus propias imágenes
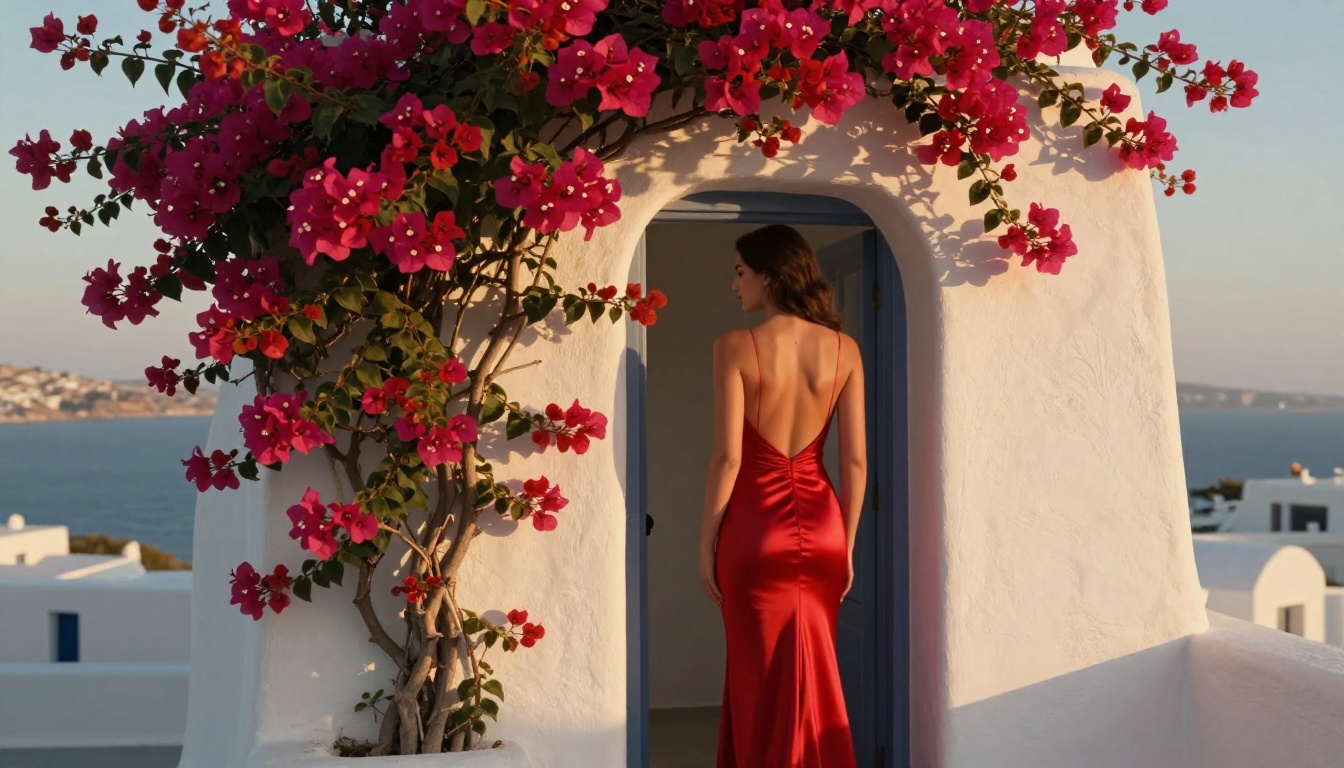
La mejor forma de sentir realmente cómo un modelo maneja el estilo y el detalle es probarlo. El enfoque de Seedream 5 Lite, centrado en la curación de datos de entrenamiento estéticos, la coherencia global basada en transformer y el soporte de texto bilingüe, produce una firma visual reconocible que merece la pena experimentar de primera mano.
Si quieres empezar a experimentar con generación de imágenes por IA de alta calidad ahora mismo, PicassoIA te da acceso a una amplia biblioteca de modelos de texto a imagen donde puedes empezar de inmediato a trabajar con prompts que ponen a prueba la coherencia de estilo, la fidelidad del detalle y las composiciones complejas.
Empieza con algo concreto: describe una textura de tela, una condición de iluminación, una película fotográfica. Observa con qué precisión el modelo traduce tus palabras a realidad visual. Esa precisión es lo que Seedream 5 Lite y los modelos construidos sobre principios similares se esfuerzan por conseguir, y es lo que separa las imágenes que parecen generadas de las que parecen genuinamente trabajadas a mano.


