Seedream 5 Lite fait partie de ces modèles qui vous amènent à reconsidérer ce que signifie vraiment le label « Lite » en IA générative. Publié par ByteDance comme modèle de texte vers image compact mais capable, il compte environ 2 milliards de paramètres, une fraction de son grand frère. Pourtant, en pratique, la fidélité visuelle qu’il produit, en particulier la cohérence du style et les détails fins, dépasse souvent les attentes pour sa catégorie.
Si vous avez déjà travaillé avec la génération d’images par IA, vous savez que la cohérence du style et la préservation des détails sont les points où la plupart des modèles montrent leurs failles. Faire tenir une identité visuelle à travers une scène complexe, tout en rendant simultanément la texture des cheveux, le tissage d’un tissu et la profondeur de l’arrière-plan, est vraiment difficile. Seedream 5 Lite adopte une approche précise pour résoudre ces deux problèmes, et il vaut la peine de détailler concrètement son fonctionnement.
La différence entre un modèle « Lite » qui sacrifie simplement la qualité pour la vitesse et un modèle qui fait des choix d’architecture plus intelligents est importante. Seedream 5 Lite relève sans conteste de la seconde catégorie. Cet article décrit les mécanismes derrière ses capacités de style et de détail, les domaines dans lesquels il se distingue vraiment, et les limites réalistes qu’on rencontre en pratique.
Ce qu’est Seedream 5 Lite
L’architecture de 2B paramètres
Seedream 5 Lite appartient à la famille de modèles Seedream de ByteDance, qui s’est imposée comme un concurrent sérieux dans l’espace de la génération d’images par IA, en Chine comme à l’international. La désignation « Lite » fait référence au nombre de paramètres du modèle : environ 2 milliards, contre l’empreinte plus importante de Seedream 5 complet.
Il ne s’agit pas seulement de taille pour rendre l’outil accessible. L’architecture Lite reflète des choix délibérés quant à l’allocation de la capacité du modèle. L’équipe de ByteDance s’est concentrée sur l’efficacité de l’entraînement et sur la qualité soigneusement sélectionnée du jeu de données, plutôt que sur la simple augmentation du nombre de paramètres. Le résultat est un modèle dont la qualité perceptuelle est nettement supérieure à ce que son nombre de paramètres laisserait supposer.
| Caractéristique | Seedream 5 Lite | Modèle typique à pleine échelle |
|---|
| Paramètres | ~2B | 8B–12B |
| Données d’entraînement | Sélection à forte esthétique | Données issues du web sans tri |
| Rendu du texte | Bilingue (chinois + anglais) | Axé sur l’anglais |
| Vitesse d’inférence | Rapide | Plus lente |
| Précision du style | Élevée | Variable |
Pourquoi l’architecture transformer change la donne
L’architecture d’un modèle de diffusion influence directement ce qu’il peut conserver du style. Seedream 5 Lite utilise une épine dorsale de diffusion basée sur des transformers, plutôt que l’ancienne architecture UNet qui dominait les générations précédentes de modèles.
La différence concrète : les architectures transformer utilisent une auto-attention globale, ce qui signifie que chaque position spatiale du processus de génération d’image peut prêter attention à toutes les autres. Dans un modèle UNet, l’information circule dans une structure hiérarchique encodeur-décodeur où les positions éloignées n’ont qu’une influence indirecte les unes sur les autres. Pour la cohérence stylistique sur une composition entière, l’approche transformer donne des résultats nettement meilleurs.
Des fenêtres d’attention croisée plus larges permettent au modèle de relier entre elles des parties éloignées d’une image, ce qui lui permet de maintenir une cohérence stylistique du premier plan à l’arrière-plan, du sujet au décor. C’est l’une des raisons pour lesquelles Seedream 5 Lite affiche souvent une intégrité compositionnelle plus forte que des modèles basés sur UNet dotés d’un nombre de paramètres plus élevé.
💡 Pourquoi ça marche : l’auto-attention des transformers permet au modèle de « voir » l’image entière en une fois pendant la génération, et non pas seulement des voisinages locaux. C’est ce qui évite l’aspect décousu que l’on obtient lorsqu’un modèle rend un sujet dans un style et l’arrière-plan dans un autre.
Le moteur de style de Seedream 5 Lite
Comment le scoring esthétique façonne le modèle
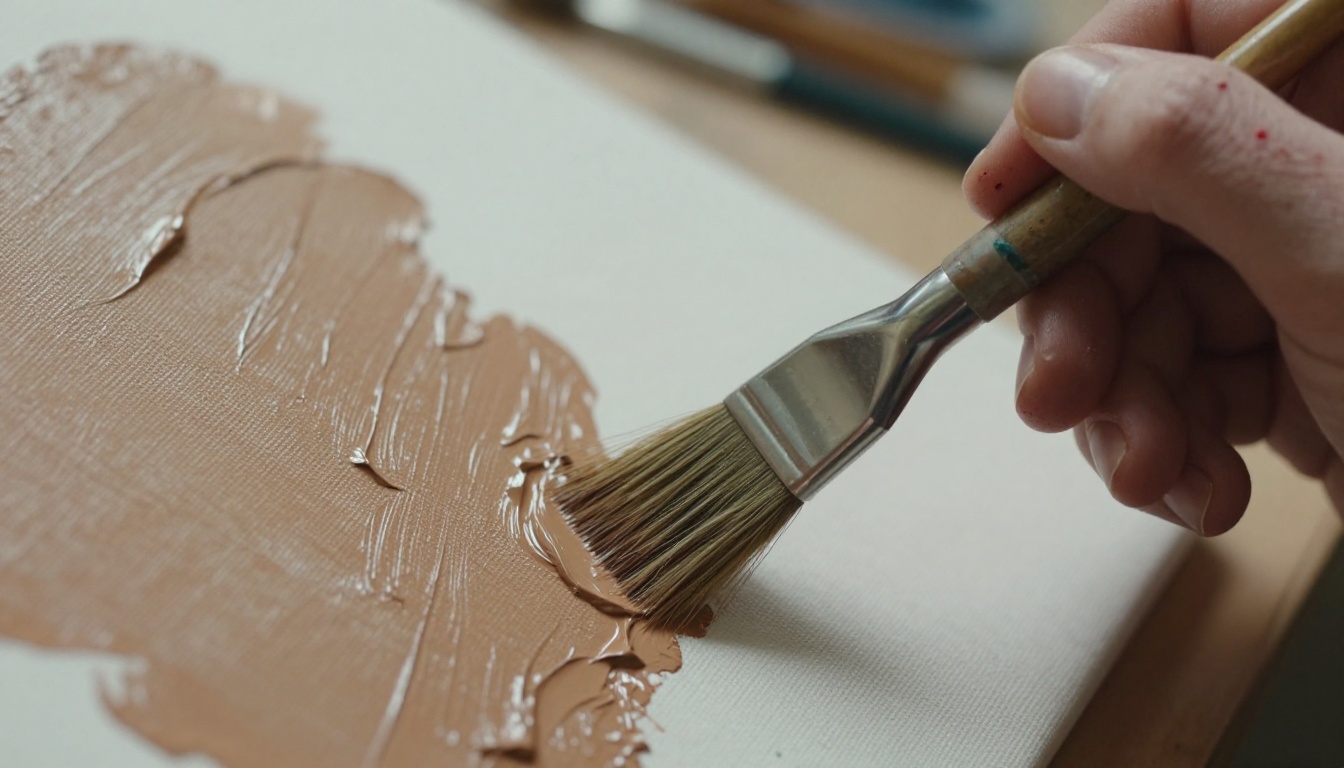
L’un des aspects les plus distinctifs du pipeline d’entraînement de Seedream 5 est l’usage intensif du scoring esthétique lors de la sélection du jeu de données. Plutôt que d’entraîner le modèle sur chaque paire image-texte disponible, le pipeline filtre selon la qualité visuelle, l’harmonie des couleurs, l’équilibre de la composition et l’attrait esthétique global.
Il s’agit d’une forme d’entraînement pondéré par la qualité : le modèle voit des exemples propres et de haute qualité bien plus souvent que des exemples médiocres. L’effet sur le résultat est réel et mesurable. Seedream 5 Lite a une forte tendance à produire des images aux palettes de couleurs d’apparence naturelle, à l’éclairage bien équilibré et aux compositions qui semblent intentionnelles plutôt qu’accidentelles.
Au-delà de la sélection, le processus d’entraînement de ByteDance intègre un retour esthétique sous forme de signal de récompense, à l’image du fonctionnement du RLHF (apprentissage par renforcement à partir de retours humains) dans les grands modèles de langage, mais adapté aux sorties visuelles. Des évaluateurs humains notent les images générées, et ces évaluations façonnent la fonction de récompense du modèle pendant le fine-tuning. C’est pourquoi le modèle tend vers des résultats visuellement plaisants, même lorsque les prompts sont ambigus ou insuffisamment précis.
Tokens de style et conditionnement textuel
Seedream 5 Lite utilise un encodeur de texte sophistiqué qui traite le langage lié au style avec une précision remarquable. Lorsque vous écrivez « aquarelle sur papier texturé » ou « grain de film, Kodak Portra 400 », la voie de conditionnement textuel du modèle a été entraînée à associer ces expressions à des distributions visuelles précises.
C’est la différence entre un modèle qui approxime vaguement un style et un modèle qui s’y engage réellement. La texture d’un lavis d’aquarelle, la courbe de tonalité précise d’une pellicule, le bord pictural d’une huile sur toile : ces éléments passent du prompt au pixel avec une fidélité supérieure à ce que l’on observe habituellement à ce nombre de paramètres.
Une identité visuelle cohérente à travers toute la scène
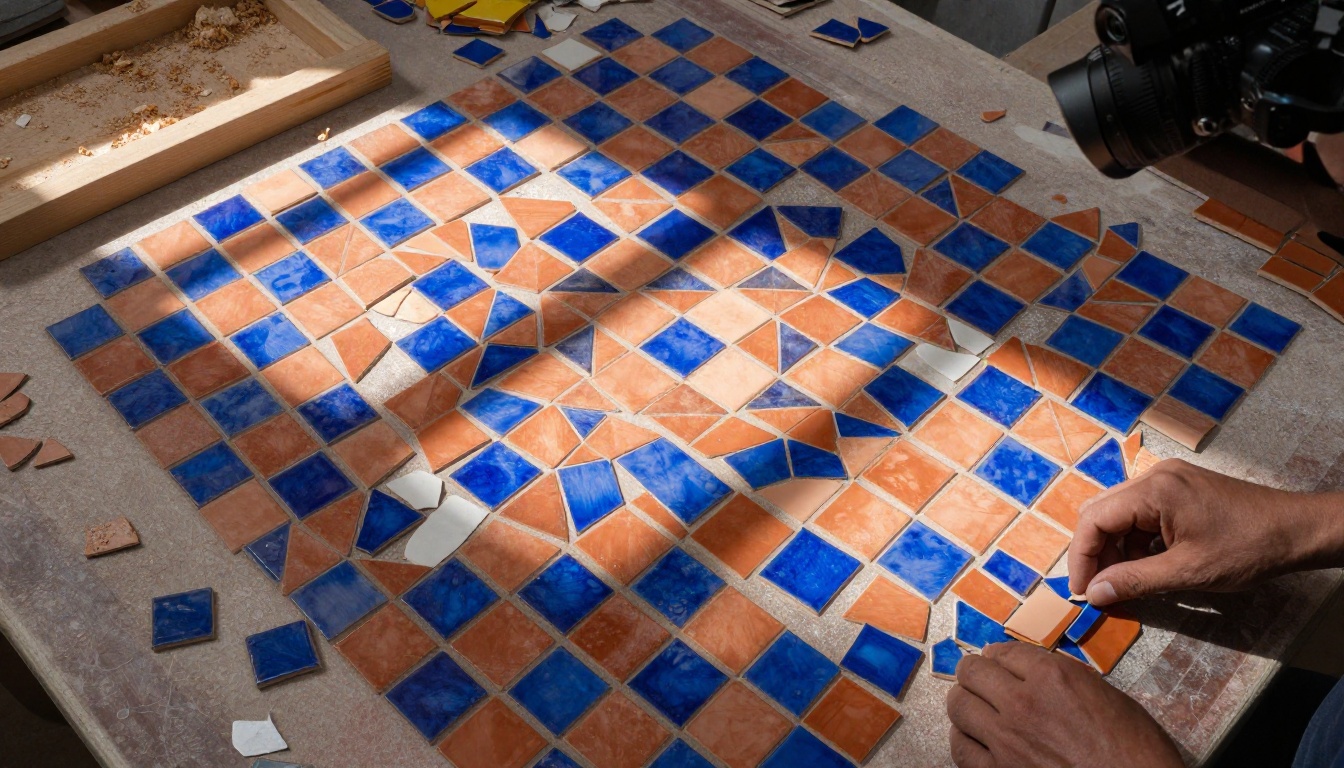
Là où de nombreux modèles peinent, c’est à maintenir un style cohérent sur tous les éléments d’une scène complexe. Un modèle peut rendre le sujet dans un style photoréaliste alors que l’arrière-plan ressemble à une esthétique totalement différente. Le mécanisme d’attention globale de Seedream 5 Lite permet à chaque partie de l’image d’influencer chacune des autres pendant la génération.
Le résultat est une cohérence compositionnelle : la logique de l’éclairage reste constante du premier plan à l’arrière-plan, l’étalonnage des couleurs s’applique uniformément, et les textures stylistiques ne basculent pas soudainement au milieu du cadre. Lorsque vous spécifiez un style visuel, il tient dans toute la composition.
Fidélité des textures et des surfaces
Le rendu des détails dans les modèles de diffusion repose sur la capacité du modèle à conserver l’information à haute fréquence tout au long du processus de débruitage. Les modèles de diffusion fonctionnent en supprimant progressivement le bruit, et les détails fins comme les pores de la peau, le tissage des tissus ou les nervures des feuilles occupent les bandes de plus haute fréquence d’une image.
Seedream 5 Lite gère mieux cela que la plupart des modèles de 2B paramètres, grâce à sa résolution d’entraînement. Le modèle a été entraîné sur des recadrages d’images en haute résolution, ce qui signifie qu’il a vu et appris des informations visuelles fines à un niveau de détail que les modèles entraînés sur des recadrages plus petits n’ont tout simplement jamais rencontré.
Le calendrier de débruitage compte aussi : le nombre d’étapes que le modèle met pour résoudre les détails à partir du bruit, et le moment où la structure fine et la structure grossière s’établissent. Des calendriers de débruitage bien réglés préservent mieux les détails fins à nombre d’étapes d’inférence égal. C’est un domaine d’optimisation actif dans la famille Seedream.
Micro-détails du tissu et des cheveux
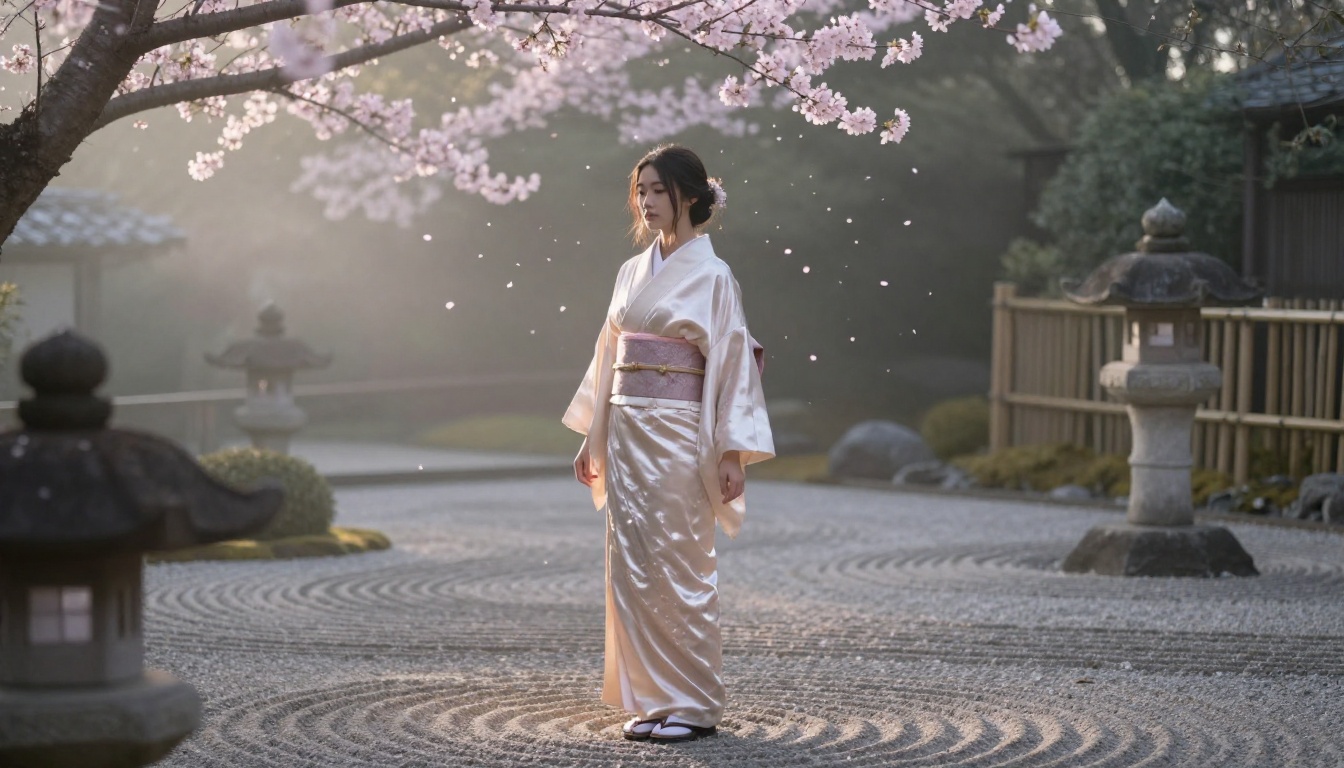
Deux catégories de détails révèlent systématiquement les faiblesses des modèles : les tissus et les cheveux. Les deux impliquent des motifs complexes à information directionnelle (sens du tissage, direction des cheveux), des éléments à l’échelle du sous-pixel et des interactions avec la lumière qui exigent de modéliser simultanément la géométrie et les propriétés des matériaux.
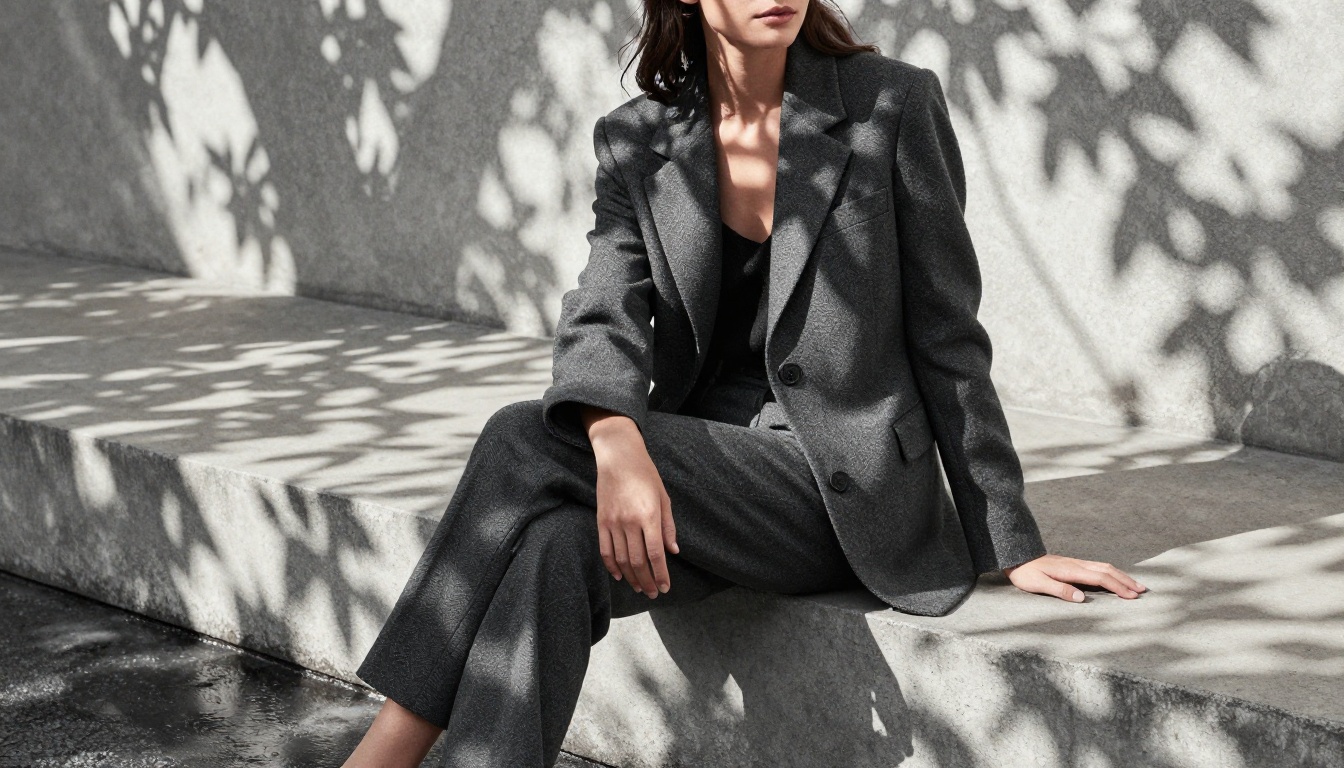
Seedream 5 Lite donne de bons résultats sur les deux. Les textures de tissus, en particulier les matières structurées comme le denim, la dentelle et la laine, montrent des motifs de tissage crédibles. Les cheveux se rendent avec un flux directionnel et une variation de micro-mèches appropriée, plutôt que la masse uniforme d’aspect peint que produisent les modèles plus faibles.
Cela reflète à la fois la qualité des données d’entraînement et le champ réceptif effectif du modèle, qui lui permet de modéliser les motifs de texture locaux tout en restant cohérent avec le contexte structurel plus large qui les entoure.
💡 Astuce de prompt : pour tirer le maximum de détails de Seedream 5 Lite, décrivez explicitement la texture. Des expressions comme « texture visible de tissage de lin » ou « mèches de cheveux individuelles bien nettes » activeront la capacité de rendu des hautes fréquences du modèle de façon plus fiable que des termes de style vagues.
Rendu de texte bilingue
Pourquoi le texte dans les images est difficile
Le rendu de texte lisible dans les images générées est l’un des problèmes vraiment difficiles de la synthèse d’images par diffusion. La raison est architecturale : les modèles de diffusion génèrent les images comme un champ de pixels dans son ensemble, et non comme une composition sémantique d’éléments distincts. Le texte, avec ses formes de glyphes précises et ses relations spatiales, exige une précision spatiale extrême au niveau des frontières fines.
La plupart des modèles occidentaux de génération d’images par IA ont été entraînés principalement sur des données en anglais et peinent encore avec le texte de plusieurs mots dans les images. L’espacement des caractères, l’alignement sur la ligne de base et la cohérence des polices se dégradent à mesure que la complexité du texte augmente.
L’avantage chinois-anglais
Seedream 5 Lite a été explicitement entraîné au rendu de texte bilingue, couvrant les caractères chinois simplifiés et les caractères anglais. C’est un facteur de différenciation important pour les créateurs de contenu qui travaillent sur les marchés asiatiques, ou pour quiconque a besoin d’un texte précis intégré aux images générées.
Le modèle gère la signalétique, les étiquettes de produits, le texte d’affiches et la typographie décorative avec une précision remarquable pour sa catégorie. Le rendu des caractères chinois est particulièrement solide, compte tenu de la complexité des traits des glyphes chinois par rapport aux lettres latines. Les traits de chaque caractère conservent leurs formes distinctes au lieu de se fondre les uns dans les autres.
| Type de texte | Seedream 5 Lite | Modèle occidental typique |
|---|
| Texte court en anglais | Excellent | Bon |
| Phrases longues en anglais | Bon | Faible |
| Chinois simplifié | Solide | Très faible |
| Bilingue mixte | Solide | Généralement défaillant |
| Style manuscrit | Modéré | Faible |
Rédiger des prompts qui donnent le meilleur style et détail
La précision plutôt que le flou
L’une des leçons pratiques de l’utilisation de Seedream 5 Lite est que le modèle réagit très bien à un langage spécifique et concret. Les qualificatifs de style vagues comme « beau », « joli » ou « haute qualité » sont traités par l’encodeur de texte mais ne portent pas beaucoup d’information discriminante. Les descriptions précises de matériaux et d’optique ont bien plus de poids.
Au lieu de « peinture détaillée », essayez « huile sur toile de lin, coups de brosse impasto visibles, texture de couteau à palette dans les hautes lumières, sous-peinture d’ombres froides ». Au lieu de « bon éclairage », essayez « lumière diffuse unique d’une fenêtre orientée au nord, température de couleur froide de 5500K, transition d’ombre douce ».
Ce principe de précision s’applique à chaque catégorie de descripteurs de style :
- Pellicules : « rendu du grain et des couleurs de Kodak Portra 400 » plutôt que « look argentique »
- Caractéristiques d’objectif : « faible profondeur de champ à 85mm f/1.8 » plutôt que « arrière-plan flou »
- Textures de surface : « tissage de tissu visible, définition des fils individuels » plutôt que « texturé »
- Conditions atmosphériques : « brume volumétrique du matin à travers les pins » plutôt que « brumeux »
Structurer un prompt à plusieurs éléments
Pour les scènes complexes avec plusieurs exigences de style, structurer votre prompt en couches donne à Seedream 5 Lite des signaux de conditionnement plus nets :
- Sujet et action d’abord : qui ou quoi, faisant quoi
- Environnement ensuite : où, avec quel entourage
- Éclairage en troisième : source, direction, qualité, température de couleur
- Caméra et objectif en quatrième : focale, ouverture, angle de prise de vue
- Texture et atmosphère en cinquième : détails de surface, effets atmosphériques, caractéristiques de la pellicule
Cet ordre correspond à peu près à la hiérarchie de l’importance visuelle dans une image : la composition globale d’abord, le détail local en dernier. Lorsqu’une génération échoue sur le style mais réussit la composition, conservez les éléments structurels de votre prompt et ne réécrivez que les descripteurs de style.
Vitesse ou qualité avec les modèles Lite
Ce que « Lite » retranche vraiment
La réduction de taille d’un modèle complet à un modèle Lite n’est pas sans contrepartie. Dans le cas de Seedream 5 Lite, les compromis apparaissent surtout dans :
- Scènes à nombreux objets : les modèles complets peuvent contenir simultanément davantage de concepts visuels distincts dans un seul cadre
- Détails extrêmes en gros plan sur des sujets non humains : l’ornementation architecturale complexe et les mécanismes montrent davantage de simplification à des niveaux de détail fins
- Plafond de complexité du prompt : les prompts très longs et fortement superposés peuvent perdre partiellement certains éléments spécifiés lorsqu’ils entrent en conflit entre eux
Ce qui n’est notablement pas sacrifié : la cohérence du style, la qualité des détails sur un sujet unique, la fidélité des couleurs et le rendu de texte bilingue tiennent bien la comparaison avec les modèles plus grands.
La vitesse d’inférence en pratique
Grâce à son nombre de paramètres réduit, Seedream 5 Lite fonctionne nettement plus vite que les alternatives à pleine échelle sur un matériel équivalent. Pour les créateurs qui réalisent un travail à haut volume, comme les portraits, les photos de produits ou les images éditoriales, une inférence plus rapide signifie davantage d’itérations par heure, ce qui produit souvent de meilleurs résultats finaux qu’une seule génération lente d’un modèle plus lourd.
Utilisez l’avantage de la vitesse pour lancer 5 à 10 variantes de prompt et sélectionner la meilleure, plutôt que de consacrer les mêmes ressources de calcul à une seule génération soigneusement réglée d’un modèle plus lent. La vitesse d’itération est en soi un outil créatif.
Résultats en conditions réelles
Là où il performe le mieux
Seedream 5 Lite est à son meilleur dans :
- Travail de portrait et de figure humaine : l’anatomie humaine, le détail de la peau et la précision des traits du visage sont nettement solides dans un large éventail de styles
- Images de mode et de textile : le rendu des tissus est l’une de ses capacités les plus claires, les matières structurées comme le denim, la dentelle et la laine produisant des motifs de tissage crédibles
- Esthétiques photographiques stylisées : les simulations de grain de film, les styles d’étalonnage des couleurs et les looks cinématographiques se reproduisent avec une grande fidélité à leurs esthétiques d’origine
- Compositions à sujet unique : des images avec un ou deux sujets sur des arrière-plans contextuels, où le modèle peut consacrer davantage de capacité aux détails du sujet principal
- Styles esthétiques d’Asie de l’Est : les données d’entraînement penchent vers l’art et la photographie asiatiques de haute qualité, ce qui donne au modèle une force distinctive dans ces traditions visuelles
Là où vous remarquerez les limites
Seedream 5 Lite montre ses limites dans :
- Mains avec de nombreux doigts qui se croisent : une faiblesse persistante des modèles de diffusion, un peu plus visible au nombre de paramètres de la version Lite
- Intérieurs architecturaux complexes : les scènes à nombreux éléments avec des exigences géométriques précises tendent à s’adoucir ou à se simplifier
- Animaux en mouvement : sujets non humains dynamiques avec une articulation complexe des membres
- Conceptions de produits très spécifiques : géométrie d’objets avec des exigences structurelles ou de marque précises
Garder les yeux ouverts sur ces limites fait partie de l’utilisation efficace de tout modèle. Pour ses cas d’usage visés, les capacités l’emportent largement sur les limitations.
Outils similaires sur PicassoIA
Si les capacités de style et de détail de Seedream 5 Lite vous intéressent, plusieurs modèles sur PicassoIA offrent des forces comparables ou complémentaires pour différents flux de travail créatifs.
PicassoIA Image est le modèle de texte vers image propre à la plateforme, offrant une haute fidélité visuelle dans un large éventail de styles et de sujets. Il gère bien le conditionnement par prompt complexe et se distingue particulièrement pour les rendus photoréalistes de portrait et de mode, avec un accent tout aussi marqué sur la qualité esthétique de ses sorties.
Flux Redux Dev adopte une approche différente : plutôt que de partir uniquement du texte, il crée des variations à partir d’une image de référence tout en préservant l’identité visuelle essentielle de l’original. C’est précieux lorsque vous avez un style ou une esthétique existants que vous souhaitez conserver sur plusieurs images générées, ce qui correspond étroitement à ce que Seedream 5 Lite obtient à partir du prompt textuel.
PicassoIA Image Editor Pro ajoute des capacités d’édition à la génération, vous permettant d’affiner les images générées grâce à l’inpainting, à l’outpainting et à des retouches ciblées. Cela se combine bien avec n’importe quel modèle de génération principal lorsque vous devez corriger des problèmes de détail précis dans une sortie par ailleurs solide, sans tout regénérer.
Créez vos propres images
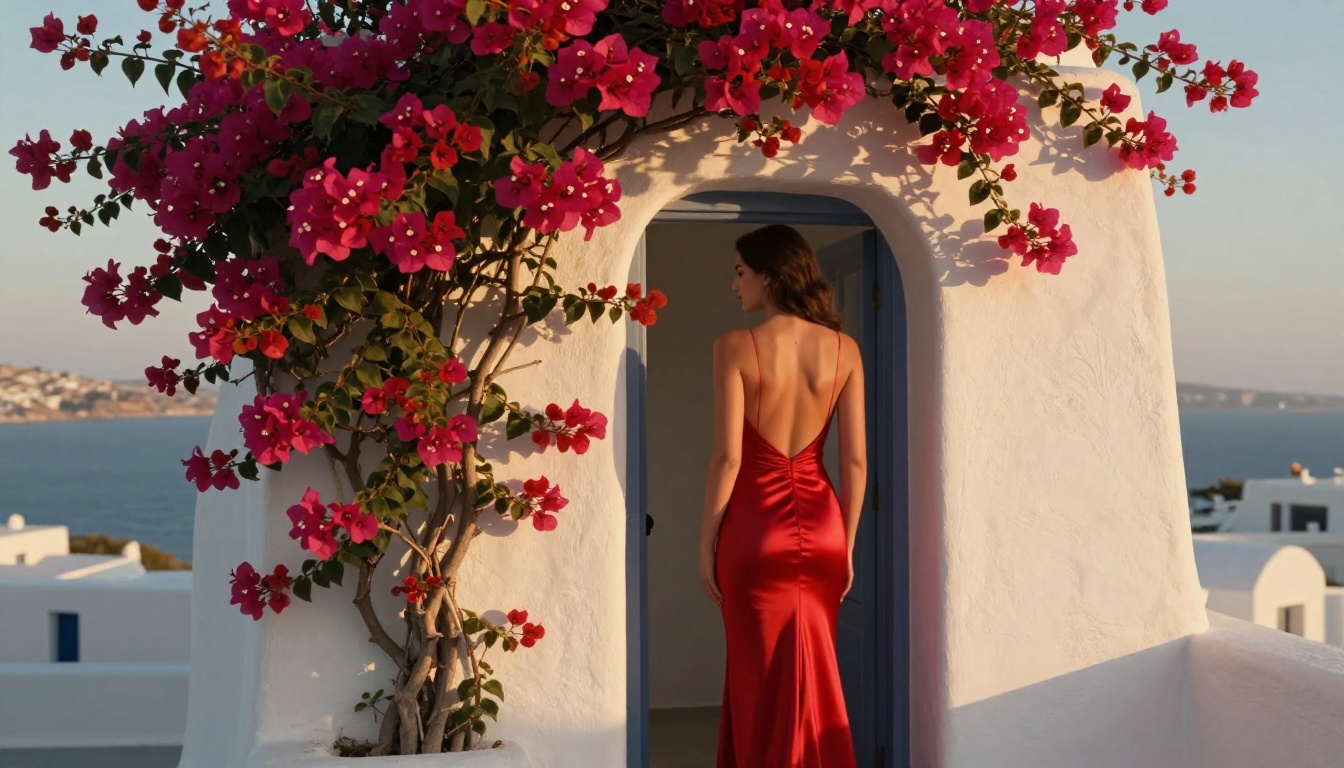
La meilleure façon de vraiment se faire une idée de la manière dont un modèle gère le style et le détail est de le faire tourner. L’approche de Seedream 5 Lite, centrée sur la sélection des données d’entraînement esthétiques, la cohérence globale fondée sur les transformers et la prise en charge du texte bilingue, produit une signature visuelle reconnaissable qui mérite d’être expérimentée directement.
Si vous voulez commencer à expérimenter la génération d’images par IA de haute qualité dès maintenant, PicassoIA vous donne accès à une vaste bibliothèque de modèles de texte vers image où vous pouvez immédiatement travailler avec des prompts qui testent la cohérence du style, la fidélité des détails et les compositions complexes.
Commencez par quelque chose de précis : décrivez une texture de tissu, une condition d’éclairage, une pellicule. Observez avec quelle précision le modèle traduit vos mots en réalité visuelle. Cette précision est ce que Seedream 5 Lite et les modèles construits sur des principes similaires s’efforcent d’atteindre, et c’est ce qui distingue les images qui semblent générées de celles qui semblent véritablement travaillées.


