O Seedream 5 Lite é um desses modelos que fazem você repensar o que o rótulo "lite" realmente significa na IA generativa. Lançado pela ByteDance como um modelo de texto para imagem compacto, mas capaz, ele tem cerca de 2 bilhões de parâmetros, uma fração do seu irmão maior. Na prática, porém, a fidelidade visual que ele produz, especialmente na consistência de estilo e nos detalhes finos, costuma superar as expectativas para sua categoria de peso.
Se você já passou algum tempo trabalhando com geração de imagens por IA, sabe que consistência de estilo e preservação de detalhes são onde a maioria dos modelos mostra suas falhas. Fazer um modelo manter uma identidade visual em uma cena complexa, ao mesmo tempo em que renderiza textura de cabelo, trama de tecido e profundidade de fundo, é realmente difícil. O Seedream 5 Lite adota uma abordagem específica para resolver os dois problemas, e vale a pena detalhar, na prática, como isso funciona.
A distinção entre um modelo "lite" que apenas sacrifica qualidade em troca de velocidade e outro que faz escolhas arquiteturais mais inteligentes é significativa. O Seedream 5 Lite se encaixa com firmeza na segunda categoria. Este artigo analisa os mecanismos por trás de suas capacidades de estilo e detalhe, onde ele tem um desempenho realmente bom e quais são os limites realistas na prática.
O que é o Seedream 5 Lite
A arquitetura de 2B parâmetros
O Seedream 5 Lite pertence à família de modelos Seedream da ByteDance, que se posicionou como um concorrente sério no espaço de geração de imagens por IA, tanto na China quanto no mundo. A designação "Lite" se refere à contagem de parâmetros do modelo: aproximadamente 2 bilhões, em comparação com o tamanho maior do Seedream 5 completo.
Não se trata apenas de tamanho para facilitar o acesso. A arquitetura Lite reflete decisões deliberadas sobre onde alocar a capacidade do modelo. A equipe da ByteDance focou na eficiência de treinamento e na qualidade cuidadosamente curada do conjunto de dados, em vez de simplesmente aumentar os parâmetros. O resultado é um modelo que produz qualidade perceptual muito acima do que a contagem de parâmetros sozinha sugeriria.
| Especificação | Seedream 5 Lite | Modelo típico de escala completa |
|---|
| Parâmetros | ~2B | 8B–12B |
| Dados de treinamento | Estético alto e curado | Raspados da web em larga escala |
| Renderização de texto | Bilíngue (CN + EN) | Focado em inglês |
| Velocidade de inferência | Rápida | Mais lenta |
| Precisão de estilo | Alta | Variável |
Por que a arquitetura transformer muda as coisas
A arquitetura de um modelo de difusão afeta diretamente o que ele consegue reter sobre estilo. O Seedream 5 Lite usa um backbone de difusão baseado em transformer, em vez da arquitetura UNet mais antiga, que dominou as gerações anteriores de modelos.
A diferença prática: arquiteturas transformer usam auto-atenção global, o que significa que cada posição espacial no processo de geração da imagem pode prestar atenção a todas as outras. Em um modelo UNet, a informação flui por uma estrutura hierárquica de codificador-decodificador, na qual posições distantes só se influenciam indiretamente. Para a coerência de estilo em uma composição inteira, a abordagem transformer oferece resultados significativamente melhores.
Janelas de cross-attention maiores permitem que o modelo relacione partes distantes de uma imagem entre si, e é assim que ele mantém a coerência estilística do primeiro plano ao fundo, do sujeito ao cenário. Esse é um dos motivos pelos quais o Seedream 5 Lite muitas vezes mostra uma integridade composicional mais forte do que modelos baseados em UNet com contagens de parâmetros mais altas.
💡 Por que funciona: A auto-atenção do transformer permite que o modelo "veja" a imagem inteira de uma vez durante a geração, não apenas vizinhanças locais. É isso que evita o aspecto desconexo que você obtém quando um modelo renderiza um sujeito em um estilo e o fundo em outro.
O motor de estilo dentro do Seedream 5 Lite
Como a pontuação estética molda o modelo
Um dos aspectos mais distintivos do pipeline de treinamento do Seedream 5 é o uso intenso de pontuação estética na curadoria do conjunto de dados. Em vez de treinar com todos os pares imagem-texto disponíveis, o pipeline filtra por qualidade visual, harmonia de cores, equilíbrio composicional e apelo estético geral.
Isso é uma forma de treinamento ponderado pela qualidade: o modelo vê exemplos limpos e de alta qualidade com muito mais frequência do que os medíocres. O efeito no resultado é real e mensurável. O Seedream 5 Lite tem uma forte tendência a produzir imagens com paletas de cores de aparência natural, iluminação bem equilibrada e composições que parecem intencionais, não acidentais.
Além da curadoria, o processo de treinamento da ByteDance incorpora feedback estético como sinal de recompensa, de forma semelhante a como o RLHF (Aprendizado por Reforço com Feedback Humano) funciona em modelos de linguagem, mas adaptado para saída visual. Avaliadores humanos analisam as imagens geradas, e essas avaliações moldam a função de recompensa do modelo durante o fine-tuning. É por isso que o modelo tende a produzir resultados visualmente agradáveis mesmo quando os prompts são ambíguos ou pouco especificados.
Tokens de estilo e condicionamento por texto
O Seedream 5 Lite usa um codificador de texto sofisticado que processa a linguagem relacionada a estilo com notável precisão. Quando você escreve "aquarela sobre papel texturizado" ou "film grain, Kodak Portra 400", a via de condicionamento de texto do modelo foi treinada para associar essas expressões a distribuições visuais específicas.
Essa é a diferença entre um modelo que aproxima vagamente um estilo e outro que realmente se compromete com ele. A textura de uma aguada de aquarela, a curva tonal específica de um filme fotográfico, a qualidade de borda pictórica do óleo sobre tela: tudo isso se traduz do prompt para o pixel com mais fidelidade do que você normalmente vê nessa contagem de parâmetros.
Identidade visual consistente em toda a cena
Onde muitos modelos têm dificuldade é em manter um estilo consistente em todos os elementos de uma cena complexa. Um modelo pode renderizar o sujeito em estilo fotorrealista enquanto o fundo parece uma estética completamente diferente. O mecanismo de atenção global do Seedream 5 Lite permite que cada parte da imagem influencie todas as outras durante a geração.
O resultado é a coerência composicional: a lógica de iluminação se mantém consistente do primeiro plano ao fundo, a gradação de cor se aplica de maneira uniforme e as texturas estilísticas não mudam de repente no meio do quadro. Quando você especifica um estilo visual, ele se sustenta em toda a composição.
Como ele captura detalhes finos
Textura e fidelidade de superfície
A renderização de detalhes em modelos de difusão depende da capacidade do modelo de manter informação de alta frequência ao longo do processo de remoção de ruído. Os modelos de difusão funcionam removendo o ruído gradualmente, e detalhes finos como poros da pele, trama de tecido e nervuras de folhas ocupam as faixas de maior frequência de uma imagem.
O Seedream 5 Lite lida com isso melhor do que a maioria dos modelos de 2B parâmetros por causa de sua resolução de treinamento. O modelo foi treinado com recortes de imagens em alta resolução, o que significa que ele viu e aprendeu informações visuais de granulação fina em um nível de detalhe que modelos treinados com recortes menores simplesmente não encontraram.
O cronograma de remoção de ruído também importa: quantos passos o modelo leva para resolver os detalhes a partir do ruído e em que momento a estrutura fina e a grossa são estabelecidas. Cronogramas de remoção de ruído bem ajustados resultam em melhor preservação de detalhes finos com o mesmo número de passos de inferência. Essa é uma área de otimização ativa na família Seedream.
Microdetalhes em tecido e cabelo
Duas categorias de detalhe que expõem de forma consistente as fraquezas dos modelos são tecido e cabelo. Ambos envolvem padrões complexos com informação direcional (direção da trama, fluxo do cabelo), características em escala sub-pixel e interações com a luz que exigem modelar geometria e propriedades do material ao mesmo tempo.
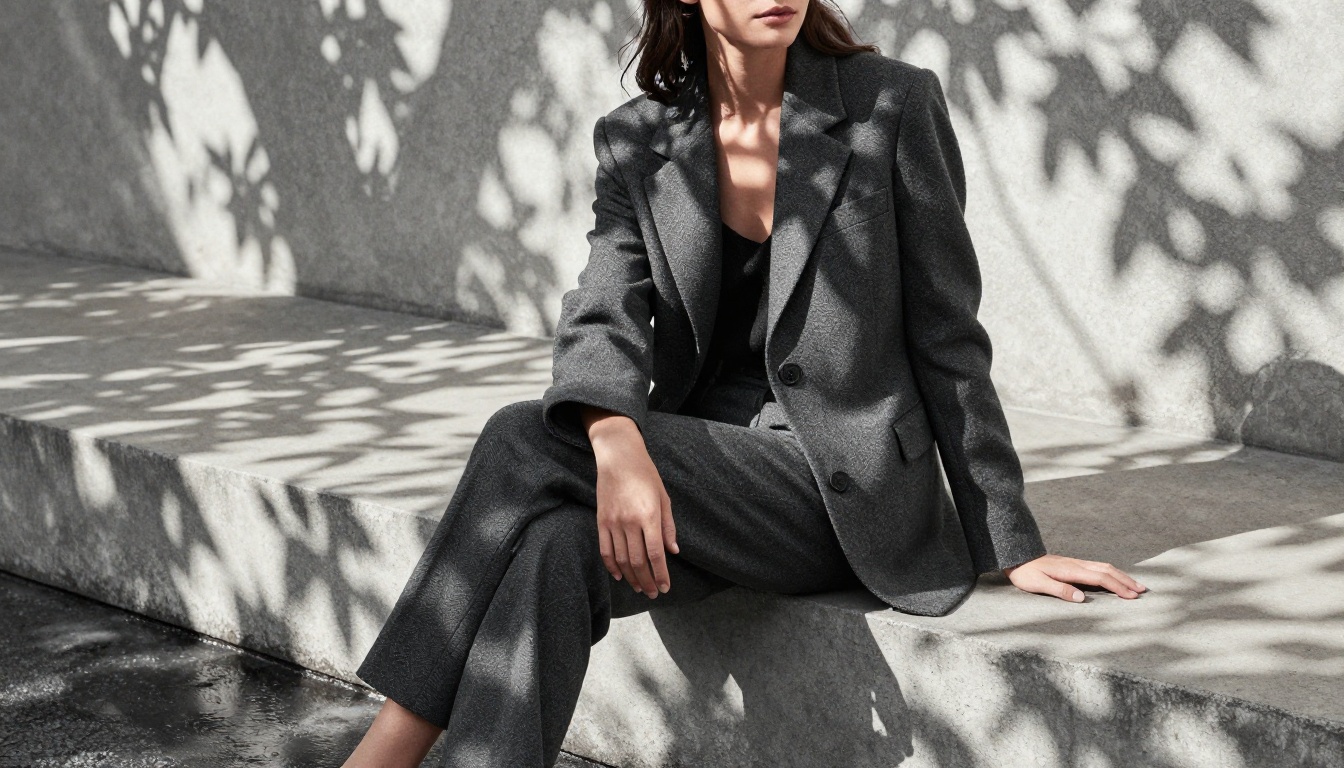
O Seedream 5 Lite tem um bom desempenho nas duas. Texturas de tecido, especialmente materiais estruturados como jeans, renda e lã, mostram padrões de trama críveis. O cabelo é renderizado com fluxo direcional e variação apropriada de micro-fios, em vez da massa uniforme com aparência de pintura que modelos mais fracos produzem.
Isso reflete tanto a qualidade dos dados de treinamento quanto o campo receptivo efetivo do modelo, que permite modelar padrões de textura locais e, ao mesmo tempo, manter coerência com o contexto estrutural maior ao redor deles.
💡 Dica de prompt: Para tirar o máximo de detalhe do Seedream 5 Lite, descreva a textura explicitamente. Expressões como "textura visível de trama de linho" ou "fios de cabelo individuais em foco nítido" ativarão a capacidade de renderização de alta frequência do modelo com mais confiabilidade do que palavras de estilo vagas.
Renderização de texto bilíngue
Por que o texto em imagens é difícil
Renderizar texto legível dentro de imagens geradas é um dos problemas genuinamente difíceis da síntese de imagens baseada em difusão. A razão é arquitetural: os modelos de difusão geram imagens como um campo inteiro de pixels, não como uma composição semântica de elementos distintos. O texto, com suas formas precisas de glifos e relações espaciais, exige precisão espacial extremamente alta ao longo de limites finos de características.
A maioria dos modelos ocidentais de imagem por IA foi treinada principalmente com dados em inglês e ainda tem dificuldade com texto de várias palavras dentro das imagens. Espaçamento entre caracteres, alinhamento de linha de base e consistência de fonte se degradam à medida que a complexidade do texto aumenta.
A vantagem do chinês e do inglês
O Seedream 5 Lite foi explicitamente treinado para renderização de texto bilíngue, cobrindo caracteres em chinês simplificado e em inglês. Isso é um diferencial significativo para criadores de conteúdo que trabalham em mercados asiáticos, ou para quem precisa de texto preciso incorporado em imagens geradas.
O modelo lida com sinalização, rótulos de produtos, texto de pôsteres e tipografia decorativa com notável precisão para sua categoria. A renderização de caracteres chineses é particularmente forte, dada a complexidade dos traços dos glifos chineses em comparação com as formas de letras latinas. Os traços individuais dos caracteres mantêm suas formas distintas, em vez de se fundirem.
| Tipo de texto | Seedream 5 Lite | Modelo ocidental típico |
|---|
| Texto curto em inglês | Excelente | Bom |
| Frases longas em inglês | Bom | Fraco |
| Chinês simplificado | Forte | Muito fraco |
| Bilíngue misto | Forte | Geralmente quebrado |
| Estilo manuscrito | Moderado | Fraco |
Como escrever prompts que trazem o máximo de estilo e detalhe
Especificidade em vez de vagueza
Uma das lições práticas de trabalhar com o Seedream 5 Lite é que o modelo responde muito bem a uma linguagem específica e concreta. Descritores de estilo vagos como "bonito", "legal" ou "alta qualidade" são processados pelo codificador de texto, mas não carregam muita informação discriminativa. Descrições específicas de material e ótica têm muito mais peso.
Em vez de "pintura detalhada", experimente "óleo sobre tela de linho, pinceladas de empasto visíveis, textura de espátula nos realces, subpintura de sombra fria". Em vez de "boa iluminação", experimente "luz única e difusa de janela voltada para o norte, temperatura de cor fria de 5500K, transição suave de sombra".
Esse princípio de especificidade se aplica a todas as categorias de descritores de estilo:
- Tipos de filme: "renderização de grão e cor do Kodak Portra 400" em vez de "aspecto de filme"
- Características da lente: "85mm f/1.8 com profundidade de campo rasa" em vez de "fundo desfocado"
- Texturas de superfície: "trama de tecido visível, definição de fios individuais" em vez de "texturizado"
- Condições atmosféricas: "névoa matinal volumétrica através dos pinheiros" em vez de "nevoento"
Estruturação de prompts com múltiplos elementos
Para cenas complexas com vários requisitos de estilo, estruturar seu prompt em camadas dá ao Seedream 5 Lite sinais de condicionamento mais limpos:
- Sujeito e ação primeiro: Quem ou o quê, fazendo o quê
- Ambiente em segundo: Onde, com quais arredores
- Iluminação em terceiro: Fonte, direção, qualidade, temperatura de cor
- Câmera e lente em quarto: Distância focal, abertura, ângulo de tomada
- Textura e atmosfera em quinto: Detalhes de superfície, efeitos atmosféricos, características de filme
Essa ordem corresponde aproximadamente à hierarquia de importância visual de uma imagem: composição global primeiro, detalhe local por último. Quando uma geração erra no estilo, mas acerta na composição, mantenha os elementos estruturais do seu prompt e reescreva apenas os descritores de estilo.
Velocidade ou qualidade em modelos Lite
O que o "Lite" realmente corta
A redução de tamanho de um modelo de escala completa para um modelo Lite não é gratuita. No caso do Seedream 5 Lite, as contrapartidas aparecem com mais clareza em:
- Cenas com muitos objetos: Modelos de escala completa conseguem sustentar mais conceitos visuais distintos simultaneamente em um único quadro
- Detalhe em close extremo de sujeitos não humanos: Ornamentos arquitetônicos complexos e maquinário mostram mais simplificação em níveis de detalhe fino
- Teto de complexidade do prompt: Prompts muito longos e com muitas camadas podem deixar de lado parcialmente elementos especificados quando eles entram em conflito entre si
O que notavelmente não é sacrificado: coerência de estilo, qualidade de detalhe em sujeito único, fidelidade de cor e renderização de texto bilíngue se sustentam bem em relação a modelos maiores.
Velocidade de inferência na prática
Por causa da contagem de parâmetros reduzida, o Seedream 5 Lite roda visivelmente mais rápido do que alternativas de escala completa em hardware equivalente. Para criadores que fazem trabalho de alto volume, como retratos, fotos de produtos ou imagens editoriais, inferência mais rápida significa mais iterações por hora, o que muitas vezes produz resultados finais melhores do que uma única geração lenta de um modelo mais pesado.
Use a vantagem de velocidade para rodar de 5 a 10 variações de prompt e escolher a melhor, em vez de gastar o mesmo processamento em uma única geração cuidadosamente ajustada de um modelo mais lento. A velocidade de iteração é, por si só, uma ferramenta criativa.
Resultados no mundo real
Onde ele tem melhor desempenho
O Seedream 5 Lite está no seu melhor em:
- Trabalho com retratos e figura humana: Anatomia humana, detalhe de pele e precisão de traços faciais são notavelmente fortes em uma grande variedade de estilos
- Imagens de moda e têxteis: A renderização de tecido é uma de suas capacidades mais claras, com materiais estruturados como jeans, renda e lã produzindo padrões de trama críveis
- Estéticas de fotografia estilizada: Simulações de grão de filme, estilos de gradação de cor e looks cinematográficos se reproduzem com alta fidelidade às suas estéticas de origem
- Composições de foco único: Imagens com um ou dois sujeitos contra fundos contextuais, em que o modelo pode dedicar mais capacidade ao detalhe do sujeito principal
- Estilos estéticos do Leste Asiático: Os dados de treinamento tendem para arte e fotografia asiáticas de alta qualidade, o que dá ao modelo uma força distintiva nessas tradições visuais
Onde você vai notar limites
O Seedream 5 Lite mostra seus limites em:
- Mãos com muitos dedos interagindo: Uma fraqueza persistente de modelos de difusão, um pouco mais visível na contagem de parâmetros Lite
- Interiores arquitetônicos complexos: Cenas com muitos elementos e exigências geométricas precisas tendem a suavizar ou simplificar
- Animais em movimento: Sujeitos não humanos dinâmicos com articulação complexa de membros
- Designs de produto altamente específicos: Geometria de objetos com exigências estruturais ou de marca precisas
Ser realista quanto a esses limites faz parte de usar qualquer modelo com eficiência. Para os casos de uso para os quais ele foi pensado, as capacidades superam significativamente as limitações.
Ferramentas semelhantes no PicassoIA
Se as capacidades de estilo e detalhe do Seedream 5 Lite despertaram seu interesse, vários modelos no PicassoIA oferecem forças comparáveis ou complementares para diferentes fluxos de trabalho criativos.
O PicassoIA Image é o modelo próprio de texto para imagem da plataforma, com alta fidelidade visual em uma grande variedade de estilos e sujeitos. Ele lida bem com condicionamento de prompts complexos e é especialmente forte para saídas fotorrealistas de retrato e moda, com uma ênfase semelhante na qualidade estética em sua distribuição de saída.
O Flux Redux Dev adota uma abordagem diferente: em vez de partir puramente de texto, ele cria variações a partir de uma imagem de referência, preservando a identidade visual central do original. Isso é valioso quando você tem um estilo ou uma estética existente que quer manter em várias imagens geradas, o que se aproxima muito do que o Seedream 5 Lite alcança a partir do lado do prompt de texto.
O PicassoIA Image Editor Pro adiciona recursos de edição sobre a geração, permitindo refinar imagens geradas com inpainting, outpainting e edições pontuais. Ele combina bem com qualquer modelo de geração principal quando você precisa corrigir problemas de detalhe específicos em uma saída de outra forma forte, sem regenerar do zero.
Crie suas próprias imagens
A melhor maneira de realmente sentir como um modelo lida com estilo e detalhe é executá-lo. A abordagem do Seedream 5 Lite, com foco na curadoria de dados de treinamento estéticos, coerência global baseada em transformer e suporte a texto bilíngue, produz uma assinatura visual reconhecível que vale a pena experimentar diretamente.
Se você quer começar a experimentar geração de imagens por IA de alta qualidade agora mesmo, o PicassoIA dá acesso a uma ampla biblioteca de modelos de texto para imagem, onde você pode começar imediatamente a trabalhar com prompts que testam consistência de estilo, fidelidade de detalhe e composições complexas.
Comece com algo específico: descreva uma textura de tecido, uma condição de iluminação, um tipo de filme. Veja com que precisão o modelo traduz suas palavras em realidade visual. Essa precisão é o que o Seedream 5 Lite e os modelos construídos com princípios semelhantes estão buscando acertar, e é o que separa imagens que parecem geradas de imagens que parecem genuinamente criadas.


