Antes, lograr que un rostro cantara en perfecta sincronía con una canción requería un estudio completo de captura de movimiento, un equipo de VFX y semanas de postproducción. Hoy, un solo modelo de IA lo hace en menos de dos minutos, con solo una foto o un clip de video y un archivo de audio. Ese cambio ha abierto la puerta a creadores independientes, músicos, profesionales del marketing y desarrolladores para producir contenido que antes era territorio exclusivo de producciones de gran presupuesto.
La demanda es real. Los creadores musicales quieren videos de letras animadas. Los responsables de redes sociales buscan clips para compartir. Los profesores de idiomas necesitan contenido doblado para cantar en grupo. Los anunciantes quieren rostros que hablen directamente a audiencias regionales en su propio idioma, con las bocas bien sincronizadas. La sincronización labial con IA responde a todas estas necesidades a la vez.
Qué hace realmente la sincronización labial con IA
En esencia, la sincronización labial con IA es un proceso de generación de video. Un modelo toma un archivo de audio y un video (o una imagen) de origen, analiza la secuencia de fonemas del audio y asigna las formas de la boca, los movimientos de la mandíbula y las deformaciones de los músculos faciales, fotograma a fotograma, sobre el rostro original. El resultado es un nuevo video en el que los movimientos visibles de la boca coinciden con el audio con una gran precisión temporal.
Esto es muy distinto del doblaje. El doblaje tradicional solo cambia la pista de audio. La sincronización labial con IA altera físicamente la imagen del video para que el rostro parezca hablar o cantar de verdad el nuevo audio. Es un proceso de síntesis de video, no de edición de audio.
La tecnología detrás de la sincronización de la boca
Los mejores modelos de sincronización labial actuales combinan varios procesos distintos que funcionan en secuencia:
- Detección de fonemas: el audio se descompone en sus unidades de sonido más pequeñas
- Seguimiento de puntos de referencia faciales: el modelo identifica y sigue entre 68 y 478 puntos faciales en el video de origen
- Síntesis generativa de fotogramas: se generan nuevos fotogramas de video en los que la zona de la boca coincide con cada fonema
- Suavizado temporal: las transiciones entre fotogramas se mezclan para evitar vibraciones o parpadeos
Modelos como Lipsync 2 Pro y React 1 usan redes neuronales basadas en atención, entrenadas con millones de horas de pares de audio y video de voz y canto. Por eso generalizan a rostros y voces nuevos que nunca han visto.
💡 Conviene saberlo: El modelo no necesita "conocer" el rostro de antemano. Se adapta a cualquier rostro nuevo sobre la marcha, durante la inferencia, sin necesidad de ajuste fino.
Por qué las canciones son más difíciles que el habla
La sincronización labial del habla es, a estas alturas, un problema en gran medida resuelto. Las canciones introducen dos complicaciones que el diálogo puro no tiene.
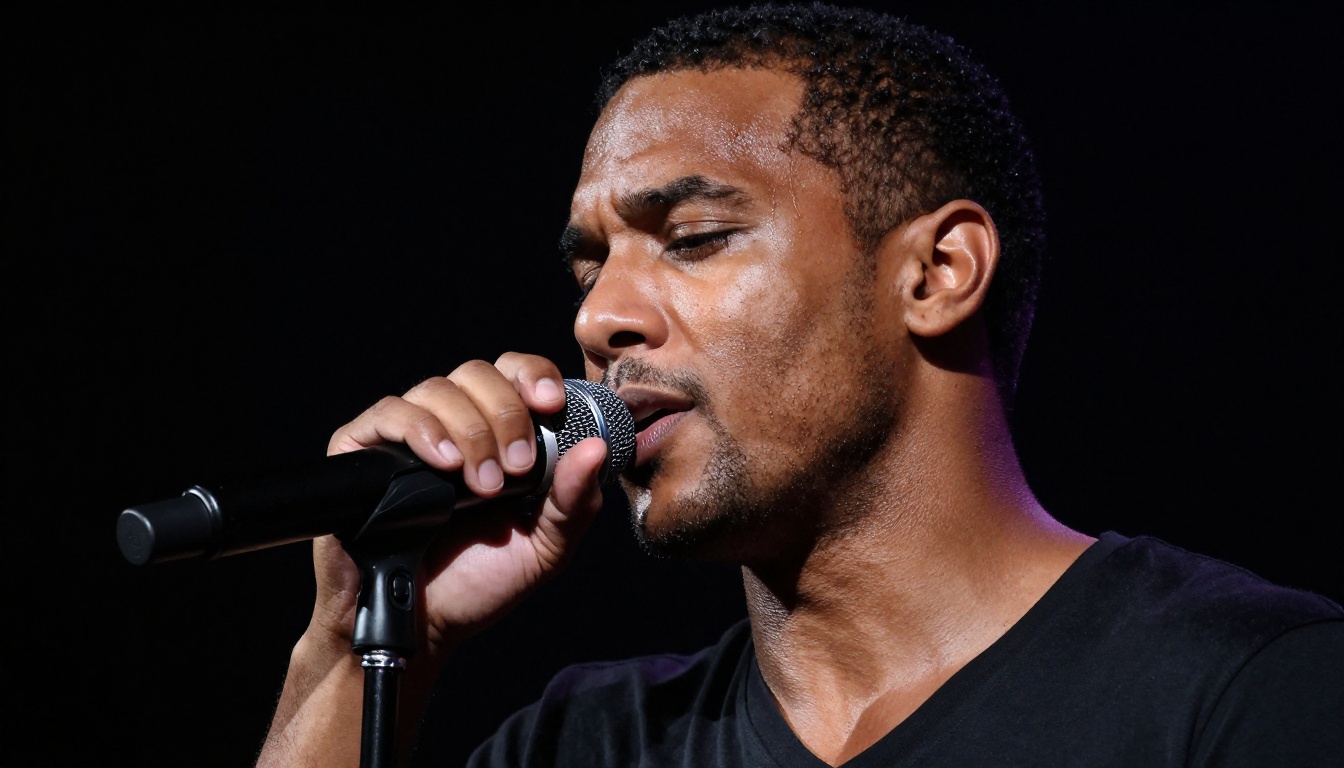
Primero, las vocales sostenidas. En el habla, las vocales duran entre 50 y 200 milisegundos. En el canto, una sola vocal puede mantenerse dos segundos o más. El modelo debe mantener una postura de boca abierta natural y realista durante periodos prolongados, sin producir fotogramas estáticos o que parezcan congelados.
Segundo, la tensión facial según el tono. Cuando una persona canta una nota aguda, sus músculos faciales se tensan de forma visible: se activa el platisma del cuello, los labios se retraen ligeramente y las fosas nasales se dilatan. Los buenos modelos de sincronización labial captan esto. Los básicos no, y producen un resultado plano, en el que la boca se mueve pero el resto del rostro parece en reposo.
Por eso importa elegir un modelo diseñado para ese fin. Omni Human 1.5 está pensado específicamente para la expresividad de todo el rostro, no solo para el movimiento aislado de la boca.
Los mejores modelos para sincronizar canciones
No todos los modelos de sincronización labial funcionan igual con contenido musical. Algunos están optimizados para el doblaje de habla, otros para avatares animados, y unos pocos están diseñados para los matices de la canción.
Precisión frente a velocidad
Existe una contrapartida real entre la calidad del resultado y el tiempo de procesamiento.
| Modelo | Fortaleza | Ideal para |
|---|
| Lipsync 2 Pro | Máxima precisión, expresión facial natural | Videoclips, contenido profesional |
| Lipsync 2 | Precisión sólida, procesamiento más rápido | Clips para redes sociales, pruebas iterativas |
| Lipsync Precision | Sincronización perfecta por fotograma, multilingüe | Producciones musicales dobladas |
| Lipsync Speed | Resultado más rápido | Borradores rápidos, reels cortos |
| React 1 | Microexpresiones realistas | Planos detallados del rostro |
| Kling Lip Sync | Muy bueno con metraje natural | Sincronización de personas reales cantando |
Para trabajos de videoclip, Lipsync 2 Pro es actualmente el modelo con mejores resultados en pasajes vocales sostenidos y expresiones faciales en notas agudas.
Sincronización de avatar frente a sincronización de video directa
También hay una diferencia importante entre dos enfoques principales:
La sincronización de video directa toma un video existente de una persona real y sustituye la zona de la boca por una versión nueva generada y sincronizada con el nuevo audio. Lipsync 2 Pro, Lipsync Speed y Kling Lip Sync funcionan de este modo.
La generación de avatares toma una sola foto fija y genera un video completo de ese rostro interpretando el audio desde cero. Omni Human 1.5, Omni Human, P Video Avatar y Fabric 1.0 funcionan de este modo.
Si tienes un video existente y quieres cambiar su voz, la sincronización directa es tu camino. Si solo tienes una foto (por ejemplo, la foto de prensa de una banda o la mascota de un producto), la generación de avatares produce un video cantando por completo a partir de una sola imagen.
Cómo usar Lipsync 2 Pro en PicassoIA
Lipsync 2 Pro de Sync es el modelo más capaz para la sincronización labial de canciones en la plataforma. Así se usa de principio a fin.
Paso 1: prepara tu clip de video
Tu video de origen debe cumplir algunos requisitos para obtener los mejores resultados:
- Visibilidad del rostro: el rostro debe verse claramente y sin obstrucciones durante al menos el 80 % del clip
- Iluminación: evita sombras intensas sobre la mitad inferior del rostro, porque dificultan el seguimiento de la boca
- Resolución: mínimo 720p, recomendable 1080p
- Duración: el modelo admite clips de varios minutos, pero los clips de menos de 60 segundos se procesan más rápido y son más fáciles de revisar
Si trabajas con una foto fija, Omni Human 1.5 es la mejor opción, ya que genera directamente el video completo de la interpretación a partir de la imagen.
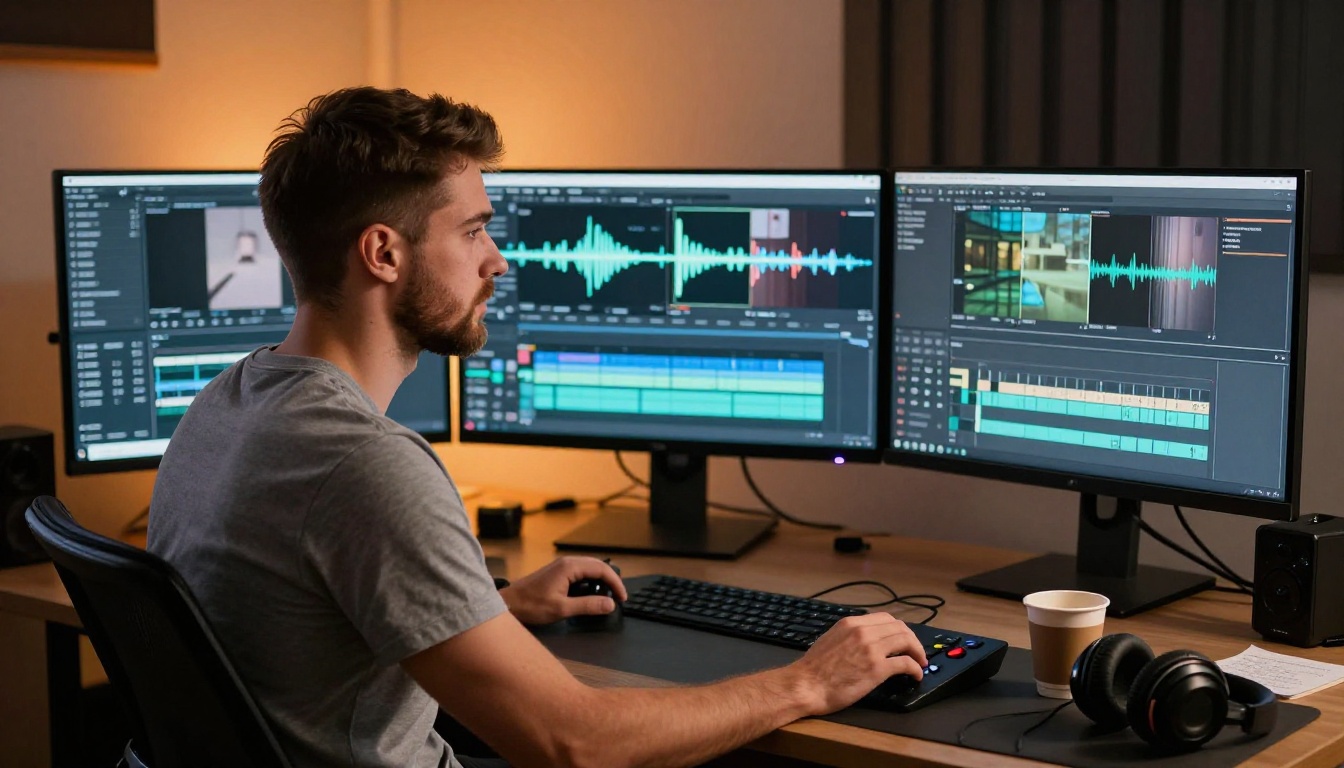
Paso 2: sube el audio de tu canción
El archivo de audio es donde la mayoría comete su primer error. Hay algunas cosas que conviene hacer bien antes de subirlo:
- Usa una pista vocal limpia si es posible, no una mezcla completa. Una mezcla con mucho bajo puede confundir la detección de fonemas.
- WAV o MP3 funcionan ambos. WAV a 44,1 kHz es lo ideal.
- Recorta el silencio al principio del archivo. Incluso 0,5 segundos de silencio inicial harán que la sincronización empiece tarde.
💡 Consejo profesional: Si usas una mezcla completa de la canción, prueba primero una herramienta de separación de audio. Darle al modelo de sincronización labial una señal vocal más limpia produce movimientos de boca notablemente más nítidos en todo el resultado.
Paso 3: configura los parámetros de sincronización
Dentro de la herramienta Lipsync 2 Pro de PicassoIA encontrarás opciones para:
- Modo de sincronización: elige "song" o "music" si está disponible; si no, selecciona el ajuste de máxima precisión
- Calidad de salida: selecciona siempre la más alta disponible, sobre todo para las exportaciones finales y no para los borradores
- Mezcla de la zona de la boca: controla cuánto del rostro que lo rodea se ve afectado por la generación. En contenido musical, una mezcla algo más amplia se ve más natural, ya que permite que las mejillas y la barbilla se muevan con el movimiento del canto.
Paso 4: descarga y comparte
Cuando termine el procesamiento (normalmente entre 30 y 90 segundos para un clip de 30 segundos), descarga el resultado y reprodúcelo junto al audio original. Revisa especialmente estos puntos:
- ¿La sincronización se mantiene durante el estribillo sin desfasarse?
- ¿Las vocales largas se ven naturales y fluidas?
- ¿Hay artefactos o parpadeos alrededor de los bordes de la boca?
Si la sincronización parece un poco tardía, normalmente se trata de un desfase del audio. Prueba a recortar otros 100 a 200 milisegundos del inicio del archivo de audio y vuelve a ejecutarlo.
La calidad del audio lo cambia todo
La variable que más influye en la calidad del resultado no es el modelo, la resolución del video ni el rostro que uses. Es el audio.
Formatos de archivo que funcionan
| Formato | Calidad | Notas |
|---|
| WAV 44,1 kHz | Mejor | Sin artefactos de compresión |
| FLAC | Excelente | Sin pérdida, más pequeño que WAV |
| MP3 320 kbps | Buena | Aceptable para la mayoría de usos |
| MP3 128 kbps | Regular | Los artefactos audibles pueden afectar a la detección de fonemas |
| AAC | Buena | Formato predeterminado de las grabaciones del iPhone |
Evita procesar audio muy comprimido. Si tu pista original es una grabación de flujo de baja tasa de bits, la detección de fonemas será menos precisa y los movimientos de los labios se verán más suaves y menos precisos.
Corregir el desfase de sincronización después de exportar
Algunos modelos producen resultados en los que la sincronización es precisa al principio, pero se desvía poco a poco hacia el final del clip. Normalmente se debe a una diferencia en la velocidad de fotogramas entre tu video de origen y el formato de salida del modelo.
Aquí tienes una solución sencilla:
- Comprueba la velocidad de fotogramas de tu video de origen (24 fps, 30 fps o 60 fps)
- Vuelve a exportar el video de origen a exactamente 25 fps antes de subirlo a PicassoIA
- Muchos modelos se entrenan sobre todo con datos a 25 fps y funcionan de forma más constante con esa velocidad
Para desfases persistentes que no responden a esta solución, Lipsync Precision maneja con más solidez las irregularidades en la velocidad de fotogramas que la mayoría de los otros modelos de la plataforma.
Las aplicaciones prácticas van mucho más allá de la curiosidad. Estos son tres casos de uso reales con un valor creativo y comercial importante.
Producción de videoclips con presupuesto ajustado
Los músicos independientes ya no necesitan contratar a un director, un equipo de cámara y una localización para producir un videoclip. Con una sola foto de retrato o un video selfie de 10 segundos, puedes generar un clip completo de interpretación con sincronización labial, de ti mismo o de un avatar estilizado cantando tu tema.
Omni Human 1.5 y P Video Avatar son especialmente buenos para este flujo de trabajo. Sube una foto, sube tu canción y obtendrás un video de interpretación completo. Añade un fondo en postproducción, corrige el color y tendrás un visual de calidad para lanzamiento en menos de una hora, sin rodar nada.
Redes sociales en la mitad de tiempo
El contenido de formato corto en TikTok, Reels y YouTube Shorts depende de una producción rápida y constante. Esperar días a un editor de video no es viable cuando necesitas publicar varias veces por semana.
Lipsync Speed está pensado exactamente para este caso de uso: procesamiento rápido, calidad de resultado sólida y optimizado para clips cortos. Combínalo con Pixverse Lipsync para variaciones estilizadas rápidas del mismo clip de origen.
💡 Consejo de contenido: Sincroniza un avatar que hable con la mascota de tu marca o con un personaje recurrente sobre audio de tendencia, para crear contenido instantáneo que detenga el scroll, sin aparecer tú mismo frente a la cámara.
Cantar en otros idiomas
Esta es una de las aplicaciones más potentes y menos aprovechadas. Toma cualquier canción, traduce la letra, genera voces nuevas en el idioma de destino con un modelo de texto a voz y luego sincroniza ese audio con el rostro original del cantante usando Lipsync Precision o Video Translate.
El resultado es una versión de la canción en la que el cantante parece interpretarla en un idioma que nunca grabó. Para los artistas, esto abre mercados internacionales sin sesiones de regrabación. Para los educadores, produce versiones en el idioma nativo de canciones populares para contenido de aprendizaje de idiomas.
Video Translate admite más de 150 idiomas y gestiona la traducción y la sincronización labial en un solo flujo de trabajo, lo que lo convierte en la opción más eficiente para producciones multilingües.
Comparativa de los mejores modelos de sincronización labial
Este es un desglose completo de todos los modelos disponibles en PicassoIA para trabajos de sincronización labial:
La elección correcta depende por completo de tu material de origen y de tu objetivo. Si tienes video, empieza con Lipsync 2 Pro si buscas calidad, o con Lipsync Speed para borradores. Si solo tienes una foto, Omni Human 1.5 produce la animación de cuerpo completo más expresiva a partir de una imagen fija.
Lleva tu resultado más lejos
Una vez que tengas tu video sincronizado, varias herramientas adicionales de PicassoIA pueden elevar aún más la calidad. Los modelos de superresolución escalan tu resultado de 720p a 4K sin volver a ejecutar el proceso de sincronización labial. Las herramientas de escalado de video con IA pueden estabilizar el metraje y reducir los artefactos de compresión que a veces aparecen durante la generación alrededor de la boca.
Para trabajos de videoclip en concreto, considera combinar tu video sincronizado con un fondo generado. Usa un modelo de texto a imagen para generar una escena que encaje con el ambiente de tu canción, úsala como fondo y superpón tu video sincronizado encima. La combinación de un fondo fotorrealista con un rostro bien sincronizado produce un resultado final que la mayoría de los espectadores no distinguiría de una producción rodada de forma tradicional.
Si tu canción necesita una identidad visual desde cero, los modelos de generación de música con IA también pueden crear pistas de acompañamiento completas a partir de prompts, de modo que toda la producción, incluida la canción, se mantenga dentro de una sola plataforma.
Empieza ya con tu primera sincronización labial
Las herramientas existen, son accesibles y producen resultados reales. Ya sea que quieras sincronizar un tema pop con tu propio rostro para un video en redes sociales, producir una versión multilingüe de la campaña de un cliente o crear un avatar cantante para un proyecto musical, PicassoIA tiene el modelo adecuado.
Elige tu material de origen, tu audio y tu modelo en la colección de sincronización labial. El primer resultado tarda menos de dos minutos en generarse. A partir de ahí, iterar es rápido y el límite de lo que puedes producir es realmente alto.
Tu canción. Cualquier rostro. Cualquier idioma. Ahora mismo.


