Cómo crear personajes de IA coherentes en cada escena
Crear personajes de IA coherentes es la diferencia entre jugar con imágenes y contar historias de verdad. Este artículo repasa los flujos de trabajo con imágenes de referencia, los anclajes de prompt y los modelos de edición de imágenes que mantienen el mismo rostro, vestuario y aspecto en decenas de escenas en PicassoIA.
Puedes generar una imagen de IA impresionante en ocho segundos. Intenta volver a generar a esa misma persona a la mañana siguiente y obtendrás a una desconocida. Otra mandíbula, otras pecas, otros ojos. El rostro que antes era inolvidable ahora pertenece a otra persona.
Esa distancia entre "una imagen preciosa" y "el mismo personaje en cuarenta escenas" es lo que separa los experimentos con arte de IA de la narrativa real. Las marcas necesitan una mascota que mantenga su forma. Los desarrolladores de juegos independientes necesitan una protagonista que sobreviva a un cambio de capítulo. Los dibujantes de cómics necesitan al mismo héroe en la viñeta tres y en la viñeta treinta.
A continuación tienes el flujo de trabajo, el vocabulario de prompts y los modelos concretos de PicassoIA que por fin hacen fiable la coherencia de personajes con IA.
💡 Regla práctica: La identidad no se sostiene solo con palabras. Se sostiene con una imagen de referencia, un vocabulario fijo y un editor que respete el rostro original.
Por qué la coherencia de personajes es tan difícil
Los modelos de difusión no guardan personajes. Reconstruyen las imágenes desde cero cada vez que pulsas generar, muestreando de un campo con ruido de rostros posibles. El mismo prompt puede sacar a una persona ligeramente distinta del espacio latente en cada ejecución.
El mismo prompt da un rostro nuevo
Aunque escribas una descripción precisa, "mujer con pecas, cabello castaño rojizo, ojos verdes, veintitantos años, mandíbula suave", le estás dando al modelo una categoría y no una persona. Hay millones de mujeres que encajan con esa descripción. El muestreador elige una al azar, según la semilla.
Cambia la semilla y la mujer cambia. Empuja el prompt un poco hacia "sonriendo" y la estructura ósea se mueve. Añade "en Tokio" y de pronto la barbilla se afila. Sin una imagen de anclaje, estás cambiando de actor en cada render.
Los modelos de difusión derivan a propósito
Esta deriva es una característica, no un error. Todo el sentido de la difusión es la variedad. Los modelos se entrenan para maximizar la creatividad entre prompts, lo que significa que pequeñas diferencias en la redacción o en la semilla producen grandes diferencias en el resultado. Eso es genial para los moodboards y malo para un personaje recurrente.
La solución es inyectar una señal visual fija que anule la deriva natural del modelo. Esa señal puede venir de tres lugares: una imagen de referencia, un LoRA entrenado o un modelo de edición que conserve la identidad y solo cambie la escena alrededor del rostro.
El enfoque de la foto de referencia
El método más sencillo funciona en menos de un minuto. Genera un único retrato de tu personaje que te guste y vuelve a introducirlo en la siguiente generación como referencia. Casi todos los modelos de imagen modernos de PicassoIA aceptan una imagen de referencia como entrada, y esa sola foto hace el noventa por ciento del trabajo pesado.
Un solo plano de héroe frente a hojas multiángulo
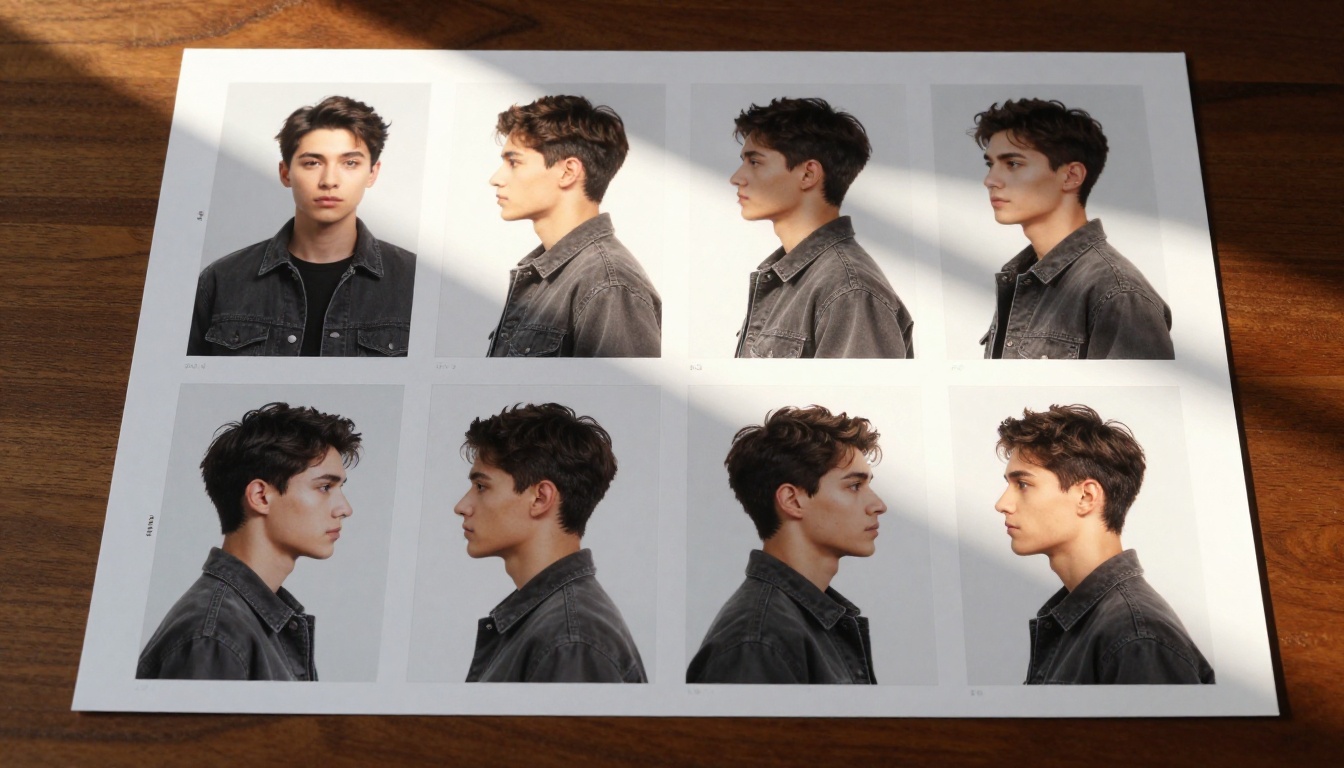
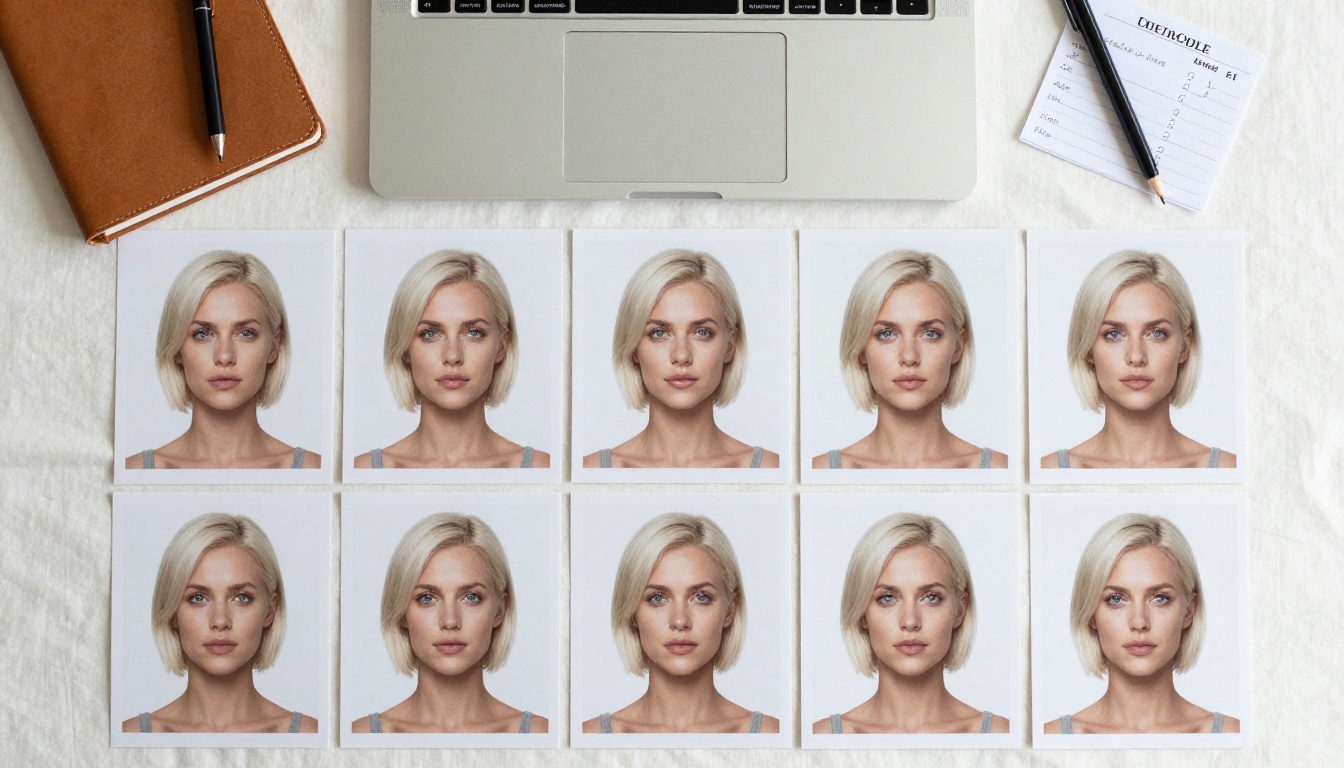
Algunos flujos quieren un único retrato de frente. Eso basta para el trabajo de texto a imagen estilizado con un modelo sólido de transferencia de identidad. Para una producción más exigente, crea una hoja de personaje de verdad: de frente, tres cuartos izquierdo, perfil, ligera vista cenital y ligero contrapicado. Cinco ángulos le dicen a un modelo mucho más sobre un rostro que uno solo.
Caso de uso
Configuración de referencia
Por qué
Retratos editoriales
1 plano de héroe
Los modelos de transferencia de identidad como Gen4 Image mantienen el rostro a partir de una sola foto de alta resolución
Viñetas de cómic y juegos
Hoja de 5 a 9 ángulos
El contexto multiángulo ayuda al modelo a renderizar a la misma persona en poses que nunca ha visto
Entrenamiento de LoRA
De 15 a 30 fotos
Más datos, más variedad de iluminación y un recuerdo de identidad más preciso
Qué capturar en la referencia
Tu referencia debe aislar el rostro de cualquier ruido visual que no pertenezca al personaje. Iluminación limpia, fondo neutro, sin maquillaje intenso, sin expresiones extremas. La boca cerrada suele renderizarse con más fiabilidad que una sonrisa amplia. Los ojos deben estar abiertos y mirando cerca de la cámara, no en un ángulo pronunciado.
Un retrato cercano y nítido da al modelo el detalle de alta frecuencia que define un rostro: la curva de la línea de pestañas inferiores, la asimetría de las fosas nasales, la distancia exacta entre el ojo y la ceja. Estos rasgos diminutos son los que hacen que un rostro parezca una persona concreta y no un tipo genérico.
Modelos que de verdad mantienen un rostro
No todos los modelos de imagen están pensados para trabajar con identidad. Algunos son impresionantes en composición, pero tratan el rostro como un adorno. Los que aparecen a continuación están ajustados para la coherencia de personajes, y todos están alojados en PicassoIA.
Ideogram Character
Ideogram Character es la interpretación más literal de este artículo. Está diseñado específicamente para mantener coherente a un personaje en escenas nuevas a partir de una sola foto de referencia. Sube el rostro, describe el nuevo escenario y genera a la misma persona en ese escenario. Maneja bien los cambios de vestuario y respeta el tono de piel, algo poco habitual en los modelos de texto a imagen.
MiniMax Image 01
MiniMax Image 01 lo promocionan sus creadores como un modelo de coherencia de personajes, y su rendimiento lo respalda. Funciona bien con prompts menos estrictos y perdona que la foto de referencia no esté perfectamente iluminada. Es ideal para iterar rápido cuando no quieres estar pendiente del prompt.
Nano Banana Pro y Seedream 4
Nano Banana Pro de Google y su hermano Nano Banana 2 están, sin hacer mucho ruido, entre los modelos más sólidos para fijar personajes en 2027. El modo fuse acepta un retrato más un nuevo escenario y los combina con el rostro intacto en 4K.
Seedream 4 de ByteDance es la otra opción en 4K que merece estar en tu rotación. Mantiene la identidad con firmeza cuando pasas una referencia y suele renderizar la textura de la tela y del cabello de forma más creíble que la mayoría de rivales.
Gen4 Image y Flux Kontext
Gen4 Image de Runway convierte explícitamente fotos de referencia en cualquier escena y es lo más parecido a los antiguos flujos de ControlNet con una interfaz moderna y limpia. Flux Kontext Pro toma una imagen de personaje de origen y te permite describir cambios en la escena que la rodea mientras protege el rostro. Ambos son excelentes cuando quieres colocar a un personaje ya establecido en un momento de la historia.
Anclajes de prompt que fijan la identidad
Una buena imagen de referencia te lleva al ochenta por ciento. El último veinte por ciento depende de cómo escribas el prompt. Los prompts que fijan la identidad repiten cinco o seis etiquetas visuales cada vez, como una clase CSS para tu personaje.
Dar nombre a tu personaje
Ponle a tu personaje un nombre interno fijo y descríbelo siempre de la misma manera. Aunque el modelo no "recuerda" el nombre entre ejecuciones, esa constancia en el vocabulario de tus prompts evita que la descripción se desvíe sin que te des cuenta.
Subject anchor: "Nora, 28, auburn shoulder-length wavy hair,
pale green almond eyes, three small freckles across the nose
bridge, slim oval face, olive linen blazer over cream silk
camisole."
Pega ese anclaje al principio de cada prompt de ese personaje. Después añade la nueva escena debajo.
Repetir etiquetas visuales
Elige de cinco a siete etiquetas visuales que funcionen como huellas dactilares. El color de los ojos, el color y el corte del cabello, un patrón de pecas distintivo, un accesorio característico, un vestuario por defecto, un descriptor de altura. Repítelas palabra por palabra. Los modelos responden sorprendentemente bien a la repetición exacta: si sigues diciendo "tres pequeñas pecas en el puente de la nariz", seguirás obteniendo tres pecas.
Bloqueos de vestuario y color
El vestuario es la señal de identidad más fácil de fijar que tienes. Un vestuario característico hace que la silueta le diga al público que es la misma persona incluso antes de leer el rostro. Fija un vestuario base y después describe las capas que van encima. La mayoría de espectadores no notan si un rostro ha cambiado un cinco por ciento. Sí notarán si la chaqueta de tu héroe cambia de color en mitad de una escena.
Etiqueta de anclaje
Ejemplo
Por qué funciona
Cabello
"cabello castaño rojizo ondulado a la altura de los hombros"
El cabello es uno de los rasgos visuales más fuertes a los que se aferra el modelo
Ojos
"ojos verdes pálidos almendrados con anillo exterior más oscuro"
El detalle específico del iris obliga al modelo a comprometerse con un ojo real
Marca en la piel
"tres pequeñas pecas en el puente de la nariz"
Un marcador contable es fácil de renderizar para el modelo y fácil de comprobar
Vestuario
"chaqueta de lino oliva, camisola crema"
El vestuario define la silueta, la pista de identidad de mayor alcance
Accesorio
"collar fino de cadena dorada"
Un elemento pequeño y fijo le da al público un punto de memoria
Entrenar un LoRA personalizado para tu héroe
Cuando no basta con el flujo de referencia y el prompt, puedes entrenar un pequeño modelo personalizado para tu personaje. Un LoRA es un peso de identidad ligero que se conecta a un modelo base de imagen y le indica "renderiza a esta persona concreta".
Cuándo un LoRA supera a una foto de referencia
Un LoRA gana cuando necesitas un personaje en cientos de generaciones en producción. Las fotos de referencia funcionan escena por escena, pero cuestan tiempo de subida y complejidad en el prompt. Un LoRA entrenado incorpora el rostro en el propio modelo. Solo escribes la palabra de activación y aparece la persona correcta.
Los LoRA también son superiores para personajes no fotográficos: ilustraciones estilizadas, protagonistas de anime, diseños de mascotas. Una foto de referencia no puede explicarle a un modelo de texto a imagen cómo se ve un personaje estilizado en tres cuartos. Un LoRA sí puede.
Flujo con P Image Trainer
P Image Trainer en PicassoIA te permite entrenar un LoRA de personaje en minutos. El flujo es sencillo:
Reúne de 15 a 30 fotos de tu personaje. Varía los ángulos, la iluminación y las expresiones. Mantén el vestuario y el cabello más o menos constantes.
Recorta de cerca. El rostro debe ocupar al menos el sesenta por ciento de cada encuadre.
Etiqueta cada imagen con un conjunto corto de etiquetas, incluida una palabra de activación única como nora_v1.
Sube las imágenes a P Image Trainer y ejecuta un entrenamiento corto.
Conecta el LoRA resultante a tus prompts de imagen. Todo prompt que incluya nora_v1 renderizará ahora al personaje entrenado.
💡 Consejo sobre el conjunto de datos: La diversidad en el conjunto de entrenamiento vence a la cantidad bruta. Veinte fotos variadas superan a cincuenta casi idénticas. Varía la iluminación, el ángulo y la expresión sutil, manteniendo el mismo rostro.
Fusión de múltiples imágenes para escenas de historia
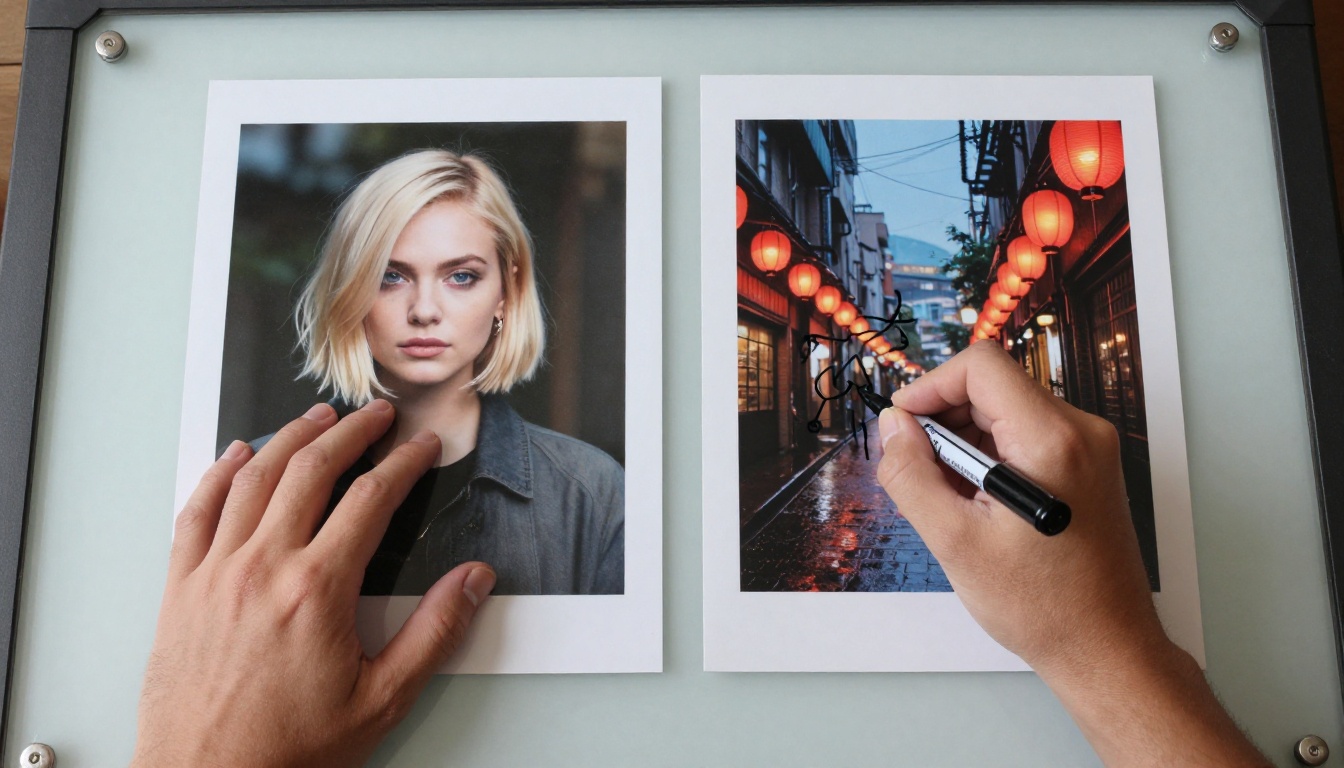
El método más nuevo no necesita ningún LoRA. Los modelos de fusión de múltiples imágenes aceptan dos o tres imágenes y las mezclan de forma inteligente: tu personaje a la izquierda, tu escenario a la derecha, y el resultado los combina.
Flux Kontext para cambios de pose
Flux Kontext Pro es el equivalente moderno de una transferencia de rostro con IP-Adapter. Le das un retrato y un prompt que pida una nueva pose o un nuevo vestuario, y edita la imagen existente conservando el rostro. Es la forma más eficiente de partir de un buen retrato y generar veinte variaciones creíbles.
Multi Image Kontext Max para escenarios nuevos
Para entornos totalmente nuevos, Multi Image Kontext Max acepta dos fotos de referencia y las combina. Pasa el retrato de tu personaje más una toma de una localización distinta y escribe un prompt que describa la acción. El modelo renderiza a tu personaje de forma creíble dentro de ese nuevo mundo. Es lo más cerca que ha estado la industria de "pon mi personaje en cualquier foto".
Corregir la deriva con Image Editor Pro
A veces el noventa y cinco por ciento no basta. El rostro está casi bien, pero los ojos han derivado ligeramente al verde cuando deberían ser avellana. El patrón de pecas se redujo de tres puntos a uno. Los pómulos subieron medio milímetro.
PicassoIA Image Editor Pro es la herramienta de limpieza ideal aquí. Ofrece generaciones ilimitadas y acepta ediciones con máscaras de precisión, así que puedes corregir el iris, restaurar las pecas o afinar una mandíbula sin volver a tirar toda la imagen. Trátalo como el último paso de cualquier flujo de personajes: renderiza con un modelo de fusión y luego pule con el editor.
El flujo que usan los profesionales para entregar su trabajo tiene este aspecto:
Opcionalmente, aumenta la resolución con un modelo de superresolución para impresión o entrega en 4K.
💡 Consejo profesional: Guarda tu retrato de héroe en alta resolución. Cualquier modelo posterior puede reducir tu referencia, pero ninguno puede inventar detalle que falta. Empieza nítido.
Crea tu primer personaje coherente en PicassoIA
Lo más difícil de los personajes de IA coherentes ya no es la tecnología. Las herramientas están listas, los modelos ya están maduros y el flujo de trabajo de arriba es el mismo que usan los artistas conceptuales de cine y los estudios de cómics independientes en 2026. El trabajo que queda es el que solo tú puedes hacer: elegir un rostro que parezca una persona, anotar sus etiquetas de anclaje y comprometerte con ellas.
Elige un modelo de la lista de arriba, genera un único retrato que de verdad te guste y trata esa imagen como canónica. Después pásala por Flux Kontext Pro o Multi Image Kontext Max para colocar a ese mismo personaje en el resto de tu historia. Cuando el rostro derive, corrígelo dentro de PicassoIA Image Editor Pro en lugar de volver a tirar los dados desde cero.