AI कैरेक्टर को एक जैसा बनाए रखना मज़ेदार इमेज प्ले और असली स्टोरीटेलिंग के बीच का फ़र्क है। यह लेख रेफ़रेंस वर्कफ़्लो, प्रॉम्प्ट एंकर और ऐसे इमेज एडिटिंग मॉडल समझाता है जो PicassoIA पर दर्जनों सीन में एक ही चेहरा, आउटफ़िट और अंदाज़ बनाए रखते हैं।
आप आठ सेकंड में एक शानदार AI इमेज प्रॉम्प्ट कर सकते हैं। अगली सुबह उसी व्यक्ति का प्रॉम्प्ट दोबारा करके देखें, तो आपको कोई अजनबी मिलेगा। अलग जबड़ा, अलग झाइयाँ, अलग आँखें। जो चेहरा कभी यादगार था, वह अब किसी और का लगता है।
"एक खूबसूरत इमेज" और "चालीस सीन में एक ही कैरेक्टर" के बीच का यही फ़ासला AI आर्ट के प्रयोग और असली स्टोरीटेलिंग को अलग करता है। ब्रांड को ऐसा मैस्कॉट चाहिए जिसकी शक्ल बनी रहे। इंडी गेम डेवलपर को ऐसा प्रोटैगोनिस्ट चाहिए जो चैप्टर बदलने के बाद भी वही दिखे। कॉमिक आर्टिस्ट को तीसरे पैनल और तीसवें पैनल में एक ही हीरो चाहिए।
नीचे वह वर्कफ़्लो, प्रॉम्प्ट की शब्दावली और PicassoIA के वे खास मॉडल हैं जो AI कैरेक्टर कंसिस्टेंसी को भरोसेमंद बनाते हैं।
💡 मोटा नियम: पहचान सिर्फ़ शब्दों से नहीं बनती। वह एक रेफ़रेंस इमेज, तय शब्दावली और ऐसे एडिटर से बनती है जो मूल चेहरे का सम्मान करे।
कैरेक्टर कंसिस्टेंसी इतनी मुश्किल क्यों है
डिफ़्यूज़न मॉडल कैरेक्टर को स्टोर नहीं करते। हर बार जब आप जनरेट दबाते हैं, वे इमेज को शुरू से दोबारा बनाते हैं और संभावित चेहरों के एक शोर-भरे क्षेत्र से नमूना लेते हैं। एक ही प्रॉम्प्ट हर रन में लैटेंट स्पेस से थोड़ा अलग व्यक्ति निकाल सकता है।
एक ही प्रॉम्प्ट, नया चेहरा
भले ही आप कसकर विवरण लिखें, "freckled woman, auburn hair, green eyes, late twenties, soft jaw", तब भी आप मॉडल को एक श्रेणी दे रहे हैं, कोई एक व्यक्ति नहीं। ऐसी लाखों महिलाएँ हैं जो इस विवरण से मेल खाती हैं। सैंपलर सीड से प्रभावित होकर किसी एक को बेतरतीब तरीके से चुन लेता है।
सीड बदलें तो महिला भी बदल जाती है। प्रॉम्प्ट को थोड़ा "smiling" की तरफ़ धकेलें तो चेहरे की बनावट बदल जाती है। "in Tokyo" जोड़ें तो अचानक ठोड़ी तीखी हो जाती है। बिना एंकर इमेज के, आप हर रेंडर पर किरदार की भूमिका फिर से तय कर रहे होते हैं।
डिफ़्यूज़न मॉडल जानबूझकर भटकते हैं
यह भटकाव बग नहीं, फ़ीचर है। डिफ़्यूज़न का पूरा मकसद विविधता है। मॉडल को प्रॉम्प्ट्स में रचनात्मकता अधिकतम करने के लिए प्रशिक्षित किया गया है, यानी शब्दों या सीड में छोटे फ़र्क से आउटपुट में बड़े फ़र्क आ जाते हैं। मूडबोर्ड के लिए यह बढ़िया है, पर बार-बार आने वाले कैरेक्टर के लिए बुरा।
इसका हल है एक तय विज़ुअल सिग्नल डालना जो मॉडल के स्वाभाविक भटकाव को रोक दे। यह सिग्नल तीन जगह से आ सकता है: एक रेफ़रेंस इमेज, एक ट्रेंड किया हुआ LoRA, या ऐसा एडिटिंग मॉडल जो सिर्फ़ चेहरे के आसपास का सीन बदले और पहचान को बचाए रखे।
रेफ़रेंस फ़ोटो का तरीका
सबसे सरल तरीका एक मिनट से भी कम में हो जाता है। अपने कैरेक्टर का एक पोर्ट्रेट जनरेट करें जो आपको पसंद हो, फिर उसे अगले जनरेशन में रेफ़रेंस के तौर पर दें। PicassoIA पर लगभग हर आधुनिक इमेज मॉडल रेफ़रेंस इमेज इनपुट स्वीकार करता है, और वह एक फ़ोटो लगभग नब्बे प्रतिशत भारी काम कर देती है।
एक हीरो शॉट बनाम मल्टी-एंगल शीट
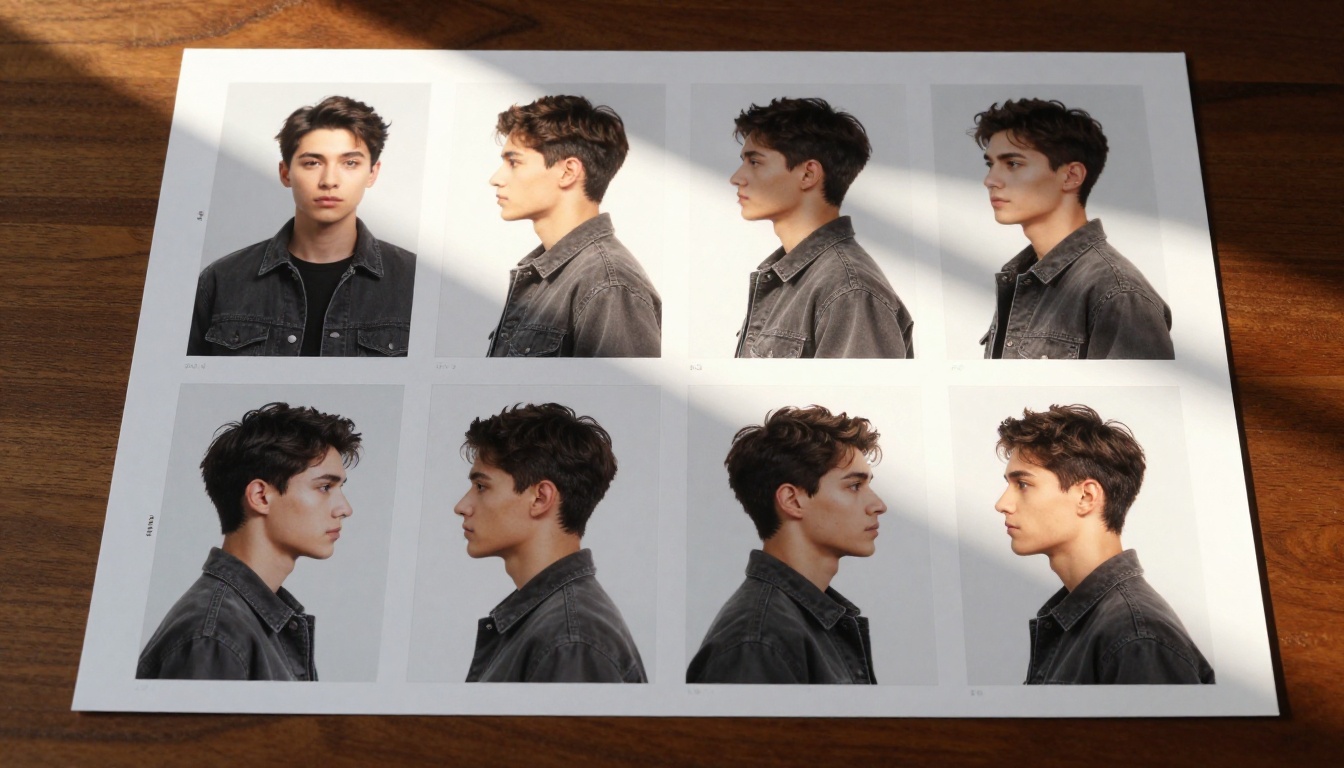
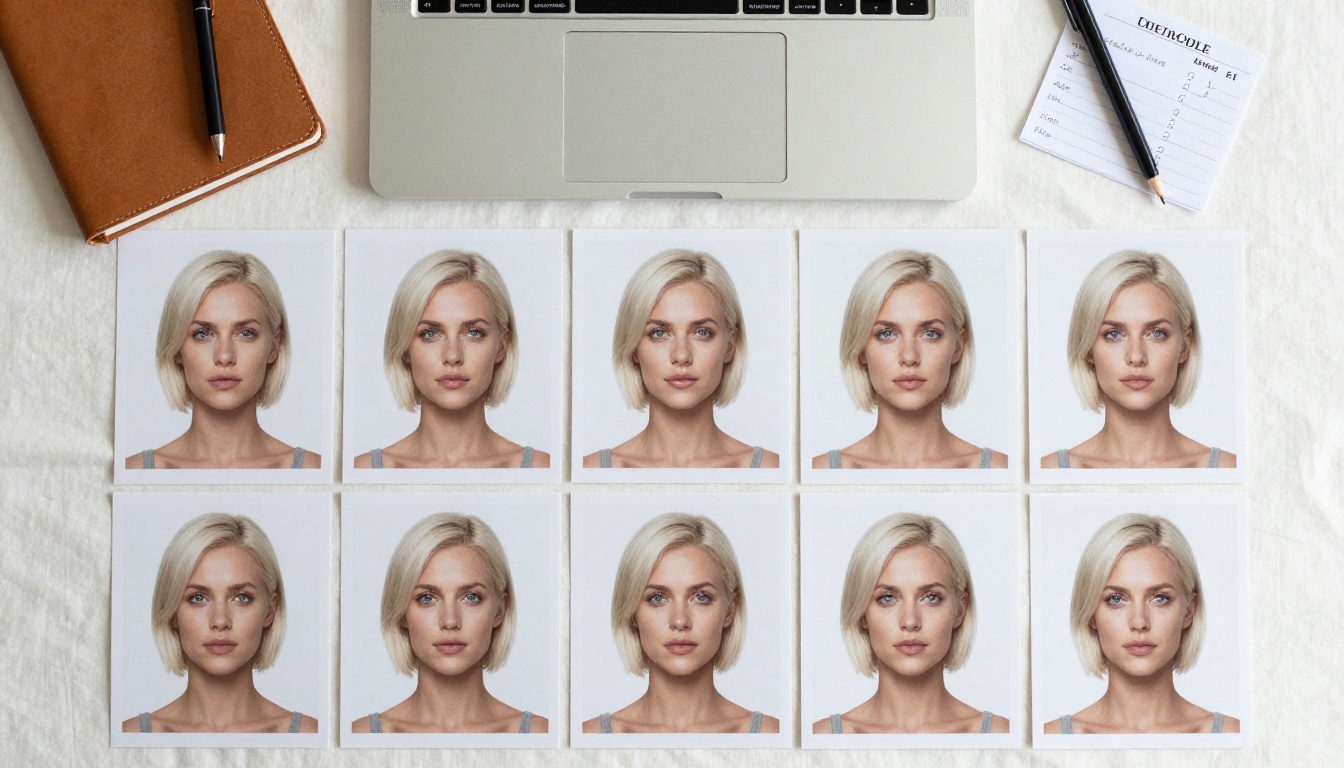
कुछ वर्कफ़्लो को एक ही फ़्रंट-फ़ेसिंग पोर्ट्रेट चाहिए। स्टाइलाइज़्ड टेक्स्ट-टू-इमेज काम के लिए, मज़बूत आइडेंटिटी ट्रांसफ़र मॉडल के साथ यह काफ़ी है। ज़्यादा माँग वाले प्रोडक्शन के लिए असली कैरेक्टर शीट बनाएँ: फ़्रंट, थ्री-क्वार्टर लेफ़्ट, प्रोफ़ाइल, हल्का ओवरहेड और हल्का लो एंगल। पाँच एंगल मॉडल को एक चेहरे के बारे में एक से कहीं ज़्यादा बताते हैं।
उपयोग
रेफ़रेंस सेटअप
क्यों
एडिटोरियल पोर्ट्रेट
1 हीरो शॉट
Gen4 Image जैसे आइडेंटिटी ट्रांसफ़र मॉडल एक हाई-रेज़ोल्यूशन फ़ोटो से ही चेहरा पकड़ लेते हैं
कॉमिक पैनल और गेम
5 से 9 एंगल शीट
मल्टी-एंगल संदर्भ मॉडल को उन पोज़ में वही व्यक्ति रेंडर करने में मदद करता है जो उसने पहले कभी नहीं देखे
LoRA ट्रेनिंग
15 से 30 फ़ोटो
ज़्यादा डेटा, रोशनी में ज़्यादा विविधता, चेहरे की ज़्यादा सटीक पहचान
रेफ़रेंस में क्या कैप्चर करें
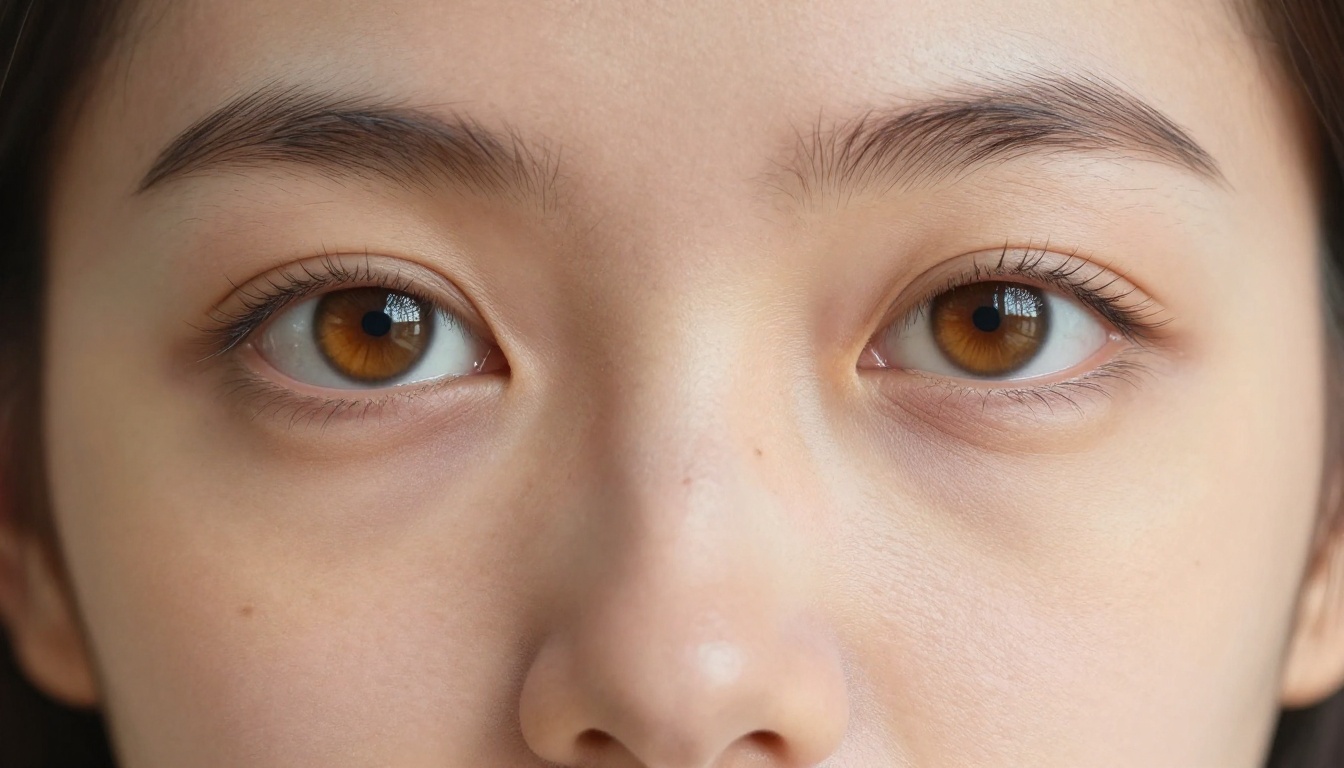
आपका रेफ़रेंस चेहरे को उन सभी विज़ुअल शोर से अलग करे जो कैरेक्टर के नहीं हैं। साफ़ रोशनी, न्यूट्रल बैकग्राउंड, भारी मेकअप नहीं, कोई अतिरंजित एक्सप्रेशन नहीं। बंद मुँह तेज़ मुस्कान से ज़्यादा भरोसेमंद रेंडर होता है। आँखें खुली हों और कैमरे के आसपास देख रही हों, किसी तीखे कोण पर नहीं।
एक नज़दीकी, तीखा पोर्ट्रेट मॉडल को वह हाई-फ़्रीक्वेंसी डिटेल देता है जो चेहरे को परिभाषित करती है: निचली पलक की रेखा का घुमाव, नथुनों की असमानता, आँख और भौंह के बीच की सटीक दूरी। ये छोटी बारीकियाँ ही किसी चेहरे को एक खास व्यक्ति जैसा महसूस कराती हैं, न कि किसी सामान्य टाइप जैसा।
वे मॉडल जो सच में चेहरा बनाए रखते हैं
हर इमेज मॉडल पहचान के काम के लिए नहीं बना है। कुछ कंपोज़िशन में शानदार होते हैं, पर चेहरे को सजावट भर मानते हैं। नीचे दिए मॉडल कैरेक्टर कंसिस्टेंसी के लिए ट्यून किए गए हैं, और ये सभी PicassoIA पर होस्ट हैं।
Ideogram Character
Ideogram Character इस लेख की सबसे सीधी व्याख्या है। यह खास तौर पर एक रेफ़रेंस फ़ोटो से नए सीन में कैरेक्टर को एक जैसा रखने के लिए बना है। चेहरा अपलोड करें, नए सेटिंग का विवरण दें, और यह उसी व्यक्ति को उस सेटिंग में रेंडर कर देता है। यह आउटफ़िट बदलने को अच्छी तरह संभालता है और स्किन टोन का सम्मान करता है, जो टेक्स्ट-टू-इमेज मॉडल में दुर्लभ है।
MiniMax Image 01
MiniMax Image 01 को उसके निर्माता कंसिस्टेंट-कैरेक्टर मॉडल के रूप में प्रचारित करते हैं, और परफ़ॉर्मेंस उसका समर्थन करती है। यह ढीले प्रॉम्प्ट्स के साथ अच्छा चलता है और अगर आपकी रेफ़रेंस फ़ोटो की रोशनी बिल्कुल सही न हो तो भी माफ़ कर देता है। जब आप प्रॉम्प्ट को बहुत ज़्यादा संभालना न चाहें, तब तेज़ इटरेशन के लिए अच्छा है।
Nano Banana Pro और Seedream 4
Google का Nano Banana Pro और उसका साथी Nano Banana 2 2027 के सबसे मज़बूत कैरेक्टर-लॉकिंग मॉडल में से कुछ हैं। फ़्यूज़ मोड एक पोर्ट्रेट और एक नया सेटिंग लेता है और दोनों को 4K में चेहरा बरकरार रखते हुए मिला देता है।
ByteDance का Seedream 4 एक और 4K विकल्प है जिसे रोटेशन में रखना चाहिए। रेफ़रेंस देने पर यह पहचान को कसकर थामे रखता है और ज़्यादातर प्रतिस्पर्धियों से ज़्यादा विश्वसनीय तरीके से कपड़े और बालों की बनावट रेंडर करता है।
Gen4 Image और Flux Kontext
Runway का Gen4 Image रेफ़रेंस फ़ोटो को किसी भी सीन में बदलने के लिए साफ़ तौर पर बना है और एक साफ़ आधुनिक इंटरफ़ेस में पुराने ControlNet वर्कफ़्लो के सबसे करीब है। Flux Kontext Pro एक सोर्स कैरेक्टर इमेज लेता है और आपको उसके आसपास के सीन में बदलाव का विवरण देने की सुविधा देता है, जबकि चेहरा सुरक्षित रहता है। जब आप किसी स्थापित कैरेक्टर को कहानी के किसी पल में रखना चाहते हैं, तब दोनों शानदार हैं।
प्रॉम्प्ट एंकर जो पहचान लॉक करते हैं
एक अच्छी रेफ़रेंस इमेज आपको अस्सी प्रतिशत तक पहुँचा देती है। आखिरी बीस प्रतिशत इस बात से आता है कि आप प्रॉम्प्ट कैसे लिखते हैं। पहचान लॉक करने वाले प्रॉम्प्ट हर बार वही पाँच-छह विज़ुअल टैग दोहराते हैं, जैसे आपके कैरेक्टर के लिए एक CSS क्लास।
अपने कैरेक्टर का नाम रखना
अपने कैरेक्टर को एक तय आंतरिक नाम दें, फिर उसका वर्णन हर बार एक ही तरीके से करें। भले ही मॉडल रनों के बीच नाम को "याद" न रखे, आपके प्रॉम्प्ट की शब्दावली में यह एकरूपता विवरण को अनजाने में बदलने से रोकती है।
Subject anchor: "Nora, 28, auburn shoulder-length wavy hair,
pale green almond eyes, three small freckles across the nose
bridge, slim oval face, olive linen blazer over cream silk
camisole."
उस एंकर को उस कैरेक्टर के हर प्रॉम्प्ट के सबसे ऊपर चिपकाएँ। फिर उसके नीचे नया सीन जोड़ें।
विज़ुअल टैग दोहराना
पाँच से सात विज़ुअल टैग चुनें जो फ़िंगरप्रिंट का काम करें। आँखों का रंग, बालों का रंग और कट, झाइयों का एक खास पैटर्न, कोई सिग्नेचर एक्सेसरी, डिफ़ॉल्ट आउटफ़िट, कद का विवरण। इन्हें शब्दशः दोहराएँ। मॉडल सटीक दोहराव पर हैरानी की हद तक प्रतिक्रिया देते हैं: अगर आप "three small freckles on the nose bridge" कहते रहेंगे, तो आपको तीन झाइयाँ ही मिलती रहेंगी।
आउटफ़िट और कलर लॉक
आउटफ़िट आपके पास मौजूद सबसे आसान और कम मेहनत वाला पहचान संकेत है। सिग्नेचर आउटफ़िट का मतलब है कि दर्शक चेहरा पढ़ने से पहले ही सिल्हूट से जान जाते हैं कि यह वही व्यक्ति है। एक बेस आउटफ़िट लॉक करें, फिर उसके ऊपर की परतों का वर्णन करें। ज़्यादातर दर्शक यह नहीं बता पाएँगे कि चेहरा पाँच प्रतिशत बदला है या नहीं। पर अगर आपके हीरो की जैकेट सीन के बीच में रंग बदल देती है, तो वे ज़रूर नोटिस करेंगे।
एंकर टैग
उदाहरण
यह क्यों काम करता है
बाल
"auburn shoulder-length wavy hair"
बाल उन सबसे मज़बूत विज़ुअल फ़ीचर्स में से हैं जिन्हें मॉडल पकड़ता है
आँखें
"pale green almond eyes with darker outer ring"
आइरिस का खास विवरण मॉडल को एक असली आँख तय करने पर मजबूर करता है
त्वचा का निशान
"three small freckles across nose bridge"
गिनने लायक निशान मॉडल के लिए रेंडर करना आसान और जाँचना आसान है
आउटफ़िट
"olive linen blazer, cream camisole"
आउटफ़िट सिल्हूट तय करता है, जो सबसे दूर तक जाने वाला पहचान संकेत है
एक्सेसरी
"thin gold chain necklace"
एक छोटी तय चीज़ दर्शकों को याद रखने का सूत्र देती है
अपने हीरो पर कस्टम LoRA ट्रेन करना
जब रेफ़रेंस-प्लस-प्रॉम्प्ट वाला तरीका काफ़ी न हो, तब आप अपने कैरेक्टर पर एक छोटा कस्टम मॉडल ट्रेन कर सकते हैं। LoRA एक हल्का पहचान वेट है जो बेस इमेज मॉडल में जुड़ जाता है और उसे बताता है "इस खास व्यक्ति को रेंडर करें।"
LoRA कब रेफ़रेंस फ़ोटो से बेहतर है
LoRA तब जीतता है जब आपको प्रोडक्शन में सैकड़ों जनरेशन में एक कैरेक्टर चाहिए। रेफ़रेंस फ़ोटो सीन-दर-सीन काम करती हैं, पर उनमें अपलोड का समय और प्रॉम्प्ट की जटिलता लगती है। ट्रेंड किया हुआ LoRA चेहरे को सीधे मॉडल में बैठा देता है। आप बस ट्रिगर शब्द लिखते हैं और सही व्यक्ति सामने आ जाता है।
LoRA गैर-फ़ोटोग्राफ़िक कैरेक्टर के लिए भी बेहतर हैं: स्टाइलाइज़्ड इलस्ट्रेशन, एनीमे प्रोटैगोनिस्ट, मैस्कॉट डिज़ाइन। एक रेफ़रेंस फ़ोटो टेक्स्ट-टू-इमेज मॉडल को यह नहीं बता सकती कि कोई स्टाइलाइज़्ड कैरेक्टर थ्री-क्वार्टर व्यू में कैसा दिखता है। LoRA बता सकता है।
P Image Trainer वर्कफ़्लो
PicassoIA पर P Image Trainer आपको मिनटों में एक कैरेक्टर LoRA ट्रेन करने देता है। वर्कफ़्लो सीधा है:
अपने कैरेक्टर की 15 से 30 फ़ोटो इकट्ठा करें। एंगल, रोशनी और एक्सप्रेशन में विविधता रखें। वार्डरोब और बाल लगभग एक जैसे रखें।
चेहरे को कसकर क्रॉप करें। हर फ़्रेम में चेहरा कम से कम साठ प्रतिशत भरना चाहिए।
हर इमेज को छोटे टैग सेट से कैप्शन दें, जिसमें nora_v1 जैसा एक अनोखा ट्रिगर शब्द शामिल हो।
P Image Trainer पर अपलोड करें और एक छोटा ट्रेनिंग जॉब चलाएँ।
नतीजे के LoRA को अपने इमेज प्रॉम्प्ट में लगाएँ। जो भी प्रॉम्प्ट nora_v1 शामिल करेगा, वह अब ट्रेन किए गए कैरेक्टर को रेंडर करेगा।
💡 डेटासेट टिप: ट्रेनिंग सेट में विविधता कच्ची मात्रा से बेहतर है। बीस अलग-अलग फ़ोटो पचास लगभग एक जैसी फ़ोटो से बेहतर परिणाम देती हैं। रोशनी, कोण और हल्का एक्सप्रेशन बदलें, पर चेहरा वही रखें।
स्टोरी सीन के लिए मल्टी-इमेज फ़्यूज़न
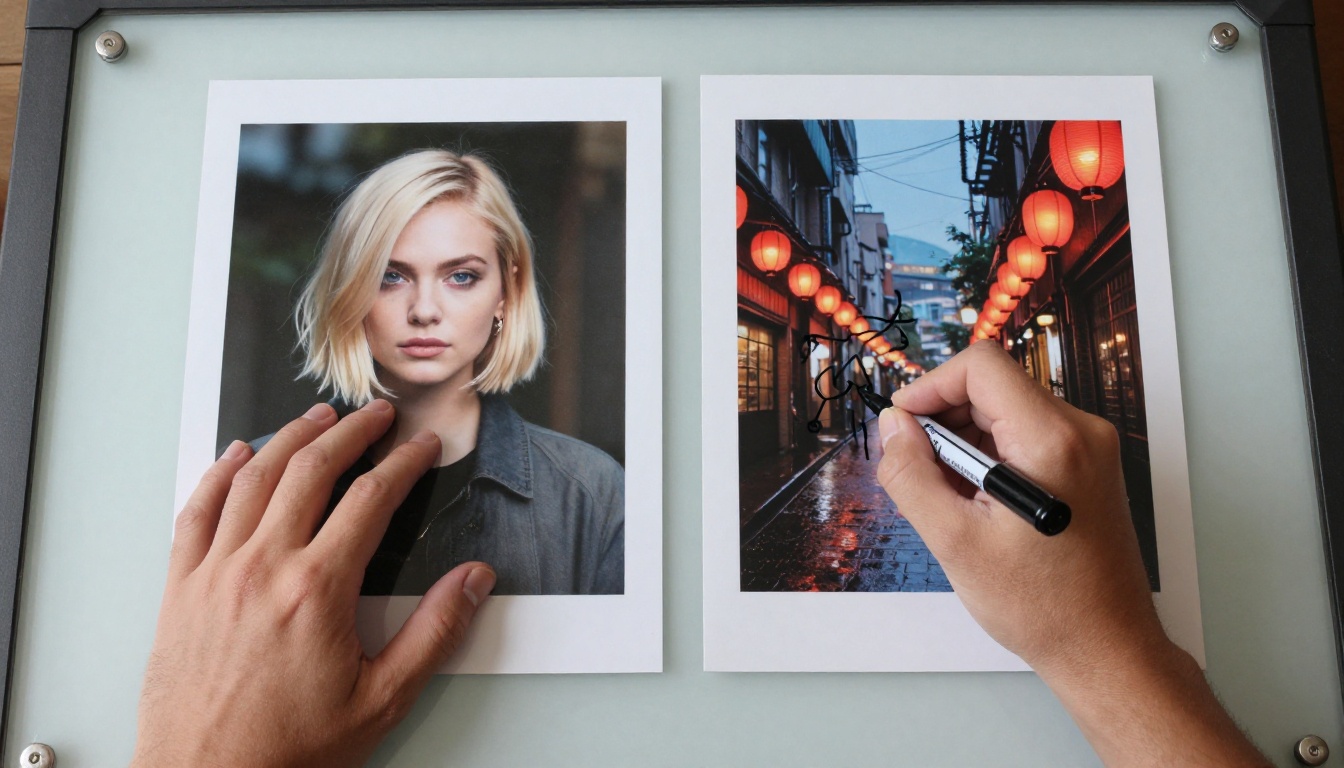
सबसे नया तरीका बिल्कुल LoRA नहीं माँगता। मल्टी-इमेज फ़्यूज़न मॉडल दो या तीन इमेज लेते हैं और उन्हें बुद्धिमानी से मिलाते हैं: बाईं ओर आपका कैरेक्टर, दाईं ओर आपका सीन, और आउटपुट दोनों को जोड़ता है।
पोज़ बदलने के लिए Flux Kontext
Flux Kontext Pro IP-Adapter फ़ेस ट्रांसफ़र का आधुनिक समकक्ष है। इसे एक पोर्ट्रेट और ऐसा प्रॉम्प्ट दें जो नया पोज़ या नया आउटफ़िट माँगे, और यह चेहरा बचाते हुए मौजूदा इमेज को एडिट कर देता है। एक अच्छे पोर्ट्रेट से बीस विश्वसनीय वेरिएशन बनाने का यह सबसे कुशल तरीका है।
नए सेटिंग के लिए Multi Image Kontext Max
बिल्कुल नए वातावरण के लिए, Multi Image Kontext Max दो रेफ़रेंस फ़ोटो लेता है और उन्हें मिला देता है। अपने कैरेक्टर का पोर्ट्रेट और एक अलग लोकेशन शॉट दें, फिर एक्शन का वर्णन करता प्रॉम्प्ट लिखें। मॉडल आपके कैरेक्टर को उस नई दुनिया में विश्वसनीय तरीके से रेंडर करता है। "मेरे कैरेक्टर को किसी भी फ़ोटो में डाल दें" की दिशा में इंडस्ट्री अब तक का सबसे करीबी यही है।
Image Editor Pro से ड्रिफ़्ट ठीक करना
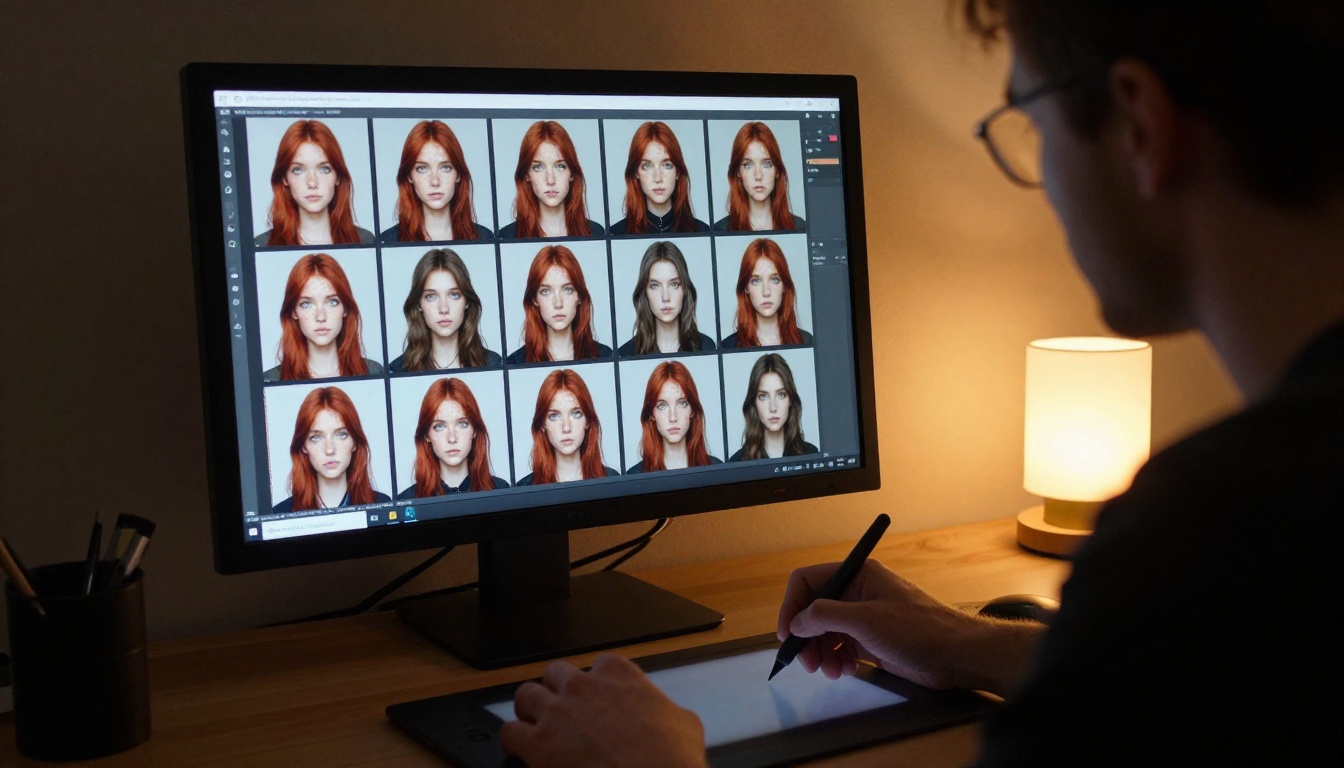
कभी-कभी पंचानवे प्रतिशत काफ़ी नहीं होता। चेहरा लगभग सही है, पर आँखें हेज़ल होनी चाहिए थीं और थोड़ी हरी हो गई हैं। झाइयों का पैटर्न तीन बिंदुओं से घटकर एक रह गया है। गालों की हड्डियाँ आधा मिलीमीटर ऊपर उठ गई हैं।
PicassoIA Image Editor Pro यहाँ सफ़ाई का चुना हुआ टूल है। यह असीमित जनरेशन चलाता है और पिनपॉइंट मास्क एडिट स्वीकार करता है, ताकि आप पूरी इमेज दोबारा रोल किए बिना आइरिस ठीक कर सकें, झाइयाँ वापस ला सकें, या जबड़े की रेखा छोटी कर सकें। इसे किसी भी कैरेक्टर पाइपलाइन का आखिरी चरण मानें: फ़्यूज़न मॉडल से रेंडर करें, फिर एडिटर से चमकाएँ।
पेशेवर काम जिस पाइपलाइन से तैयार होता है, वह कुछ ऐसी दिखती है:
प्रिंट या 4K डिलीवरी के लिए चाहें तो किसी सुपर-रेज़ोल्यूशन मॉडल से अपस्केल करें।
💡 प्रो टिप: अपना हीरो पोर्ट्रेट हाई रेज़ोल्यूशन में सेव करें। आगे के हर मॉडल आपके रेफ़रेंस को छोटा कर सकते हैं, पर कोई भी गायब डिटेल नहीं बना सकता। शुरुआत तीखी रखें।
PicassoIA पर अपना पहला एक जैसा कैरेक्टर बनाएँ
एक जैसे AI कैरेक्टर का सबसे कठिन हिस्सा अब तकनीक नहीं है। टूलिंग मौजूद है, मॉडल परिपक्व हैं, और ऊपर बताया गया वर्कफ़्लो वही है जो 2026 में फ़िल्म कॉन्सेप्ट आर्टिस्ट और इंडी कॉमिक स्टूडियो इस्तेमाल करते हैं। बाकी काम वह हिस्सा है जो सिर्फ़ आप कर सकते हैं: एक ऐसा चेहरा चुनें जो इंसान जैसा लगे, उसके एंकर टैग लिखें, और उस पर टिके रहें।
ऊपर की सूची से एक मॉडल चुनें, एक ऐसा सिंगल पोर्ट्रेट जनरेट करें जो आपको सच में पसंद हो, और उस इमेज को कैनॉनिकल मानें। फिर उसे Flux Kontext Pro या Multi Image Kontext Max से गुज़ारें ताकि वही कैरेक्टर आपकी कहानी के बाकी हिस्सों में आ सके। जब चेहरा ड्रिफ़्ट करे, तो शून्य से दोबारा रोल करने के बजाय उसे PicassoIA Image Editor Pro के अंदर ठीक करें।