Como criar personagens de IA consistentes em todas as cenas
Criar personagens de IA consistentes é a distância entre brincar com imagens e contar histórias de verdade. Este artigo mostra fluxos de trabalho com referências, âncoras de prompt e modelos de edição de imagem que mantêm o mesmo rosto, a mesma roupa e o mesmo visual em dezenas de cenas no PicassoIA.
Você consegue gerar uma imagem de IA impressionante em oito segundos. Tente gerar essa mesma pessoa de novo na manhã seguinte e você terá uma desconhecida. Outro maxilar, outras sardas, outros olhos. O rosto que antes era inesquecível agora pertence a outra pessoa.
Essa distância entre "uma imagem bonita" e "o mesmo personagem em quarenta cenas" é o que separa experimentos com arte de IA de uma narrativa de verdade. Marcas precisam de uma mascote que mantenha a forma. Desenvolvedores de jogos indie precisam de um protagonista que sobreviva a uma mudança de capítulo. Quadrinistas precisam do mesmo herói no painel três e no painel trinta.
A seguir, você encontra o fluxo de trabalho, o vocabulário de prompts e os modelos específicos do PicassoIA que tornam a consistência de personagens com IA confiável de fato.
💡 Regra prática: A identidade não se sustenta só com palavras. Ela se sustenta com uma imagem de referência, um vocabulário fixo e um editor que respeite o rosto original.
Por que a consistência de personagens é tão difícil
Modelos de difusão não armazenam personagens. Eles reconstroem as imagens do zero toda vez que você clica em gerar, amostrando de um campo com ruído de rostos possíveis. O mesmo prompt pode puxar uma pessoa ligeiramente diferente do espaço latente a cada execução.
O mesmo prompt gera um rosto novo
Mesmo quando você escreve uma descrição precisa, "mulher com sardas, cabelo castanho-avermelhado, olhos verdes, uns vinte e poucos anos, maxilar suave", você está dando ao modelo uma categoria, não uma pessoa. Existem milhões de mulheres que se encaixam nessa descrição. O amostrador escolhe uma ao acaso, guiado pela seed.
Mude a seed e a mulher muda. Empurre o prompt levemente para "sorrindo" e a estrutura óssea se altera. Acrescente "em Tóquio" e de repente o queixo fica mais marcado. Sem uma imagem âncora, você está trocando de atriz a cada renderização.
Modelos de difusão variam de propósito
Essa variação é um recurso, não um defeito. O objetivo da difusão é justamente a variedade. Os modelos são treinados para maximizar a criatividade entre prompts, o que significa que pequenas diferenças na redação ou na seed produzem grandes diferenças no resultado. Isso é ótimo para painéis de inspiração e ruim para um personagem recorrente.
A solução é injetar um sinal visual fixo que sobreponha a variação natural do modelo. Esse sinal pode vir de três lugares: uma imagem de referência, um LoRA treinado ou um modelo de edição que preserve a identidade e altere apenas a cena ao redor do rosto.
A abordagem com foto de referência
O método mais simples funciona em menos de um minuto. Gere um único retrato do seu personagem que você ame e depois o use como referência na geração seguinte. Quase todos os modelos de imagem modernos do PicassoIA aceitam uma imagem de referência, e essa única foto faz noventa por cento do trabalho pesado.
Uma imagem principal ou folhas com vários ângulos
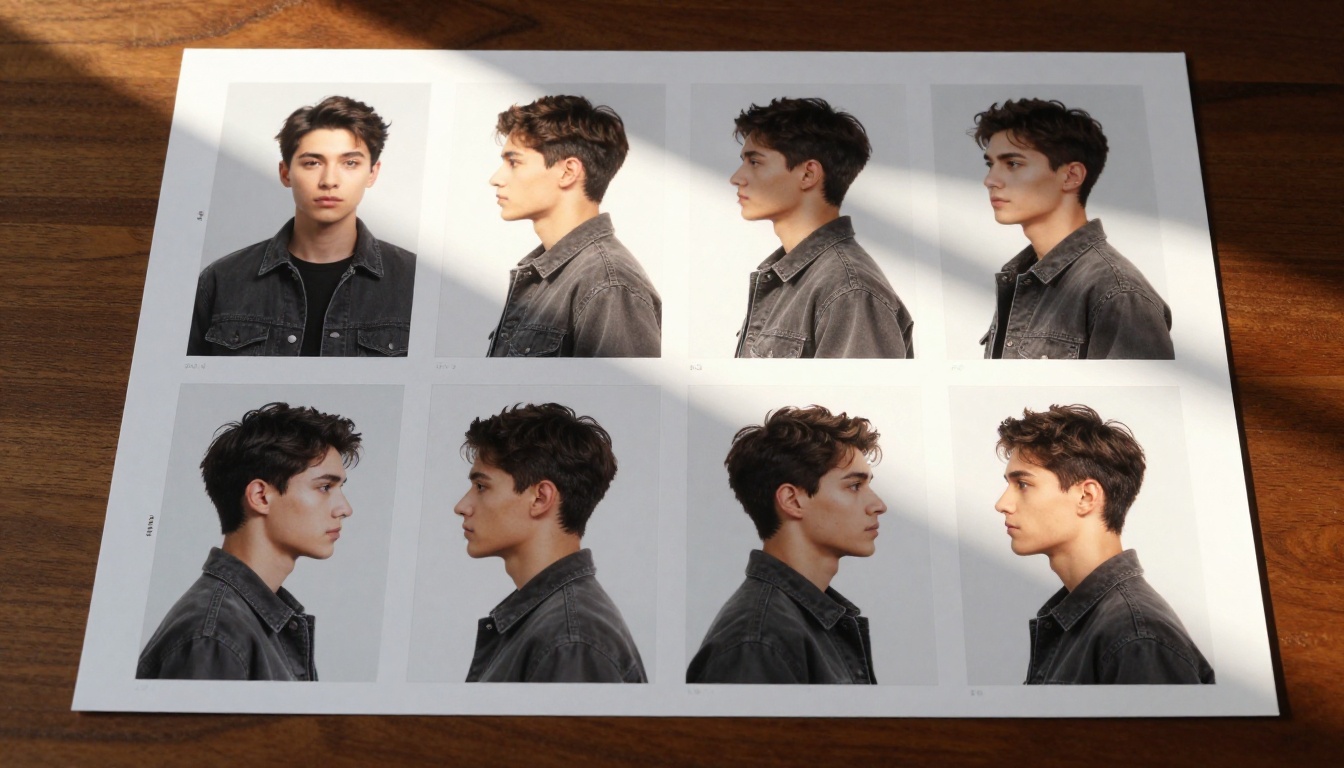
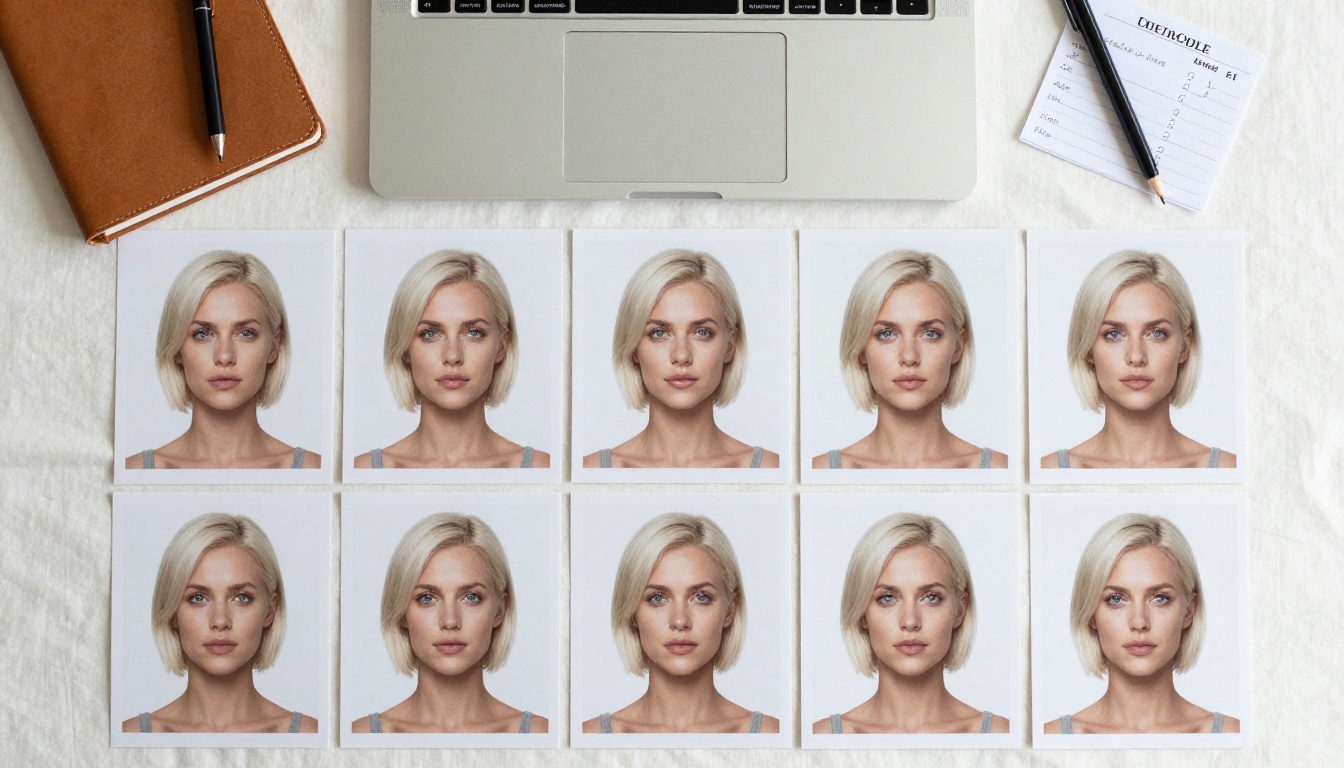
Alguns fluxos pedem um único retrato de frente. Isso basta para trabalhos de texto para imagem estilizados, com um modelo de transferência de identidade forte. Para produções mais exigentes, monte uma folha de personagem de verdade: frente, três quartos à esquerda, perfil, leve vista de cima, leve contra-plongée. Cinco ângulos dizem muito mais sobre um rosto do que um só.
Caso de uso
Configuração de referência
Por quê
Retratos editoriais
1 imagem principal
Modelos de transferência de identidade como o Gen4 Image mantêm o rosto a partir de uma única foto em alta resolução
Quadrinhos e jogos
Folha com 5 a 9 ângulos
O contexto de vários ângulos ajuda o modelo a renderizar a mesma pessoa em poses que ele nunca viu
Treinamento de LoRA
15 a 30 fotos
Mais dados, mais variedade de iluminação, recuperação de identidade mais precisa
O que capturar na referência
Sua referência deve isolar o rosto de qualquer ruído visual que não pertença ao personagem. Iluminação limpa, fundo neutro, sem maquiagem pesada, sem expressão extrema. Boca fechada tende a renderizar com mais confiabilidade do que um sorriso largo. Os olhos devem estar abertos e olhando próximo à câmera, não em um ângulo acentuado.
Um retrato próximo e nítido dá ao modelo o detalhe de alta frequência que define um rosto: a curva da linha dos cílios inferiores, a assimetria das narinas, a distância exata entre olho e sobrancelha. Esses pequenos traços são o que faz um rosto parecer uma pessoa específica e não um tipo genérico.
Modelos que realmente mantêm um rosto
Nem todo modelo de imagem foi feito para trabalhar com identidade. Alguns são impressionantes na composição, mas tratam o rosto como decoração. Os modelos abaixo são ajustados para a consistência de personagens, e todos estão disponíveis no PicassoIA.
Ideogram Character
O Ideogram Character é a interpretação mais literal deste artigo. Ele foi criado para manter um personagem consistente em novas cenas a partir de uma única foto de referência. Envie o rosto, descreva o novo cenário, e ele renderiza a mesma pessoa nesse cenário. Lida bem com trocas de roupa e respeita o tom de pele, o que é raro em modelos de texto para imagem.
MiniMax Image 01
O MiniMax Image 01 é apresentado por seus criadores como um modelo de personagem consistente, e o desempenho confirma isso. Funciona bem com prompts mais soltos e perdoa quando a foto de referência não está perfeitamente iluminada. Bom para iterações rápidas quando você não quer ficar vigiando o prompt.
Nano Banana Pro e Seedream 4
O Nano Banana Pro do Google e seu irmão Nano Banana 2 estão entre os modelos mais fortes para fixar personagens em 2027, sem alarde. O modo fuse aceita um retrato mais um novo cenário e os funde com o rosto intacto em 4K.
O Seedream 4 da ByteDance é a outra opção em 4K que vale manter por perto. Ele mantém a identidade com firmeza quando você passa uma referência e tende a renderizar a textura de tecidos e cabelos de forma mais convincente do que a maioria dos concorrentes.
Gen4 Image e Flux Kontext
O Gen4 Image da Runway transforma explicitamente fotos de referência em qualquer cena e é o mais próximo que existe dos antigos fluxos de ControlNet, numa interface moderna e limpa. O Flux Kontext Pro pega a imagem de um personagem de origem e permite descrever edições na cena ao redor dele, protegendo o rosto. Os dois são excelentes quando você quer colocar um personagem já estabelecido em um momento da história.
Âncoras de prompt que fixam a identidade
Uma boa imagem de referência leva você oitenta por cento do caminho. Os últimos vinte por cento vêm de como você escreve o prompt. Prompts que fixam a identidade repetem as mesmas cinco ou seis tags visuais a cada vez, como uma classe CSS para o seu personagem.
Dando nome ao seu personagem
Dê ao seu personagem um nome interno fixo e descreva-o sempre do mesmo jeito. Mesmo que o modelo não "lembre" o nome entre as execuções, essa consistência no vocabulário do prompt impede que a descrição mude sem querer.
Subject anchor: "Nora, 28, auburn shoulder-length wavy hair,
pale green almond eyes, three small freckles across the nose
bridge, slim oval face, olive linen blazer over cream silk
camisole."
Cole essa âncora no início de todo prompt desse personagem. Depois, adicione a nova cena logo abaixo.
Repetindo tags visuais
Escolha de cinco a sete tags visuais que funcionem como impressões digitais. Cor dos olhos, cor e corte do cabelo, um padrão de sardas característico, um acessório marcante, uma roupa padrão, um descritor de altura. Repita-as exatamente como estão. Os modelos respondem surpreendentemente bem à repetição exata: se você continuar dizendo "três pequenas sardas na ponte do nariz", continuará recebendo três sardas.
Travas de roupa e cor
A roupa é o sinal de identidade mais simples de controlar que você tem. Uma roupa característica faz com que a silhueta diga ao público que é a mesma pessoa, até antes de ele ler o rosto. Trave uma roupa base e depois descreva as camadas por cima dela. A maioria dos espectadores não percebe se um rosto mudou cinco por cento. Eles certamente vão notar se a jaqueta do seu herói mudou de cor no meio da cena.
Tag de âncora
Exemplo
Por que funciona
Cabelo
"cabelo castanho-avermelhado ondulado na altura dos ombros"
O cabelo é uma das características visuais mais fortes em que o modelo se apoia
Olhos
"olhos verdes-claros amendoados com anel externo mais escuro"
O detalhe específico da íris obriga o modelo a se comprometer com um olho real
Marca na pele
"três pequenas sardas na ponte do nariz"
Um marcador contável é fácil de renderizar e fácil de verificar
Roupa
"blazer de linho oliva, camisola creme"
A roupa define a silhueta, a pista de identidade de maior alcance
Acessório
"colar fino de corrente dourada"
Um item pequeno e fixo dá ao público um ponto de memória
Treinando um LoRA personalizado para o seu herói
Quando o fluxo com referência mais prompt não for suficiente, você pode treinar um modelo pequeno com o seu personagem. Um LoRA é um peso leve de identidade que se conecta a um modelo base de imagem e diz a ele "renderize esta pessoa específica".
Quando um LoRA vence a foto de referência
Um LoRA vence quando você precisa de um personagem em centenas de gerações na produção. Fotos de referência funcionam cena a cena, mas custam tempo de upload e complexidade de prompt. Um LoRA treinado incorpora o rosto ao próprio modelo. Você só digita a palavra-gatilho e a pessoa certa aparece.
Os LoRAs também são superiores para personagens não fotográficos: ilustrações estilizadas, protagonistas de anime, designs de mascotes. Uma foto de referência não consegue dizer a um modelo de texto para imagem como um personagem estilizado fica em três quartos. Um LoRA consegue.
Fluxo de trabalho com o P Image Trainer
O P Image Trainer no PicassoIA permite treinar um LoRA de personagem em minutos. O fluxo é simples:
Reúna de 15 a 30 fotos do seu personagem. Varie os ângulos, a iluminação e as expressões. Mantenha o figurino e o cabelo mais ou menos iguais.
Recorte bem de perto. O rosto deve ocupar pelo menos sessenta por cento de cada quadro.
Legende cada imagem com um conjunto curto de tags, incluindo uma palavra-gatilho única como nora_v1.
Envie tudo para o P Image Trainer e execute um treinamento curto.
Conecte o LoRA resultante aos seus prompts de imagem. Todo prompt que incluir nora_v1 passará a renderizar o personagem treinado.
💡 Dica de conjunto de dados: Diversidade no conjunto de treinamento vale mais do que quantidade bruta. Vinte fotos variadas superam cinquenta quase idênticas. Varie a iluminação, o ângulo e a expressão leve, mantendo o rosto o mesmo.
Fusão de múltiplas imagens para cenas de história
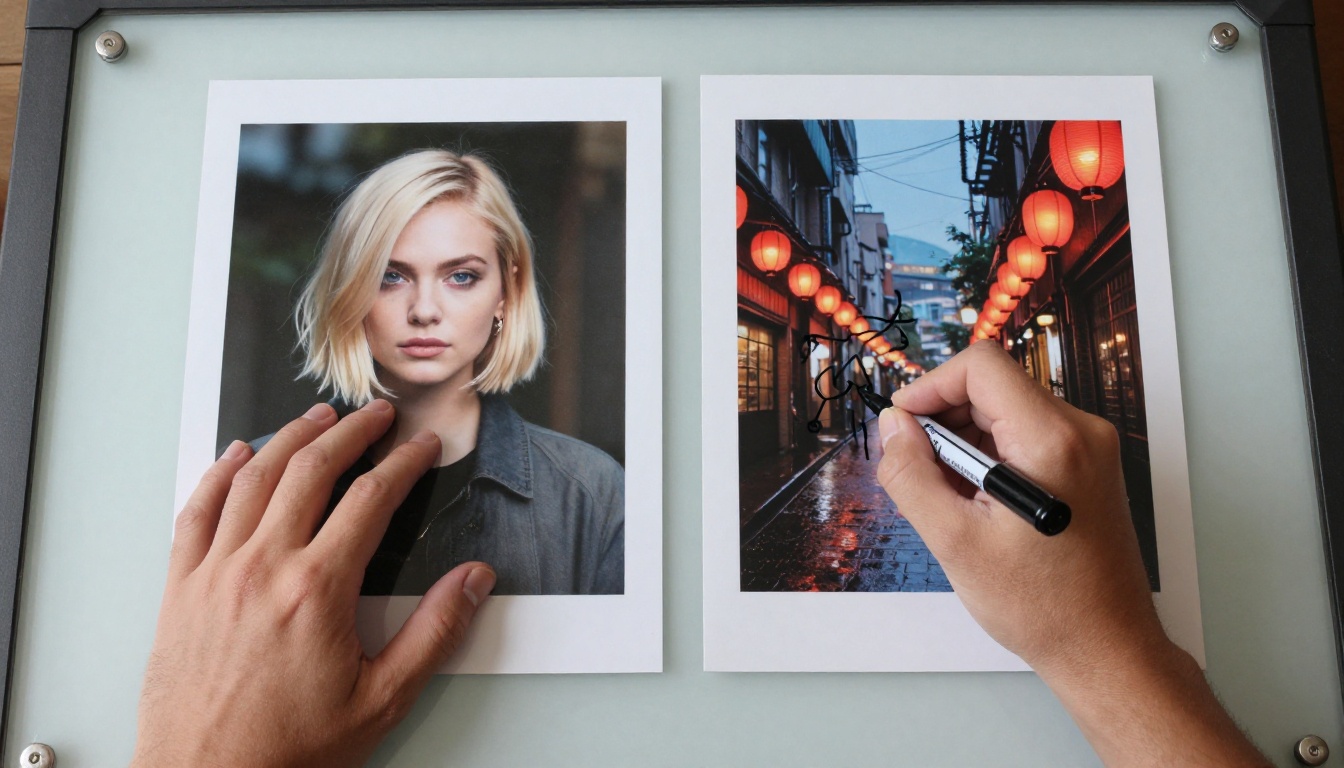
O método mais novo nem precisa de um LoRA. Os modelos de fusão de múltiplas imagens aceitam duas ou três imagens e as combinam com inteligência: seu personagem à esquerda, sua cena à direita, e o resultado une os dois.
Flux Kontext para mudanças de pose
O Flux Kontext Pro é o equivalente moderno da transferência de rosto por IP-Adapter. Dê a ele um retrato e um prompt pedindo uma nova pose ou uma nova roupa, e ele edita a imagem existente preservando o rosto. É a forma mais eficiente de pegar um bom retrato e gerar vinte variações críveis.
Multi Image Kontext Max para novos cenários
Para ambientes totalmente novos, o Multi Image Kontext Max aceita duas fotos de referência e as combina. Envie o retrato do seu personagem mais uma foto de local separada e depois escreva um prompt descrevendo a ação. O modelo renderiza seu personagem de forma crível dentro desse novo mundo. Esta é a coisa mais próxima de "colocar meu personagem em qualquer foto" que a indústria já alcançou.
Corrigindo a variação com o Image Editor Pro
Às vezes, noventa e cinco por cento não bastam. O rosto está quase certo, mas os olhos ficaram levemente verdes quando deveriam ser cor de avelã. O padrão de sardas caiu de três pintas para uma. As maçãs do rosto subiram meio milímetro.
O PicassoIA Image Editor Pro é a ferramenta de limpeza ideal nesse caso. Ele roda gerações ilimitadas e aceita edições com máscara precisa, então você pode corrigir a íris, restaurar as sardas ou ajustar uma linha da mandíbula sem refazer a imagem inteira. Trate-o como a etapa final de qualquer pipeline de personagem: renderize com um modelo de fusão e depois faça o acabamento no editor.
O pipeline que entrega trabalhos profissionais fica assim:
Opcionalmente, faça upscaling com um modelo de super-resolução para impressão ou entrega em 4K.
💡 Dica profissional: Salve seu retrato principal em alta resolução. Todo modelo posterior pode reduzir sua referência, mas nenhum consegue inventar detalhe que não existe. Comece nítido.
Crie seu primeiro personagem consistente no PicassoIA
A parte mais difícil de personagens consistentes com IA já não é a tecnologia. As ferramentas estão aqui, os modelos estão maduros, e o fluxo de trabalho acima é o mesmo usado por artistas conceituais de cinema e estúdios indie de quadrinhos em 2026. O trabalho que resta é o que só você pode fazer: escolher um rosto que pareça uma pessoa, anotar suas tags de âncora e se comprometer.
Escolha um modelo da lista acima, gere um único retrato que você realmente ame e trate essa imagem como canônica. Depois, passe-a pelo Flux Kontext Pro ou pelo Multi Image Kontext Max para colocar esse mesmo personagem no resto da sua história. Quando o rosto variar, corrija-o no PicassoIA Image Editor Pro em vez de refazer tudo do zero.