Grabaste una locución perfecta. Tu video ya está rodado. Pero los movimientos de la boca no coinciden, el idioma no es el adecuado para tu público o simplemente necesitas que el audio y los labios encajen sin reservar otra sesión de grabación. Eso es exactamente lo que resuelve el lipsync con IA en 2027, y lo hace con tanta precisión que la mayoría de los espectadores no puede distinguir entre una grabación original y una versión con lipsync.
El lipsync con IA ha cruzado un umbral real este año. El resultado de modelos como Omni Human 1.5, Lipsync 2 Pro y Kling Lip Sync ya no es "bastante bueno". Es preciso a nivel de fonema, está alineado en el tiempo hasta el milisegundo y es capaz de manejar desde un clip corto para redes sociales de 10 segundos hasta un video corporativo doblado de 60 minutos. Este artículo explica cómo funciona todo, qué modelos merecen tu tiempo y cómo ejecutar el proceso, de principio a fin, hasta obtener el archivo final.
Qué hace realmente la sincronización labial con IA
La mayoría de la gente supone que el lipsync consiste solo en cambiar una pista de audio por otra. El cambio de audio es la parte sencilla. Lo que hace realmente el lipsync con IA es modificar la geometría facial del video para que la boca, las comisuras de los labios, la mandíbula y los músculos de las mejillas se muevan en sintonía con la nueva señal de audio. La interpretación original, la expresión y la personalidad se mantienen intactas. Solo cambia la zona de la boca.
El motor de sincronización detrás de los resultados
Los modelos de lipsync actuales se entrenan con cientos de miles de horas de video anotado, creando un mapa preciso entre secuencias de fonemas y deformaciones de los músculos faciales. Cuando subes un video y un archivo de audio, el modelo ejecuta un proceso de varias etapas:
- La detección facial se ejecuta en cada fotograma, identifica la región del rostro y extrae una malla
- El audio se analiza a nivel de fonema, y cada sonido del habla recibe una marca de tiempo
- Se genera una nueva geometría de la boca para cada fotograma según el fonema correspondiente
- La geometría generada se recompone sobre el rostro original mediante inpainting, preservando la textura de la piel, el color y la iluminación
El resultado es una persona que parece decir exactamente lo que suena en el audio, en cualquier idioma, a cualquier velocidad, con su identidad original totalmente preservada.
Por qué el resultado de 2026 parece real
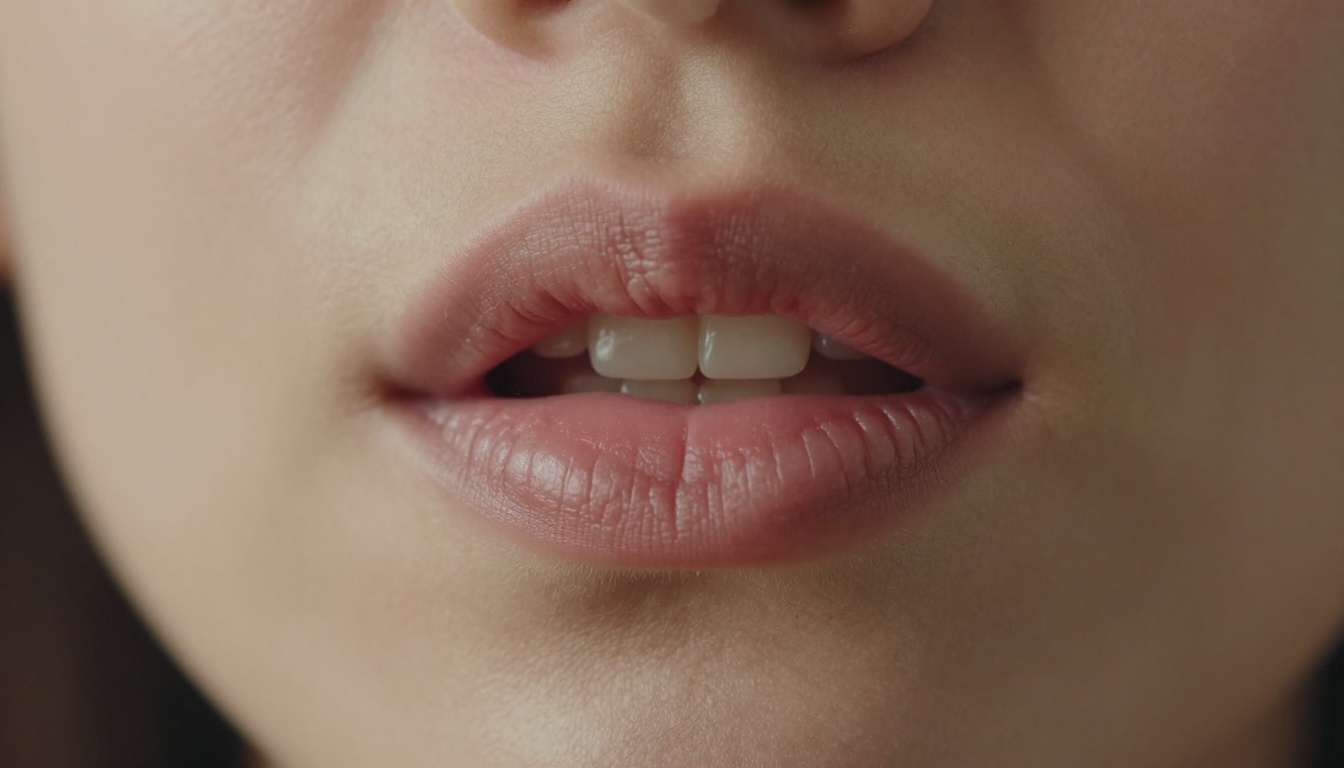
Hace tres años, el lipsync con IA se detectaba. Los bordes de los labios se difuminaban ligeramente, los dientes parecían poco realistas y las transiciones de fonemas eran entrecortadas al hablar rápido. Hoy, la síntesis basada en difusión ha reemplazado a las antiguas arquitecturas GAN. Los modelos ahora operan a nivel de inpainting por fotograma, volviendo a renderizar solo la zona de la boca y conservando todos los demás elementos, incluidos los poros de la piel, la barba incipiente, la textura del labial y los dientes.
💡 La mejora más perceptible de 2026 es el renderizado de los dientes. Los modelos anteriores tenían problemas con el interior de la boca en fonemas de boca muy abierta como "a" y "ay". Los modelos actuales reconstruyen la geometría individual de cada diente, acorde con la estructura dental de la persona original, y eliminan el aspecto de plástico que antes delataba el lipsync con IA.
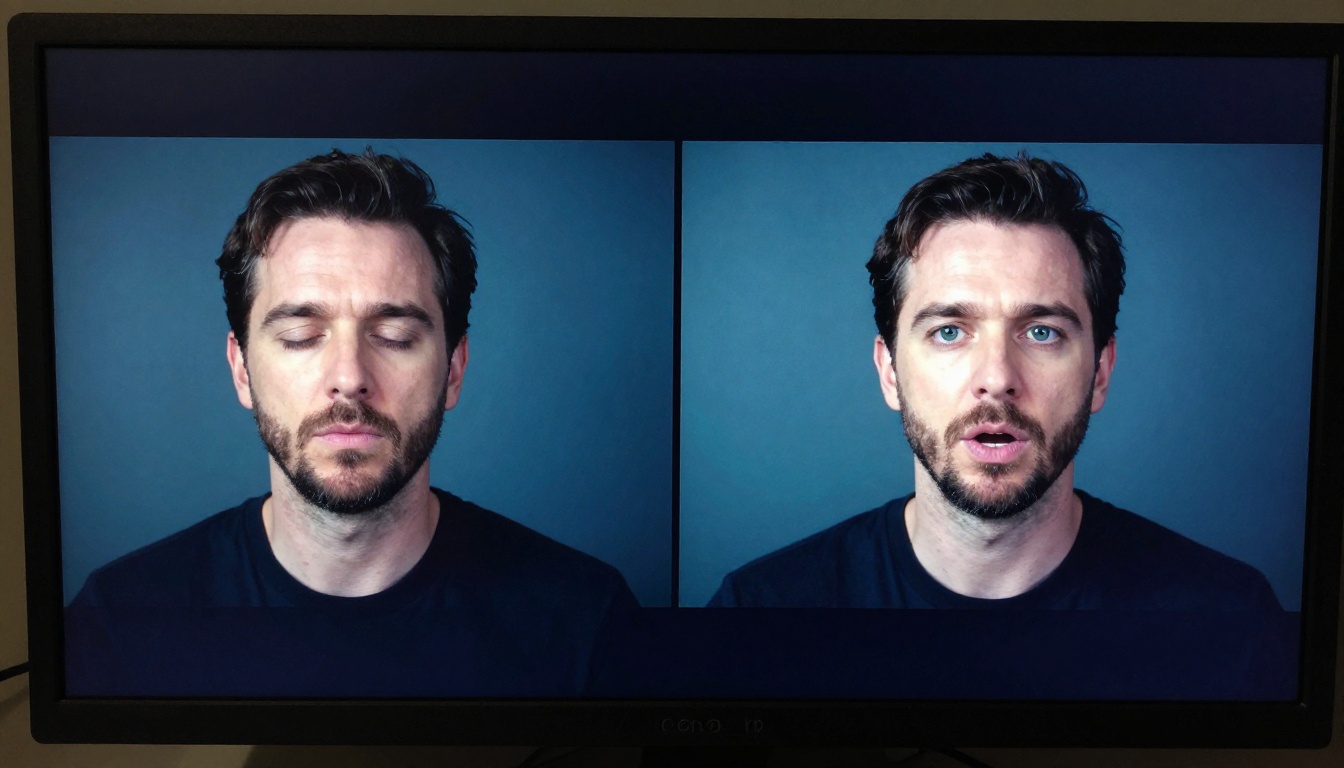
Los mejores modelos de lipsync con IA ahora mismo
Hoy hay más de una docena de modelos de lipsync con IA de calidad profesional disponibles en PicassoIA. Estos son los que producen de forma constante resultados de calidad de emisión en distintos casos de uso:
Lipsync 2 Pro: el estándar de precisión
Lipsync 2 Pro, de Sync Labs, es el benchmark actual en precisión dentro de la categoría. Gestiona la alineación audiovisual a nivel de subfotograma, lo que significa que puedes darle audio con cadencia irregular, acentos regionales, sílabas superpuestas o habla rápida y seguir obteniendo un resultado limpio, sin deriva en los movimientos de la boca.
Es el modelo ideal para:
- Localización de videos corporativos para mercados internacionales
- Posproducción documental cuando el ADR se grabó por separado
- Contenido de cursos en línea que necesita una narración actualizada sin volver a grabar el material original de la lección
La contrapartida es el tiempo de procesamiento. Lipsync 2 Pro no es la opción más rápida de la categoría. Cuando necesites un borrador en 30 segundos, usa Lipsync Speed en su lugar. Cuando el entregable sea final, usa 2 Pro.
Su hermano, Lipsync 2, se sitúa a medio camino: más rápido que la versión Pro, con calidad muy buena, lo que lo convierte en la mejor opción predeterminada para iterar un proyecto antes de pasar a la pasada de precisión.
Omni Human 1.5: de una sola foto a video completo
Omni Human 1.5, de ByteDance, hace algo totalmente distinto a los demás modelos. No necesitas ningún material de video existente. Sube una sola foto, aporta un archivo de audio y el modelo genera desde cero un video completo de cabeza parlante. La geometría facial, la dinámica de las expresiones, el movimiento natural de la cabeza y los parpadeos se sintetizan a partir de la imagen estática.
Esto lo hace excepcionalmente útil para:
- Crear videos de portavoces sin cámara ni equipo de rodaje
- Crear contenido de avatar a partir de un solo retrato
- Contenido para redes sociales en el que quieras una personalidad constante en pantalla sin repetir sesiones de grabación
Su predecesor, Omni Human, ya era impresionante. La actualización 1.5 mejoró notablemente la precisión de las microexpresiones y el ritmo de los parpadeos, que eran las señales más detectables de video sintético en la versión anterior. Los intervalos naturales de parpadeo y los ligeros giros de cabeza en mitad de una frase son lo que hace que los resultados de 1.5 parezcan genuinamente humanos.
💡 Para obtener mejores resultados con Omni Human 1.5, usa como imagen de origen un retrato de alta resolución, con iluminación uniforme y difusa y una expresión neutra. El modelo usa la geometría facial inicial como base, así que una entrada limpia produce un resultado mucho más limpio.
Kling Lip Sync: rápido y listo para redes sociales
Kling Lip Sync está optimizado para la velocidad en contenido corto. Procesa clips de menos de 60 segundos con gran rapidez, lo que lo convierte en la herramienta adecuada para Instagram Reels, TikToks y YouTube Shorts, donde el tiempo de entrega importa tanto como la calidad. La precisión de la sincronización es muy buena para el habla rápida y los estilos de locución informales, y maneja de forma nativa los formatos de video verticales, algo que sigue siendo una limitación en varios otros modelos.
Cómo crear un video de lipsync en 5 pasos
El flujo de trabajo básico es el mismo en todos los modelos. Las entradas son siempre las mismas: un video (o una foto) y un archivo de audio. La salida es siempre un video con los movimientos de la boca sincronizados con el nuevo audio. Así es el proceso completo.
Paso 1: prepara tu video de origen
El video de origen necesita una vista clara y sin obstáculos del rostro en la mayoría de los fotogramas. El modelo necesita detectar y seguir la zona de la boca durante todo el clip. Estos son los problemas habituales que causan fallos de sincronización o de seguimiento facial:
- Manos que tapan la boca o la mitad inferior de la cara
- Perfiles extremos de más de 60 grados desde el centro
- Resolución baja, por debajo de 480p, o grano de película muy marcado
- Varios rostros en el encuadre sin un sujeto principal claro
- Cortes de cámara rápidos con cambios de posición del rostro
Si tu material tiene alguno de estos problemas, recorta o encuadra las secciones en las que el rostro esté limpio y visible. La mayoría de los modelos manejan bien variaciones moderadas de ángulo, de hasta unos 45 grados desde el frente.
Paso 2: graba o sube el audio
Tu archivo de audio debe ser:
- Limpio: sin música de fondo, reverberación ni ruido ambiente bajo la voz
- Normalizado: nivel de volumen uniforme de principio a fin, sin picos repentinos
- Formato estándar: WAV o MP3 de alta calidad (ambos los aceptan todos los modelos)
💡 Si generas la voz con un modelo de texto a voz, PicassoIA tiene un conjunto completo de Text to Speech. Genera primero la voz, descarga el archivo de audio y luego introdúcelo en el modelo de lipsync. Este flujo de dos pasos te da control total sobre la calidad de la voz antes de la sincronización.
Paso 3: elige el modelo adecuado
Ajusta el modelo a tu necesidad real:
Paso 4: ejecuta la sincronización
Sube tu video y tu audio al modelo seleccionado. La mayoría de los modelos ofrecen:
- Una vista previa de detección facial que confirma la zona de seguimiento del rostro antes de empezar a procesar
- Un control de desfase de sincronización para desplazar el audio unos milisegundos si la grabación original tiene un ligero retraso al inicio
- Controles de resolución y formato de salida para el archivo final
En grabaciones estándar con el rostro bien visible, la configuración predeterminada produce un resultado limpio sin ningún ajuste manual.
Paso 5: revisa y perfecciona
Cuando termine el render, mira el resultado a velocidad 1x. Fíjate especialmente en:
- Fonemas oclusivos ("p", "b", "m"), donde los labios deben cerrarse por completo antes de abrirse
- Pausas silenciosas en las que la boca debe volver a una posición de reposo natural
- Risas o cambios emocionales a mitad de frase, donde la expresión y la sincronización tienen que coincidir
Si alguno de estos puntos no encaja del todo, vuelve a ejecutar con Lipsync Precision como alternativa. Gestiona mejor la asignación de fonemas complejos en los límites de acento que la mayoría de las opciones de nivel de velocidad.
Convierte cualquier foto en un avatar parlante
El caso de uso de lipsync con mayor valor comercial en 2027 no consiste en sincronizar material existente. Consiste en crear videos que nunca existieron. Aportas una sola foto y un archivo de audio, y el modelo genera un video completo de cabeza parlante sin necesidad de material de origen.
Omni Human 1.5 en la práctica
Omni Human 1.5 no se limita a animar la boca a partir de una foto. Genera:
- Micromovimientos naturales de la cabeza: asentimientos sutiles y leves inclinaciones laterales a mitad de frase
- Parpadeos realistas a intervalos estadísticamente naturales durante todo el clip
- Movimiento de hombros y de la parte superior del cuerpo acorde con el ritmo respiratorio que sugiere el audio
El resultado no es una cabeza estática con los labios moviéndose. Es una persona que parece estar hablando de verdad. Para los creadores que necesitan una presencia constante en pantalla sin aparecer ellos mismos frente a la cámara, esto ha pasado de lo experimental a estar listo para producción.
Fabric 1.0 y P Video Avatar
Fabric 1.0, de Veed, ofrece un flujo de trabajo simplificado para animar fotos. Está diseñado para ser fácil de usar, con controles sencillos, y funciona especialmente bien en entornos estáticos como bots de atención al cliente, explicadores de productos y presentadores de e-learning. Procesa más rápido que Omni Human 1.5 a cambio de algo menos de expresividad en el movimiento de la cabeza generado.
P Video Avatar adopta un enfoque algo distinto y se centra en mantener una identidad facial constante en salidas más largas. Cuando creas un personaje recurrente o un portavoz de marca que aparecerá en muchos videos, la coherencia de identidad de P Video Avatar lo convierte, con el tiempo, en la opción más práctica.
Doblaje frente a lipsync: cuál es la diferencia
Estos dos términos se usan a menudo como sinónimos, pero describen flujos de trabajo distintos con resultados diferentes. Entender la diferencia te ahorra tiempo a la hora de elegir la herramienta adecuada.
Cuándo necesitas doblaje
El doblaje sustituye la pista de audio original por otra nueva en un idioma distinto, con otra voz o con otro estilo, y después ajusta los movimientos de la boca del video para que coincidan. Los estudios de cine llevan décadas haciéndolo a mano. Hoy la IA ejecuta todo el proceso de forma automática.
Usa el doblaje cuando:
- Traduces el contenido a otro idioma para un nuevo público
- Reemplazas una voz específica manteniendo intacto el video original
- El audio original tiene problemas de calidad y necesita un reemplazo limpio
Video Translate, de HeyGen, es el modelo destacado para este flujo de trabajo. Admite más de 150 idiomas y combina tres pasos automatizados: transcripción del guion, generación de voz con IA en el idioma de destino que se ajusta al estilo vocal del hablante original y lipsync aplicado al video resultante. Todo el proceso se ejecuta desde una sola subida.
Cuándo el lipsync puro es la mejor opción
El lipsync sin traducción es lo que necesitas cuando:
- Tienes el idioma correcto, pero el audio se grabó por separado del video
- Quieres volver a poner voz al mismo video con otro hablante o con una grabación más limpia
- Creas contenido a partir de una foto con audio generado por IA y sin material de origen
React 1, de Sync Labs, aporta aquí una capa importante: sincroniza no solo el movimiento de los labios, sino también las microexpresiones faciales con el contenido emocional del audio. Si el audio suena entusiasmado, el rostro lo refleja. Si es tranquilo, la expresión lo sigue. Esto lo hace especialmente sólido en contenidos en los que la interpretación emocional debe coincidir con la nueva pista de audio, y no solo con el ritmo.
Traducir videos con lipsync de IA
La traducción de video es donde el lipsync con IA ofrece el retorno comercial más inmediato en 2027. Un video producido en un idioma puede llegar hoy a una audiencia global en 150 idiomas sin volver a grabar, sin contratar a un locutor para cada mercado y sin el problema del valle inquietante que hacía inutilizable en contextos profesionales el doblaje con IA de antes.
Video Translate de HeyGen
Video Translate gestiona el proceso completo de forma automática. Subes un video en cualquier idioma, eliges el idioma de destino, y el modelo hace lo siguiente:
- Transcribe el habla original a texto
- Traduce el guion con un modelo de lenguaje optimizado para una salida hablada natural
- Sintetiza una voz en el idioma de destino que coincide con el ritmo, el tono y la energía con que habla el hablante original
- Aplica el lipsync al video para que los movimientos de la boca coincidan con el nuevo audio
La adaptación de la voz es una de las funciones más infravaloradas de este modelo. No genera una voz sintética genérica en el idioma de destino. Intenta conservar las características vocales del hablante original, incluidas la velocidad de la locución, las pausas naturales y el registro emocional. El resultado suena como si el hablante original dominara el nuevo idioma, no como un robot de texto a voz.
💡 Al doblar contenido para redes sociales, mantén los clips por debajo de 90 segundos para lograr la mejor precisión de sincronización en todos los modelos. Los videos más largos pueden presentar un ligero desfase temporal en la segunda mitad, sobre todo cuando el audio original tiene cambios rápidos de tema o cortes de escena.
React 1 para un doblaje con coherencia emocional
React 1 añade alineación de expresión al flujo de trabajo de doblaje. Cuando una traducción cambia el ritmo o el énfasis del habla original, React 1 hace que la capa de microexpresiones se adapte al contenido emocional del nuevo audio, en lugar de reflejar la toma original. En el contenido de marketing, donde el tono y la energía deben parecer propios de cada mercado, esta capa de sincronización de expresiones es muy importante.
Velocidad frente a precisión
El punto de decisión más práctico al usar lipsync con IA es elegir cuánta calidad de salida necesita realmente cada pieza de contenido. Sobredimensionar el modelo desperdicia tiempo de procesamiento. Quedarse corto con él arriesga artefactos visibles en los entregables.
El nivel de velocidad
Para el contenido en el que el tiempo de entrega importa más que la perfección:
- Lipsync Speed: tiempos de render medidos en segundos. La calidad de sincronización es muy buena en clips de menos de 30 segundos y adecuada en clips de hasta 90 segundos.
- Kling Lip Sync: el mejor de su categoría para video vertical y formato corto. Procesamiento rápido con un resultado de aspecto natural para estilos de habla informales.
- Lipsync de Pixverse: muy bueno en contenido animado y estilizado, no solo en material de imagen real. Si tu video de origen no es fotorrealista, este modelo gestiona la coherencia del render mejor que los modelos estrictamente de imagen real.
El nivel de precisión
Para el contenido en el que un solo artefacto visible dañaría la credibilidad o la confianza:
- Lipsync 2 Pro: precisión a nivel de subfotograma, gestiona limpiamente todos los tipos de fonemas y procesa videos más largos sin desfase temporal.
- Lipsync Precision: creado específicamente para audio con mucho acento y para la asignación compleja de fonemas a visemas. Destaca en audio de hablantes no nativos, cuando los sonidos vocálicos difieren mucho de los datos de entrenamiento estándar.
- Omni Human 1.5: cuando la precisión incluye una verosimilitud facial completa, y no solo el movimiento aislado de los labios.
La regla práctica: usa el nivel de velocidad para borradores, iteraciones y contenido para redes sociales. Usa el nivel de precisión para todo lo que vaya a una entrega final, a publicidad pagada o a emisión.
Qué puedes crear ahora mismo
Las aplicaciones creativas y comerciales del lipsync con IA en 2027 ya no son teóricas. Esto es lo que se está creando de verdad:
- Tutores de idiomas que generan videos de pronunciación con hablantes nativos a partir de fotos de instructores reales, sin reservar tiempo de estudio
- Equipos de marketing que localizan campañas publicitarias en 10 o más idiomas a partir de una sola grabación maestra en una tarde
- Podcasters que crean versiones en video de programas solo de audio animando una foto de cabeza con el audio de todo el episodio
- Plataformas de e-learning que actualizan cursos grabados hace años con una narración corregida, sin volver a poner a los instructores frente a la cámara
- Cineastas independientes que doblan cortometrajes a varios idiomas para presentarlos a festivales internacionales a un costo casi nulo
La barrera para cualquiera de estos flujos de trabajo es ahora una pestaña del navegador y la subida de un archivo. El cálculo se ejecuta en la nube y entrega el resultado en minutos. Sin GPU local, sin software instalado y sin configuración técnica.
Todos los modelos de este artículo están disponibles en PicassoIA, cubriendo toda la gama de flujos de trabajo de lipsync: animación de fotos, doblaje de video, traducción multilingüe, creación de avatares parlantes y actuaciones sincronizadas con la expresión. La colección completa está disponible en picassoia.com/en/all-models.
Empieza aquí según tu situación:
- Tienes material existente y quieres volver a ponerle voz: Lipsync 2 Pro
- Tienes una foto y quieres un video parlante: Omni Human 1.5
- Necesitas un video en otro idioma: Video Translate
- Procesas clips cortos para redes sociales con rapidez: Kling Lip Sync
- Necesitas una sincronización expresiva del rostro, no solo de los labios: React 1
Sube tus archivos, elige el modelo que encaje con tu flujo de trabajo y consulta el resultado en menos de cinco minutos. La tecnología está lista. Solo falta ponerla en marcha.


