Você gravou uma narração perfeita. Seu vídeo já está filmado. Mas os movimentos da boca não batem, o idioma não é o certo para seu público-alvo, ou você simplesmente precisa alinhar áudio e lábios sem marcar outra gravação. É exatamente isso que o lipsync com IA resolve em 2027, e o faz com tanta precisão que a maioria dos espectadores não consegue notar a diferença entre a gravação original e a versão com lipsync.
O lipsync com IA atingiu um patamar real este ano. O resultado de modelos como Omni Human 1.5, Lipsync 2 Pro e Kling Lip Sync não é mais "aceitável". Ele é preciso no nível do fonema, alinhado no tempo até o milissegundo, e capaz de lidar com tudo, desde um clipe curto de 10 segundos para redes sociais até um vídeo corporativo dublado de 60 minutos. Este artigo explica como tudo funciona, quais modelos valem o seu tempo e como executar o processo, do upload ao arquivo final.
A maioria das pessoas imagina que lipsync é apenas trocar uma faixa de áudio por outra. A troca de áudio é a parte simples. O que o lipsync com IA realmente faz é modificar a geometria facial no vídeo para que a boca, os cantos dos lábios, a mandíbula e os músculos ao redor das bochechas se movam em sincronia com o novo sinal de áudio. A performance original, a expressão e a personalidade permanecem totalmente intactas. Só a região da boca muda.
O motor de sincronização por trás dos resultados
Os modelos modernos de lipsync são treinados com centenas de milhares de horas de vídeo anotado, construindo um mapa preciso entre sequências de fonemas e deformações dos músculos faciais. Quando você envia um vídeo e um arquivo de áudio, o modelo executa um pipeline de múltiplas etapas:
- A detecção facial roda em cada quadro, identificando a região do rosto e extraindo uma malha
- O áudio é analisado no nível do fonema, com cada som da fala marcado no tempo
- Uma nova geometria da boca é gerada para cada quadro com base no fonema correspondente
- A geometria gerada é recomposta no rosto original usando inpainting, preservando a textura da pele, a cor e a iluminação
O resultado é uma pessoa que parece dizer exatamente o que está no áudio, em qualquer idioma, em qualquer velocidade, com sua identidade original totalmente preservada.
Por que o resultado de 2026 parece real
Três anos atrás, o lipsync com IA era detectável. As bordas dos lábios ficavam levemente borradas, os dentes pareciam irreais e as transições de fonemas ficavam truncadas em falas rápidas. Hoje, a síntese baseada em difusão substituiu as antigas arquiteturas GAN. Os modelos agora operam em nível de inpainting por quadro, renderizando novamente apenas a região da boca e preservando todos os outros elementos, incluindo poros da pele, barba por fazer, textura do batom e dentes.
💡 A melhoria mais perceptível em 2026 é a renderização dos dentes. Os modelos anteriores tinham dificuldade com o interior da boca em fonemas de boca bem aberta, como "ah" e "ai". Os modelos atuais reconstroem a geometria de cada dente de acordo com a estrutura dental da pessoa original, eliminando o aspecto de plástico que antes denunciava o lipsync com IA.
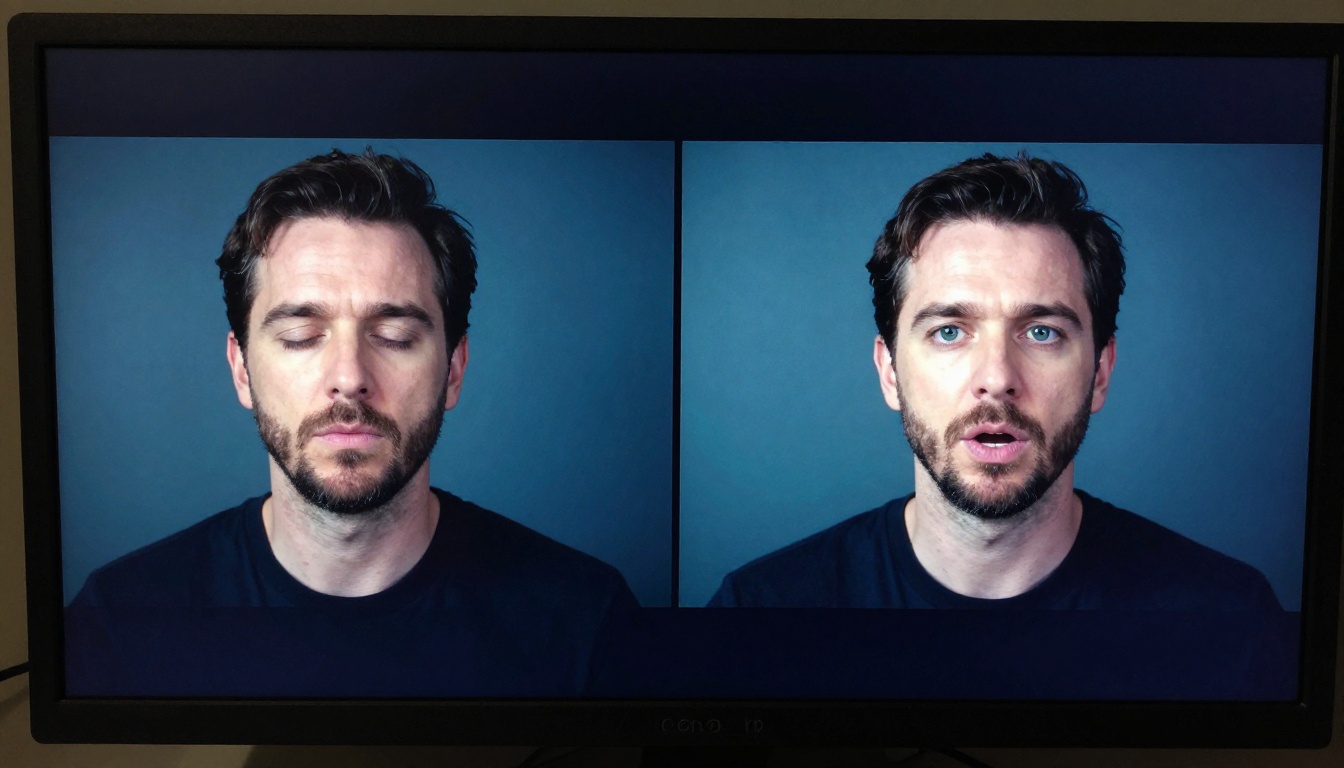
Hoje, há mais de uma dezena de modelos de lipsync com IA de nível de produção disponíveis na PicassoIA. Estes são os que produzem de forma consistente resultados de qualidade de transmissão em diferentes casos de uso:
Lipsync 2 Pro: o padrão de precisão
O Lipsync 2 Pro, da Sync Labs, é o atual benchmark de precisão da categoria. Ele trata o alinhamento áudio-visual no nível de subquadro, o que significa que você pode alimentá-lo com áudio de cadência irregular, sotaques regionais, sílabas sobrepostas ou fala rápida e ainda assim obter um resultado limpo, sem deriva na boca.
Este é o modelo ideal para:
- Localização de vídeos corporativos para mercados internacionais
- Pós-produção de documentários em que o ADR foi gravado separadamente
- Conteúdo de cursos online que precisa de narração atualizada sem regravar as aulas originais
A contrapartida é o tempo de processamento. O Lipsync 2 Pro não é a opção mais rápida da categoria. Quando você precisar de um rascunho em 30 segundos, use o Lipsync Speed. Quando o entregável for final, use o 2 Pro.
Seu irmão, o Lipsync 2, fica no meio do caminho: mais rápido que a versão Pro, com qualidade muito boa, o que o torna a melhor opção padrão para iterar em um projeto antes de partir para a passagem de precisão.
Omni Human 1.5: de uma única foto a vídeo completo
O Omni Human 1.5, da ByteDance, faz algo categoricamente diferente dos outros modelos. Você nem precisa de imagens de vídeo existentes. Envie uma única foto, forneça um arquivo de áudio, e o modelo gera um vídeo completo de cabeça falante do zero. A geometria facial, a dinâmica das expressões, o movimento natural da cabeça e as piscadas são todos sintetizados a partir da imagem estática.
Isso o torna excepcionalmente útil para:
- Criar vídeos de porta-voz sem câmera nem equipe
- Construir conteúdo de avatar a partir de uma única foto de rosto
- Conteúdo para redes sociais em que você quer uma personalidade consistente na tela sem sessões de gravação repetidas
Seu antecessor, o Omni Human, já era impressionante. A atualização 1.5 melhorou significativamente a precisão das microexpressões e o tempo das piscadas, que eram os sinais mais detectáveis de vídeo sintético na versão anterior. Intervalos naturais de piscada e leves inclinações da cabeça no meio da frase são o que faz os resultados do 1.5 parecerem genuinamente humanos.
💡 Para os melhores resultados com o Omni Human 1.5, use como imagem de origem uma foto de rosto em alta resolução, com iluminação uniforme e difusa e expressão neutra. O modelo usa a geometria facial inicial como base, então uma entrada limpa produz um resultado muito mais limpo.
Kling Lip Sync: rápido e pronto para redes sociais
O Kling Lip Sync é otimizado para velocidade em conteúdo curto. Ele processa clipes de menos de 60 segundos extremamente rápido, o que o torna a ferramenta certa para Reels do Instagram, TikToks e YouTube Shorts, em que o tempo de entrega importa tanto quanto a qualidade. A precisão da sincronia é muito boa para falas rápidas e estilos de fala casuais, e ele trabalha nativamente com formatos de vídeo vertical, o que ainda é uma limitação para vários outros modelos.
O fluxo de trabalho básico é o mesmo em todos os modelos. As entradas são sempre as mesmas: um vídeo (ou foto) e um arquivo de áudio. A saída é sempre um vídeo com os movimentos da boca sincronizados com o novo áudio. Veja o processo completo.
Etapa 1: prepare seu vídeo de origem
O vídeo de origem precisa de uma visão clara e sem obstruções do rosto na maioria dos quadros. O modelo precisa detectar e rastrear a região da boca ao longo de todo o clipe. Problemas comuns que causam falhas de sincronia ou de rastreamento facial:
- Mãos cobrindo a boca ou a parte inferior do rosto
- Ângulos extremos de perfil, acima de 60 graus do centro
- Resolução baixa, abaixo de 480p, ou granulação de filme forte
- Vários rostos no quadro sem um assunto principal claro
- Cortes rápidos de câmera com mudanças na posição do rosto
Se o seu material tiver algum desses problemas, corte ou recorte para as partes em que o rosto está limpo e visível. A maioria dos modelos lida bem com variação moderada de ângulo, de até cerca de 45 graus em relação à frente.
Etapa 2: grave ou envie o áudio
Seu arquivo de áudio deve ser:
- Limpo: sem música de fundo, reverberação ou ruído ambiente sob a fala
- Normalizado: nível de volume constante do início ao fim, sem picos repentinos
- Em formato padrão: WAV ou MP3 de alta qualidade (ambos são aceitos por todos os modelos)
💡 Se você estiver gerando a voz com um modelo de texto para fala, a PicassoIA tem um conjunto completo de Texto para fala. Gere a voz primeiro, baixe o arquivo de áudio e depois alimente o modelo de lipsync. Esse fluxo em duas etapas lhe dá controle total sobre a qualidade da voz antes da etapa de sincronização.
Etapa 3: escolha o modelo certo
Combine o modelo com sua necessidade real:
Etapa 4: execute a sincronização
Envie seu vídeo e seu áudio para o modelo selecionado. A maioria dos modelos oferece:
- Uma prévia de detecção facial que confirma a área de rastreamento do rosto antes do processamento começar
- Um controle de deslocamento de sincronia para adiantar ou atrasar o áudio em alguns milissegundos, caso a gravação original tenha um pequeno atraso no início
- Controles de resolução e formato de saída para o arquivo final
Para gravações padrão com boa visibilidade do rosto, as configurações padrão produzem um resultado limpo sem necessidade de ajuste manual.
Etapa 5: revise e refine
Quando a renderização terminar, assista ao resultado em velocidade 1x. Verifique especialmente:
- Fonemas plosivos ("p", "b", "m"), em que os lábios devem se fechar por completo antes de abrir
- Pausas silenciosas, em que a boca deve voltar a uma posição de repouso natural
- Risadas ou mudanças emocionais no meio da frase, em que a expressão e a sincronia precisam acontecer juntas
Se algum desses pontos parecer levemente errado, refaça com o Lipsync Precision como alternativa. Ele lida melhor com o mapeamento complexo de fonemas em trechos com troca de sotaque do que a maioria das opções da faixa de velocidade.
O caso de uso de lipsync com maior valor comercial em 2027 não é sincronizar filmagens existentes. É criar vídeos que nunca existiram. Você fornece uma única foto e um arquivo de áudio, e o modelo gera um vídeo completo de cabeça falante sem nenhuma filmagem de origem.
Omni Human 1.5 na prática
O Omni Human 1.5 não apenas anima a boca a partir de uma foto. Ele gera:
- Micromovimentos naturais da cabeça: acenos sutis, inclinações laterais leves no meio da frase
- Piscadas realistas em intervalos estatisticamente naturais ao longo do clipe
- Movimento de ombros e parte superior do corpo coerente com o ritmo da respiração sugerido pelo áudio
O resultado não é uma cabeça estática com lábios se movendo. É uma pessoa que parece estar de fato falando. Para criadores que precisam de uma presença consistente na tela sem aparecer eles mesmos na câmera, isso deixou de ser experimental e passou a estar pronto para produção.
Fabric 1.0 e P Video Avatar
O Fabric 1.0, da Veed, oferece um fluxo de trabalho simplificado de animação de fotos. Ele foi projetado para facilidade de uso, com controles enxutos, e tem desempenho especialmente bom em ambientes estáticos, como bots de atendimento ao cliente, explicadores de produtos e apresentadores de e-learning. Ele processa mais rápido que o Omni Human 1.5, ao custo de alguma expressividade no movimento gerado da cabeça.
O P Video Avatar segue uma abordagem um pouco diferente, com foco em manter a identidade facial consistente em saídas mais longas. Quando você está criando um personagem recorrente ou um porta-voz de marca que vai aparecer em muitos vídeos, a consistência de identidade do P Video Avatar o torna a escolha mais prática com o tempo.
Dublagem ou lipsync: qual é a diferença
Esses dois termos são usados como se fossem intercambiáveis, mas descrevem fluxos de trabalho diferentes com resultados diferentes. Entender a distinção economiza tempo na hora de escolher a ferramenta certa.
Quando você precisa de dublagem
A dublagem substitui a faixa de áudio original por uma nova, em outro idioma, com outra voz ou outro estilo, e depois ajusta os movimentos da boca do vídeo para combinar. Os estúdios de cinema fazem isso manualmente há décadas. Hoje, a IA executa todo o pipeline automaticamente.
Use a dublagem quando:
- Você está traduzindo um conteúdo para outro idioma e um novo público
- Você precisa trocar uma voz específica mantendo o vídeo original intacto
- O áudio original tem problemas de qualidade e precisa de uma substituição limpa
O Video Translate, da HeyGen, é o modelo de destaque para esse fluxo de trabalho. Ele lida com mais de 150 idiomas e combina três etapas automatizadas: transcrição do roteiro, geração de voz com IA no idioma-alvo que combina com o estilo vocal do falante original, e lipsync aplicado ao vídeo resultante. Todo o pipeline roda a partir de um único upload.
Quando o lipsync puro é a melhor escolha
O lipsync sem tradução é o que você precisa quando:
- Você já tem o idioma certo, mas o áudio foi gravado separadamente do vídeo
- Você quer regravar a voz do mesmo vídeo com outro falante ou uma gravação mais limpa
- Você está criando conteúdo a partir de uma foto com áudio gerado por IA e nenhuma filmagem de origem
O React 1, da Sync Labs, acrescenta uma camada importante aqui: ele sincroniza não só o movimento dos lábios, mas também as microexpressões faciais com o conteúdo emocional do áudio. Se o áudio soa animado, o rosto reflete isso. Se for calmo, a expressão acompanha. Isso o torna especialmente forte em conteúdos em que a performance emocional precisa combinar com a nova faixa de áudio, e não apenas com o tempo.
A tradução de vídeo é onde o lipsync com IA entrega o retorno comercial mais imediato em 2027. Um vídeo produzido em um idioma agora pode alcançar um público global em 150 idiomas, sem regravar, sem contratar dubladores para cada mercado e sem o problema do vale da estranheza que tornava a IA de dublagem anterior inutilizável em contextos profissionais.
Video Translate, da HeyGen
O Video Translate executa o pipeline completo automaticamente. Você envia um vídeo em qualquer idioma, seleciona o idioma de destino e o modelo:
- Transcreve a fala original para texto
- Traduz o roteiro usando um modelo de linguagem otimizado para fala natural
- Sintetiza uma voz no idioma de destino que combina com o ritmo, o tom e a energia da fala do falante original
- Aplica o lipsync ao vídeo para que os movimentos da boca combinem com o novo áudio
A correspondência de voz é um dos recursos mais subestimados desse modelo. Ele não gera uma voz sintética genérica no idioma de destino. Ele tenta preservar as características vocais do falante original, incluindo a velocidade de fala, as pausas naturais e o registro emocional. O resultado soa como o próprio falante original fluente no novo idioma, e não como um robô de texto para fala.
💡 Ao dublar conteúdo para redes sociais, mantenha os clipes com menos de 90 segundos para obter a melhor precisão de sincronia em todos os modelos. Vídeos mais longos podem apresentar uma leve deriva de tempo na segunda metade, especialmente quando o áudio original tem mudanças rápidas de assunto ou cortes de cena.
React 1 para uma dublagem com consistência emocional
O React 1 acrescenta alinhamento de expressão ao fluxo de dublagem. Quando uma tradução altera o ritmo ou a ênfase da fala original, o React 1 garante que a camada de microexpressões se adapte ao conteúdo emocional do novo áudio, em vez de refletir a gravação original. Para conteúdos de marketing em que o tom e a energia precisam parecer nativos em cada mercado, essa camada de sincronia de expressão importa bastante.
Velocidade ou precisão
O ponto de decisão mais prático ao executar lipsync com IA é escolher quanta qualidade de resultado aquele conteúdo específico realmente exige. Especificar demais o modelo desperdiça tempo de processamento. Especificar de menos corre o risco de artefatos visíveis nos entregáveis.
A faixa de velocidade
Para conteúdos em que o tempo de entrega importa mais que a perfeição:
- Lipsync Speed: tempos de renderização medidos em segundos. A qualidade da sincronia é muito boa para clipes de menos de 30 segundos e adequada para clipes de até 90 segundos.
- Kling Lip Sync: o melhor da categoria para vídeo vertical e formato curto. Processamento rápido com resultados de aparência natural para estilos de fala casuais.
- Lipsync da Pixverse: forte em conteúdo animado e estilizado, não só em filmagens reais. Se o seu vídeo de origem não for fotorrealista, ele lida com a consistência da renderização melhor do que modelos estritamente voltados a imagens reais.
A faixa de precisão
Para conteúdos em que um único artefato visível prejudicaria a credibilidade ou a confiança:
- Lipsync 2 Pro: precisão de subquadro, lida com todos os tipos de fonema de forma limpa e processa vídeos mais longos sem deriva temporal.
- Lipsync Precision: criado especificamente para áudio com forte sotaque e mapeamento complexo de fonema para viseme. Tem bom desempenho com áudio de falantes não nativos, em que os sons das vogais diferem bastante dos dados de treinamento padrão.
- Omni Human 1.5: quando a precisão inclui a credibilidade facial completa, e não apenas o movimento dos lábios isoladamente.
A regra prática: use a faixa de velocidade para rascunhos, iterações e conteúdo para redes sociais. Use a faixa de precisão para qualquer coisa que vá para um entregável final, mídia paga ou transmissão.
O que você pode criar agora
As aplicações criativas e comerciais do lipsync com IA em 2027 não são mais teóricas. Veja o que está sendo construído de fato:
- Tutores de idiomas gerando vídeos de pronúncia com falantes nativos a partir de fotos de instrutores reais, sem reservar estúdio
- Equipes de marketing localizando campanhas publicitárias em 10 ou mais idiomas a partir de uma única gravação master em uma tarde
- Podcasters criando versões em vídeo de programas só de áudio ao animar uma foto de rosto com o episódio completo
- Plataformas de e-learning atualizando cursos gravados anos atrás com narração corrigida, sem trazer os instrutores de volta à frente da câmera
- Cineastas independentes dublando curtas-metragens em vários idiomas para submissões em festivais internacionais com custo próximo de zero
A barreira para qualquer um desses fluxos de trabalho agora é uma aba do navegador e um upload de arquivo. O processamento roda na nuvem e entrega o resultado em minutos. Sem GPU local, sem software instalado, sem configuração técnica.
Todos os modelos deste artigo estão disponíveis na PicassoIA, cobrindo toda a gama de fluxos de trabalho de lipsync: animação de fotos, dublagem de vídeo, tradução multilíngue, criação de avatares falantes e performances com sincronia de expressão. A coleção completa está disponível em picassoia.com/en/all-models.
Comece aqui, de acordo com a sua situação:
Envie seus arquivos, escolha o modelo que se encaixa no seu fluxo de trabalho e veja o resultado em menos de cinco minutos. A tecnologia está pronta. Só falta executá-la.


