Vous avez enregistré une voix off parfaite. Votre vidéo est tournée. Mais les mouvements de la bouche ne correspondent pas, la langue ne convient pas à votre public cible, ou vous avez simplement besoin que l’audio et les lèvres s’alignent sans réserver un nouveau tournage. C’est précisément ce que résout le lipsync par IA en 2027, et il le fait avec une précision telle que la plupart des spectateurs ne peuvent pas distinguer un enregistrement original d’une version synchronisée.
Le lipsync par IA a franchi un vrai cap cette année. Le résultat produit par des modèles comme Omni Human 1.5, Lipsync 2 Pro et Kling Lip Sync n’est plus « assez proche ». Il est précis au niveau du phonème, aligné dans le temps à la milliseconde près, et capable de traiter aussi bien un clip de 10 secondes pour les réseaux sociaux qu’une vidéo d’entreprise doublée de 60 minutes. Cet article explique comment tout cela fonctionne, quels modèles valent votre temps, et comment exécuter le processus, de l’import jusqu’au fichier final.
Ce que fait réellement le lipsync par IA
La plupart des gens pensent que le lipsync consiste simplement à remplacer une piste audio par une autre. Le remplacement audio est la partie la plus simple. Ce que fait réellement le lipsync par IA, c’est modifier la géométrie faciale de la vidéo pour que la bouche, les commissures des lèvres, la mâchoire et les muscles des joues environnants suivent le nouveau signal audio. La performance d’origine, l’expression et la personnalité restent entièrement intactes. Seule la zone de la bouche change.
Le moteur de synchronisation derrière les résultats
Les modèles de lipsync modernes sont entraînés sur des centaines de milliers d’heures de vidéos annotées, en construisant une correspondance précise entre les séquences de phonèmes et les déformations des muscles faciaux. Lorsque vous importez une vidéo et un fichier audio, le modèle exécute un pipeline en plusieurs étapes :
- La détection du visage s’effectue sur chaque image, en identifiant la zone du visage et en extrayant un maillage
- L’audio est analysé au niveau du phonème, chaque son de parole étant horodaté
- Une nouvelle géométrie de la bouche est générée pour chaque image, en fonction du phonème correspondant
- La géométrie générée est recomposée dans le visage d’origine par inpainting, en préservant la texture de la peau, la couleur et l’éclairage
Le résultat est une personne qui semble dire exactement ce qui se trouve dans l’audio, dans n’importe quelle langue, à n’importe quelle vitesse, tout en conservant entièrement son identité d’origine.
Pourquoi le résultat de 2026 paraît réel
Il y a trois ans, le lipsync par IA était détectable. Les bords des lèvres étaient légèrement flous, les dents paraissaient irréalistes, et les transitions de phonèmes étaient saccadées à débit de parole rapide. Aujourd’hui, la synthèse par diffusion a remplacé les anciennes architectures GAN. Les modèles fonctionnent désormais au niveau de l’inpainting image par image, en ne re-générant que la zone de la bouche tout en préservant chaque autre élément, y compris les pores de la peau, la barbe naissante, la texture du rouge à lèvres et les dents.
💡 L’amélioration la plus perceptible en 2026 concerne le rendu des dents. Les modèles précédents peinaient à reproduire l’intérieur de la bouche lors des phonèmes à bouche grande ouverte comme « a » et « ay ». Les modèles actuels reconstruisent la géométrie individuelle de chaque dent, conforme à la structure dentaire de la personne d’origine, ce qui élimine l’aspect plastique qui trahissait auparavant le lipsync par IA.
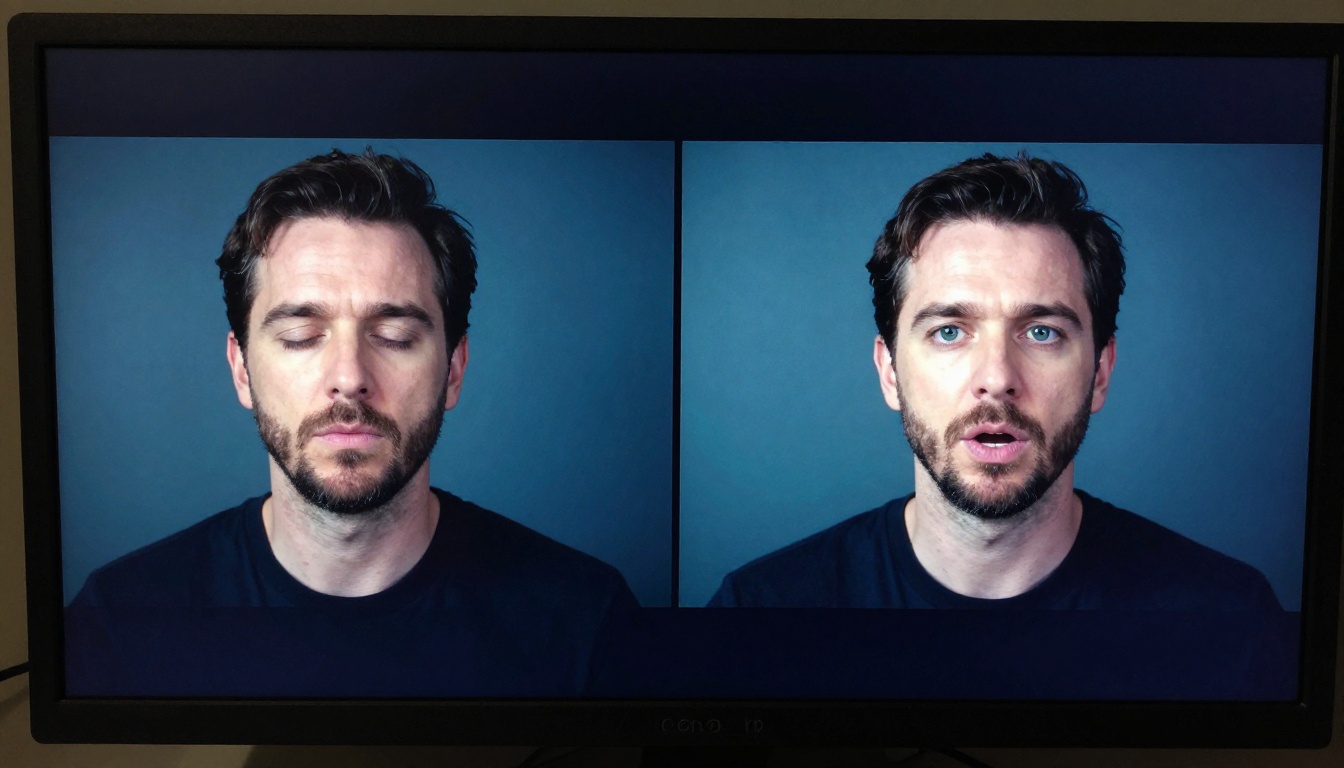
Les meilleurs modèles de lipsync par IA du moment
Plus d’une douzaine de modèles de lipsync par IA prêts pour la production sont désormais disponibles sur PicassoIA. Voici ceux qui produisent systématiquement des résultats de qualité diffusion dans différents cas d’usage :
Lipsync 2 Pro : la référence en matière de précision
Lipsync 2 Pro de Sync Labs est actuellement le benchmark en matière de précision dans la catégorie. Il gère l’alignement audiovisuel au niveau sous-image, ce qui signifie que vous pouvez lui fournir un audio au rythme irrégulier, avec des accents régionaux, des syllabes qui se chevauchent ou une parole rapide, et obtenir tout de même un résultat propre, sans dérive de la bouche.
C’est le modèle de choix pour :
- La localisation de vidéos d’entreprise vers les marchés internationaux
- La post-production documentaire lorsque l’ADR a été enregistré séparément
- Les contenus de cours en ligne qui nécessitent une narration mise à jour sans refaire le tournage de la leçon d’origine
Le compromis porte sur le temps de traitement. Lipsync 2 Pro n’est pas l’option la plus rapide de la catégorie. Lorsque vous avez besoin d’une ébauche en 30 secondes, utilisez plutôt Lipsync Speed. Lorsque le livrable est final, utilisez 2 Pro.
Son petit frère, Lipsync 2, se situe entre les deux : plus rapide que la version Pro, avec une très bonne qualité, ce qui en fait le meilleur choix par défaut pour itérer sur un projet avant de passer à la passe de précision.
Omni Human 1.5 : d’une seule photo à la vidéo complète
Omni Human 1.5 de ByteDance fait quelque chose de radicalement différent des autres modèles. Vous n’avez pas du tout besoin de séquences vidéo existantes. Importez une seule photo, fournissez un fichier audio, et le modèle génère une vidéo complète de tête parlante à partir de zéro. La géométrie faciale, la dynamique des expressions, les mouvements naturels de la tête et les clignements des yeux sont tous synthétisés à partir de l’image fixe.
Cela le rend exceptionnellement utile pour :
- Créer des vidéos de porte-parole sans caméra ni équipe de tournage
- Construire du contenu d’avatar à partir d’un seul portrait
- Créer des contenus pour les réseaux sociaux où vous voulez une personnalité à l’écran cohérente sans sessions de tournage répétées
Son prédécesseur, Omni Human, était déjà impressionnant. La mise à jour 1.5 a nettement amélioré la précision des micro-expressions et le timing des clignements, qui étaient les signes les plus détectables de vidéo synthétique dans la version précédente. Les intervalles de clignement naturels et les légères inclinaisons de la tête au milieu d’une phrase sont ce qui rend les résultats de la 1.5 réellement humains.
💡 Pour de meilleurs résultats avec Omni Human 1.5, utilisez comme image source un portrait haute résolution, avec un éclairage uniforme et diffus et une expression neutre. Le modèle utilise la géométrie faciale initiale comme base, donc une entrée propre produit un résultat beaucoup plus net.
Kling Lip Sync : rapide et prêt pour les réseaux sociaux
Kling Lip Sync est optimisé pour la vitesse sur les contenus courts. Il traite les clips de moins de 60 secondes très rapidement, ce qui en fait l’outil idéal pour les Reels Instagram, les TikTok et les YouTube Shorts, où le délai de livraison compte autant que la qualité. La précision de synchronisation est très bonne pour une parole rapide et des styles de diction décontractés, et il gère nativement les formats vidéo verticaux, ce qui reste une limite pour plusieurs autres modèles.
Le flux de travail de base est identique pour tous les modèles. Les entrées sont toujours les mêmes : une vidéo (ou une photo) et un fichier audio. La sortie est toujours une vidéo dont les mouvements de la bouche sont synchronisés sur le nouvel audio. Voici le processus complet.
Étape 1 : préparez votre vidéo source
La vidéo source doit offrir une vue claire et dégagée du visage dans la majorité des images. Le modèle doit détecter et suivre la zone de la bouche tout au long du clip. Voici les problèmes courants qui provoquent des erreurs de synchronisation ou de suivi du visage :
- Des mains qui couvrent la bouche ou le bas du visage
- Des profils latéraux extrêmes au-delà de 60 degrés par rapport au centre
- Une résolution inférieure à 480p, ou un grain de film prononcé
- Plusieurs visages dans le cadre sans sujet principal clairement identifié
- Des coupes de caméra rapides avec des positions du visage qui changent
Si vos images présentent l’un de ces problèmes, recadrez ou découpez les passages où le visage est net et visible. La plupart des modèles gèrent bien une variation d’angle modérée, jusqu’à environ 45 degrés par rapport à une vue de face.
Étape 2 : enregistrez ou importez l’audio
Votre fichier audio doit être :
- Propre : sans musique de fond, réverbération ni bruit ambiant sous la parole
- Normalisé : niveau sonore constant du début à la fin, sans pics soudains
- Dans un format standard : WAV ou MP3 de bonne qualité (les deux sont acceptés par tous les modèles)
💡 Si vous générez la voix avec un modèle de synthèse vocale, PicassoIA dispose d’une suite complète Text to Speech. Générez d’abord la voix, téléchargez le fichier audio, puis injectez-le dans le modèle de lipsync. Ce flux en deux étapes vous donne un contrôle total sur la qualité de la voix avant l’étape de synchronisation.
Étape 3 : choisissez le bon modèle
Adaptez le modèle à votre besoin réel :
Étape 4 : lancez la synchronisation
Importez votre vidéo et votre audio dans le modèle sélectionné. La plupart des modèles proposent :
- Un aperçu de la détection du visage qui confirme la zone de suivi du visage avant le début du traitement
- Une commande de décalage de synchronisation pour décaler l’audio de quelques millisecondes si l’enregistrement d’origine présente un léger retard au démarrage
- Des options de résolution et de format de sortie pour le fichier final
Pour des enregistrements standard où le visage est bien visible, les paramètres par défaut produisent un résultat propre sans réglage manuel.
Étape 5 : vérifiez et affinez
Une fois le rendu terminé, regardez le résultat à vitesse 1x. Vérifiez en particulier :
- Les phonèmes occlusifs (« p », « b », « m ») où les lèvres doivent se fermer complètement avant de s’ouvrir
- Les pauses silencieuses où la bouche doit revenir à une position de repos naturelle
- Les rires ou les changements émotionnels au milieu d’une phrase, où l’expression et la synchronisation doivent coïncider
Si l’un de ces points paraît légèrement décalé, relancez avec Lipsync Precision comme alternative. Il gère mieux la correspondance complexe des phonèmes aux frontières d’accents que la plupart des options de la gamme rapide.
L’usage du lipsync le plus précieux commercialement en 2027 ne consiste pas à synchroniser des séquences existantes. Il s’agit de créer une vidéo qui n’a jamais existé. Vous fournissez une seule photo et un fichier audio, et le modèle génère une vidéo complète de tête parlante, sans séquence source.
Omni Human 1.5 en pratique
Omni Human 1.5 ne se contente pas d’animer la bouche à partir d’une photo. Il génère :
- Des micro-mouvements naturels de la tête : de légers hochements, de légères inclinaisons latérales au milieu d’une phrase
- Des clignements d’yeux réalistes à des intervalles statistiquement naturels tout au long du clip
- Des mouvements des épaules et du haut du corps en accord avec le rythme respiratoire suggéré par l’audio
Le résultat n’est pas une tête immobile avec des lèvres qui bougent. C’est une personne qui semble réellement parler. Pour les créateurs qui ont besoin d’une présence à l’écran constante sans apparaître eux-mêmes devant la caméra, cela est passé du stade expérimental à celui de la production.
Fabric 1.0 et P Video Avatar
Fabric 1.0 de Veed propose un flux d’animation de photo simplifié. Il est conçu pour être facile à utiliser, avec des commandes épurées, et il donne de très bons résultats pour les environnements statiques, comme les robots de service client, les présentations de produits et les présentateurs de e-learning. Il traite plus vite qu’Omni Human 1.5, au prix d’une certaine expressivité dans les mouvements de tête générés.
P Video Avatar adopte une approche légèrement différente, en se concentrant sur le maintien d’une identité faciale cohérente sur des vidéos plus longues. Lorsque vous créez un personnage récurrent ou un porte-parole de marque qui apparaîtra dans de nombreuses vidéos, la constance de l’identité de P Video Avatar en fait le choix le plus pratique sur la durée.
Doublage ou lipsync : quelle est la différence
Ces deux termes sont souvent utilisés l’un pour l’autre, mais ils décrivent des flux de travail différents avec des résultats différents. Comprendre la distinction vous fait gagner du temps dans le choix de l’outil.
Quand le doublage est nécessaire
Le doublage remplace la piste audio d’origine par une nouvelle, dans une autre langue, avec une autre voix ou un autre style, puis ajuste les mouvements de la bouche de la vidéo pour correspondre. Les studios de cinéma le font manuellement depuis des décennies. L’IA exécute désormais l’ensemble du pipeline automatiquement.
Utilisez le doublage lorsque vous :
- Traduisez un contenu dans une autre langue pour un nouveau public
- Remplacez une voix précise tout en conservant la vidéo d’origine intacte
- Constatez que l’audio d’origine présente des problèmes de qualité et nécessite un remplacement propre
Video Translate de HeyGen est le modèle phare pour ce flux de travail. Il gère plus de 150 langues et combine trois étapes automatisées : la transcription du script, la génération d’une voix IA dans la langue cible qui correspond au style vocal de l’intervenant d’origine, et le lipsync appliqué à la vidéo résultante. Le pipeline complet s’exécute à partir d’un seul import.
Quand le lipsync pur est le meilleur choix
Le lipsync sans traduction est ce dont vous avez besoin lorsque :
- Vous disposez de la bonne langue, mais l’audio a été enregistré séparément de la vidéo
- Vous voulez refaire la voix de la même vidéo avec un autre intervenant ou un enregistrement plus propre
- Vous créez un contenu à partir d’une photo avec un audio généré par IA et aucune séquence source
React 1 de Sync Labs ajoute ici une couche importante : il synchronise non seulement le mouvement des lèvres, mais aussi les micro-expressions du visage avec le contenu émotionnel de l’audio. Si l’audio paraît enthousiaste, le visage le reflète. S’il est calme, l’expression suit. Cela le rend particulièrement efficace pour les contenus où la performance émotionnelle doit correspondre à la nouvelle piste audio, et pas seulement au rythme.
Traduire des vidéos avec le lipsync par IA
La traduction vidéo est le domaine où le lipsync par IA offre le retour commercial le plus immédiat en 2027. Une vidéo réalisée dans une langue peut désormais toucher un public mondial dans 150 langues, sans nouveau tournage, sans recruter de comédiens de doublage pour chaque marché, et sans le problème de la vallée de l’étrange qui rendait les premières IA de doublage inutilisables dans un contexte professionnel.
Video Translate de HeyGen
Video Translate gère l’ensemble du pipeline automatiquement. Vous importez une vidéo dans n’importe quelle langue, sélectionnez votre langue cible, et le modèle :
- Transcrit la parole d’origine en texte
- Traduit le script à l’aide d’un grand modèle de langage optimisé pour une sortie orale naturelle
- Synthétise une voix dans la langue cible qui correspond au rythme, au ton et à l’énergie d’élocution de l’intervenant d’origine
- Applique le lipsync à la vidéo pour que les mouvements de la bouche correspondent à la nouvelle piste audio
La correspondance vocale est l’une des fonctionnalités les plus sous-estimées de ce modèle. Il ne génère pas une voix synthétique générique dans la langue cible. Il cherche à préserver les caractéristiques vocales de l’intervenant d’origine, y compris la vitesse d’élocution, les pauses naturelles et le registre émotionnel. Le résultat donne l’impression que l’intervenant d’origine parle couramment la nouvelle langue, et non qu’un robot de synthèse vocale s’exprime.
💡 Lorsque vous doublez un contenu pour les réseaux sociaux, gardez les clips sous 90 secondes pour une précision de synchronisation optimale avec tous les modèles. Les vidéos plus longues peuvent présenter une légère dérive temporelle dans la seconde moitié, surtout lorsque l’audio source comporte des changements de sujet rapides ou des coupes de scène.
React 1 pour un doublage cohérent sur le plan émotionnel
React 1 ajoute l’alignement des expressions au flux de doublage. Lorsqu’une traduction modifie le rythme ou l’emphase de la parole d’origine, React 1 fait en sorte que la couche de micro-expressions s’adapte au contenu émotionnel de la nouvelle piste audio, au lieu de reproduire la prise d’origine. Pour les contenus marketing où le ton et l’énergie doivent paraître naturels sur chaque marché, cette couche de synchronisation des expressions compte beaucoup.
Vitesse ou précision
Le point de décision le plus concret lorsque vous utilisez le lipsync par IA consiste à choisir le niveau de qualité réellement requis par le contenu. Surdimensionner le modèle fait perdre du temps de traitement. Le sous-dimensionner risque de laisser des artefacts visibles dans les livrables.
La gamme rapide
Pour les contenus où le délai de livraison compte plus que la perfection :
- Lipsync Speed : durées de rendu mesurées en secondes. La qualité de synchronisation est très bonne pour les clips de moins de 30 secondes et correcte pour les clips allant jusqu’à 90 secondes.
- Kling Lip Sync : le meilleur de sa catégorie pour la vidéo verticale et le format court. Traitement rapide et résultat naturel pour les styles de parole décontractés.
- Lipsync de Pixverse : performant sur les contenus animés et stylisés, pas seulement sur les images en prise de vue réelle. Si votre vidéo source n’est pas photoréaliste, ce modèle gère mieux la cohérence du rendu que les modèles strictement orientés prise de vue réelle.
La gamme précision
Pour les contenus où un seul artefact visible nuirait à la crédibilité ou à la confiance :
- Lipsync 2 Pro : précision au niveau sous-image, gère proprement tous les types de phonèmes, traite les vidéos longues sans dérive temporelle.
- Lipsync Precision : conçu spécifiquement pour les audios à fort accent et la correspondance complexe entre phonèmes et visèmes. Performant sur les audios de locuteurs non natifs, dont les sons vocaliques diffèrent nettement des données d’entraînement standard.
- Omni Human 1.5 : lorsque la précision implique une crédibilité faciale complète, et pas seulement le mouvement des lèvres isolément.
La règle pratique : utilisez la gamme rapide pour les ébauches, les itérations et les contenus pour les réseaux sociaux. Utilisez la gamme précision pour tout ce qui entre dans un livrable final, un placement payant ou une diffusion.
Ce que vous pouvez créer dès maintenant
Les applications créatives et commerciales du lipsync par IA en 2027 ne relèvent plus de la théorie. Voici ce qui se construit réellement :
- Les tuteurs de langues génèrent des vidéos de prononciation avec des locuteurs natifs à partir de photos de vrais formateurs, sans réserver de studio
- Les équipes marketing localisent des campagnes publicitaires dans 10 langues ou plus à partir d’un seul enregistrement maître en une après-midi
- Les podcasteurs créent des versions vidéo d’émissions purement audio en animant un portrait sur l’intégralité de l’épisode
- Les plateformes de e-learning mettent à jour des cours enregistrés il y a plusieurs années avec une narration corrigée, sans faire revenir les formateurs devant la caméra
- Les cinéastes indépendants doublent leurs courts-métrages dans plusieurs langues pour les soumissions aux festivals internationaux, pour un coût quasi nul
Le seul obstacle à l’un de ces flux de travail est désormais un onglet de navigateur et un import de fichier. Le calcul s’effectue dans le cloud et livre le résultat en quelques minutes. Pas de GPU local, pas de logiciel à installer, pas de configuration technique.
Chaque modèle de cet article est disponible sur PicassoIA, couvrant toute la gamme des flux de travail de lipsync : animation de photo, doublage vidéo, traduction multilingue, création d’avatars parlants et performances synchronisées sur les expressions. La collection complète est accessible sur picassoia.com/en/all-models.
Commencez ici selon votre situation :
- Vous avez des séquences existantes et voulez les doubler à nouveau : Lipsync 2 Pro
- Vous avez une photo et voulez une vidéo parlante : Omni Human 1.5
- Vous avez besoin d’une vidéo dans une autre langue : Video Translate
- Vous traitez rapidement de courts clips pour les réseaux sociaux : Kling Lip Sync
- Vous avez besoin d’une synchronisation expressive du visage, pas seulement des lèvres : React 1
Importez vos fichiers, choisissez le modèle qui correspond à votre flux de travail, et obtenez le résultat en moins de cinq minutes. La technologie est prête. Il ne reste plus qu’à l’utiliser.


