Las imágenes de referencia lo cambian todo. Cuando escribes un prompt solo, la IA toma cientos de micro-decisiones sobre color, iluminación, pose, ropa, estructura facial y estado de ánimo. Dale una imagen de referencia y, de repente, esas decisiones quedan ancladas a algo real. El resultado se vuelve predecible, constante y, en realidad, muy cercano a lo que tenías en mente.
No se trata de describir una imagen con palabras. Se trata de mostrarle a la IA exactamente lo que quieres y dejar que el modelo haga la traducción. Así funciona en la práctica.
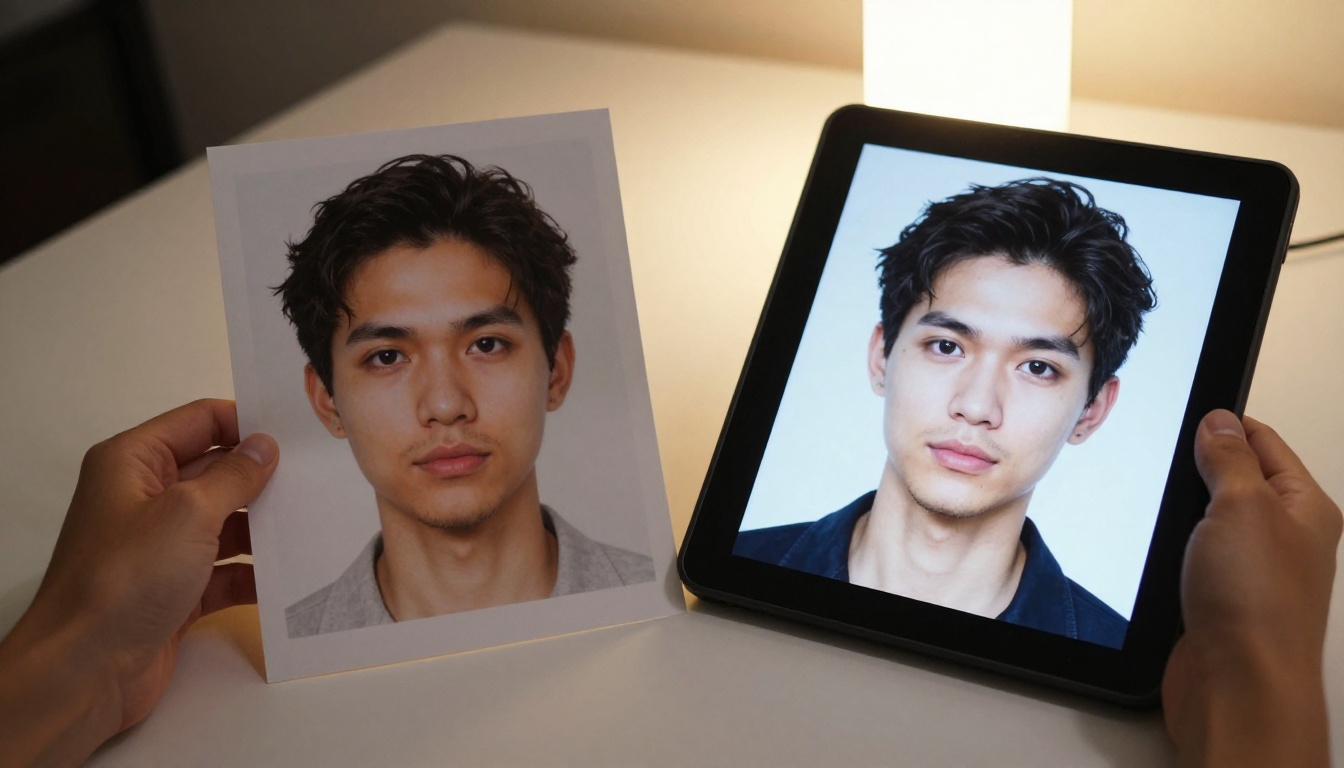
Qué hacen realmente las imágenes de referencia
La mayoría piensa en los generadores de IA como máquinas de texto a imagen: escribes un prompt y obtienes una imagen. Pero los modelos más capaces de hoy son multimodales: aceptan texto e imágenes como entrada, y la imagen aporta información que ningún texto puede transmitir por completo.
Cuando proporcionas una imagen de referencia, le das al modelo un ancla visual. Según la herramienta y cómo la uses, esa ancla puede fijar:
- Estilo: La estética general, la gradación de color, la textura del trazo o el aspecto fotográfico
- Sujeto: La persona, el objeto o el personaje concreto que quieres reproducir
- Composición: Dónde se colocan los elementos en el encuadre y su escala relativa
- Iluminación: La dirección, la temperatura de color y la intensidad de las fuentes de luz
- Pose y estructura: La posición del cuerpo, el ángulo del rostro o la distribución arquitectónica
El modelo no copia la referencia píxel a píxel. Lee la información visual y la usa como condición junto con tu prompt de texto. El texto le dice qué cambiar; la imagen de referencia le dice qué conservar.
Estilo, sujeto o composición
Estos tres elementos se comportan de forma muy distinta cuando usas una imagen de referencia. Entender la diferencia te ahorra horas de intentos fallidos.
Las referencias de estilo funcionan mejor cuando la imagen de referencia comparte el mismo tema general que tu prompt. Si introduces una foto con iluminación claroscuro dramática y pides un retrato, el modelo aplicará esa lógica de luz al nuevo rostro que describas.
Las referencias de sujeto exigen que el modelo extraiga y transfiera información de identidad concreta: un rostro, un disfraz, un producto de marca. Es más difícil. Los modelos especializados en la coherencia del sujeto, como Flux Redux Dev, están diseñados específicamente para este caso de uso.
Las referencias de composición son las más sutiles. Puedes subir un boceto o incluso un diseño aproximado, y el modelo colocará los elementos en posiciones similares. ControlNet se creó específicamente para esto, y sigue siendo una de las herramientas más precisas para controlar la composición.
Por qué los prompts solos se quedan cortos
Un prompt como "mujer con vestido rojo, iluminación cinematográfica, película de 35 mm" suena específico. Pero deja a la IA decidir: ¿qué mujer? ¿Qué tono de rojo? ¿Qué colorimetría de qué película? ¿Hacia dónde viene la luz?
Cada una de esas decisiones abiertas es una oportunidad para que el resultado se aleje de lo que querías. Las imágenes de referencia cierran esas brechas. Cuanto más puedas mostrar en lugar de describir, mayor será tu control sobre el resultado final.
No todas las herramientas de IA manejan las imágenes de referencia de la misma manera. Hay tres flujos de trabajo distintos, y cada uno ofrece un nivel de control diferente.
Imagen a imagen (el clásico)
El método más antiguo y universal. Subes una imagen y el modelo genera una nueva versión que conserva la estructura general y la paleta. La mayoría de plataformas ofrecen un control deslizante de fuerza o denoising: una fuerza mayor significa más cambio, y una fuerza menor mantiene el resultado más cerca de la referencia.
Casos de uso más indicados:
- Transformar un boceto aproximado en un render fotorrealista
- Cambiar el estilo de una foto manteniendo su composición
- Crear variaciones rápidas de un recurso existente
La debilidad de la imagen a imagen es la identidad del sujeto. Si subes una foto de una persona concreta, el modelo puede conservar su pose aproximada y la iluminación, pero cambiar su rostro. Para un control más preciso de la identidad, necesitas algo más específico.
IP-Adapter y Flux Redux
IP-Adapter (Image Prompt Adapter) es una técnica que inyecta el contenido semántico de la imagen de referencia directamente en las capas de atención del modelo. En lugar de condicionar por la estructura de píxeles, condiciona por lo que representa la imagen. Esto da una coherencia del sujeto mucho más sólida.
Flux Redux Dev usa un enfoque similar integrado en la arquitectura de Flux. Le proporcionas una imagen de origen y Flux Redux extrae su estilo y la huella del sujeto, y luego los aplica a nuevos prompts. El resultado: el mismo rostro, el mismo estilo artístico o el mismo producto apareciendo en escenas radicalmente distintas.
Este es el método que conviene usar cuando la coherencia importa más que la desviación creativa.
Entrenamiento de LoRA para un bloqueo profundo del estilo
Cuando ni la imagen a imagen ni IP-Adapter te dan la precisión que necesitas, entrenas un LoRA (Low-Rank Adaptation). Un LoRA es un modelo pequeño con ajuste fino sobre 10-30 imágenes de tu sujeto, estilo o producto concreto. Una vez entrenado, cada generación que use ese LoRA queda anclada a esos datos de entrenamiento.
P Image Trainer en PicassoIA lo hace accesible sin necesidad de una configuración local con GPU. Sube tus imágenes de referencia, configura unos cuantos parámetros y obtienes un LoRA entrenado que puedes usar en cualquier modelo compatible.
La contrapartida: el entrenamiento de LoRA requiere más tiempo y más imágenes por adelantado. Pero en proyectos continuos en los que necesitas un aspecto absolutamente coherente, la inversión se amortiza de inmediato.
Cómo gestiona las referencias Flux Redux Dev
Flux Redux Dev es una de las herramientas más directas para la generación basada en referencias disponibles en este momento. Se diseñó desde cero para tomar una imagen de origen y crear variaciones que respeten tanto el estilo como el contenido de la referencia.
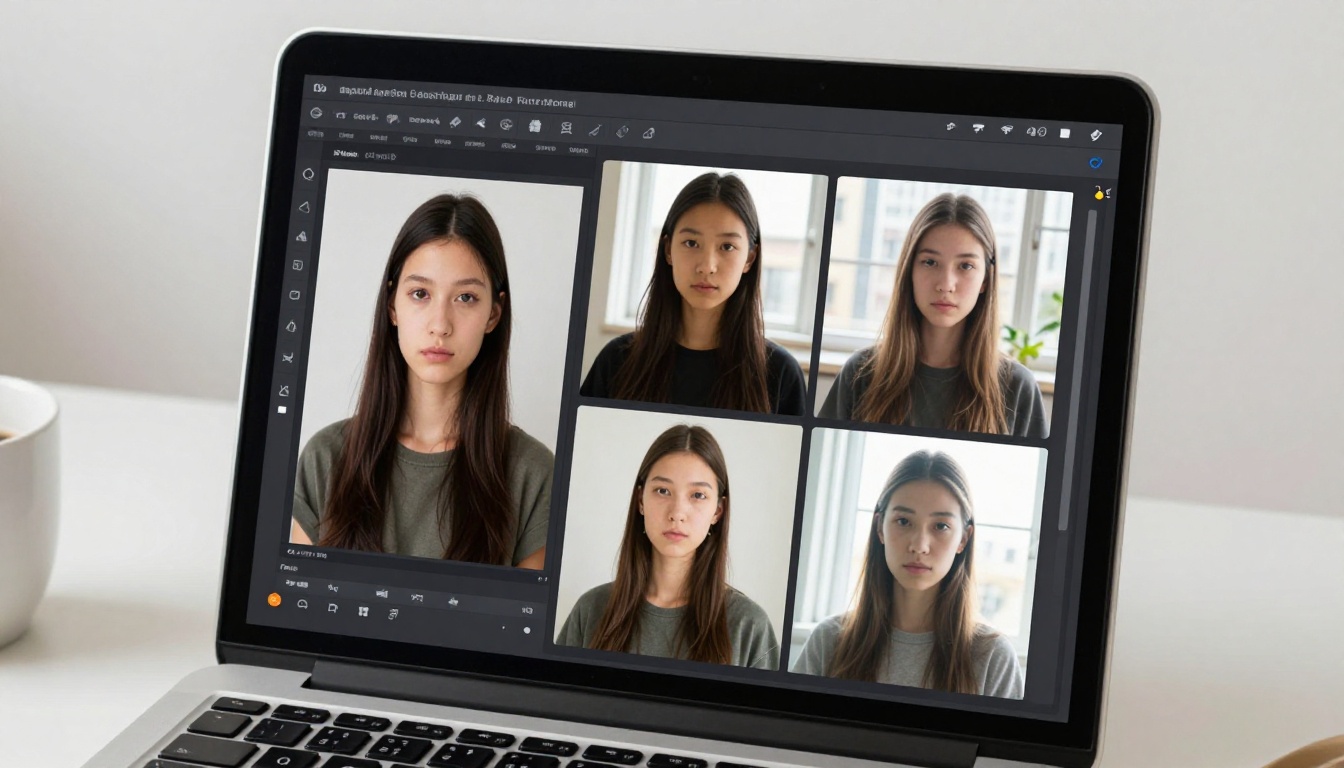
Paso a paso en PicassoIA
- Abre Flux Redux Dev en PicassoIA
- Sube tu imagen de referencia con el panel de entrada de imágenes
- Escribe tu prompt describiendo lo que quieres cambiar (nuevo escenario, iluminación, atuendo, escena)
- Ajusta la fuerza de la referencia. Empieza en 0.75 para una referencia fuerte con algo de libertad creativa
- Elige la relación de aspecto y la resolución
- Genera tu primer lote y revísalo antes de ajustar la fuerza
El modelo mantendrá la identidad central de tu referencia mientras se adapta a tu prompt. El retrato de una persona sobre un fondo blanco liso puede convertirse en la misma persona en un bosque, al atardecer o bajo una luz lateral de estudio dramática. El ancla del rostro y la ropa se mantiene; todo lo demás cambia según tu prompt.
Los ajustes de fuerza que importan
| Valor de fuerza | Qué hace |
|---|
| 0.3-0.5 | Influencia ligera de la referencia, más libertad creativa |
| 0.6-0.8 | Equilibrado: buena coherencia con margen para cambiar |
| 0.85-1.0 | Máximo bloqueo de referencia, mínima influencia del prompt |
La mayoría de los flujos de trabajo profesionales se mueven entre 0.65 y 0.8. Por debajo de 0.5, a menudo pierdes la identidad del sujeto por completo. Por encima de 0.9, el resultado copia la referencia de forma demasiado literal y limita el valor del prompt de texto.
Cómo conseguir personajes coherentes
La coherencia de personajes es uno de los retos más consultados en la generación de imágenes con IA. Si estás construyendo una historia, una campaña de producto o un personaje para redes sociales, necesitas que el mismo rostro y la misma ropa aparezcan en muchas escenas distintas.
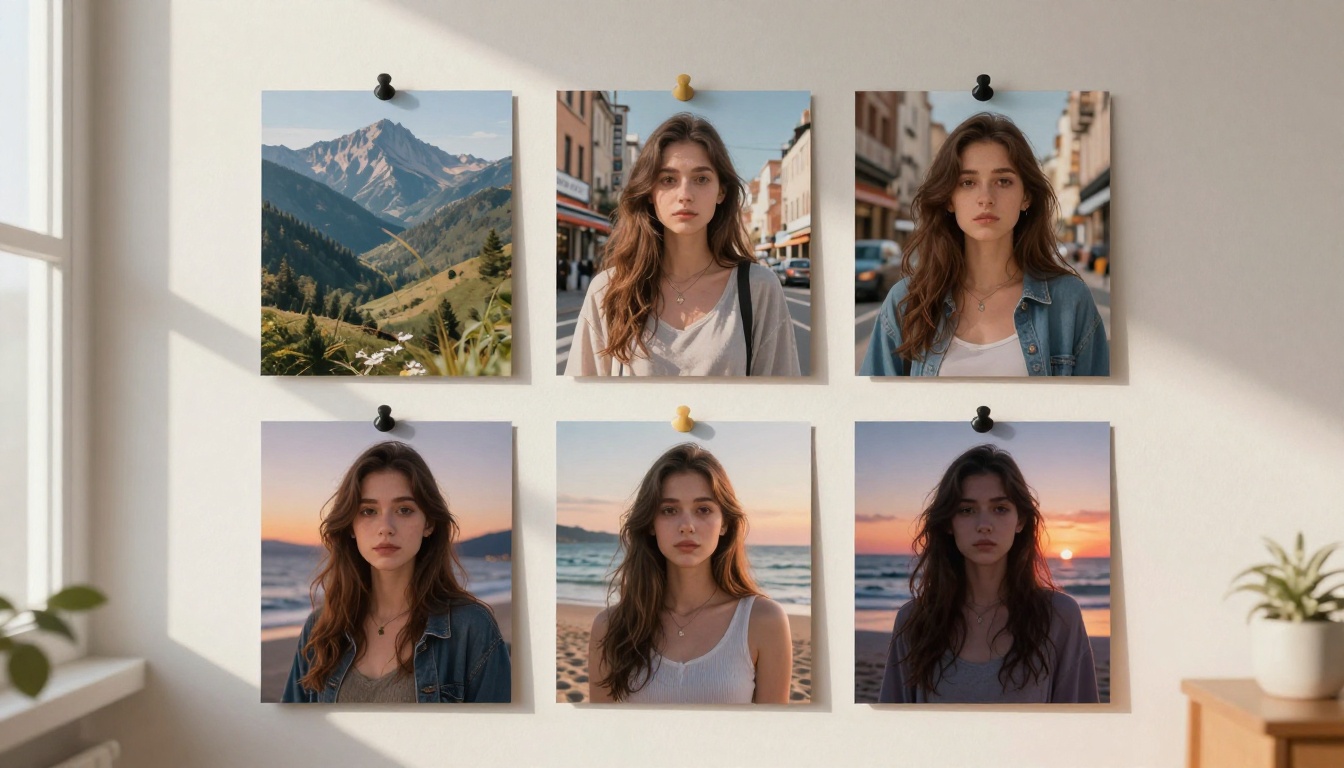
Coherencia facial entre escenas
El flujo de trabajo más rápido para la coherencia facial:
- Genera un retrato nítido y frontal de tu personaje como referencia principal
- Introdúcelo en Flux Redux Dev o en PicassoIA Image Editor Pro con la fuerza de referencia en 0.75
- Varía solo el escenario y la iluminación en tu prompt, y deja sin cambios la descripción del personaje
- Mantén en el prompt términos que describan el rostro para reforzar la referencia: color de ojos, peinado, rasgos faciales concretos
Cuanto más describas con regularidad el rostro en texto junto a la imagen de referencia, más estable será la identidad entre generaciones. Texto e imagen trabajan juntos, no como sustitutos el uno del otro.
La ropa y los accesorios también se mantienen
El mismo principio se aplica a los elementos que no son el rostro. Si tu personaje siempre lleva una chaqueta concreta, incluye la chaqueta en tu imagen de referencia principal y descríbela con precisión en el prompt. Los modelos leen muy bien la textura y el color de la ropa a partir de la referencia, sobre todo cuando el prompt refuerza esos detalles.
Para productos de marca complejos u objetos únicos, el entrenamiento de LoRA supera siempre a IP-Adapter. La retención de detalles a nivel fino (costuras, herrajes, colocación del logotipo) es notablemente mejor con un LoRA entrenado que con una sola imagen de referencia.
Transferencia de estilo sin perder el sujeto
La transferencia de estilo consiste en aplicar el lenguaje visual de una imagen al contenido de otra. Iluminación de cine negro en una foto callejera moderna. Tonos analógicos cálidos en un retrato digital. Suena sencillo, y con el enfoque correcto lo es.
La regla de la mezcla 40/60
Cuando usas imagen a imagen para la transferencia de estilo, una fuerza de referencia en torno a 0.4 (40%) para el estilo y dejando el 60% al prompt te da los resultados más utilizables. Con este equilibrio:
- Los colores dominantes y el contraste tonal de la referencia aparecen en el resultado
- El sujeto de tu prompt se distingue con claridad y no se deforma
- Detalles como la textura de la piel y la ropa se mantienen realistas
Si superas una fuerza de referencia de 0.6 para la transferencia de estilo, el estilo empieza a sobrescribir al sujeto. La persona u objeto que querías colocar en ese estilo comienza a perder nitidez y forma reconocible.
💡 Consejo: Para las referencias de estilo, usa imágenes con un lenguaje visual muy claro y contundente. Una referencia muy estilizada se comunica mejor que una sutil. Cuanto más distintivo sea el estilo, más fiablemente el modelo lo leerá y lo aplicará.
Cuándo usar ControlNet en su lugar
ControlNet es la mejor opción cuando tu preocupación principal es la pose o la composición más que el estilo. Subes un mapa de bordes, un mapa de profundidad o un esqueleto de pose, y ControlNet ancla el resultado de la IA a esas guías estructurales mientras genera libremente en todas las demás dimensiones.
Si necesitas reproducir exactamente una pose corporal concreta en una escena nueva, o quieres igualar la distribución de una habitación a partir de un plano de referencia, ControlNet es la herramienta adecuada. PicassoIA Image Editor Pro incluye edición compatible con ControlNet justo para este tipo de guía estructural, junto con las capacidades de inpainting y outpainting.
Errores comunes que arruinan tus resultados
Después de entender las herramientas, el siguiente paso es evitar los patrones que producen resultados malos de forma constante, sin importar qué modelo uses.
Peso de referencia incorrecto
El error más frecuente: la fuerza de referencia demasiado alta o demasiado baja. Los usuarios nuevos tienden a irse a los extremos. La ponen en 1.0 esperando una copia perfecta y obtienen algo parecido a un filtro deformado. O la ponen en 0.2 con la esperanza de una influencia sutil, y la imagen de referencia no tiene ningún efecto.
Trabaja desde el punto medio. Empieza en 0.7, haz tres generaciones y ajusta en incrementos pequeños (de 0.05 a 0.1) según lo que veas. Este enfoque de diagnóstico es mucho más eficiente que adivinar en los extremos y preguntarte por qué no funciona nada.
Iluminación y relación de aspecto que no coinciden
Tu imagen de referencia transmite su iluminación a la generación. Si tu referencia tiene luz lateral dura y quieres una luz suave de belleza en el resultado, esas dos condiciones se pelean entre sí. El modelo intenta conciliarlas y no obtienes ninguna de las dos con claridad.
Haz que la iluminación de tu prompt coincida con la de tu imagen de referencia, o describe la nueva luz de forma muy explícita en el prompt y baja la fuerza de referencia para que la dirección de la luz pueda cambiar.
Los desajustes de relación de aspecto provocan distorsiones. Ajusta o recorta siempre tu imagen de referencia a la misma proporción en la que vas a generar. Introducir una referencia de retrato 9:16 en una generación 16:9 deformará las proporciones de forma impredecible y producirá sujetos distorsionados.
Usar referencias de baja calidad
Las imágenes de referencia borrosas, de baja resolución o muy comprimidas degradan la calidad del resultado. El modelo no puede extraer un estilo o una información del sujeto claros de una foto pixelada. Usa siempre la versión de mayor calidad disponible de tu imagen de referencia.
Si tu única referencia tiene baja resolución, pásala primero por Wan 2.7 Image Pro o por un modelo de superresolución para afinar el detalle antes de usarla como referencia.
5 modelos que admiten imágenes de referencia en PicassoIA
No todos los generadores de IA manejan las imágenes de referencia por igual. Estas son cinco de las opciones más sólidas de PicassoIA para el trabajo basado en referencias, cada una adecuada a un caso de uso distinto.
Flux Redux Dev es el punto de partida predeterminado para la mayoría de los flujos de trabajo con imágenes de referencia, porque maneja tanto el estilo como el sujeto con una sola entrada de imagen y sin necesidad de entrenamiento. Es el camino más rápido desde "tengo una referencia" hasta "tengo un resultado coherente".
PicassoIA Image Editor Pro es la herramienta potente para cuando necesitas un control granular. El inpainting te permite corregir o reemplazar zonas concretas de una imagen manteniendo intacto el resto. El outpainting amplía el lienzo más allá de sus bordes originales. ControlNet bloquea la pose y la composición. Juntas, estas funciones hacen de él la plataforma de edición basada en referencias más versátil disponible.
P Image Trainer y P Image Edit LoRA forman un flujo de trabajo en dos pasos para una máxima coherencia: primero entrenas con tu conjunto de referencias y luego generas con el LoRA entrenado aplicado a cada resultado.
Qwen Image Edit Plus se encarga de las tareas de edición directa en las que tienes una imagen existente y quieres modificar elementos concretos. Lee tu foto subida como referencia y aplica tus instrucciones de texto a cambios puntuales.
Construir un flujo de trabajo basado en referencias que escale
Cuando entiendas la mecánica, podrás crear un proceso repetible en lugar de adivinar en cada generación.
- Selecciona tu referencia principal desde el principio del proyecto. Una imagen de alta calidad que represente lo que quieres anclar.
- Elige la herramienta adecuada según el elemento que más importe: identidad del sujeto (Flux Redux, LoRA), estilo (imagen a imagen) o estructura (ControlNet).
- Empieza con una fuerza de referencia de 0.7 y ajusta según los resultados, no según la intuición.
- Mantén los prompts de texto coherentes con la referencia para reforzarla en lugar de contradecirla.
- Crea una biblioteca de referencias con el tiempo. Cada buen resultado que generes se convierte en un candidato a referencia para la siguiente generación.
Los profesionales que obtienen resultados siempre excelentes con los generadores de IA no usan mejores prompts. Gestionan mejor sus referencias. Una biblioteca bien organizada de referencias de alta calidad vale más que cualquier fórmula de prompt.
Trabajar con el entrenamiento de LoRA a gran escala
Para proyectos que exigen una coherencia absoluta en decenas o cientos de imágenes, el entrenamiento de LoRA es el camino más fiable. P Image Trainer en PicassoIA te guía por el proceso sin necesidad de ninguna configuración local ni inversión en hardware.
La calidad de tus datos de entrenamiento lo determina todo. Usa de 15 a 25 imágenes de tu sujeto con:
- Condiciones de iluminación variadas (luz frontal, luz lateral, contraluz)
- Varios ángulos (frontal, tres cuartos, perfil)
- Fondos limpios en al menos la mitad de las imágenes
- Encuadre coherente del sujeto (sin rostros parciales ni extremidades recortadas)
Un conjunto de entrenamiento bien preparado produce un LoRA que mantiene la identidad del sujeto de forma fiable en cualquier prompt, escena o estilo que apliques. Un conjunto mal preparado, con imágenes borrosas o encuadres irregulares, desperdicia créditos y produce resultados inestables.
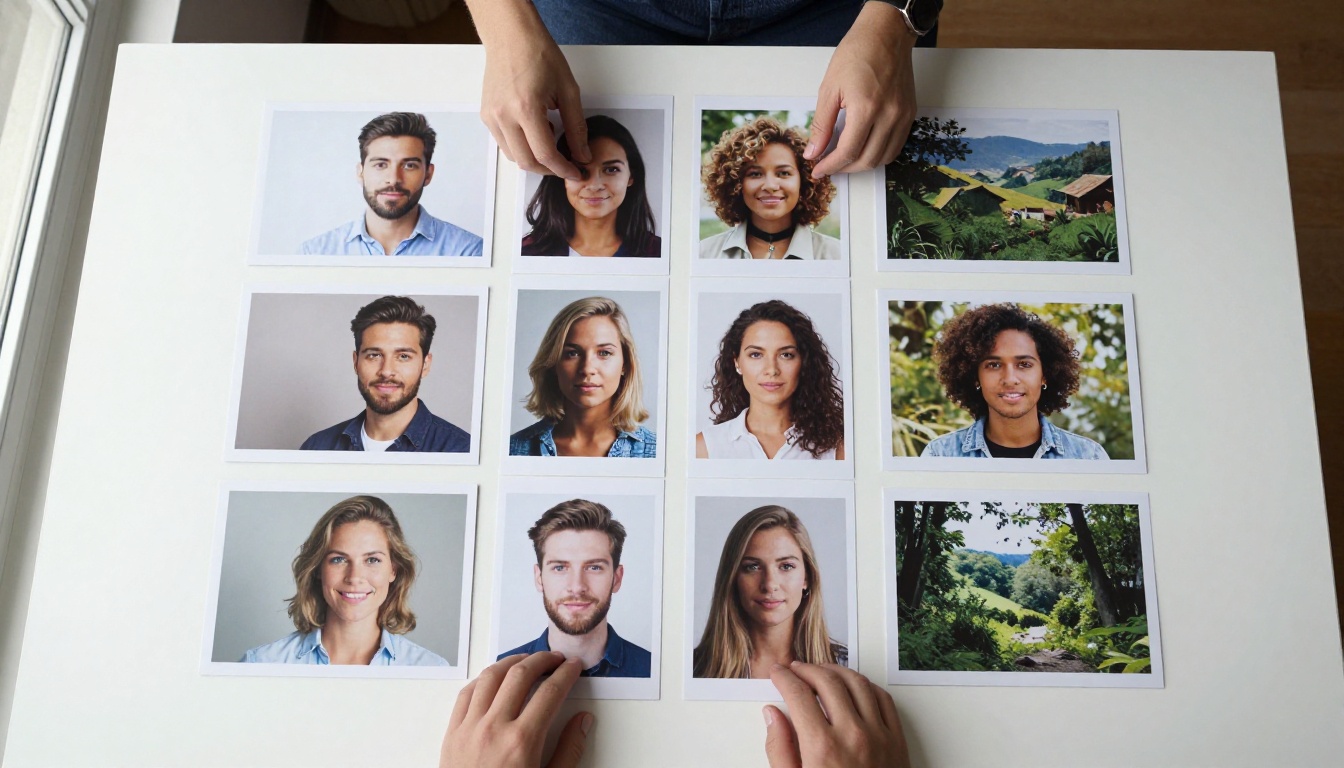
💡 Consejo sobre LoRA: Etiqueta cada imagen de entrenamiento con una palabra desencadenante coherente (por ejemplo, "TOK person") y describe la escena con claridad. Esto enseña al modelo a activar la identidad concreta cuando ve esa palabra en tus prompts, lo que te da un control preciso de encendido y apagado sobre cuándo se aplica la influencia del LoRA.
Una vez entrenado tu LoRA, combínalo con P Image Edit LoRA para el flujo de edición más controlado de la plataforma. Puedes aplicar el LoRA a imágenes nuevas, usarlo con inpainting o mezclarlo con otros modelos para resultados híbridos creativos.
Empieza a crear con referencias visuales ahora
Las imágenes de referencia no son un atajo ni un truco avanzado. Son el flujo de trabajo estándar para cualquiera que necesite resultados predecibles y profesionales de la generación con IA. Tanto si estás construyendo la identidad de una marca, creando un personaje de ficción o manteniendo un estilo visual concreto a lo largo de un proyecto, las herramientas de PicassoIA te dan control total sobre aquello a lo que la IA se ancla.
Empieza con Flux Redux Dev para obtener variaciones inmediatas de imagen a partir de una sola referencia. Prueba PicassoIA Image Editor Pro para un control granular con ControlNet e inpainting. Cuando necesites la máxima coherencia en un proyecto completo, entrena tu LoRA con P Image Trainer y pasa todas tus generaciones por P Image Edit LoRA.
Explora todos los modelos disponibles en picassoia.com/en/all-models y encuentra la herramienta de imágenes de referencia adecuada para tu próximo proyecto.


