रेफ़रेंस इमेज सब कुछ बदल देती हैं। जब आप अकेले प्रॉम्प्ट लिखते हैं, तो AI रंग, रोशनी, पोज़, कपड़े, चेहरे की बनावट और मूड के बारे में सैकड़ों छोटे फ़ैसले लेता है। अब उसे एक रेफ़रेंस इमेज दीजिए, और अचानक वे फ़ैसले किसी असली चीज़ से जुड़ जाते हैं। नतीजा अनुमान लगाने लायक, एक-जैसा और असल में आपकी सोच के काफ़ी करीब हो जाता है।
यह मामला शब्दों में इमेज का वर्णन करने का नहीं है। यह AI को सीधे दिखाने का है कि आपको क्या चाहिए, और मॉडल को उसका अनुवाद करने देना। यह असल में कैसे काम करता है, आइए देखते हैं।
रेफ़रेंस इमेज असल में क्या करती हैं
ज़्यादातर लोग AI जनरेटर को टेक्स्ट-टू-इमेज मशीन समझते हैं। प्रॉम्प्ट डालिए, इमेज मिल जाएगी। लेकिन आज के सबसे सक्षम मॉडल मल्टीमॉडल हैं: वे इनपुट के रूप में टेक्स्ट और इमेज दोनों स्वीकार करते हैं, और इमेज इनपुट में वह जानकारी होती है जिसे कितना भी लंबा टेक्स्ट पूरी तरह नहीं पहुँचा सकता।
जब आप रेफ़रेंस इमेज देते हैं, तो आप मॉडल को एक विज़ुअल एंकर दे रहे होते हैं। टूल और उसके इस्तेमाल के तरीके के आधार पर यह एंकर इन चीज़ों को लॉक कर सकता है:
- स्टाइल: समग्र सौंदर्य, कलर ग्रेडिंग, ब्रश की बनावट या फ़ोटोग्राफ़िक लुक
- सब्जेक्ट: वह खास व्यक्ति, वस्तु या कैरेक्टर जिसे आप दोबारा बनवाना चाहते हैं
- कंपोज़िशन: फ़्रेम में तत्व कहाँ हैं, उनका सापेक्ष आकार
- रोशनी: रोशनी के स्रोतों की दिशा, कलर टेम्परेचर और तीव्रता
- पोज़ और स्ट्रक्चर: शरीर की स्थिति, चेहरे का कोण या स्थापत्य का लेआउट
मॉडल रेफ़रेंस को पिक्सेल-दर-पिक्सेल कॉपी नहीं करता। वह विज़ुअल जानकारी पढ़ता है और उसे आपके टेक्स्ट प्रॉम्प्ट के साथ एक शर्त के रूप में इस्तेमाल करता है। टेक्स्ट बताता है कि क्या बदलना है; रेफ़रेंस इमेज बताती है कि क्या बनाए रखना है।
स्टाइल बनाम सब्जेक्ट बनाम कंपोज़िशन
रेफ़रेंस इमेज इस्तेमाल करते समय ये तीनों तत्व बहुत अलग तरह से काम करते हैं। इस अंतर को समझने से आपके घंटों की नाकाम कोशिशें बच सकती हैं।
स्टाइल रेफ़रेंस तब सबसे अच्छा काम करते हैं जब रेफ़रेंस इमेज का मुख्य सब्जेक्ट आपके प्रॉम्प्ट जैसा ही हो। नाटकीय चियारोस्कुरो रोशनी वाली फ़ोटो देकर पोर्ट्रेट का प्रॉम्प्ट लिखें, और मॉडल वही रोशनी का तर्क उस नए चेहरे पर लागू करेगा जिसका आप वर्णन करते हैं।
सब्जेक्ट रेफ़रेंस में मॉडल को किसी खास पहचान की जानकारी निकालकर उसे ट्रांसफ़र करना होता है: चेहरा, पोशाक या कोई ब्रांडेड प्रोडक्ट। यह मुश्किल काम है। Flux Redux Dev जैसे मॉडल, जो सब्जेक्ट कंसिस्टेंसी में माहिर हैं, इसी इस्तेमाल के लिए बनाए गए हैं।
कंपोज़िशन रेफ़रेंस सबसे बारीक होते हैं। आप स्केच या मोटा लेआउट भी अपलोड कर सकते हैं, और मॉडल तत्वों को लगभग उन्हीं जगहों पर रखेगा। ControlNet इसी काम के लिए बनाया गया था, और कंपोज़िशन नियंत्रण के लिए यह आज भी सबसे सटीक टूल्स में से एक है।
अकेले प्रॉम्प्ट क्यों कम पड़ते हैं
"लाल ड्रेस में औरत, सिनेमैटिक लाइटिंग, 35mm फ़िल्म" जैसा प्रॉम्प्ट सुनने में खास लगता है। लेकिन इसमें AI को तय करना पड़ता है: कौन-सी औरत? लाल का कौन-सा शेड? किस फ़िल्म स्टॉक का कलर साइंस? रोशनी किस दिशा से आए?
इनमें से हर खुला फ़ैसला इस बात का मौका है कि आउटपुट आपकी चाही हुई इमेज से भटक जाए। रेफ़रेंस इमेज ये अंतर पाट देती हैं। जितना आप वर्णन करने के बजाय दिखा सकते हैं, अंतिम नतीजे पर आपका नियंत्रण उतना ही ज़्यादा होता है।
AI को रेफ़रेंस देने के 3 तरीके
हर AI टूल रेफ़रेंस इमेज को एक जैसे तरीके से नहीं संभालता। तीन अलग-अलग वर्कफ़्लो हैं, और हर एक अलग स्तर का नियंत्रण देता है।
इमेज-टू-इमेज (क्लासिक तरीका)
यह सबसे पुराना और सबसे आम तरीका है। आप एक इमेज अपलोड करते हैं और मॉडल उसका नया वर्ज़न बनाता है जो मोटे स्ट्रक्चर और पैलेट को बनाए रखता है। ज़्यादातर प्लेटफ़ॉर्म पर strength या denoising स्लाइडर मिलता है: ज़्यादा strength का मतलब ज़्यादा बदलाव, कम strength का मतलब आउटपुट रेफ़रेंस के ज़्यादा करीब रहेगा।
सबसे अच्छे उपयोग:
- मोटे स्केच को फोटोरियलिस्टिक रेंडर में बदलना
- फ़ोटो की कंपोज़िशन बनाए रखते हुए उसका स्टाइल बदलना
- मौजूदा एसेट के तेज़ वैरिएशन बनाना
इमेज-टू-इमेज की कमज़ोरी सब्जेक्ट की पहचान है। अगर आप किसी खास व्यक्ति की फ़ोटो अपलोड करते हैं, तो मॉडल उसका मोटा पोज़ और रोशनी बनाए रख सकता है, लेकिन चेहरा बदल सकता है। पहचान पर सख़्त नियंत्रण के लिए आपको कुछ ज़्यादा निशाना साधने वाला तरीका चाहिए।
IP-Adapter और Flux Redux
IP-Adapter (Image Prompt Adapter) एक ऐसी तकनीक है जो रेफ़रेंस इमेज का सिमैंटिक कंटेंट सीधे मॉडल की अटेंशन लेयर्स में डालती है। पिक्सेल स्ट्रक्चर पर कंडीशन करने के बजाय, यह इस पर कंडीशन करती है कि इमेज क्या दर्शाती है। इससे सब्जेक्ट कंसिस्टेंसी कहीं मज़बूत होती है।
Flux Redux Dev Flux आर्किटेक्चर में बनी एक मिलती-जुलती तकनीक इस्तेमाल करता है। आप एक सोर्स इमेज देते हैं और Flux Redux उसके स्टाइल और सब्जेक्ट की छाप निकालकर नए प्रॉम्प्ट पर लागू करता है। नतीजा: वही चेहरा, वही आर्ट स्टाइल, या वही प्रोडक्ट पूरी तरह अलग दृश्यों में दिखता है।
जब कंसिस्टेंसी रचनात्मक बदलाव से ज़्यादा ज़रूरी हो, तब यही तरीका इस्तेमाल करें।
गहरे स्टाइल लॉक के लिए LoRA ट्रेनिंग
जब इमेज-टू-इमेज और IP-Adapter, दोनों आपको ज़रूरी सटीकता नहीं देते, तब आप LoRA (Low-Rank Adaptation) ट्रेन करते हैं। LoRA एक छोटा मॉडल है जिसे आपके खास सब्जेक्ट, स्टाइल या प्रोडक्ट की 10-30 इमेज पर फ़ाइन-ट्यून किया जाता है। ट्रेन होने के बाद, उस LoRA से बनी हर इमेज उसी ट्रेनिंग डेटा से जुड़ी रहती है।
PicassoIA पर P Image Trainer लोकल GPU सेटअप के बिना यह काम आसान बना देता है। अपनी रेफ़रेंस इमेज अपलोड करें, कुछ पैरामीटर सेट करें, और एक ट्रेन्ड LoRA पाएँ जिसे किसी भी संगत मॉडल में इस्तेमाल किया जा सकता है।
ट्रेड-ऑफ़ यह है: LoRA ट्रेनिंग में पहले ज़्यादा समय और ज़्यादा इमेज लगती हैं। लेकिन लगातार चलने वाले प्रोजेक्ट में, जहाँ आपको बिल्कुल एक-जैसा लुक चाहिए, वहाँ यह निवेश तुरंत वसूल हो जाता है।
Flux Redux Dev रेफ़रेंस कैसे संभालता है
Flux Redux Dev अभी उपलब्ध रेफ़रेंस-आधारित जनरेशन के सबसे सीधे टूल्स में से एक है। इसे शुरुआत से ऐसे बनाया गया था कि यह एक सोर्स इमेज लेकर ऐसे वैरिएशन बनाए जो रेफ़रेंस के स्टाइल और कंटेंट, दोनों का सम्मान करें।
PicassoIA पर चरण-दर-चरण
- PicassoIA पर Flux Redux Dev खोलें
- इमेज इनपुट पैनल से अपनी रेफ़रेंस इमेज अपलोड करें
- वह प्रॉम्प्ट लिखें जो बताए कि आप क्या बदलना चाहते हैं (नई सेटिंग, रोशनी, पोशाक, दृश्य)
- रेफ़रेंस strength सेट करें। मज़बूत रेफ़रेंस के साथ थोड़ी रचनात्मक आज़ादी के लिए 0.75 से शुरू करें
- अपना आस्पेक्ट रेशियो और रिज़ॉल्यूशन चुनें
- पहला बैच जनरेट करें, फिर strength में बदलाव करने से पहले नतीजे देखें
मॉडल आपके रेफ़रेंस की मूल पहचान बनाए रखते हुए उसे आपके प्रॉम्प्ट के हिसाब से ढालेगा। सफ़ेद बैकग्राउंड पर खड़ा एक व्यक्ति जंगल में, सूर्यास्त के समय, या स्टूडियो की नाटकीय साइड लाइटिंग में वही व्यक्ति बन सकता है। चेहरे और पोशाक का एंकर वही रहता है; बाकी सब आपके प्रॉम्प्ट के साथ बदलता है।
strength की वे सेटिंग्स जो मायने रखती हैं
| Strength मान | यह क्या करता है |
|---|
| 0.3-0.5 | हल्का रेफ़रेंस प्रभाव, ज़्यादा रचनात्मक आज़ादी |
| 0.6-0.8 | संतुलित: मज़बूत कंसिस्टेंसी के साथ बदलाव की गुंजाइश |
| 0.85-1.0 | अधिकतम रेफ़रेंस लॉक, प्रॉम्प्ट का न्यूनतम प्रभाव |
ज़्यादातर प्रोफ़ेशनल वर्कफ़्लो आम तौर पर 0.65 और 0.8 के बीच रहते हैं। 0.5 से नीचे जाने पर अक्सर सब्जेक्ट की पहचान पूरी तरह खो जाती है। 0.9 से ऊपर जाने पर आउटपुट रेफ़रेंस को बहुत शाब्दिक रूप से कॉपी करता है, जिससे टेक्स्ट प्रॉम्प्ट की अहमियत सीमित हो जाती है।
एक-जैसे कैरेक्टर कैसे बनाएँ
AI इमेज जनरेशन में कैरेक्टर कंसिस्टेंसी सबसे ज़्यादा पूछी जाने वाली चुनौतियों में से एक है। अगर आप कहानी, प्रोडक्ट कैंपेन या सोशल मीडिया पर्सोना बना रहे हैं, तो आपको कई अलग-अलग दृश्यों में एक ही चेहरा और पोशाक चाहिए।
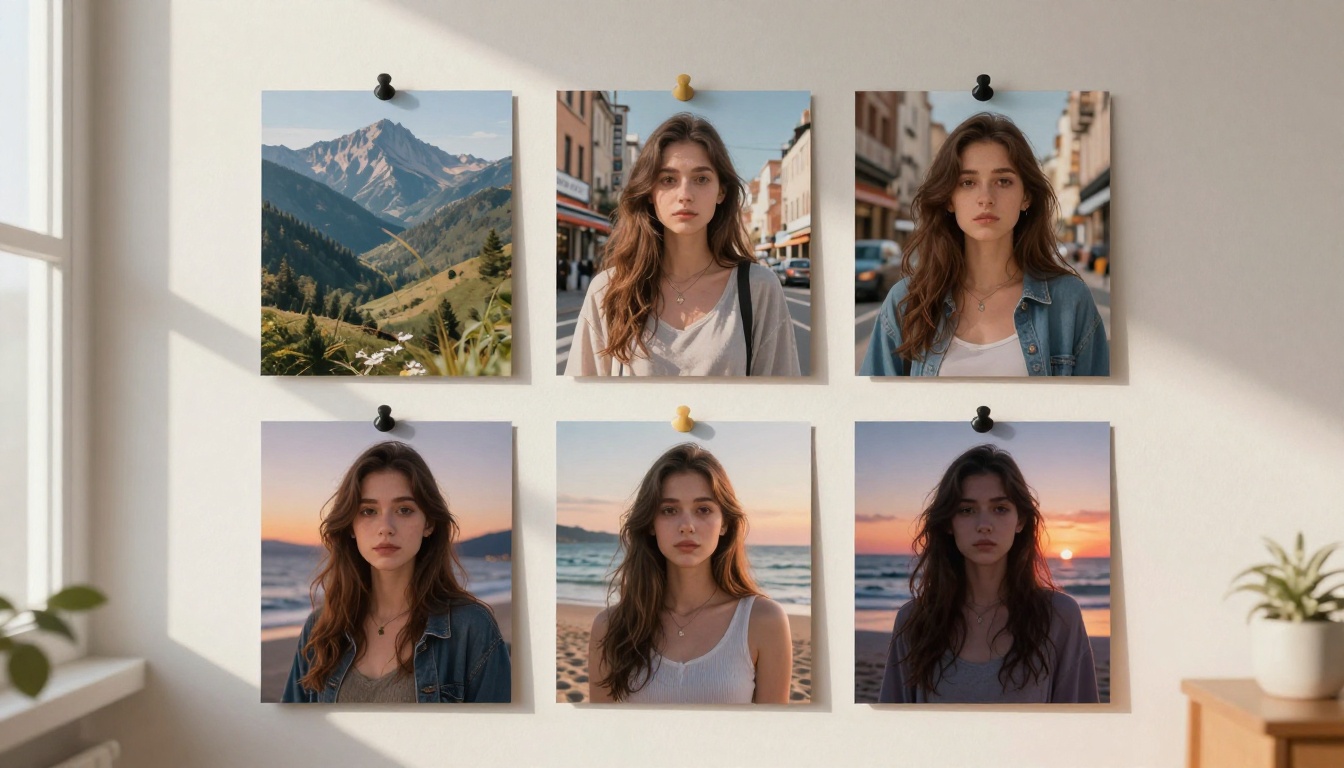
अलग-अलग दृश्यों में चेहरे की कंसिस्टेंसी
चेहरे की कंसिस्टेंसी के लिए सबसे तेज़ वर्कफ़्लो:
- अपने कैरेक्टर का एक साफ़, सामने से लिया गया पोर्ट्रेट मास्टर रेफ़रेंस के रूप में जनरेट करें
- इसे Flux Redux Dev या PicassoIA Image Editor Pro में 0.75 रेफ़रेंस strength के साथ डालें
- प्रॉम्प्ट में केवल दृश्य और रोशनी बदलें, कैरेक्टर का वर्णन वैसा ही रखें
- रेफ़रेंस को मज़बूत करने के लिए प्रॉम्प्ट में चेहरे के वर्णन के शब्द रखें: आँखों का रंग, बालों का स्टाइल, चेहरे की खास विशेषताएँ
रेफ़रेंस इमेज के साथ चेहरे का जितना एक-सा वर्णन टेक्स्ट में करेंगे, उतनी ज़्यादा स्थिर होगी पहचान जनरेशन के दौरान। टेक्स्ट और इमेज एक साथ काम करते हैं, एक-दूसरे की जगह नहीं लेते।
कपड़े और प्रॉप्स भी साथ चलते हैं
यही सिद्धांत चेहरे के अलावा बाकी तत्वों पर भी लागू होता है। अगर आपका कैरेक्टर हमेशा एक खास जैकेट पहनता है, तो उस जैकेट को अपनी मास्टर रेफ़रेंस इमेज में शामिल करें और प्रॉम्प्ट में उसका सटीक वर्णन करें। मॉडल रेफ़रेंस से कपड़े की बनावट और रंग बहुत असरदार तरीके से पढ़ते हैं, खासकर जब प्रॉम्प्ट उन विवरणों को मज़बूत करे।
जटिल ब्रांडेड प्रोडक्ट या अनोखी वस्तुओं के लिए, LoRA ट्रेनिंग हर बार IP-Adapter से बेहतर है। बारीक स्तर पर डिटेल बनाए रखना (सिलाई, हार्डवेयर, लोगो की जगह) एक ट्रेन्ड LoRA के साथ एक ही रेफ़रेंस इमेज की तुलना में काफ़ी बेहतर रहता है।
सब्जेक्ट खोए बिना स्टाइल ट्रांसफ़र
स्टाइल ट्रांसफ़र एक इमेज की विज़ुअल भाषा को दूसरी इमेज के कंटेंट पर लागू करने की कला है। किसी आधुनिक स्ट्रीट फ़ोटो पर फ़िल्म नोयर की रोशनी। डिजिटल पोर्ट्रेट पर गर्म एनालॉग टोन। सुनने में सरल लगता है, और सही तरीके से करने पर यह सच में सरल है।
40/60 ब्लेंड नियम
स्टाइल ट्रांसफ़र के लिए इमेज-टू-इमेज इस्तेमाल करते समय, स्टाइल के लिए लगभग 0.4 (40%) की reference strength रखें और 60% प्रॉम्प्ट को दें। इस संतुलन पर:
- रेफ़रेंस के प्रमुख रंग और टोनल कंट्रास्ट आउटपुट में दिखते हैं
- आपके प्रॉम्प्ट का सब्जेक्ट साफ़ पढ़ा जा सकता है और विकृत नहीं होता
- स्किन की बनावट और कपड़ों जैसे विवरण यथार्थवादी रहते हैं
स्टाइल ट्रांसफ़र के लिए reference strength 0.6 से ऊपर ले जाएँ, तो स्टाइल सब्जेक्ट को ढकने लगता है। जिस व्यक्ति या वस्तु को आप उस स्टाइल में रखना चाहते थे, उसकी स्पष्टता और पहचान वाला आकार कमज़ोर होने लगता है।
💡 टिप: स्टाइल रेफ़रेंस के लिए ऐसी इमेज चुनें जिसकी विज़ुअल भाषा बहुत साफ़ और मज़बूत हो। ज़्यादा स्टाइलाइज़्ड रेफ़रेंस, हल्के रेफ़रेंस से बेहतर संवाद करता है। स्टाइल जितना अलग होगा, मॉडल उसे उतना ही भरोसेमंद तरीके से पढ़कर लागू करेगा।
ControlNet कब इस्तेमाल करें
जब आपकी मुख्य चिंता स्टाइल के बजाय पोज़ या कंपोज़िशन हो, तब ControlNet बेहतर विकल्प है। आप एज मैप, डेप्थ मैप या पोज़ स्केलेटन अपलोड करते हैं, और ControlNet AI के आउटपुट को उन स्ट्रक्चरल गाइड से बाँध देता है, जबकि बाकी सभी आयामों में वह आज़ादी से जनरेट करता है।
अगर आपको किसी नए दृश्य में एक खास शरीर का पोज़ हूबहू चाहिए, या किसी रेफ़रेंस फ़्लोर प्लान से कमरे का लेआउट मिलाना है, तो ControlNet सही टूल है। PicassoIA Image Editor Pro इसी तरह के स्ट्रक्चरल गाइडेंस के लिए ControlNet-संगत एडिटिंग देता है, साथ ही इनपेंटिंग और आउटपेंटिंग की क्षमताएँ भी।
आम गलतियाँ जो आपके नतीजे बिगाड़ देती हैं
टूल्स समझने के बाद अगला कदम उन पैटर्न से बचना है जो किसी भी मॉडल पर लगातार खराब आउटपुट देते हैं।
गलत रेफ़रेंस वेट
सबसे आम गलती: reference strength बहुत ज़्यादा या बहुत कम रखना। नए यूज़र अक्सर अति पर चले जाते हैं। वे उसे 1.0 पर रखते हैं, परफ़ेक्ट कॉपी की उम्मीद में, और उन्हें कुछ ऐसा मिलता है जो विकृत फ़िल्टर जैसा दिखता है। या वे 0.2 रखते हैं, हल्के प्रभाव की उम्मीद में, और रेफ़रेंस इमेज का कोई असर ही नहीं होता।
बीच से शुरू करें। 0.7 से शुरू करें, तीन जनरेशन चलाएँ, फिर जो दिखे उसके आधार पर छोटे-छोटे कदमों (0.05 से 0.1) में बदलाव करें। यह जाँच-परखकर चलने का तरीका अति पर अंदाज़े से चलने और यह सोचने से कहीं ज़्यादा कारगर है कि कुछ काम क्यों नहीं कर रहा।
बेमेल रोशनी और आस्पेक्ट रेशियो
आपकी रेफ़रेंस इमेज अपनी रोशनी को जनरेशन में ले जाती है। अगर आपकी रेफ़रेंस में तीखी साइड लाइटिंग है और आउटपुट में आपको सॉफ़्ट ब्यूटी लाइटिंग चाहिए, तो ये दोनों शर्तें आपस में टकराती हैं। मॉडल समझौता करने की कोशिश करता है और आपको दोनों में से कोई भी साफ़ नहीं मिलता।
या तो अपनी रेफ़रेंस इमेज की रोशनी का इरादा मिलाएँ, या अपने प्रॉम्प्ट में नई रोशनी को बहुत साफ़ शब्दों में बताएँ और रेफ़रेंस strength कम करें ताकि रोशनी की दिशा बदल सके।
आस्पेक्ट रेशियो का बेमेल विकृति पैदा करता है। हमेशा अपनी रेफ़रेंस इमेज को उसी रेशियो में मिलाएँ या क्रॉप करें जिसमें आप जनरेट कर रहे हैं। 9:16 के पोर्ट्रेट रेफ़रेंस को 16:9 जनरेशन में डालने से अनुपात अप्रत्याशित रूप से बिगड़ेगा और सब्जेक्ट मुड़े हुए दिखेंगे।
कम क्वालिटी के रेफ़रेंस इस्तेमाल करना
धुंधली, कम रिज़ॉल्यूशन वाली या बहुत ज़्यादा कंप्रेस्ड रेफ़रेंस इमेज आउटपुट की क्वालिटी घटाती हैं। पिक्सेलेटेड फ़ोटो से मॉडल साफ़ स्टाइल या सब्जेक्ट की जानकारी नहीं निकाल सकता। हमेशा अपनी रेफ़रेंस इमेज का सबसे अच्छा उपलब्ध वर्ज़न इस्तेमाल करें।
अगर आपके पास सिर्फ़ कम रिज़ॉल्यूशन वाली रेफ़रेंस है, तो उसे रेफ़रेंस के रूप में इस्तेमाल करने से पहले Wan 2.7 Image Pro या किसी सुपर-रेज़ोल्यूशन मॉडल से चलाकर डिटेल को शार्प कर लें।
PicassoIA पर रेफ़रेंस इमेज सपोर्ट करने वाले 5 मॉडल
सभी AI जनरेटर रेफ़रेंस इमेज को एक जैसे तरीके से नहीं संभालते। यहाँ PicassoIA पर रेफ़रेंस-आधारित काम के लिए पाँच सबसे मज़बूत विकल्प हैं, जिनमें से हर एक अलग इस्तेमाल के लिए उपयुक्त है।
Flux Redux Dev ज़्यादातर रेफ़रेंस इमेज वर्कफ़्लो का डिफ़ॉल्ट शुरुआती बिंदु है, क्योंकि यह एक ही इमेज इनपुट से स्टाइल और सब्जेक्ट दोनों संभालता है और इसके लिए किसी ट्रेनिंग की ज़रूरत नहीं होती। "मेरे पास एक रेफ़रेंस है" से "मेरे पास एक एक-सा आउटपुट है" तक पहुँचने का यह सबसे तेज़ रास्ता है।
PicassoIA Image Editor Pro जब आपको बारीक नियंत्रण चाहिए, तब यह पावर टूल है। इनपेंटिंग से आप इमेज के खास हिस्सों को ठीक या बदल सकते हैं, जबकि बाकी हिस्सा जस का तस रहता है। आउटपेंटिंग कैनवस को उसकी मूल सीमाओं से आगे बढ़ाती है। ControlNet पोज़ और कंपोज़िशन लॉक करता है। इन सबको मिलाकर, यह उपलब्ध सबसे बहुमुखी रेफ़रेंस-आधारित एडिटिंग प्लेटफ़ॉर्म बन जाता है।
P Image Trainer और P Image Edit LoRA मिलकर अधिकतम कंसिस्टेंसी के लिए दो-चरणीय वर्कफ़्लो बनाते हैं: पहले अपने रेफ़रेंस डेटासेट पर ट्रेन करें, फिर हर आउटपुट पर ट्रेन्ड LoRA लागू करके जनरेट करें।
Qwen Image Edit Plus सीधे एडिटिंग कामों के लिए है, जहाँ आपके पास मौजूदा इमेज है और आप उसके खास तत्वों में बदलाव करना चाहते हैं। यह आपकी अपलोड की गई फ़ोटो को रेफ़रेंस की तरह पढ़ता है और आपके टेक्स्ट निर्देशों के मुताबिक़ खास बदलाव करता है।
ऐसा रेफ़रेंस-आधारित वर्कफ़्लो बनाना जो बढ़ सके
एक बार मैकेनिक्स समझ आ जाएँ, तो आप हर जनरेशन पर अंदाज़ा लगाने के बजाय एक दोहराने लायक प्रक्रिया बना सकते हैं।
- प्रोजेक्ट की शुरुआत में ही अपनी मास्टर रेफ़रेंस चुनें। एक उच्च-गुणवत्ता वाली इमेज जो उस चीज़ को दर्शाए जिसे आप एंकर करना चाहते हैं।
- सही टूल चुनें, इस आधार पर कि कौन-सा तत्व सबसे ज़्यादा मायने रखता है: सब्जेक्ट पहचान (Flux Redux, LoRA), स्टाइल (इमेज-टू-इमेज), या स्ट्रक्चर (ControlNet)।
- 0.7 reference strength से शुरू करें और नतीजों के आधार पर समायोजित करें, अंदाज़े के आधार पर नहीं।
- टेक्स्ट प्रॉम्प्ट को रेफ़रेंस के अनुरूप रखें, ताकि वे उसका विरोध करने के बजाय उसे मज़बूत करें।
- समय के साथ रेफ़रेंस लाइब्रेरी बनाएँ। हर अच्छा आउटपुट अगली जनरेशन के लिए एक रेफ़रेंस उम्मीदवार बन जाता है।
जो प्रोफ़ेशनल AI जनरेटर से लगातार बेहतरीन नतीजे पाते हैं, वे बेहतर प्रॉम्प्ट इस्तेमाल नहीं करते। वे बेहतर रेफ़रेंस मैनेजमेंट करते हैं। उच्च-गुणवत्ता वाले रेफ़रेंस की व्यवस्थित लाइब्रेरी किसी भी प्रॉम्प्ट फ़ॉर्मूले से ज़्यादा कीमती है।
बड़े पैमाने पर LoRA ट्रेनिंग के साथ काम
उन प्रोजेक्ट्स के लिए जिन्हें दर्जनों या सैकड़ों इमेज में पूरी तरह एक-सी कंसिस्टेंसी चाहिए, LoRA ट्रेनिंग सबसे भरोसेमंद रास्ता है। PicassoIA पर P Image Trainer बिना किसी लोकल सेटअप या हार्डवेयर निवेश के पूरी प्रक्रिया में आपका मार्गदर्शन करता है।
ट्रेनिंग डेटा की क्वालिटी ही सब कुछ तय करती है। अपने सब्जेक्ट की 15 से 25 इमेज लें, जिनमें ये चीज़ें हों:
- अलग-अलग रोशनी (फ़्रंट लाइट, साइड लाइट, रिम लाइट)
- कई कोण (सामने से, थ्री-क्वार्टर, प्रोफ़ाइल)
- कम से कम आधी इमेज में साफ़ बैकग्राउंड
- सब्जेक्ट का एक-सा फ़्रेमिंग (आधे चेहरे नहीं, कटे हुए अंग नहीं)
एक अच्छी तरह तैयार ट्रेनिंग सेट ऐसा LoRA बनाता है जो आपके लागू किए गए किसी भी प्रॉम्प्ट, दृश्य या स्टाइल में सब्जेक्ट की पहचान भरोसे से बनाए रखता है। कमज़ोर तरीके से तैयार सेट, जिसमें धुंधली इमेज या असंगत फ़्रेमिंग हो, क्रेडिट बर्बाद करता है और अस्थिर नतीजे देता है।
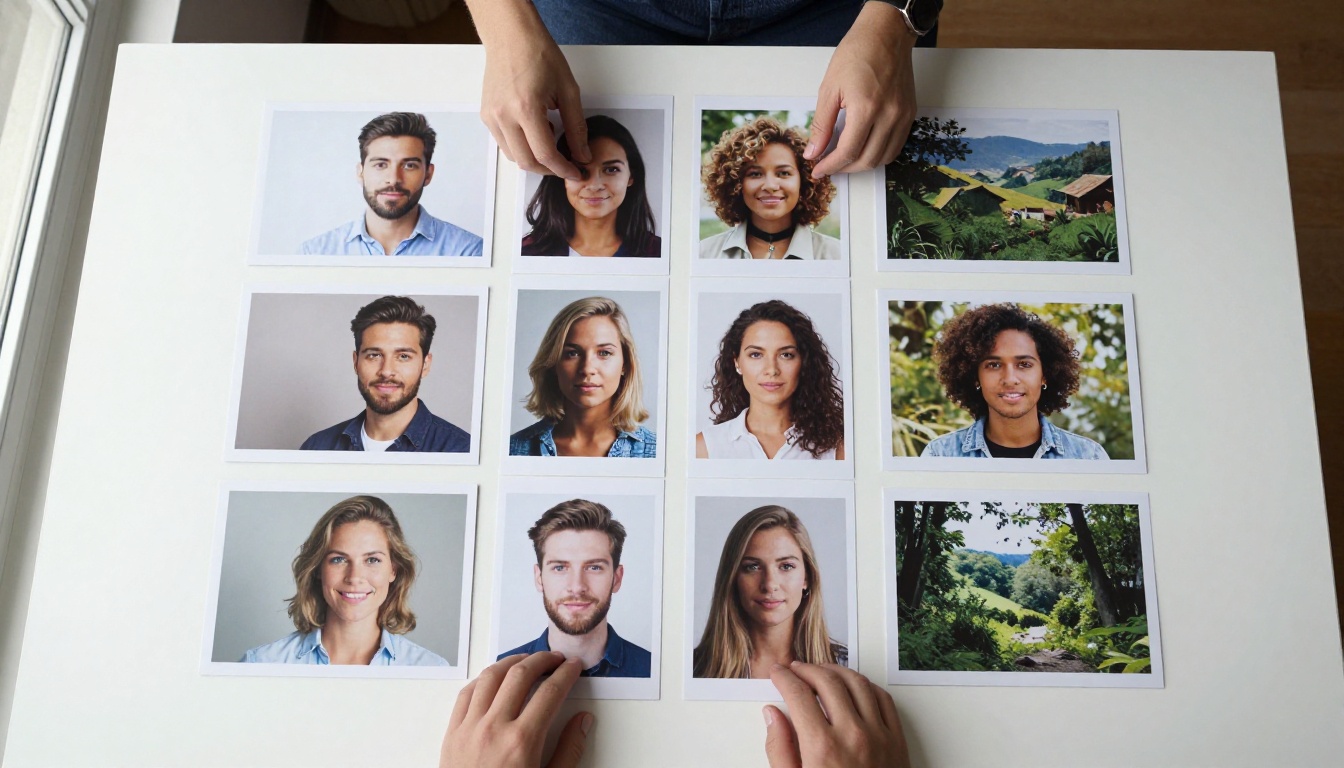
💡 LoRA टिप: हर ट्रेनिंग इमेज को एक एक-सा ट्रिगर शब्द (जैसे, "TOK person") देकर कैप्शन दें और दृश्य को साफ़ शब्दों में बताएँ। इससे मॉडल सीखता है कि जब वह प्रॉम्प्ट में वह शब्द देखे, तो वह खास पहचान सक्रिय हो, जिससे आपको यह सटीक नियंत्रण मिलता है कि LoRA का प्रभाव कब चालू हो।
एक बार आपका LoRA ट्रेन हो जाए, तो प्लेटफ़ॉर्म पर सबसे नियंत्रित एडिटिंग वर्कफ़्लो के लिए इसे P Image Edit LoRA के साथ जोड़ें। आप LoRA को नई इमेज पर लागू कर सकते हैं, इनपेंटिंग के साथ इस्तेमाल कर सकते हैं, या हाइब्रिड आउटपुट के लिए दूसरे मॉडल के साथ मिला सकते हैं।
अभी विज़ुअल रेफ़रेंस के साथ बनाना शुरू करें
रेफ़रेंस इमेज कोई जुगाड़ या एडवांस्ड ट्रिक नहीं हैं। जिसे भी AI जनरेशन से अनुमान लगाने लायक, प्रोफ़ेशनल नतीजे चाहिए, उसके लिए ये स्टैंडर्ड वर्कफ़्लो हैं। चाहे आप ब्रांड पहचान बना रहे हों, काल्पनिक कैरेक्टर गढ़ रहे हों, या पूरे प्रोजेक्ट में एक खास विज़ुअल स्टाइल मिला रहे हों, PicassoIA के टूल्स आपको यह पूरा नियंत्रण देते हैं कि AI किस चीज़ से एंकर हो।
एक ही रेफ़रेंस से तुरंत इमेज वैरिएशन के लिए Flux Redux Dev से शुरू करें। ControlNet और इनपेंटिंग के साथ बारीक नियंत्रण के लिए PicassoIA Image Editor Pro आज़माएँ। जब पूरे प्रोजेक्ट में अधिकतम कंसिस्टेंसी चाहिए, तो P Image Trainer से अपना LoRA बनाएँ और अपनी सारी जनरेशन P Image Edit LoRA के ज़रिए चलाएँ।
सभी उपलब्ध मॉडल picassoia.com/en/all-models पर देखें और अपने अगले प्रोजेक्ट के लिए सही रेफ़रेंस-इमेज टूल चुनें।


