Les images de référence changent tout. Lorsque vous saisissez un prompt seul, l’IA prend des centaines de petites décisions sur la couleur, l’éclairage, la pose, les vêtements, la structure du visage et l’ambiance. Donnez-lui une image de référence et ces décisions s’ancrent soudain sur quelque chose de concret. Le résultat devient prévisible, cohérent et réellement proche de ce que vous aviez en tête.
Il ne s’agit pas de décrire une image avec des mots. Il s’agit de montrer à l’IA exactement ce que vous voulez et de laisser le modèle faire la traduction. Voici comment cela fonctionne concrètement.
Ce que font réellement les images de référence
La plupart des gens considèrent les générateurs d’IA comme des machines de texte vers image. Vous saisissez un prompt, vous obtenez une image. Mais les modèles les plus performants aujourd’hui sont multimodaux : ils acceptent à la fois le texte et les images en entrée, et l’image transmet des informations qu’aucun texte ne peut entièrement rendre.
Lorsque vous fournissez une image de référence, vous donnez au modèle un repère visuel. Selon l’outil et la manière dont vous l’utilisez, ce repère peut verrouiller :
- Le style : l’esthétique générale, l’étalonnage des couleurs, la texture du pinceau ou le rendu photographique
- Le sujet : la personne, l’objet ou le personnage précis que vous voulez reproduire
- La composition : la place des éléments dans le cadre, leur échelle relative
- L’éclairage : la direction, la température de couleur et l’intensité des sources lumineuses
- La pose et la structure : la position du corps, l’angle du visage ou l’agencement architectural
Le modèle ne copie pas la référence pixel par pixel. Il lit les informations visuelles et les utilise comme condition en complément de votre prompt textuel. Le texte indique ce qu’il faut modifier ; l’image de référence indique ce qu’il faut conserver.
Style, sujet et composition
Ces trois éléments se comportent très différemment lorsque vous utilisez une image de référence. Comprendre la distinction vous fait gagner des heures d’essais infructueux.
Les références de style fonctionnent au mieux lorsque l’image de référence partage le même sujet général que votre prompt. Si vous fournissez une photo à l’éclairage clair-obscur spectaculaire et demandez un portrait, le modèle appliquera cette logique d’éclairage au nouveau visage que vous décrivez.
Les références de sujet exigent que le modèle extraie et transfère des informations d’identité précises : un visage, un costume, un produit de marque. C’est plus difficile. Les modèles spécialisés dans la cohérence des sujets, comme Flux Redux Dev, sont conçus spécifiquement pour ce cas d’usage.
Les références de composition sont les plus subtiles. Vous pouvez importer un croquis, voire une mise en page grossière, et le modèle placera les éléments à des positions similaires. ControlNet a été conçu précisément pour cela, et reste l’un des outils les plus précis pour contrôler la composition.
Pourquoi les prompts seuls ne suffisent pas
Un prompt tel que « femme en robe rouge, éclairage cinématographique, pellicule 35 mm » semble précis. Mais il laisse à l’IA le soin de choisir : quelle femme ? Quelle nuance de rouge ? Quelle colorimétrie de pellicule ? Dans quelle direction vient la lumière ?
Chacun de ces choix ouverts est une occasion pour le résultat de s’écarter de ce que vous vouliez. Les images de référence comblent ces vides. Plus vous montrez au lieu de décrire, plus vous contrôlez le résultat final.
3 façons de transmettre des références à l’IA
Tous les outils d’IA ne gèrent pas les images de référence de la même façon. Il existe trois flux de travail distincts, et chacun offre un niveau de contrôle différent.
Image vers image (le classique)
La méthode la plus ancienne et la plus universelle. Vous importez une image et le modèle génère une nouvelle version qui conserve la structure générale et la palette. La plupart des plateformes proposent un curseur de force ou de débruitage : une force élevée signifie plus de changements, une force faible garde le résultat plus proche de la référence.
Cas d’usage idéaux :
- Transformer un croquis grossier en rendu photoréaliste
- Changer le style d’une photo tout en gardant sa composition
- Créer des variations rapides d’un visuel existant
La faiblesse de l’image vers image concerne l’identité du sujet. Si vous importez la photo d’une personne précise, le modèle peut conserver sa pose approximative et son éclairage, mais modifier son visage. Pour un contrôle plus serré de l’identité, il faut un outil plus ciblé.
IP-Adapter et Flux Redux
IP-Adapter (Image Prompt Adapter) est une technique qui injecte le contenu sémantique de l’image de référence directement dans les couches d’attention du modèle. Au lieu de conditionner sur la structure des pixels, elle conditionne sur ce que représente l’image. On obtient ainsi une cohérence du sujet bien plus forte.
Flux Redux Dev repose sur une approche similaire intégrée à l’architecture Flux. Vous fournissez une image source, Flux Redux en extrait le style et l’empreinte du sujet, puis les applique à de nouveaux prompts. Le résultat : le même visage, le même style artistique ou le même produit, dans des scènes radicalement différentes.
C’est la méthode à privilégier lorsque la cohérence compte davantage que l’écart créatif.
Entraînement d’un LoRA pour un verrouillage stylistique poussé
Lorsque ni l’image vers image ni IP-Adapter ne vous donnent la précision voulue, vous entraînez un LoRA (Low-Rank Adaptation). Un LoRA est un petit modèle issu d’un fine-tuning sur 10 à 30 images de votre sujet, style ou produit précis. Une fois entraîné, chaque génération utilisant ce LoRA est ancrée sur ces données d’entraînement.
P Image Trainer sur PicassoIA rend cette démarche accessible sans configuration GPU locale. Importez vos images de référence, configurez quelques paramètres et obtenez un LoRA entraîné que vous pouvez utiliser dans tout modèle compatible.
Le compromis : l’entraînement d’un LoRA demande plus de temps et d’images en amont. Mais pour des projets au long cours où vous avez besoin d’un rendu parfaitement constant, l’investissement est rentabilisé immédiatement.
Flux Redux Dev est l’un des outils les plus directs pour la génération à partir de références disponibles actuellement. Il a été conçu dès le départ pour prendre une image source et créer des variations qui respectent à la fois le style et le contenu de la référence.
Pas à pas sur PicassoIA
- Ouvrez Flux Redux Dev sur PicassoIA
- Importez votre image de référence à l’aide du panneau d’entrée d’image
- Rédigez votre prompt en décrivant ce que vous voulez modifier (nouveau décor, éclairage, tenue, scène)
- Réglez la force de référence. Commencez à 0,75 pour une référence forte avec une certaine liberté créative
- Choisissez votre format et votre résolution
- Générez un premier lot, puis examinez-le avant d’ajuster la force
Le modèle conservera l’identité centrale de votre référence tout en s’adaptant à votre prompt. Un portrait de personne sur fond blanc uni peut devenir la même personne dans une forêt, au coucher du soleil ou sous un éclairage de studio dramatique et latéral. Le repère du visage et des vêtements reste ; tout le reste évolue selon votre prompt.
Les réglages de force qui comptent
| Valeur de force | Effet |
|---|
| 0,3-0,5 | Influence légère de la référence, plus de liberté créative |
| 0,6-0,8 | Équilibré : forte cohérence avec de la marge pour les changements |
| 0,85-1,0 | Verrouillage maximal de la référence, influence minimale du prompt |
La plupart des flux de travail professionnels se situent entre 0,65 et 0,8. En dessous de 0,5, vous perdez souvent complètement l’identité du sujet. Au-dessus de 0,9, le résultat copie la référence de façon trop littérale, ce qui limite l’intérêt du prompt textuel.
Obtenir des personnages cohérents
La cohérence des personnages est l’un des défis les plus souvent évoqués dans la génération d’images par IA. Si vous construisez une histoire, une campagne produit ou une persona sur les réseaux sociaux, vous avez besoin que le même visage et les mêmes vêtements apparaissent dans de nombreuses scènes différentes.
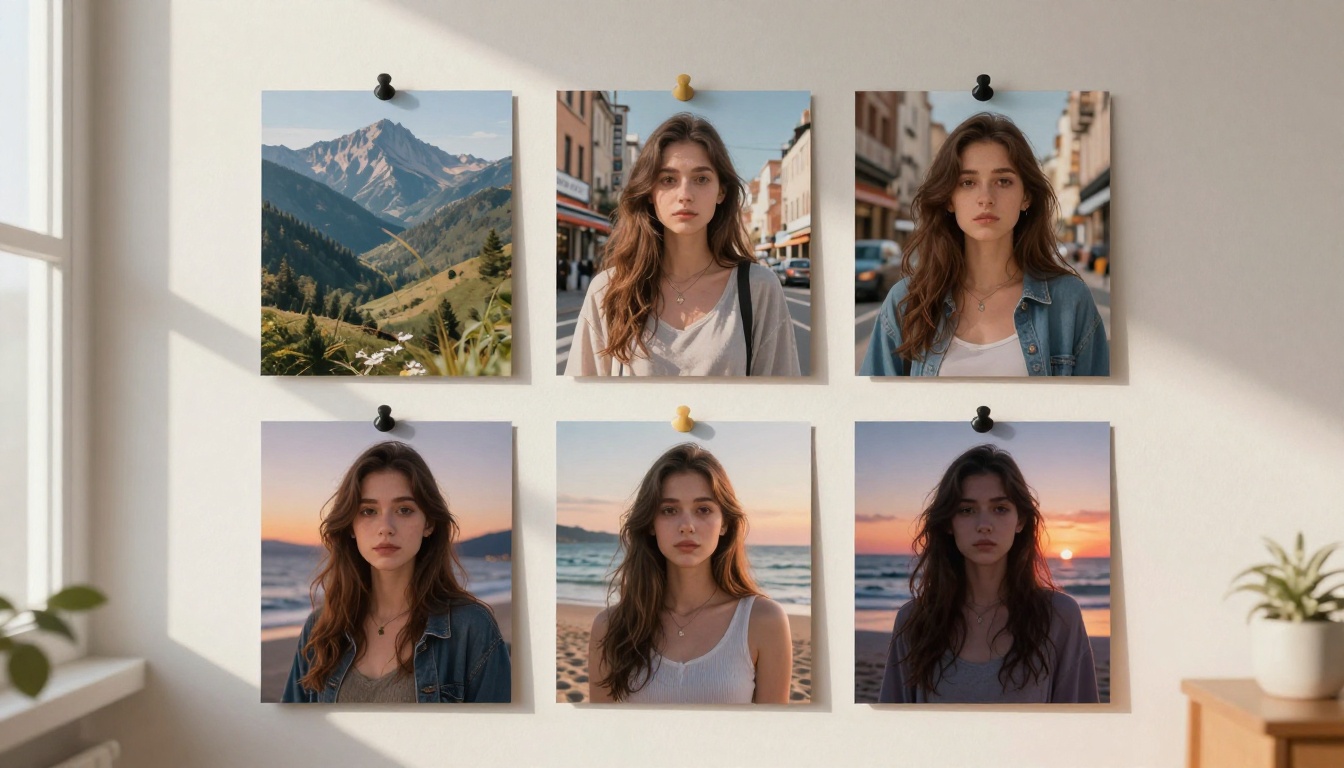
La cohérence du visage d’une scène à l’autre
Le flux de travail le plus rapide pour la cohérence du visage :
- Générez un portrait net, de face, de votre personnage comme référence principale
- Importez-le dans Flux Redux Dev ou PicassoIA Image Editor Pro avec une force de référence à 0,75
- Ne modifiez que le décor et l’éclairage dans votre prompt, et laissez la description du personnage inchangée
- Conservez dans le prompt les termes décrivant le visage pour renforcer la référence : couleur des yeux, coiffure, traits du visage précis
Plus vous décrivez le visage de manière constante par le texte, en complément de l’image de référence, plus l’identité reste stable d’une génération à l’autre. Texte et image travaillent ensemble, ils ne se remplacent pas.
Les vêtements et accessoires se transmettent d’une scène à l’autre
Le même principe s’applique aux éléments autres que le visage. Si votre personnage porte toujours une veste particulière, incluez-la dans votre image de référence principale et décrivez-la précisément dans votre prompt. Les modèles lisent très bien la texture et la couleur des vêtements à partir de la référence, surtout lorsque le prompt renforce ces détails.
Pour les produits de marque complexes ou les objets uniques, l’entraînement d’un LoRA l’emporte à chaque fois sur IP-Adapter. La restitution des détails fins (coutures, quincaillerie, placement du logo) est nettement meilleure avec un LoRA entraîné qu’avec une seule image de référence.
Transfert de style sans perdre son sujet
Le transfert de style consiste à appliquer le langage visuel d’une image au contenu d’une autre. Un éclairage film noir sur une photo de rue moderne. Des tons analogiques chauds sur un portrait numérique. Cela semble simple, et avec la bonne approche, ça l’est.
La règle du mélange 40/60
Lorsque vous utilisez l’image vers image pour un transfert de style, une force de référence d’environ 0,4 (40 %) pour le style, en laissant 60 % au prompt, donne les résultats les plus exploitables. À cet équilibre :
- Les couleurs dominantes et le contraste tonal de la référence apparaissent dans le résultat
- Le sujet de votre prompt reste clairement lisible et non déformé
- Les détails comme la texture de la peau et les vêtements restent réalistes
Au-delà de 0,6 de force de référence pour le transfert de style, le style commence à écraser le sujet. La personne ou l’objet que vous vouliez placer dans ce style perd peu à peu sa netteté et sa forme reconnaissable.
💡 Astuce : pour les références de style, utilisez des images au langage visuel très net et affirmé. Une référence fortement stylisée se fait mieux comprendre qu’une référence subtile. Plus le style est distinct, plus le modèle le lit et l’applique de façon fiable.
Quand utiliser ControlNet à la place
ControlNet est le meilleur choix lorsque votre préoccupation principale est la pose ou la composition plutôt que le style. Vous importez une carte des contours, une carte de profondeur ou un squelette de pose, et ControlNet verrouille le résultat de l’IA sur ces guides structurels tout en générant librement dans toutes les autres dimensions.
Si vous avez besoin d’une pose corporelle précise reproduite à l’identique dans une nouvelle scène, ou si vous voulez faire correspondre l’agencement d’une pièce à partir d’un plan de référence, ControlNet est l’outil adapté. PicassoIA Image Editor Pro intègre une édition compatible ControlNet pour ce type de guidage structurel, ainsi que des capacités d’inpainting et d’outpainting.
Les erreurs courantes qui ruinent vos résultats
Une fois les outils compris, l’étape suivante consiste à éviter les schémas qui produisent systématiquement de mauvais résultats, quel que soit le modèle utilisé.
Mauvais poids de la référence
L’erreur la plus fréquente : une force de référence trop élevée ou trop basse. Les nouveaux utilisateurs ont tendance à aller aux extrêmes. Ils la règlent à 1,0 en espérant une copie parfaite, et obtiennent quelque chose qui ressemble à un filtre déformé. Ou ils la règlent à 0,2 dans l’espoir d’une influence subtile, et l’image de référence n’a alors aucun effet.
Partez du milieu. Commencez à 0,7, lancez trois générations, puis ajustez par petits paliers (0,05 à 0,1) selon ce que vous voyez. Cette démarche de diagnostic est bien plus efficace que de deviner aux extrêmes en se demandant pourquoi rien ne fonctionne.
Éclairage et format incohérents
Votre image de référence transmet son éclairage à la génération. Si votre référence présente une lumière latérale dure et que vous voulez un éclairage beauté doux dans le résultat, ces deux conditions se contrarient. Le modèle tente un compromis, et vous n’obtenez clairement ni l’un ni l’autre.
Soit vous faites correspondre l’intention d’éclairage de votre image de référence, soit vous décrivez très explicitement le nouvel éclairage dans votre prompt et vous baissez la force de référence pour laisser la direction de la lumière évoluer.
Les incohérences de format provoquent des déformations. Faites toujours correspondre ou recadrez votre image de référence au même format que celui de votre génération. Importer un portrait de référence en 9:16 dans une génération en 16:9 déformera les proportions de façon imprévisible et produira des sujets distordus.
Utiliser des références de faible qualité
Les images de référence floues, de faible résolution ou fortement compressées dégradent la qualité du résultat. Le modèle ne peut pas extraire de style ou d’information de sujet nets à partir d’une photo pixélisée. Utilisez toujours la version de la meilleure qualité disponible de votre image de référence.
Si votre seule référence est de faible résolution, passez-la d’abord dans Wan 2.7 Image Pro ou dans un modèle de super-résolution pour restaurer les détails avant de l’utiliser comme référence.
5 modèles qui prennent en charge les images de référence sur PicassoIA
Tous les générateurs d’IA ne gèrent pas les images de référence de la même façon. Voici cinq des options les plus performantes sur PicassoIA pour les travaux à partir de références, chacune adaptée à un cas d’usage différent.
Flux Redux Dev est le point de départ par défaut pour la plupart des flux de travail à partir d’images de référence, car il gère à la fois le style et le sujet avec une seule entrée d’image, sans entraînement requis. C’est le chemin le plus rapide entre « j’ai une référence » et « j’obtiens un résultat cohérent ».
PicassoIA Image Editor Pro est l’outil puissant à utiliser lorsque vous avez besoin d’un contrôle fin. L’inpainting permet de corriger ou de remplacer des zones précises d’une image tout en conservant le reste intact. L’outpainting étend le cadre au-delà de ses bords d’origine. ControlNet verrouille la pose et la composition. Ensemble, ces fonctions en font la plateforme d’édition à partir de références la plus polyvalente disponible.
P Image Trainer et P Image Edit LoRA forment un flux de travail en deux étapes pour une cohérence maximale : entraînez d’abord sur votre jeu de données de référence, puis générez avec le LoRA entraîné appliqué à chaque résultat.
Qwen Image Edit Plus gère les tâches d’édition directe lorsque vous disposez d’une image existante et souhaitez modifier des éléments précis. Il lit votre photo importée comme référence et applique vos instructions textuelles à des modifications ciblées.
Construire un flux de travail à partir de références, qui passe à l’échelle
Une fois les mécanismes compris, vous pouvez construire un processus reproductible au lieu de deviner à chaque génération.
- Choisissez tôt votre référence principale dans le projet. Une seule image de haute qualité qui représente ce que vous voulez ancrer.
- Sélectionnez le bon outil selon l’élément le plus important : identité du sujet (Flux Redux, LoRA), style (image vers image) ou structure (ControlNet).
- Commencez à 0,7 de force de référence et ajustez selon les résultats, pas selon l’intuition.
- Gardez des prompts textuels cohérents avec la référence pour la renforcer plutôt que la contredire.
- Constituez une bibliothèque de références au fil du temps. Chaque bon résultat généré devient un candidat de référence pour la génération suivante.
Les professionnels qui obtiennent régulièrement d’excellents résultats avec les générateurs d’IA n’utilisent pas de meilleurs prompts. Ils gèrent mieux leurs références. Une bibliothèque de références de haute qualité, bien organisée, vaut plus que n’importe quelle formule de prompt.
Travailler avec l’entraînement de LoRA à grande échelle
Pour les projets qui exigent une cohérence absolue sur des dizaines, voire des centaines d’images, l’entraînement d’un LoRA est la voie la plus fiable. Le P Image Trainer sur PicassoIA vous guide dans la démarche, sans configuration locale ni investissement matériel.
La qualité de vos données d’entraînement détermine tout. Utilisez 15 à 25 images de votre sujet avec :
- Des conditions d’éclairage variées (lumière frontale, lumière latérale, contre-jour)
- Plusieurs angles (de face, trois quarts, profil)
- Des fonds épurés sur au moins la moitié des images
- Un cadrage cohérent du sujet (ni visages partiels, ni membres coupés)
Un jeu d’entraînement bien préparé produit un LoRA qui conserve l’identité du sujet de façon fiable, quels que soient le prompt, la scène ou le style appliqué. Un jeu mal préparé, avec des images floues ou un cadrage incohérent, gaspille des crédits et produit des résultats instables.
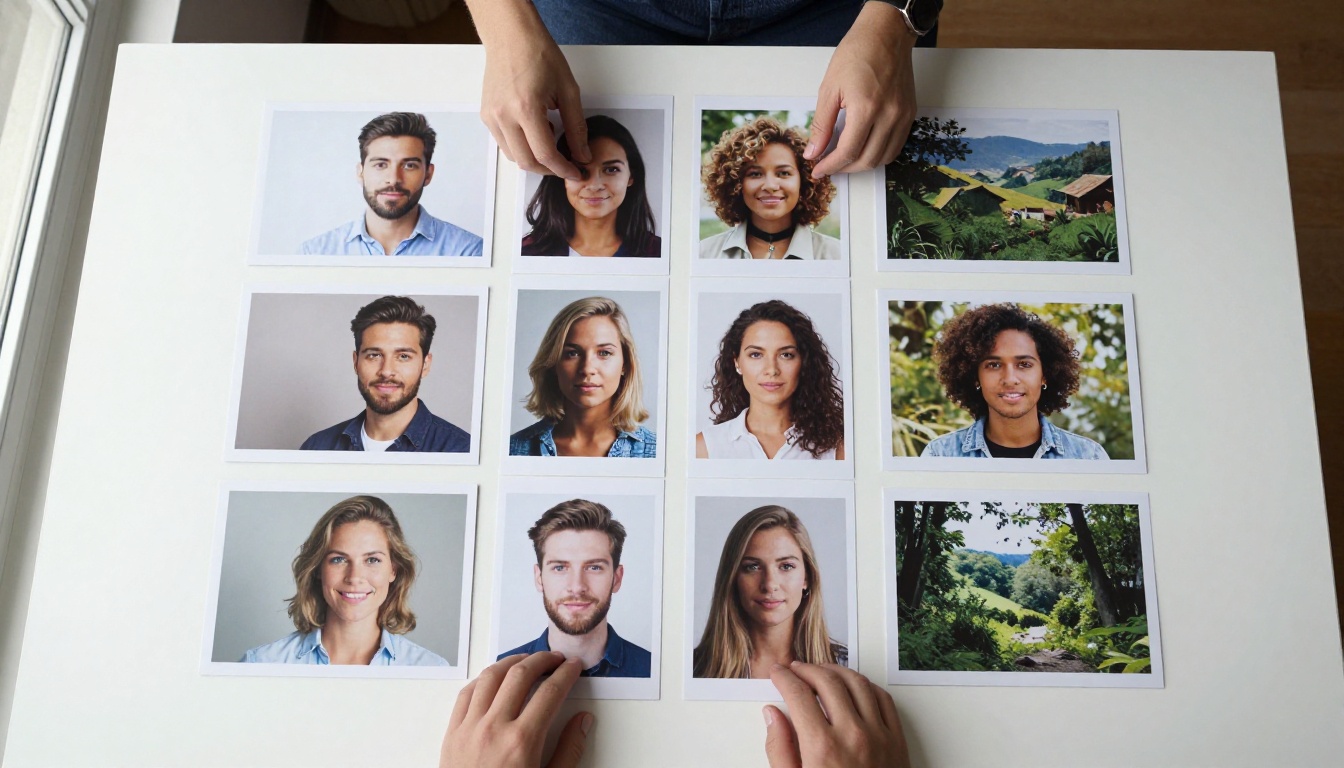
💡 Astuce LoRA : légendez chaque image d’entraînement avec un mot déclencheur constant (par exemple « TOK person ») et décrivez clairement la scène. Cela apprend au modèle à activer l’identité précise lorsqu’il rencontre ce mot dans vos prompts, ce qui vous donne un contrôle précis sur le moment où l’influence du LoRA s’exerce.
Une fois votre LoRA entraîné, associez-le à P Image Edit LoRA pour le flux d’édition le plus maîtrisé de la plateforme. Vous pouvez appliquer le LoRA à de nouvelles images, l’utiliser avec l’inpainting ou le combiner à d’autres modèles pour des résultats hybrides et créatifs.
Commencez dès maintenant à créer avec des références visuelles
Les images de référence ne sont ni un contournement ni une astuce avancée. Elles constituent le flux de travail standard de quiconque a besoin de résultats prévisibles et professionnels avec la génération par IA. Qu’il s’agisse de construire une identité de marque, de créer un personnage fictif ou de faire correspondre un style visuel précis sur l’ensemble d’un projet, les outils de PicassoIA vous donnent un contrôle total sur ce à quoi l’IA s’ancre.
Commencez avec Flux Redux Dev pour obtenir immédiatement des variations d’image à partir d’une seule référence. Essayez PicassoIA Image Editor Pro pour un contrôle précis avec ControlNet et l’inpainting. Lorsque vous avez besoin d’une cohérence maximale sur un projet complet, construisez votre LoRA avec P Image Trainer et passez toutes vos générations par P Image Edit LoRA.
Parcourez tous les modèles disponibles sur picassoia.com/en/all-models et trouvez l’outil de génération à partir d’images de référence adapté à votre prochain projet.


