Escribir prompts para imagen a video no es lo mismo que escribir prompts para imagen. Las reglas son distintas, el vocabulario es distinto y, sobre todo, el modelo mental que necesitas es completamente otro. Un buen prompt de imagen fija describe un instante congelado. Un buen prompt de movimiento describe una secuencia de hechos que se desarrollan en el tiempo. Si envías tu mejor imagen a un modelo de video de IA y obtienes resultados rígidos, incorrectos o simplemente extraños, el problema casi seguro está en tu prompt.
Por qué el prompt lo es todo
Todos los modelos de imagen a video, desde Wan 2.7 I2V hasta Kling v3 Omni Video, funcionan interpretando dos entradas: tu fotograma inicial y tus instrucciones de movimiento. El modelo lee la imagen para obtener el contexto de la escena, la iluminación, el sujeto, las pistas de profundidad y la paleta de color. Después lee tu prompt para saber qué hacer con todo eso durante los siguientes cinco segundos.
Si tu prompt es vago, el modelo adivina. A veces acierta. Muchas veces no. Si tu prompt es preciso y centrado en el movimiento, el modelo ejecuta. Esa es toda la diferencia entre un clip que enseñarías a alguien y uno que borrarías.
Por eso no puedes copiar y pegar un prompt de imagen generativa en Seedance 2.0 y esperar resultados cinematográficos. Los prompts de imagen están optimizados para la composición estática. Los prompts de video requieren pensamiento temporal.
Pensamiento estático frente a pensamiento de movimiento
Un prompt estático responde a una pregunta: ¿cómo se ve esto? Un prompt de movimiento responde a otra: ¿qué ocurre aquí, en qué orden y desde qué posición de cámara?
Esta es una comparación directa:
| Prompt estático | Prompt de movimiento |
|---|
| "Mujer sentada junto a la ventana de una cafetería, luz de la mañana" | "La mujer levanta su taza de café despacio, mira hacia la izquierda por la ventana, la luz suave recorre su rostro mientras pasan las nubes" |
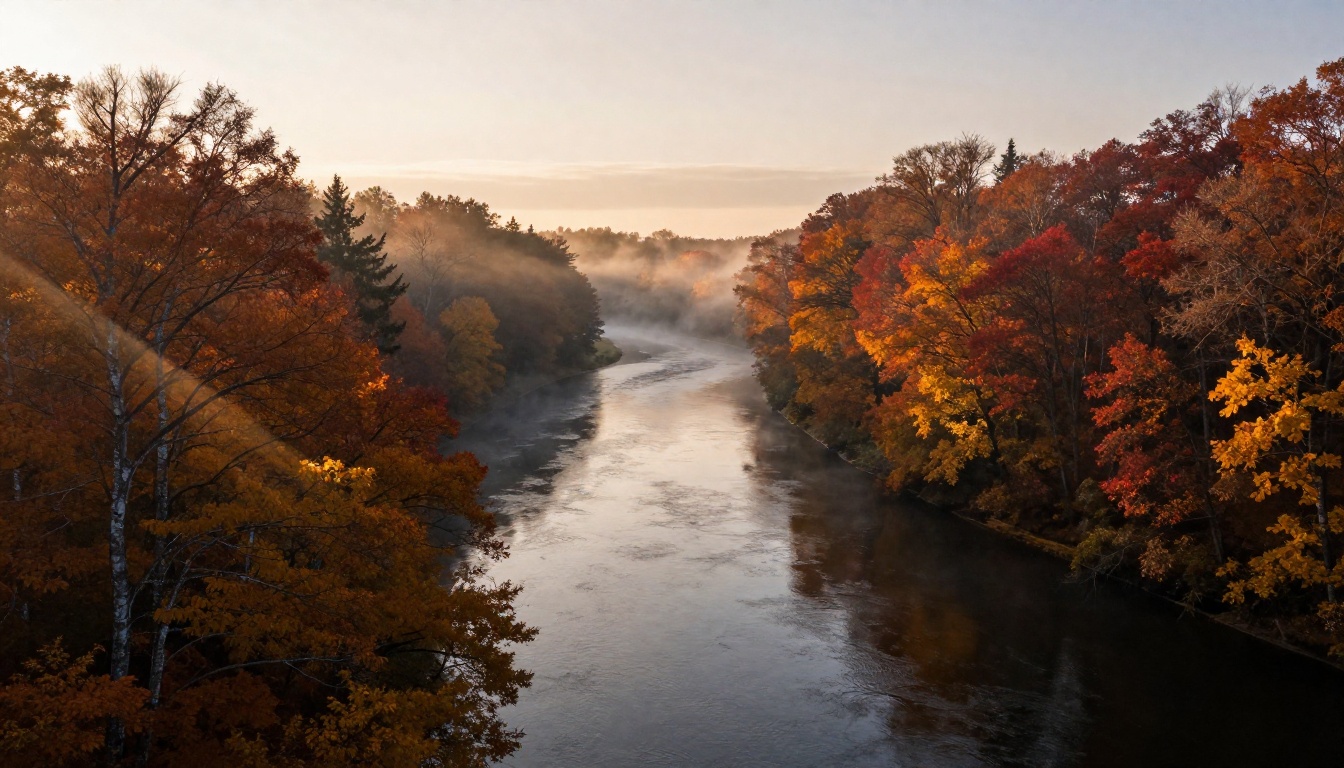
| "Río en el bosque al atardecer dorado" | "La cámara avanza suavemente y a baja altura sobre la superficie del agua, la neblina se aparta de las rocas mientras la corriente avanza" |
| "Hombre caminando bajo la lluvia" | "El hombre avanza de izquierda a derecha sobre adoquines mojados, los charcos se ondulan con cada paso, la cámara lo sigue a media distancia" |
Cada prompt de movimiento describe hechos en el tiempo. Hay un sujeto, un verbo y un contexto que explica cómo cambia la escena. Esa estructura es la que los modelos de video están diseñados para leer.
Lo que el modelo realmente lee
Los modelos de video de IA dan peso a los distintos elementos del prompt siguiendo un orden de prioridad aproximado. El movimiento del sujeto ocupa el primer lugar. El movimiento de cámara, el segundo. Los detalles de atmósfera y textura van al final. Si empiezas tu prompt con descripciones de la escena y dejas el movimiento para el final, el modelo puede producir un clip visualmente preciso pero casi estático.
💡 Regla: Lo que se mueve va primero. La acción del sujeto en la primera frase. El movimiento de cámara en la segunda. La iluminación y la atmósfera, al final.
La anatomía de un buen prompt de movimiento
Todo prompt de imagen a video de alto rendimiento contiene tres elementos estructurales. Si falta uno, obtendrás resultados irregulares entre generaciones.
Primero el sujeto, después la acción
El sujeto es el elemento principal de tu imagen. La acción es lo que ese sujeto hace durante el clip. Ambos deben ser específicos y concretos.
Débil: "Una mujer en una cafetería"
Fuerte: "Una mujer levanta su taza de espresso con ambas manos, el vapor se curva hacia arriba con la luz de la mañana"
El verbo es donde vive la animación. "Levanta", "gira", "mira de reojo", "sonríe", "camina", "inclina" le dan al modelo algo concreto que ejecutar. Los verbos abstractos como "siente" o "experimenta" no producen nada útil, porque no tienen un equivalente físico que el modelo pueda representar como movimiento a lo largo de los fotogramas.
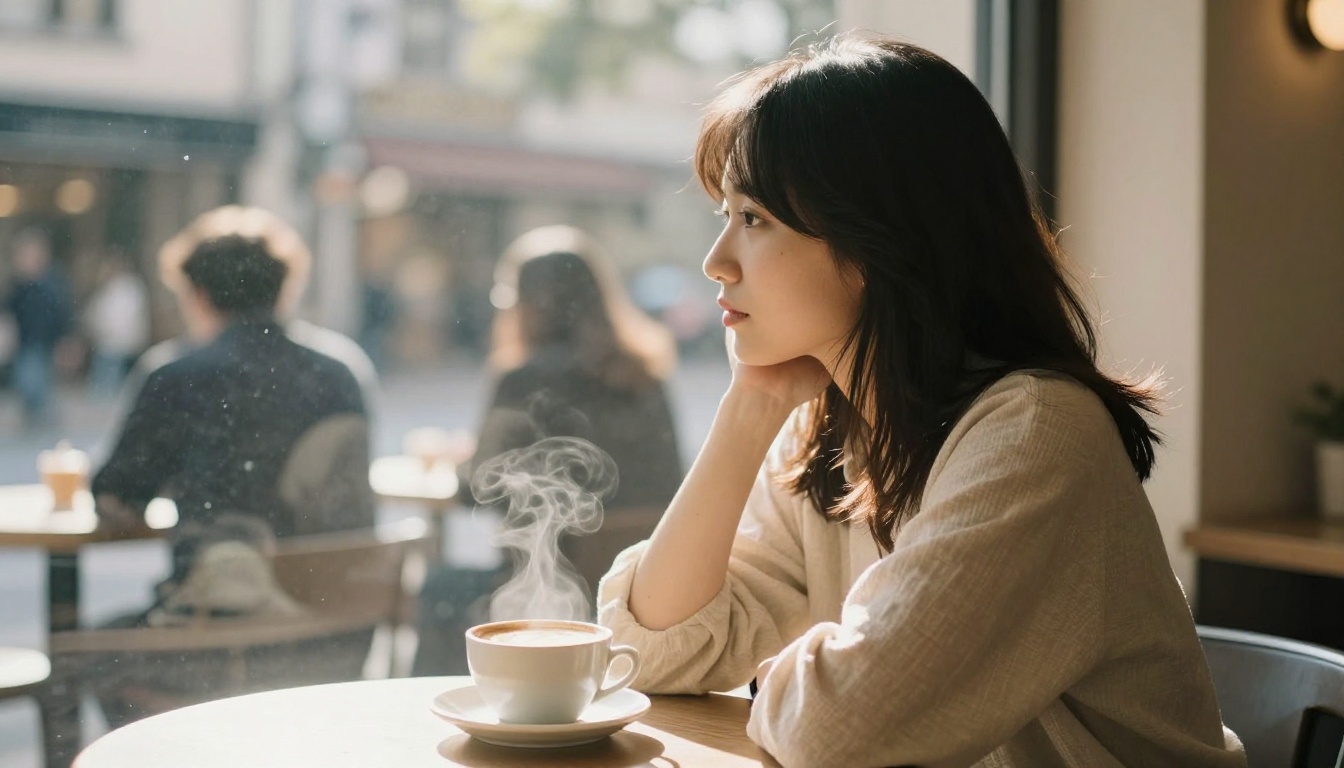
Modelos como Wan 2.6 I2V y Kling v2.6 Motion Control responden especialmente bien a la formulación precisa de la acción del sujeto. Cuanto más detallada sea la descripción de la acción, con más fidelidad podrá el modelo ejecutarla durante toda la duración del clip.
El papel del movimiento de cámara
El movimiento de cámara es el elemento más desaprovechado en los prompts de movimiento de aficionados. También es el que con más fiabilidad convierte un clip correcto en uno cinematográfico.
| Dirección de cámara | Qué produce |
|---|
| Dolly lento hacia delante | Intimidad, atrae la atención hacia el sujeto |
| Panorámica suave a la izquierda o a la derecha | Revela el entorno, genera sensación de viaje |
| Subida desde un ángulo bajo | Dramatismo, el sujeto parece dominante en el encuadre |
| Descenso aéreo | Sensación de llegada, establece escala y lugar |
| Estática, bloqueada | Todo el énfasis en el movimiento del sujeto, deliberado y contenido |
| Deriva suave a mano alzada | Realismo orgánico, calidad documental |
| Zoom out lento | Expansión del contexto, revela la escala progresivamente |
| Órbita de 360 grados | Enfoque en el producto, muestra todos los ángulos en secuencia |
💡 Elige un solo movimiento de cámara por clip y mantenlo. Mezclar dos movimientos de cámara en cinco segundos crea confusión visual, y los modelos rara vez los ejecutan bien los dos.
Gen4 Turbo y Kling v3 Motion Control responden muy bien a las indicaciones explícitas de cámara. Kling v3 Motion Control fue diseñado específicamente para seguir instrucciones de trayectoria de cámara, lo que lo hace valioso cuando el control espacial preciso es importante.
Pistas de tiempo y velocidad
Cinco segundos pasan rápido. La velocidad con la que se mueven tu sujeto y la cámara dentro de esa ventana cambia por completo el tono emocional del clip.
Modificadores de velocidad útiles:
- "lentamente", "con suavidad", "poco a poco" — calmado, meditativo, elegante
- "bruscamente", "de repente" — mucha energía, dramático
- "apenas perceptiblemente" — atmosférico, impresionista
- "de forma constante", "sin variar" — controlado, deliberado
- "a ráfagas", "rítmicamente" — dinámico, cinético
No necesitas especificar fotogramas por segundo ni tiempos en milisegundos. El modelo se encarga de eso internamente. Lo que haces con estas palabras es fijar la sensación de velocidad mediante la elección de adverbios y adjetivos, y esa sensación es exactamente lo que se representa.
Vocabulario de movimiento que funciona
Las palabras concretas que uses determinan lo que se genera. Este es un vocabulario práctico organizado por función, listo para usar.
Palabras para la acción del sujeto
Deriva, se desliza, se dispara, se asienta, parpadea, pulsa, barre, espirala, traza, rota, se contrae, se expande, sube, cae, se inclina, gira, levanta, libera, se mece, centellea
Palabras para el movimiento de cámara
Dolly hacia dentro, panorámica a la izquierda, sube, desciende, inclinación hacia arriba, inclinación hacia abajo, travelling a la derecha, circula, orbita, revela, grúa hacia arriba, mantiene la posición, avanza a través, retrocede, sigue a distancia
Palabras para atmósfera y textura
Volumétrica, difusa, rasante, moteada, centelleante, apagada, brumosa, cristalina, granulada, en capas, dispersa, de bordes suaves, prismática, angular, de tono cálido
Cómo construir una frase: [Subject from set 1] + [direction or purpose] + [camera word from set 2] + [atmosphere from set 3]
Ejemplo: "La niebla del río asciende a través de la copa ámbar mientras la cámara avanza con suavidad a nivel del agua, la luz matinal difusa se dispersa entre las ramas."
Son 28 palabras. Le da al modelo acción del sujeto, movimiento de cámara y textura atmosférica. Todo lo que necesita para producir un clip coherente.
Plantillas de estructura de prompt
Dos estructuras cubren aproximadamente el 90 % de los casos de uso. La más simple es más rápida de escribir y funciona bien con la mayoría de los modelos. La detallada produce resultados más precisos cuando los necesitas.
La fórmula simple de 3 partes
[Subject action] + [Camera movement] + [Atmosphere]
Ejemplo: "Una mujer se gira despacio hacia la cámara con una leve sonrisa. La cámara avanza suavemente. Luz matinal difusa y cálida."
Esta estructura funciona bien con modelos rápidos como Wan 2.5 I2V Fast, Seedance 2.0 Fast y Video 01 Live. Los prompts cortos dejan espacio para que el modelo exprese su propio estilo de movimiento, lo que con modelos de alta calidad suele jugar a tu favor.
La fórmula cinematográfica de 5 partes
[Subject starting state] + [Action sequence] + [Camera movement] + [Lighting behavior] + [Atmospheric detail]
Ejemplo: "Un hombre está de pie al borde de una calle mojada por la lluvia, con el cuello de la chaqueta levantado y las manos a los costados. Lentamente, alza la mirada hacia el fondo de la calle y da un paso al frente. La cámara lo acompaña desde un ángulo bajo, subiendo ligeramente. La luz cálida de una farola de sodio se refleja en el asfalto mojado a la izquierda. Una neblina suave recorre los edificios del fondo."
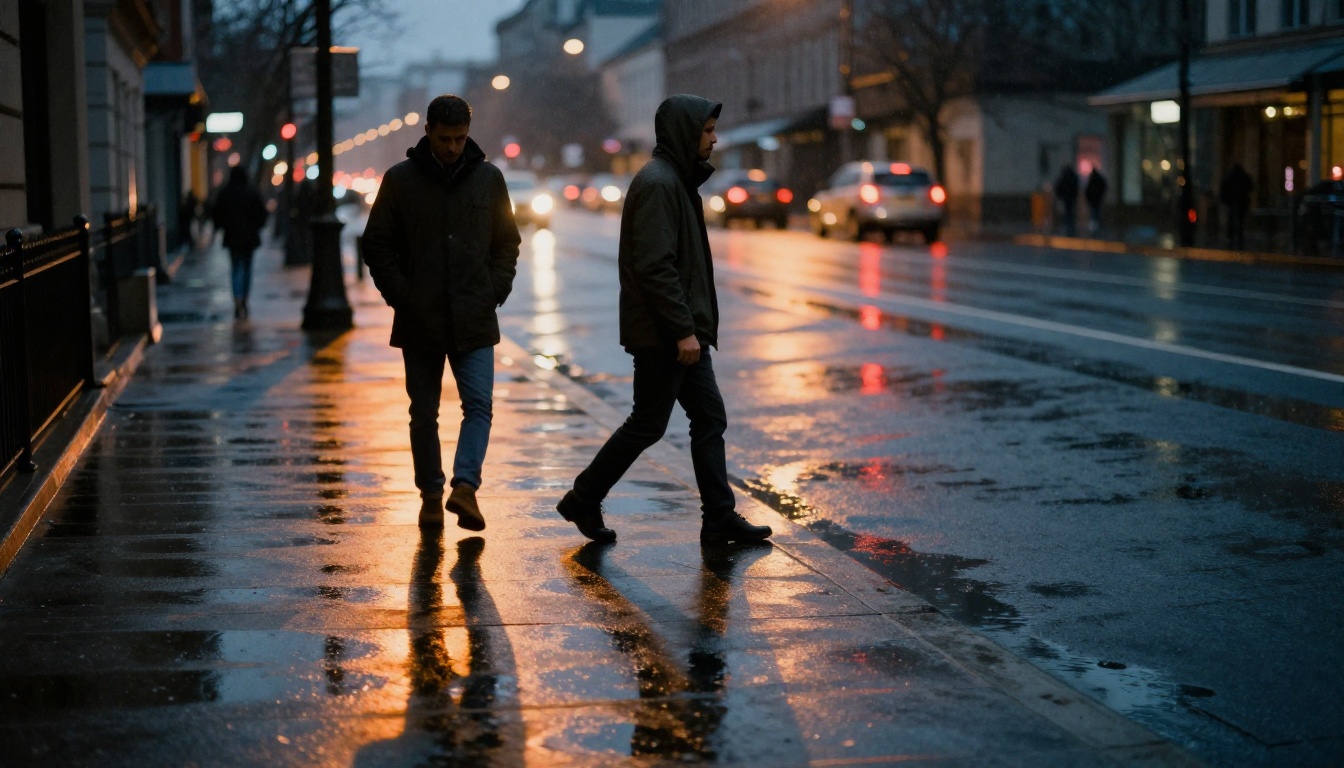
Esa estructura de 65 palabras da a modelos de precisión como Wan 2.7 I2V y Kling v3 Omni Video material suficiente para producir un clip genuinamente cinematográfico, con movimiento coherente durante los cinco segundos.
Cuándo usar cada una
| Situación | Mejor fórmula |
|---|
| Contenido para redes sociales, iteraciones rápidas | Simple de 3 partes |
| Cortometraje o secuencias narrativas | Cinematográfica de 5 partes |
| Animaciones de producto | Simple de 3 partes con un verbo de acción específico del producto |
| Escenas de personajes | Cinematográfica de 5 partes |
| Tomas de naturaleza o paisaje | Simple de 3 partes (los modelos rellenan bien los huecos del entorno) |
| Secuencias de videoclip musical | Cinematográfica de 5 partes |
Errores comunes en los prompts
Estos tres patrones producen resultados débiles de forma constante, y los tres son fáciles de evitar una vez que sabes qué vigilar.
Sobrecargar la escena
Cinco segundos no pueden contener tres eventos distintos. Si tu prompt incluye varios cambios de escena, el modelo ignora algunos o crea cortes bruscos entre ellos.
Evita: "La mujer se da la vuelta, luego la cámara corta a la calle de fuera, luego hace zoom sobre una taza de café, luego la luz pasa de día a noche."
Haz esto en su lugar: Elige un momento y muéstralo por completo. Guarda el resto de planos para prompts distintos y generaciones separadas.
Ignorar el fotograma inicial
El modelo usa tu imagen como fotograma cero. Si tu prompt describe algo que no puede derivarse del estado de la imagen, el modelo ignora la instrucción o produce artefactos de distorsión al intentar conciliar el conflicto.
Si tu imagen muestra a una mujer sentada con los ojos cerrados y tu prompt dice "ella abre los ojos y sale corriendo por la puerta", le estás pidiendo al modelo que contradiga su propia entrada. Trabaja desde el estado de la imagen, no en contra de él.
💡 Antes de escribir tu prompt, escribe una frase que describa exactamente lo que muestra tu imagen. Después escribe un prompt que continúe de forma natural desde ese estado. Ese único hábito elimina la mayoría de las generaciones fallidas.
Usar el lenguaje de la generación de imágenes
Las frases que funcionan en los generadores de imágenes confunden activamente a los modelos de video:
- "Muy detallado, 8K, fotorrealista" — el modelo gestiona la resolución internamente; estas palabras desperdician tokens del prompt
- "Al estilo de [fotógrafo]" — las referencias de estilo funcionan para la composición estática, no para describir el movimiento en el tiempo
- "Gradación de color cinematográfica" — la gradación la aplica el modelo internamente; esta frase no dirige el movimiento
- "Enfoque nítido, fondo bokeh" — el enfoque lo define tu imagen de entrada; el prompt no debe volver a describir el estado estático
Sustituye cada una de estas frases por una indicación de movimiento. Cada token que gastas en "muy detallado" es un token que no has gastado en decirle a la cámara que suba.
Modelos de imagen a video en PicassoIA
PicassoIA aloja más de 100 modelos de generación de video, incluidos los sistemas de imagen a video más capaces disponibles en la actualidad.
Los mejores modelos para prompts de movimiento
| Modelo | Fortaleza | Calidad de salida |
|---|
| Wan 2.7 I2V | Animación de escenas detallada, gran fidelidad de movimiento | 720p |
| Kling v3 Motion Control | Precisión en la trayectoria de cámara, movimiento cinematográfico | 1080p |
| Kling v3 Omni Video | Video de alta calidad a partir de texto e imagen | 1080p |
| Seedance 2.0 | Movimiento realista y fluido con audio nativo | 1080p |
| Gen4 Turbo | Imagen a video rápido, ideal para iteraciones frecuentes | 720p |
| Ovi I2V | Animación de personajes con audio sincronizado | 720p |
| Video 01 Live | Animación natural de fotos fijas | 1080p |
| Wan 2.5 I2V | Calidad y velocidad equilibradas para el uso diario | 720p |
| Hailuo 2.3 | Calidad de salida cinematográfica en 1080p | 1080p |
| LTX 2 Pro | Máxima calidad, salida en 4K | 4K |
Cómo usar Wan 2.7 I2V en PicassoIA
Wan 2.7 I2V se cuenta siempre entre los modelos de imagen a video más potentes para una animación que responde bien al prompt. Así puedes obtener resultados fiables con él:
- Sube tu imagen de partida a la interfaz del modelo. Un mínimo de 512 px de ancho da al modelo suficientes datos de píxeles para un movimiento coherente.
- Escribe tu prompt con cualquiera de las dos fórmulas. Primero la acción del sujeto, después el movimiento de cámara y por último la atmósfera. Haz que la primera frase trate por completo de lo que hace el sujeto.
- Elige la resolución: 720p ofrece la mejor relación entre calidad y velocidad para la mayoría de los casos. Úsala como opción por defecto.
- Itera cambiando verbos: genera tres variaciones del mismo prompt con verbos de movimiento distintos. "Deriva" y "se desliza" producen sensaciones de movimiento diferentes a partir de entradas idénticas. El vocabulario de verbos es tu principal palanca de iteración.
- Cuando el movimiento es demasiado sutil: si Wan 2.7 da resultados demasiado contenidos, ejecuta exactamente el mismo prompt en Kling v3 Motion Control. Kling produce con regularidad un movimiento más pronunciado a partir del mismo texto, lo que hace que los dos modelos sean complementarios naturales para encontrar la intensidad de movimiento adecuada.
Ejemplos reales de prompts
Estos son prompts completos y listos para usar, para cuatro tipos comunes de imagen. Copia la estructura y adapta los detalles a tus propias imágenes.
Animación de retrato
Imagen de partida: Persona mirando ligeramente a la izquierda, luz suave de estudio
Prompt: "Ella gira la cabeza despacio hacia la cámara, con una leve sonrisa que se forma en la comisura de la boca. La cámara se mantiene quieta, bloqueada. La luz suave y difusa de estudio desde arriba a la izquierda ilumina su pómulo y el borde del hombro."
Mejores modelos: Ovi I2V, Video 01 Live
Movimiento de paisaje
Imagen de partida: Copa de un bosque otoñal, río visible desde un ángulo aéreo
Prompt: "La superficie del río capta la luz mientras la cámara desciende lentamente hacia el agua, las copas de los árboles se abren a cada lado. La niebla se desliza sobre el dosel superior. La luz pasa de ámbar a oro cálido a medida que cambia el ángulo de descenso."
Mejores modelos: Wan 2.7 I2V, Wan 2.6 I2V
Presentación de producto
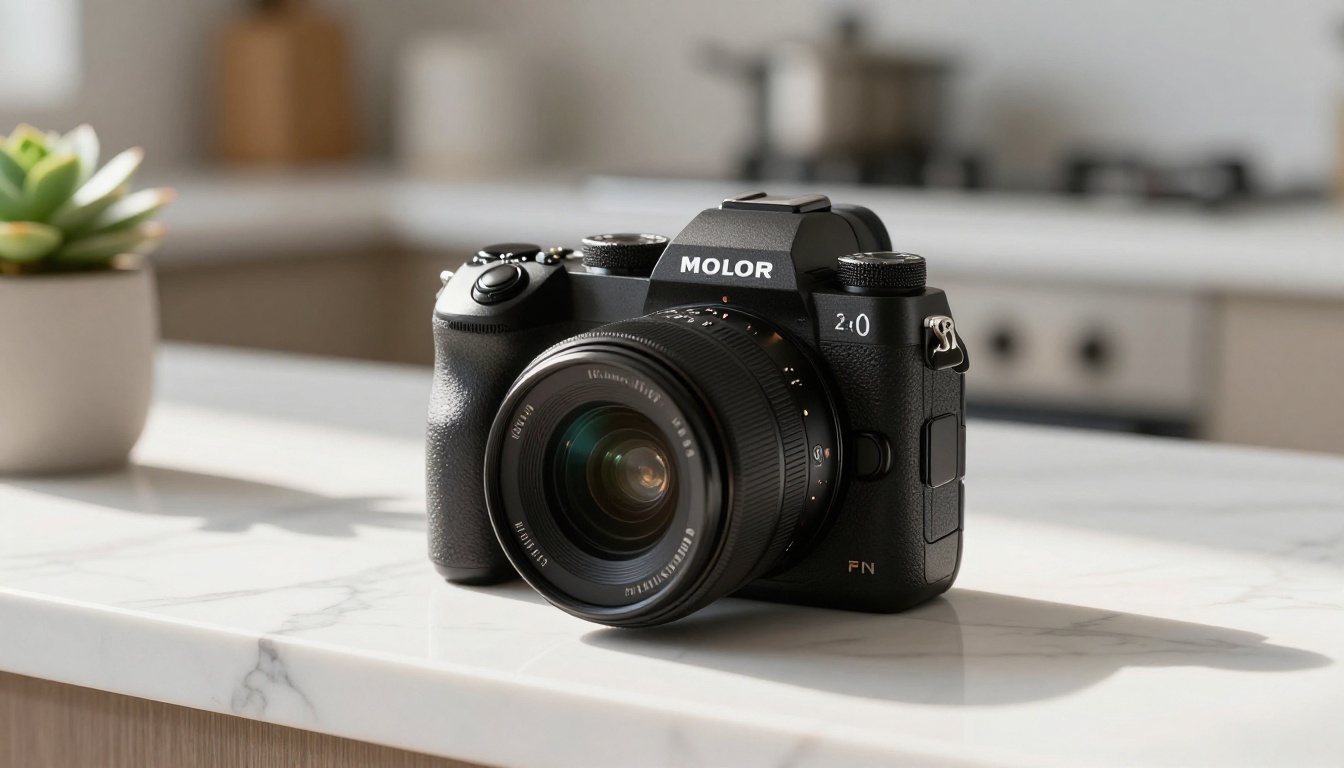
Imagen de partida: Cuerpo de cámara sobre una encimera de mármol, luz de ventana visible
Prompt: "El cuerpo de la cámara reposa inmóvil sobre la superficie de mármol mientras empieza una órbita lenta de 180 grados desde el lado derecho, revelando progresivamente la textura del agarre y los detalles de los mandos. El parche de luz se desplaza sobre las vetas del mármol a medida que cambia el ángulo. Suave, continuo, comercial."
Mejores modelos: Gen4 Turbo, Seedance 2.0
Secuencia de acción
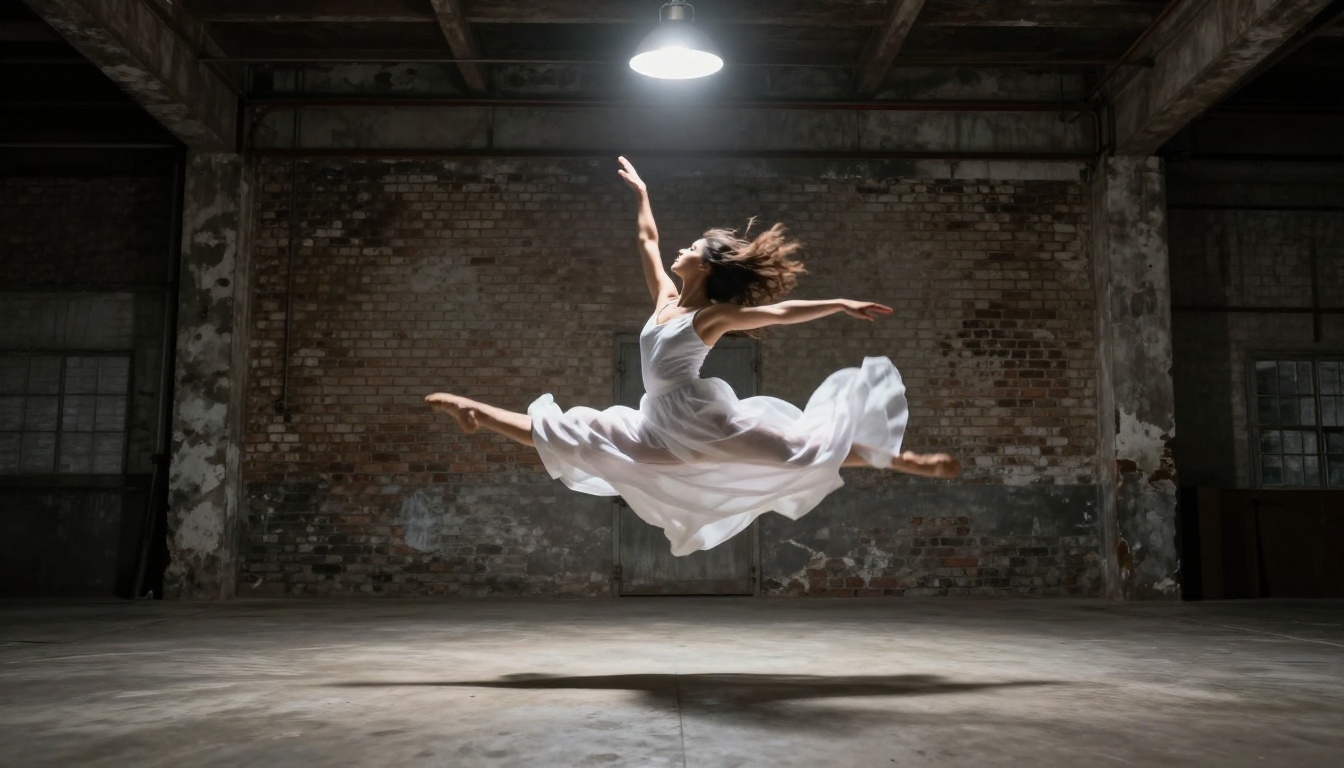
Imagen de partida: Bailarina en pleno salto en un almacén
Prompt: "Ella aterriza tras el salto y se lanza de inmediato a un giro lento, con los brazos extendidos hacia los costados. La cámara sube ligeramente y se desliza hacia la izquierda, manteniéndola centrada en el encuadre durante todo el plano. La única lámpara cenital proyecta su sombra giratoria sobre el suelo de hormigón bajo ella. Alto contraste, deliberado, contenido."
Mejores modelos: Kling v3 Video, Hailuo 2.3
Qué separa lo bueno de lo excelente
Llegados a este punto ya tienes la estructura: acción del sujeto, movimiento de cámara y atmósfera, en el orden correcto y con vocabulario preciso. Lo que separa los resultados que borrarías de los que de verdad usarías es la especificidad sobre cómo se mueve algo, no solo sobre qué se mueve.
Compara estos dos prompts para la misma imagen:
Correcto: "Las hojas se mueven con el viento."
Impresionante: "Hojas individuales se separan de las puntas de las ramas y descienden en espiral con arcos lentos, girando sobre sí mismas mientras caen, y la cámara sube suavemente mientras la última se posa en el suelo."
La segunda versión describe la trayectoria, la física y la relación de la cámara con el suceso durante toda la duración del clip. Ese nivel de detalle le da al modelo algo real con lo que trabajar desde el primer fotograma hasta el fotograma 120.
Una nota práctica sobre la iteración: si tus resultados empiezan a parecerse demasiado entre sí, cambia primero tus verbos de movimiento, antes que cualquier otra cosa. Sustituye "lentamente" por "gradualmente". Sustituye "deriva" por "se desliza". Los pequeños cambios de vocabulario en la frase de acción del sujeto producen salidas de movimiento notablemente distintas, porque los modelos son más sensibles a la elección del verbo de lo que la mayoría de la gente cree.
Tus imágenes ya están listas
Cada imagen que has creado es un posible fotograma inicial. Los modelos de video de IA en PicassoIA se encargan del render. Tu trabajo es describir lo que sucede a continuación, con un lenguaje de movimiento que el modelo pueda ejecutar.
Elige una imagen. Escribe una frase de acción del sujeto. Añade un movimiento de cámara. Añade una nota de atmósfera. Pégala en Wan 2.7 I2V o Seedance 2.0 y genera. El resultado será notablemente mejor que cualquier cosa producida antes de aplicar esta estructura. Después cambia un verbo y vuelve a ejecutarlo. Así es como se desarrolla de verdad una práctica de escritura de prompts.
Explora los más de 100 modelos de generación de video en picassoia.com/en/all-models y empieza por el modelo de la tabla de arriba que mejor encaje con tu caso de uso.


