Escrever prompts de imagem para vídeo não é igual a escrever prompts de imagem. As regras são diferentes, o vocabulário é diferente e, o mais importante, o modelo mental que você precisa é completamente outro. Um ótimo prompt de imagem estática descreve um momento congelado. Um ótimo prompt de movimento descreve uma sequência de eventos se desenrolando no tempo. Se você envia sua melhor imagem para um modelo de vídeo com IA e obtém resultados rígidos, errados ou simplesmente estranhos, o problema quase certamente está no seu prompt.
Por que o seu prompt é todo o trabalho
Todo modelo de imagem para vídeo, do Wan 2.7 I2V ao Kling v3 Omni Video, funciona interpretando duas entradas: seu quadro inicial e suas instruções de movimento. O modelo lê a imagem para entender o contexto da cena, a iluminação, o sujeito, as pistas de profundidade e a paleta de cores. Depois, lê seu prompt para saber o que fazer com tudo isso nos próximos cinco segundos.
Se o seu prompt for vago, o modelo adivinha. Às vezes acerta. Muitas vezes não acerta. Se o seu prompt for preciso e focado em movimento, o modelo executa. Essa é toda a diferença entre um clipe que você mostraria para alguém e um que você apagaria.
Por isso você não pode copiar e colar um prompt de geração de imagens no Seedance 2.0 e esperar resultados cinematográficos. Prompts de imagem são otimizados para composição estática. Prompts de vídeo exigem pensamento temporal.
Pensamento estático versus pensamento de movimento
Um prompt estático responde a uma pergunta: como isso se parece? Um prompt de movimento responde a outra pergunta: o que acontece aqui, em que ordem e de qual posição de câmera?
Aqui está uma comparação direta:
| Prompt estático | Prompt de movimento |
|---|
| "Mulher sentada na janela de um café, luz da manhã" | "Mulher levanta a xícara de café devagar, olha de relance para a esquerda pela janela, a luz suave se desloca pelo rosto dela conforme as nuvens passam" |
| "Rio na floresta na hora dourada" | "A câmera avança devagar, baixa, sobre a superfície da água, enquanto a névoa se desprende das pedras conforme a correnteza se move" |
| "Homem caminhando na chuva" | "Homem atravessa a rua da esquerda para a direita sobre paralelepípedos molhados, poças ondulam a cada passo, a câmera acompanha a meia distância" |
Cada prompt de movimento descreve eventos no tempo. Há um sujeito, um verbo e um contexto para a forma como a cena muda. Essa estrutura é o que os modelos de vídeo foram construídos para ler.
O que o modelo realmente lê
Modelos de vídeo com IA dão peso aos elementos do prompt em uma ordem aproximada de prioridade. O movimento do sujeito fica no topo. O movimento de câmera vem em seguida. Os detalhes de atmosfera e textura vêm por último. Se você abre o prompt com descrições da cena e enterra o movimento no fim, o modelo pode produzir um clipe visualmente preciso, mas quase estático.
💡 Regra: Coloque primeiro o que se move. Ação do sujeito na primeira frase. Movimento de câmera na segunda. Iluminação e atmosfera por último.
A anatomia de um bom prompt de movimento
Todo prompt de imagem para vídeo de alto desempenho contém três elementos estruturais. Se você deixar de lado qualquer um deles, obterá resultados inconsistentes entre as gerações.
Sujeito primeiro, ação em seguida
O sujeito é o elemento principal da sua imagem. A ação é o que esse sujeito faz durante o clipe. Ambos precisam ser específicos e concretos.
Fraco: "Uma mulher em uma cafeteria"
Forte: "Uma mulher levanta a xícara de espresso com as duas mãos, com vapor subindo em espiral na luz da manhã"
O verbo é onde a animação acontece. "Levanta", "vira", "olha de relance", "sorri", "caminha", "inclina" dão ao modelo algo concreto para executar. Verbos abstratos como "sente" ou "vivencia" não produzem nada útil, porque não têm um correlato físico que o modelo possa renderizar como movimento entre os quadros.
Modelos como o Wan 2.6 I2V e o Kling v2.6 Motion Control respondem especialmente bem a uma formulação precisa da ação do sujeito. Quanto mais granular for a descrição da ação, com mais fidelidade o modelo consegue executá-la durante toda a duração do clipe.
O papel do movimento de câmera
O movimento de câmera é o elemento mais subutilizado nos prompts de movimento amadores. Ele também é o elemento que, com mais confiabilidade, transforma um clipe razoável em um clipe cinematográfico.
| Direção da câmera | O que produz |
|---|
| Dolly in lento | Intimidade, atrai a atenção para o sujeito |
| Panorâmica suave para a esquerda ou direita | Revela o ambiente, cria sensação de deslocamento |
| Subida de ângulo baixo | Drama, o sujeito parece dominante no quadro |
| Descida aérea | Sensação de chegada, estabelece escala e lugar |
| Estática, travada | Toda a ênfase no movimento do sujeito, deliberado e contido |
| Deriva manual leve | Realismo orgânico, qualidade documental |
| Zoom out lento | Expansão de contexto, revela a escala progressivamente |
| Órbita de 360 graus | Foco no produto, mostra todos os ângulos em sequência |
💡 Escolha um movimento de câmera por clipe e mantenha-se nele. Misturar dois movimentos de câmera em cinco segundos cria confusão visual, e os modelos raramente executam os dois de forma limpa.
O Gen4 Turbo e o Kling v3 Motion Control respondem muito bem a diretrizes explícitas de câmera. O Kling v3 Motion Control foi especificamente criado para seguir instruções de trajetória de câmera, o que o torna valioso quando o controle espacial preciso importa.
Pistas de tempo e velocidade
Cinco segundos passam rápido. A velocidade com que seu sujeito e a câmera se movem dentro dessa janela muda por completo o tom emocional do clipe.
Modificadores de velocidade úteis:
- "devagar," "suavemente," "gradualmente" — calmo, meditativo, elegante
- "bruscamente," "de repente" — alta energia, dramático
- "quase imperceptivelmente" — atmosférico, impressionista
- "de forma constante," "continuamente" — controlado, deliberado
- "em rajadas," "ritmicamente" — dinâmico, cinético
Você não precisa especificar taxas de quadros ou tempos em milissegundos. O modelo cuida disso internamente. O que você faz com essas palavras é definir a sensação de velocidade pela escolha de advérbios e adjetivos, e é exatamente essa sensação que é renderizada.
Vocabulário de movimento que funciona
As palavras específicas que você usa determinam o que será gerado. Aqui está um vocabulário de trabalho organizado por função, pronto para ser usado diretamente.
Palavras para a ação do sujeito
Deriva, desliza, dispara, assenta, tremeluz, pulsa, varre, espirala, traça, gira, contrai, expande, sobe, cai, inclina, vira, levanta, libera, balança, cintila
Palavras para o movimento de câmera
Dolly in, panorâmica para a esquerda, sobe, desce, inclina para cima, inclina para baixo, acompanha para a direita, circula, orbita, revela, sobe em grua, fica parada, atravessa, recua, segue à distância
Palavras para atmosfera e textura
Volumétrica, difusa, rasante, pontilhada, cintilante, abafada, enevoada, cristalina, granulada, em camadas, dispersa, de bordas suaves, prismática, angular, de tons quentes
Como montar uma frase: [Subject from set 1] + [direction or purpose] + [camera word from set 2] + [atmosphere from set 3]
Exemplo: "A névoa do rio sobe pelo dossel âmbar enquanto a câmera avança suavemente na altura da água, com a luz difusa da manhã se espalhando pelos galhos."
São 28 palavras. Elas dão ao modelo ação do sujeito, movimento de câmera e textura atmosférica. Tudo o que ele precisa para produzir um clipe coerente.
Modelos de estrutura de prompt
Duas estruturas cobrem cerca de 90% dos casos de uso. A mais simples é mais rápida de escrever e funciona bem com a maioria dos modelos. A detalhada gera resultados mais precisos quando você precisa deles.
A fórmula simples de 3 partes
[Subject action] + [Camera movement] + [Atmosphere]
Exemplo: "Uma mulher se vira devagar para a câmera com um leve sorriso. A câmera avança suavemente. Luz difusa e quente da manhã."
Essa estrutura funciona bem com modelos rápidos, incluindo o Wan 2.5 I2V Fast, o Seedance 2.0 Fast e o Video 01 Live. Prompts curtos deixam espaço para o modelo expressar seu próprio estilo de movimento, o que, com modelos de alta qualidade, costuma jogar a seu favor.
A fórmula cinematográfica de 5 partes
[Subject starting state] + [Action sequence] + [Camera movement] + [Lighting behavior] + [Atmospheric detail]
Exemplo: "Um homem está na beira de uma rua molhada pela chuva, com a gola do casaco levantada e as mãos ao lado do corpo. Ele eleva devagar o olhar em direção à extremidade distante da rua e dá um passo à frente. A câmera o acompanha em ângulo baixo, subindo levemente. A luz quente de um poste de sódio reflete no asfalto molhado à esquerda. Uma névoa suave se espalha pelos prédios ao fundo."
Essa estrutura de 65 palavras oferece aos modelos de precisão, como o Wan 2.7 I2V e o Kling v3 Omni Video, material suficiente para produzir um clipe genuinamente cinematográfico, com movimento coerente ao longo dos cinco segundos.
Quando usar cada uma
| Situação | Melhor fórmula |
|---|
| Conteúdo para redes sociais, iterações rápidas | Simples de 3 partes |
| Curta-metragem ou sequências narrativas | Cinematográfica de 5 partes |
| Animações de produto | Simples de 3 partes com verbo de ação específico do produto |
| Cenas com personagens | Cinematográfica de 5 partes |
| Fotos de natureza ou paisagem | Simples de 3 partes (os modelos preenchem bem as lacunas do ambiente) |
| Sequências de videoclipe musical | Cinematográfica de 5 partes |
Erros comuns em prompts
Estes três padrões produzem resultados fracos de forma consistente, e todos são fáceis de evitar quando você sabe o que observar.
Sobrecarregar a cena
Cinco segundos não comportam três eventos distintos. Se o seu prompt inclui várias mudanças de cena, o modelo ignora algumas ou cria cortes bruscos entre elas.
Evite: "A mulher se vira, depois a câmera corta para a rua lá fora, depois dá zoom em uma xícara de café, depois a luz muda do dia para a noite."
Faça assim: Escolha um momento e renderize-o por completo. Guarde os demais planos para prompts e gerações separados.
Ignorar o quadro inicial
O modelo usa a sua imagem como quadro zero. Se o seu prompt descreve algo que não pode decorrer do estado da imagem, o modelo ignora a instrução ou produz artefatos de distorção tentando conciliar o conflito.
Se a sua imagem mostra uma mulher sentada, de olhos fechados, e o seu prompt diz "ela abre os olhos e sai correndo pela porta", você está pedindo ao modelo que contradiga a própria entrada. Trabalhe a partir do estado da imagem, não contra ele.
💡 Antes de escrever o prompt, escreva uma frase descrevendo exatamente o que a sua imagem mostra. Depois, escreva um prompt que continue naturalmente a partir desse estado. Esse único hábito elimina a maioria das gerações fracassadas.
Usar linguagem de geração de imagens
Frases que funcionam em geradores de imagem confundem ativamente os modelos de vídeo:
- "Altamente detalhado, 8K, fotorrealista" — o modelo cuida da resolução internamente; essas palavras desperdiçam tokens do prompt
- "No estilo de [fotógrafo]" — referências de estilo funcionam para composição estática, não para descrever movimento temporal
- "Gradação de cor cinematográfica" — a gradação de cor é aplicada internamente pelo modelo; essa frase não direciona o movimento
- "Foco nítido, fundo com bokeh" — o foco é definido pela sua imagem de entrada; o prompt não deve redescrever o estado estático
Substitua cada uma dessas expressões por uma diretriz de movimento. Cada token que você gasta com "altamente detalhado" é um token que você não usou para mandar a câmera subir.
Modelos de imagem para vídeo no PicassoIA
O PicassoIA hospeda mais de 100 modelos de geração de vídeo, incluindo os sistemas de imagem para vídeo mais capazes disponíveis atualmente em qualquer lugar.
Melhores modelos para prompts de movimento
| Modelo | Ponto forte | Qualidade de saída |
|---|
| Wan 2.7 I2V | Animação de cenas detalhadas, forte fidelidade de movimento | 720p |
| Kling v3 Motion Control | Precisão na trajetória de câmera, movimento cinematográfico | 1080p |
| Kling v3 Omni Video | Vídeo de alta qualidade a partir de texto e imagem | 1080p |
| Seedance 2.0 | Movimento realista e fluido com áudio nativo | 1080p |
| Gen4 Turbo | Imagem para vídeo rápido, ideal para iterações rápidas | 720p |
| Ovi I2V | Animação de personagens com áudio sincronizado | 720p |
| Video 01 Live | Animação natural de fotos estáticas | 1080p |
| Wan 2.5 I2V | Qualidade e velocidade equilibradas para uso diário | 720p |
| Hailuo 2.3 | Qualidade de saída cinematográfica em 1080p | 1080p |
| LTX 2 Pro | Qualidade máxima, saída em 4K | 4K |
Como usar o Wan 2.7 I2V no PicassoIA
O Wan 2.7 I2V é, de forma consistente, um dos modelos de imagem para vídeo mais fortes disponíveis para animação responsiva a prompts. Veja como obter resultados confiáveis com ele:
- Envie sua imagem inicial para a interface do modelo. Uma largura mínima de 512px dá ao modelo dados de pixel suficientes para um movimento consistente.
- Escreva seu prompt usando uma das fórmulas. Ação do sujeito primeiro, depois movimento de câmera e, por último, atmosfera. Mantenha a primeira frase inteiramente voltada para o que o sujeito faz.
- Escolha a resolução: 720p oferece a melhor relação entre qualidade e velocidade para a maioria dos casos. Use-a como padrão.
- Itere trocando verbos: Gere três variações do mesmo prompt com verbos de movimento diferentes. "Deriva" e "desliza" produzem sensações de movimento diferentes a partir das mesmas entradas. O vocabulário de verbos é sua principal alavanca de iteração.
- Quando o movimento estiver sutil demais: Se o Wan 2.7 gerar resultados contidos demais, rode exatamente o mesmo prompt no Kling v3 Motion Control. O Kling produz de forma consistente um movimento mais pronunciado a partir do mesmo texto, o que torna os dois modelos complementares naturais para encontrar a intensidade de movimento certa.
Exemplos reais de prompts
Estes são prompts completos e prontos para uso, para quatro tipos comuns de imagem. Copie a estrutura e adapte os detalhes às suas próprias imagens.
Animação de retrato
Imagem inicial: Pessoa olhando levemente para a esquerda, luz suave de estúdio
Prompt: "Ela vira a cabeça devagar em direção à câmera, com um leve sorriso se formando no canto da boca. A câmera fica parada, travada. Luz suave e difusa de estúdio vinda do alto à esquerda atinge sua maçã do rosto e a borda do ombro."
Melhores modelos: Ovi I2V, Video 01 Live
Movimento de paisagem
Imagem inicial: Dossel de floresta de outono, rio visível de um ângulo aéreo
Prompt: "A superfície do rio capta a luz conforme a câmera desce devagar em direção à água, com as copas das árvores se abrindo dos dois lados. A névoa se espalha pelo dossel superior. A luz muda de âmbar para dourado quente conforme o ângulo de descida se altera."
Melhores modelos: Wan 2.7 I2V, Wan 2.6 I2V
Vitrine de produto
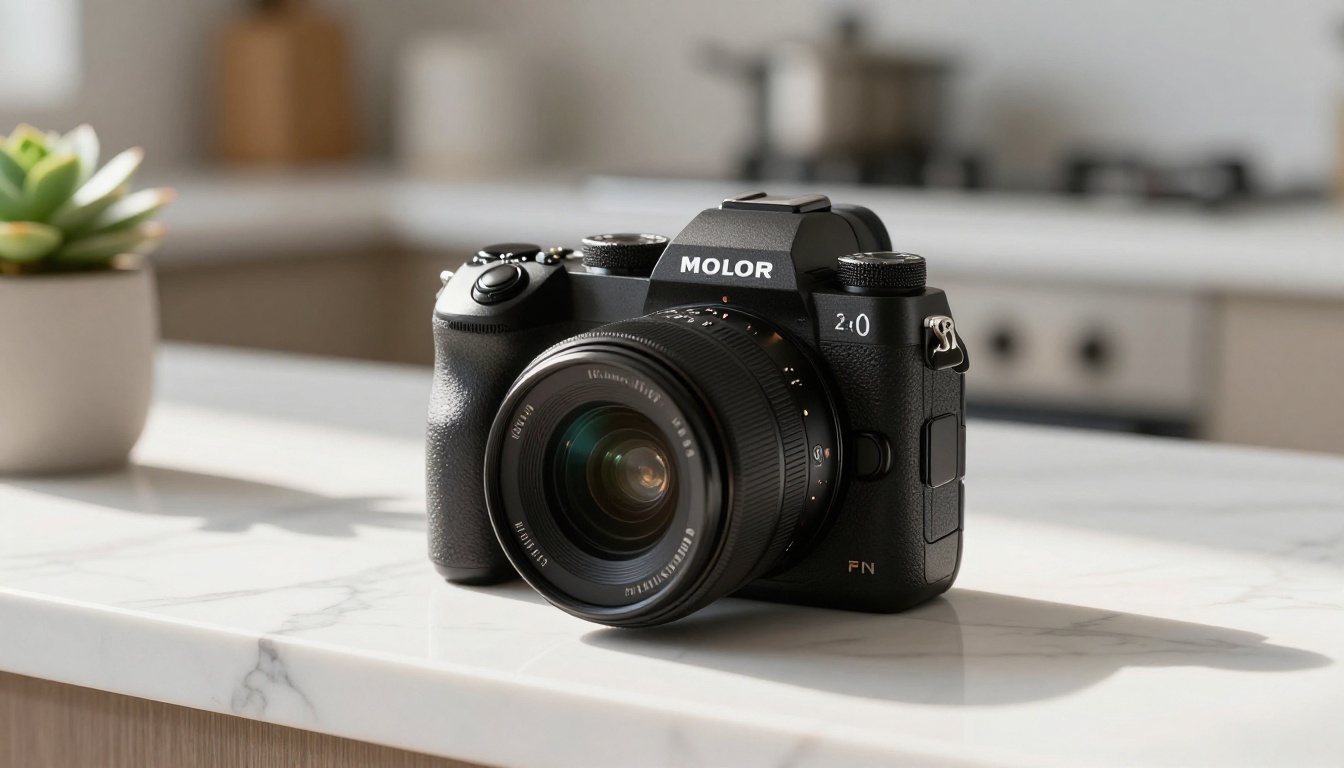
Imagem inicial: Corpo de câmera sobre bancada de mármore, luz de janela visível
Prompt: "O corpo da câmera permanece imóvel sobre a superfície de mármore enquanto uma órbita lenta de 180 graus começa pelo lado direito, revelando progressivamente a textura da pegada e os detalhes do disco de ajuste. O feixe de luz se desloca pelos veios do mármore conforme o ângulo muda. Suave, contínuo, comercial."
Melhores modelos: Gen4 Turbo, Seedance 2.0
Sequência de ação
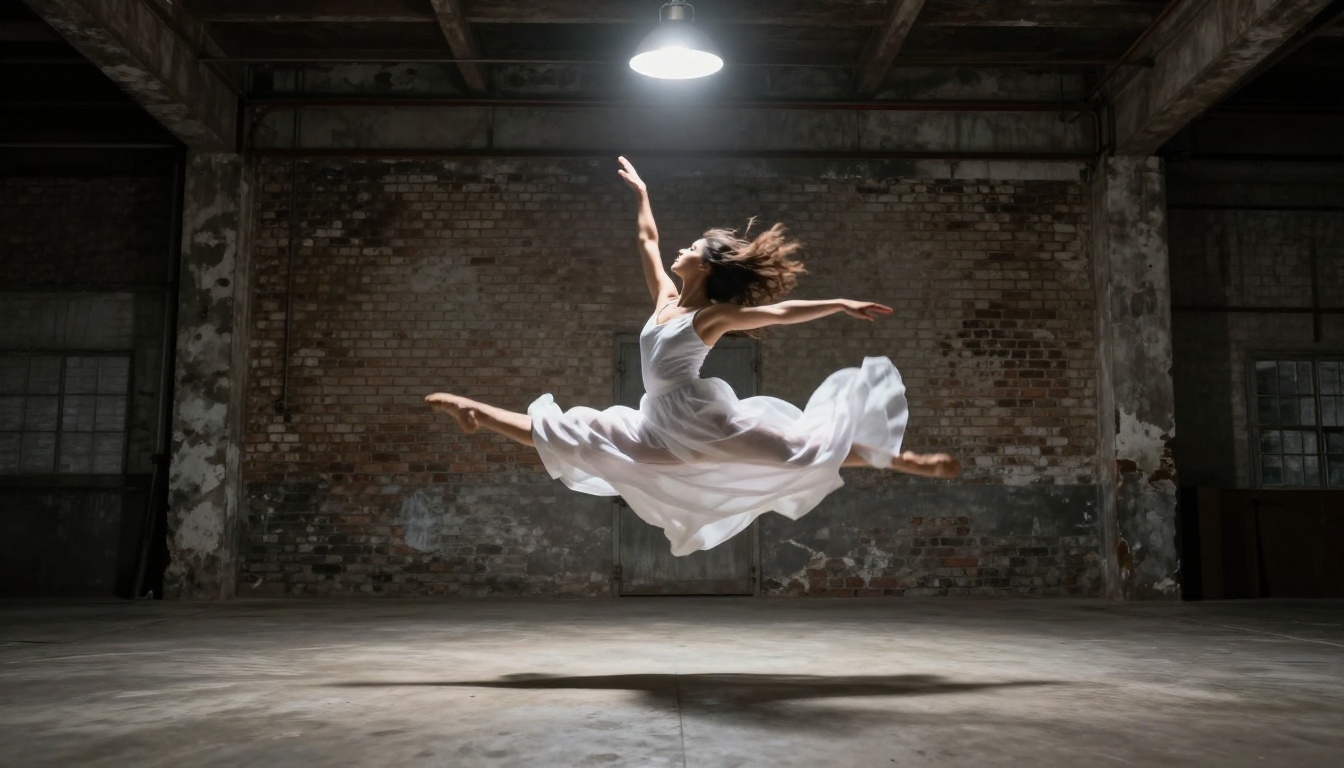
Imagem inicial: Bailarina no meio de um salto em um galpão
Prompt: "Ela aterrissa do salto e imediatamente se lança em um giro lento, com os braços se estendendo para fora dos lados do corpo. A câmera sobe levemente e desloca-se para a esquerda, mantendo-a centralizada no quadro durante todo o tempo. A única lâmpada suspensa projeta sua sombra girando pelo piso de concreto logo abaixo. Alto contraste, deliberado, contido."
Melhores modelos: Kling v3 Video, Hailuo 2.3
O que separa o bom do excelente
Neste ponto, você tem a estrutura: ação do sujeito, movimento de câmera e atmosfera, na ordem certa, com vocabulário preciso. O que separa resultados que você apagaria de resultados que realmente usaria é a especificidade no nível de como algo se move, e não apenas de o que se move.
Compare estes dois prompts para a mesma imagem:
Adequado: "As folhas sopram com o vento."
Impressionante: "Folhas individuais se soltam das pontas dos galhos e descem em espiral, em arcos lentos, girando conforme caem, enquanto a câmera sobe suavemente até que a última pouse no chão."
A segunda versão descreve trajetória, física e a relação da câmera com o evento durante toda a duração do clipe. Esse nível de detalhe dá ao modelo algo real para trabalhar do quadro um ao quadro 120.
Uma observação prática sobre iteração: se os seus resultados começarem a parecer repetitivos, troque os verbos de movimento antes de mudar qualquer outra coisa. Substitua "devagar" por "gradualmente". Substitua "deriva" por "desliza". Pequenas mudanças de vocabulário na frase de ação do sujeito produzem resultados de movimento significativamente diferentes, porque os modelos são mais sensíveis à escolha do verbo do que a maioria das pessoas imagina.
Suas imagens já estão prontas
Toda imagem que você já fez é um possível quadro inicial. Os modelos de vídeo com IA no PicassoIA cuidam da renderização. Seu trabalho é descrever o que acontece em seguida, em linguagem de movimento que o modelo consiga executar.
Escolha uma imagem. Escreva uma frase de ação do sujeito. Acrescente um movimento de câmera. Acrescente uma observação de atmosfera. Cole no Wan 2.7 I2V ou no Seedance 2.0 e gere. O resultado será visivelmente melhor do que qualquer coisa produzida antes de aplicar esta estrutura. Depois, troque um verbo e rode de novo. É assim que uma prática de escrita de prompts realmente se desenvolve.
Explore todos os mais de 100 modelos de geração de vídeo em picassoia.com/en/all-models e comece pelo modelo da tabela acima que melhor se adapta ao seu caso de uso.


