Écrire un prompt image vers vidéo n’est pas la même chose qu’écrire un prompt d’image. Les règles sont différentes, le vocabulaire aussi, et surtout le modèle mental à adopter est totalement différent. Un bon prompt d’image fixe décrit un instant figé. Un bon prompt de mouvement décrit une suite d’événements qui se déroulent dans le temps. Si vous envoyez votre meilleure image dans un modèle de vidéo par IA et obtenez des résultats raides, faux ou simplement bizarres, le problème vient presque certainement de votre prompt.
Pourquoi votre prompt fait tout le travail
Chaque modèle image vers vidéo, de Wan 2.7 I2V à Kling v3 Omni Video, fonctionne en interprétant deux entrées : votre image de départ et vos instructions de mouvement. Le modèle lit l’image pour le contexte de la scène, l’éclairage, le sujet, les indices de profondeur et la palette de couleurs. Puis il lit votre prompt pour savoir quoi faire de tout cela pendant les cinq prochaines secondes.
Si votre prompt est vague, le modèle devine. Parfois il devine juste. Souvent non. Si votre prompt est précis et orienté mouvement, le modèle exécute. C’est toute la différence entre un clip que vous montreriez à quelqu’un et un clip que vous supprimeriez.
C’est pourquoi vous ne pouvez pas copier-coller un prompt d’image générative dans Seedance 2.0 en espérant un rendu cinématographique. Les prompts d’image sont optimisés pour la composition statique. Les prompts vidéo demandent une réflexion temporelle.
Pensée statique contre pensée de mouvement
Un prompt statique répond à une seule question : à quoi cela ressemble-t-il ? Un prompt de mouvement répond à une autre question : que se passe-t-il ici, dans quel ordre, et depuis quelle position de caméra ?
Voici une comparaison directe :
| Prompt statique | Prompt de mouvement |
|---|
| « Femme assise à la fenêtre d’un café, lumière du matin » | « La femme soulève lentement sa tasse de café, jette un regard à gauche par la fenêtre, une lumière douce glisse sur son visage à mesure que les nuages passent » |
| « Rivière en forêt à l’heure dorée » | « La caméra avance doucement, à basse altitude au-dessus de la surface de l’eau, de la brume se détache des rochers à mesure que le courant avance » |
| « Homme marchant sous la pluie » | « L’homme avance de la gauche vers la droite sur des pavés mouillés, des flaques ondulent à chaque pas, la caméra le suit à mi-distance » |
Chaque prompt de mouvement décrit des événements dans le temps. Il y a un sujet, un verbe et un contexte qui indique comment la scène évolue. Cette structure est précisément ce que les modèles vidéo sont conçus pour lire.
Ce que le modèle lit réellement
Les modèles de vidéo par IA pondèrent les éléments d’un prompt selon un ordre de priorité approximatif. Le mouvement du sujet arrive en tête. Le mouvement de caméra vient en deuxième. Les détails d’atmosphère et de texture viennent en dernier. Si vous placez les descriptions de scène en début de prompt et reléguez le mouvement à la fin, le modèle risque de produire un clip visuellement exact mais presque statique.
💡 Règle : placez d’abord ce qui bouge. Action du sujet dans la première phrase. Mouvement de caméra dans la deuxième. Éclairage et atmosphère en dernier.
L’anatomie d’un bon prompt de mouvement
Chaque prompt image vers vidéo performant contient trois éléments structurels. Si vous en omettez un seul, vos résultats varieront d’une génération à l’autre.
Le sujet d’abord, l’action ensuite
Le sujet est l’élément principal de votre image. L’action est ce que ce sujet fait pendant le clip. Les deux doivent être précis et concrets.
Faible : « Une femme dans un café »
Fort : « Une femme soulève sa tasse d’expresso à deux mains, la vapeur monte en volutes dans la lumière du matin »
C’est dans le verbe que se loge l’animation. « Soulève », « tourne », « jette un regard », « sourit », « marche », « incline » donnent au modèle quelque chose de concret à exécuter. Les verbes abstraits comme « ressent » ou « vit l’expérience de » ne produisent rien d’utile, car ils n’ont aucun équivalent physique que le modèle puisse rendre en mouvement d’une image à l’autre.
Des modèles comme Wan 2.6 I2V et Kling v2.6 Motion Control réagissent particulièrement bien à une formulation précise de l’action du sujet. Plus votre description de l’action est fine, plus le modèle peut l’exécuter fidèlement sur toute la durée du clip.
Le rôle du mouvement de caméra
Le mouvement de caméra est l’élément le plus sous-utilisé dans les prompts de mouvement amateurs. C’est aussi celui qui transforme le plus sûrement un clip correct en clip cinématographique.
| Direction de caméra | Ce qu’elle produit |
|---|
| Travelling avant lent | Intimité, attire l’attention vers le sujet |
| Panoramique doux à gauche ou à droite | Révèle l’environnement, crée une impression de voyage |
| Montée en contre-plongée | Dramatisme, le sujet paraît dominant dans le cadre |
| Descente aérienne | Sensation d’arrivée, établit l’échelle et le lieu |
| Statique, verrouillé | Toute l’attention sur le mouvement du sujet, délibéré et contenu |
| Légère dérive à l’épaule | Réalisme organique, qualité documentaire |
| Dézoom lent | Élargissement du contexte, révèle progressivement l’échelle |
| Orbite à 360 degrés | Mise en valeur du produit, montre tous les angles successivement |
💡 Choisissez un seul mouvement de caméra par clip et tenez-vous-y. Combiner deux mouvements de caméra en cinq secondes crée une confusion visuelle, et les modèles réussissent rarement à exécuter les deux proprement.
Gen4 Turbo et Kling v3 Motion Control répondent très bien aux consignes de caméra explicites. Kling v3 Motion Control a été spécifiquement conçu pour suivre des trajectoires de caméra, ce qui le rend précieux lorsque le contrôle spatial précis compte.
Repères de timing et de vitesse
Cinq secondes passent vite. La vitesse à laquelle votre sujet et votre caméra se déplacent dans cette fenêtre change entièrement le ton émotionnel du clip.
Modificateurs de vitesse utiles :
- « lentement », « doucement », « progressivement » — calme, méditatif, élégant
- « brusquement », « soudain » — forte énergie, dramatique
- « à peine perceptiblement » — atmosphérique, impressionniste
- « régulièrement », « constamment » — contrôlé, délibéré
- « par à-coups », « en rythme » — dynamique, cinétique
Vous n’avez pas besoin de préciser des fréquences d’images ni des durées en millisecondes. Le modèle gère cela en interne. Ce que vous faites avec ces mots, c’est fixer le sentiment de vitesse par le choix des adverbes et des adjectifs, et ce sentiment est précisément ce qui est rendu.
Un vocabulaire de mouvement qui fonctionne
Les mots précis que vous utilisez déterminent ce qui sera généré. Voici un vocabulaire de travail organisé par fonction, prêt à être utilisé directement.
Mots pour l’action du sujet
Dérive, glisse, jaillit, se pose, scintille, pulse, balaie, tourbillonne, trace, pivote, se contracte, se dilate, s’élève, retombe, incline, tourne, soulève, libère, ondule, miroite
Mots pour le mouvement de caméra
Travelling avant, panoramique à gauche, monte, descend, incline vers le haut, incline vers le bas, suit vers la droite, tourne autour, orbite, révèle, monte en grue, reste immobile, traverse, recule, suit à distance
Mots pour l’atmosphère et la texture
Volumétrique, diffus, rasant, moucheté, scintillant, feutré, brumeux, cristallin, granuleux, stratifié, dispersé, bords doux, prismatique, anguleux, aux tons chauds
Comment construire une phrase : [Subject from set 1] + [direction or purpose] + [camera word from set 2] + [atmosphere from set 3]
Exemple : « La brume de la rivière monte à travers la canopée ambrée tandis que la caméra avance doucement à hauteur d’eau, la lumière diffuse du matin se dispersant entre les branches. »
Cela fait 28 mots. Cette phrase donne au modèle une action de sujet, un mouvement de caméra et une texture atmosphérique. Tout ce dont il a besoin pour produire un clip cohérent.
Modèles de structure de prompt
Deux structures couvrent environ 90 % des cas d’usage. La plus simple s’écrit plus vite et fonctionne bien avec la plupart des modèles. La plus détaillée produit des résultats plus précis lorsque vous en avez besoin.
La formule simple en 3 parties
[Subject action] + [Camera movement] + [Atmosphere]
Exemple : « Une femme se tourne lentement vers la caméra avec un léger sourire. La caméra avance doucement. Lumière matinale chaude et diffuse. »
Cette structure fonctionne bien avec des modèles rapides, notamment Wan 2.5 I2V Fast, Seedance 2.0 Fast et Video 01 Live. Les prompts courts laissent au modèle la liberté d’exprimer son propre style de mouvement, ce qui, avec les modèles de haute qualité, joue souvent en votre faveur.
La formule cinématographique en 5 parties
[Subject starting state] + [Action sequence] + [Camera movement] + [Lighting behavior] + [Atmospheric detail]
Exemple : « Un homme se tient au bord d’une rue détrempée par la pluie, le col de sa veste relevé, les mains le long du corps. Il lève lentement le regard vers l’extrémité de la rue et fait un pas en avant. La caméra le suit en contre-plongée basse, en s’élevant légèrement. La lumière chaude d’un lampadaire au sodium se reflète sur l’asphalte mouillé à gauche. Une brume légère traverse les immeubles en arrière-plan. »
Cette structure de 65 mots donne aux modèles de précision comme Wan 2.7 I2V et Kling v3 Omni Video assez de matière pour produire un clip véritablement cinématographique, avec un mouvement cohérent sur les cinq secondes.
Quand utiliser chacune des formules
| Situation | Meilleure formule |
|---|
| Contenus pour les réseaux sociaux, itérations rapides | Formule simple en 3 parties |
| Court-métrage ou séquences narratives | Formule cinématographique en 5 parties |
| Animations de produits | Formule simple en 3 parties avec un verbe d’action spécifique au produit |
| Scènes avec personnages | Formule cinématographique en 5 parties |
| Plans de nature ou de paysage | Formule simple en 3 parties (les modèles comblent bien les vides de l’environnement) |
| Séquences de clips musicaux | Formule cinématographique en 5 parties |
Erreurs courantes dans les prompts
Ces trois schémas produisent systématiquement des résultats faibles, et les trois sont faciles à éviter une fois que vous savez quoi surveiller.
Surcharger la scène
Cinq secondes ne peuvent pas contenir trois événements distincts. Si votre prompt comporte plusieurs changements de scène, le modèle en ignore certains ou crée des coupures brutales entre eux.
À éviter : « La femme se retourne, puis la caméra coupe sur la rue extérieure, puis zoome sur une tasse de café, puis la lumière passe du jour à la nuit. »
À faire à la place : choisissez un moment et rendez-le entièrement. Gardez les autres plans pour des prompts et des générations séparés.
Ignorer l’image de départ
Le modèle utilise votre image comme image zéro. Si votre prompt décrit quelque chose qui ne peut pas découler de l’état de l’image, le modèle ignore l’instruction ou produit des artefacts de distorsion en tentant de concilier le conflit.
Si votre image montre une femme assise, les yeux fermés, et que votre prompt dit « elle ouvre les yeux et sort en courant », vous demandez au modèle de contredire sa propre entrée. Partez de l’état de l’image, pas à son encontre.
💡 Avant de rédiger votre prompt, écrivez une phrase décrivant précisément ce que montre votre image. Puis rédigez un prompt qui prolonge naturellement cet état. Cette seule habitude élimine la plupart des générations ratées.
Utiliser le langage de la génération d’images
Certaines formules qui fonctionnent dans les générateurs d’images perturbent activement les modèles vidéo :
- « Très détaillé, 8K, photoréaliste » — le modèle gère la résolution en interne ; ces mots gaspillent des tokens du prompt
- « Dans le style de [photographe] » — les références de style fonctionnent pour la composition statique, pas pour décrire un mouvement dans le temps
- « Étalonnage cinématographique » — l’étalonnage est appliqué en interne par le modèle ; cette formule ne dirige pas le mouvement
- « Mise au point nette, arrière-plan flou » — la mise au point est définie par votre image d’entrée ; le prompt ne doit pas redécrire l’état statique
Remplacez chacune de ces formules par une consigne de mouvement. Chaque token dépensé pour « très détaillé » est un token que vous n’avez pas utilisé pour demander à la caméra de s’élever.
Modèles image vers vidéo sur PicassoIA
PicassoIA héberge plus de 100 modèles de génération de vidéos, parmi les systèmes image vers vidéo les plus performants disponibles partout aujourd’hui.
Les meilleurs modèles pour les prompts de mouvement
| Modèle | Point fort | Qualité de sortie |
|---|
| Wan 2.7 I2V | Animation de scène détaillée, forte fidélité du mouvement | 720p |
| Kling v3 Motion Control | Précision de la trajectoire de caméra, mouvement cinématographique | 1080p |
| Kling v3 Omni Video | Vidéo de haute qualité à partir de texte et d’image | 1080p |
| Seedance 2.0 | Mouvement réaliste et fluide avec audio natif | 1080p |
| Gen4 Turbo | Image vers vidéo rapide, idéal pour les itérations rapides | 720p |
| Ovi I2V | Animation de personnages avec audio synchronisé | 720p |
| Video 01 Live | Animation naturelle de photos fixes | 1080p |
| Wan 2.5 I2V | Équilibre entre qualité et vitesse pour un usage quotidien | 720p |
| Hailuo 2.3 | Qualité de sortie cinématographique en 1080p | 1080p |
| LTX 2 Pro | Qualité maximale, sortie en 4K | 4K |
Comment utiliser Wan 2.7 I2V sur PicassoIA
Wan 2.7 I2V figure constamment parmi les meilleurs modèles image vers vidéo pour une animation réactive aux prompts. Voici comment obtenir des résultats fiables :
- Importez votre image de départ dans l’interface du modèle. Une largeur minimale de 512 px fournit au modèle assez de données de pixels pour un mouvement cohérent.
- Rédigez votre prompt avec l’une des deux formules. Action du sujet en premier, puis mouvement de caméra, puis atmosphère. Gardez la première phrase entièrement consacrée à ce que fait le sujet.
- Choisissez la résolution : 720p offre le meilleur rapport qualité-vitesse pour la plupart des usages. Utilisez-la par défaut.
- Itérez en changeant les verbes : générez trois variantes du même prompt avec des verbes de mouvement différents. « Dérive » et « glisse » donnent des impressions de mouvement différentes à partir d’entrées identiques. Le vocabulaire des verbes est votre principal levier d’itération.
- Quand le mouvement est trop discret : si Wan 2.7 donne des résultats trop retenus, passez le même prompt dans Kling v3 Motion Control. Kling produit de façon constante un mouvement plus marqué à partir du même texte, ce qui fait de ces deux modèles des compléments naturels pour trouver la bonne intensité de mouvement.
Exemples de prompts réels
Voici quatre prompts complets, prêts à l’emploi, pour quatre types d’images courants. Reprenez la structure et adaptez les détails à vos propres images.
Animation de portrait
Image de départ : personne regardant légèrement à gauche, lumière douce de studio
Prompt : « Elle tourne lentement la tête vers la caméra, un léger sourire se dessinant au coin de sa bouche. La caméra reste immobile, verrouillée. Une lumière de studio douce et diffuse venant du haut à gauche accroche sa pommette et le bord de son épaule. »
Meilleurs modèles : Ovi I2V, Video 01 Live
Mouvement de paysage
Image de départ : canopée d’une forêt d’automne, rivière visible depuis un angle aérien
Prompt : « La surface de la rivière capte la lumière tandis que la caméra descend doucement vers l’eau, les cimes des arbres s’écartant de chaque côté. La brume traverse la partie supérieure de la canopée. La lumière passe de l’ambre à un or chaud à mesure que l’angle de descente change. »
Meilleurs modèles : Wan 2.7 I2V, Wan 2.6 I2V
Présentation de produit
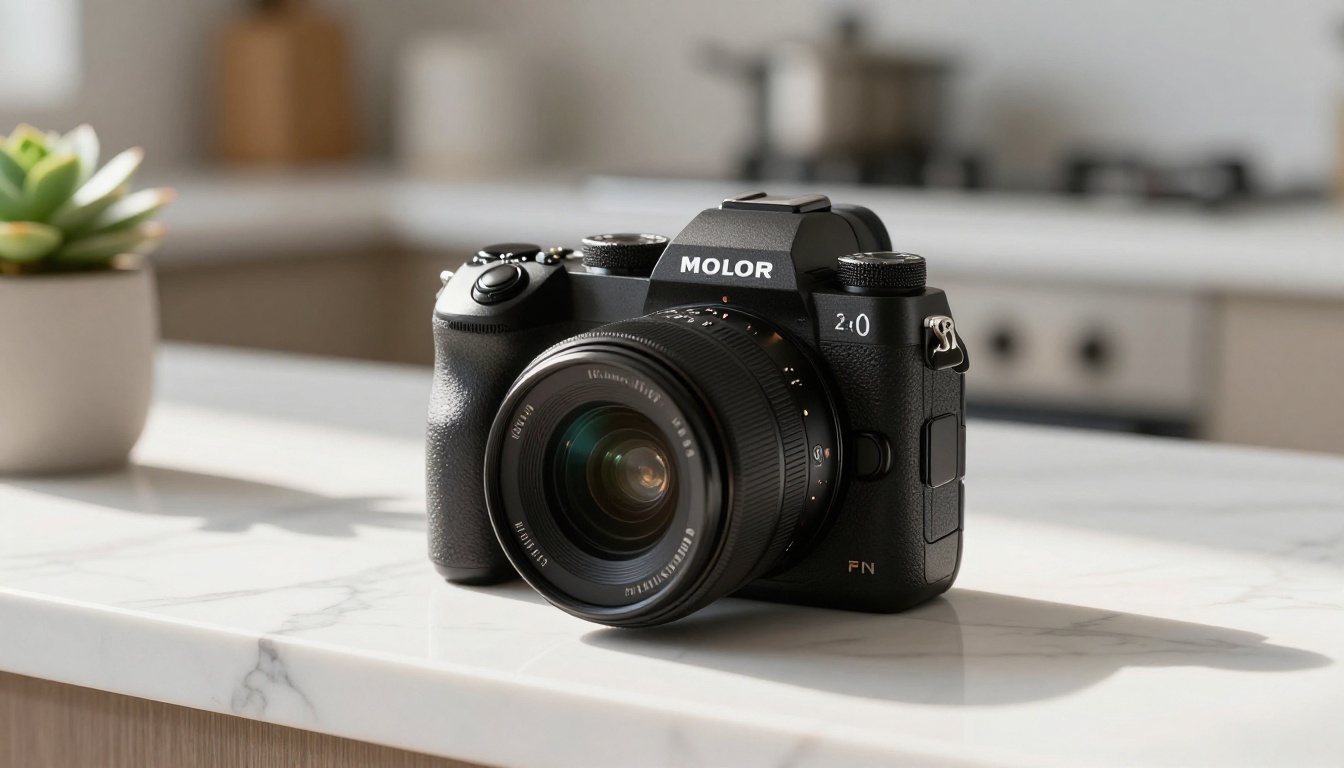
Image de départ : boîtier d’appareil photo sur un plan de travail en marbre, lumière de fenêtre visible
Prompt : « Le boîtier de l’appareil photo reste immobile sur la surface de marbre pendant qu’une lente orbite de 180 degrés commence depuis le côté droit, révélant progressivement la texture de la poignée et les détails des molettes. La tache de lumière glisse sur les veines du marbre à mesure que l’angle change. Fluide, continu, commercial. »
Meilleurs modèles : Gen4 Turbo, Seedance 2.0
Séquence d’action
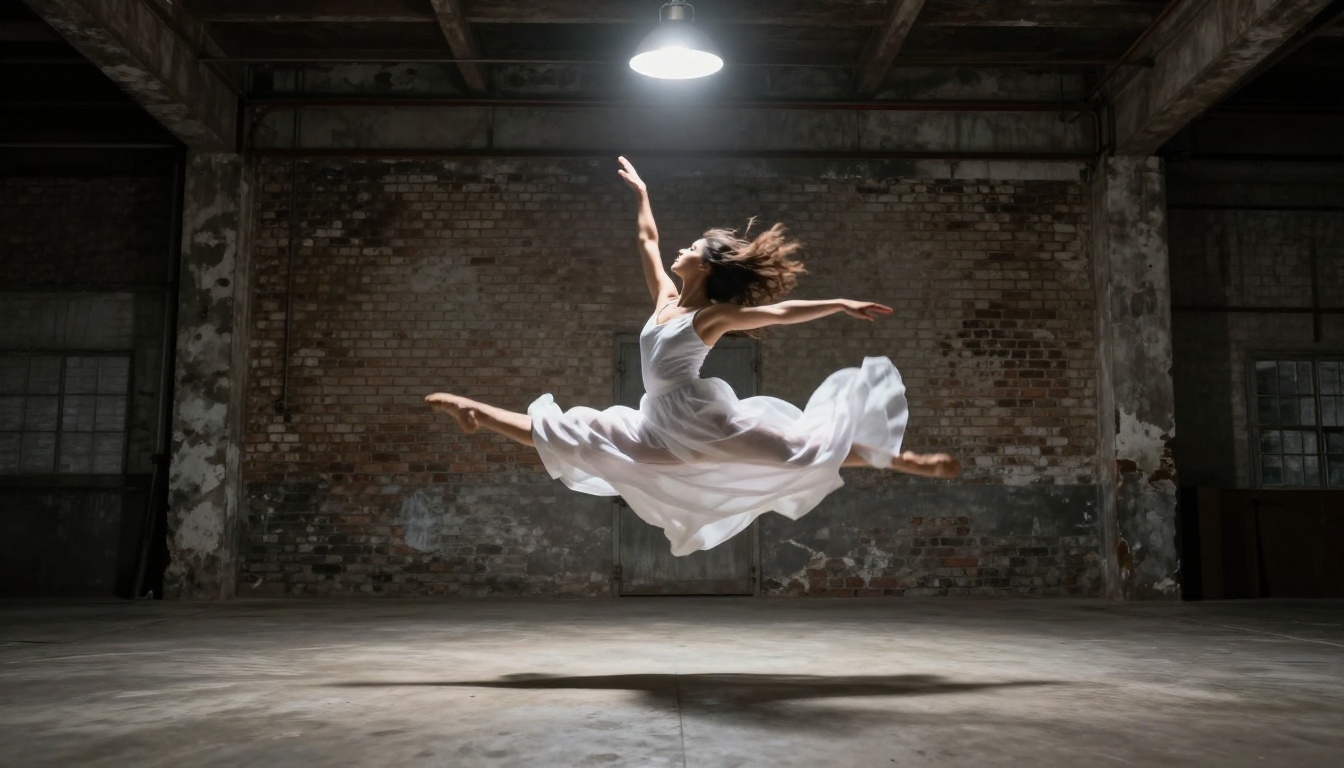
Image de départ : danseuse en plein saut dans un entrepôt
Prompt : « Elle retombe de son saut et enchaîne aussitôt une lente pirouette, les bras s’ouvrant de chaque côté du corps. La caméra s’élève légèrement et dérive vers la gauche, en gardant la danseuse centrée dans le cadre tout du long. L’unique lampe suspendue projette son ombre tournoyante sur le sol en béton en dessous d’elle. Contrasté, délibéré, contenu. »
Meilleurs modèles : Kling v3 Video, Hailuo 2.3
Ce qui distingue le bon du très bon
À ce stade, vous avez la structure : action du sujet, mouvement de caméra, atmosphère, dans le bon ordre, avec un vocabulaire précis. Ce qui sépare les résultats que vous supprimeriez de ceux que vous utiliseriez vraiment, c’est la précision sur la manière dont quelque chose bouge, et pas seulement sur ce qui bouge.
Comparez ces deux prompts pour la même image :
Passable : « Les feuilles soufflent dans le vent. »
Impressionnant : « Des feuilles isolées se détachent de l’extrémité des branches et tombent en spirales lentes, se retournant à mesure qu’elles descendent, tandis que la caméra s’élève doucement jusqu’à ce que la dernière se pose au sol. »
La seconde version décrit une trajectoire, une physique et la relation de la caméra à l’événement sur toute la durée du clip. Ce niveau de détail donne au modèle quelque chose de réel à exploiter, de la première image jusqu’à la 120e.
Une remarque pratique sur l’itération : si vos résultats commencent à se ressembler, changez vos verbes de mouvement avant de changer quoi que ce soit d’autre. Remplacez « lentement » par « progressivement ». Remplacez « dérive » par « glisse ». De petits changements de vocabulaire dans la phrase d’action du sujet produisent des mouvements sensiblement différents, car les modèles sont plus sensibles au choix du verbe qu’on ne le pense en général.
Vos images sont déjà prêtes
Chaque image que vous avez jamais réalisée est un cadre de départ potentiel. Les modèles de vidéo par IA sur PicassoIA se chargent du rendu. Votre rôle est de décrire ce qui se passe ensuite, dans un langage de mouvement que le modèle peut exécuter.
Choisissez une image. Écrivez une phrase d’action pour le sujet. Ajoutez un mouvement de caméra. Ajoutez une note d’atmosphère. Collez le tout dans Wan 2.7 I2V ou Seedance 2.0 et lancez la génération. Le résultat sera nettement meilleur que tout ce que vous obteniez avant d’appliquer cette structure. Changez ensuite un seul verbe et relancez. C’est ainsi que la pratique de l’écriture de prompts se construit réellement.
Parcourez les plus de 100 modèles de génération de vidéos sur picassoia.com/en/all-models et commencez par le modèle du tableau ci-dessus qui correspond le mieux à votre cas d’usage.


