Google acaba de lanzar Imagen 4, y cambia el panorama competitivo de la generación de texto a imagen de formas que importan tanto a profesionales como a creadores ocasionales. Si has seguido este campo desde los días de las salidas borrosas de 512x512 hasta la generación casi fotorrealista de hoy, sabes lo rápido que se mueven los benchmarks. Imagen 4 se sitúa en la cima de la línea de generación de imágenes de Google DeepMind, y aporta mejoras importantes en todas las dimensiones que importan: fotorrealismo, adherencia al prompt y renderizado de texto dentro de las imágenes.
Este artículo lo explica todo lo que necesitas saber. Qué hace realmente Imagen 4, cómo funciona su arquitectura, en qué punto se encuentra frente a DALL-E 3, Flux y Midjourney, y qué significa para cualquiera que trabaje con herramientas de imagen con IA.
Qué hace realmente Imagen 4
Fotorrealismo en un nuevo estándar
La mejora más visible de Imagen 4 es lo reales que parecen sus resultados. Las versiones anteriores de la serie Imagen tenían una suavidad característica, sobre todo en detalles finos como el cabello, las texturas de las telas y la luz reflejada. Imagen 4 resuelve gran parte de ese problema.
El modelo produce imágenes de hasta 2K de resolución de forma nativa, con grano, profundidad de campo y renderizado de materiales que en muchas condiciones rivaliza con la fotografía de estudio. Los retratos muestran textura de piel hasta el nivel de los poros. Los paisajes renderizan la luz volumétrica con esa neblina atmosférica que captarías con una cámara de fotograma completo. Los pliegues de la tela y los reflejos especulares en superficies de vidrio resisten una inspección de cerca.
El detalle fotorrealista a este nivel antes solo se lograba combinando un modelo base potente con varias pasadas de escalado y refinamiento. Imagen 4 lo consigue en un único paso de generación.
💡 Imagen 4 puede renderizar grano de película visible, imperfecciones de lente y aberración cromática cuando se le pide "fotografía analógica" o "toma analógica". El modelo ha sido entrenado para distinguir los artefactos fotográficos auténticos del ruido digital.
El texto en las imágenes: un problema de larga data resuelto
El renderizado de texto en imágenes ha sido el punto débil de todos los modelos de generación de imágenes durante años. DALL-E 3 avanzó de forma notable. Midjourney v6 mejoró. Imagen 4 es el primer modelo que maneja texto complejo y de varias palabras en imágenes con una precisión constante.
Pide un letrero de tienda con un nombre de negocio concreto, una portada de revista con un titular o una inscripción en una tarta de cumpleaños, e Imagen 4 renderiza las letras correctamente en la gran mayoría de los casos. No es un logro menor. Las arquitecturas de difusión anteriores tenían problemas con el texto porque los caracteres no mantienen relaciones espaciales coherentes durante el proceso de eliminación de ruido. El codificador de texto más grande de Imagen 4 y su ajuste fino con RLHF parecen haber resuelto esto a nivel arquitectónico.
La adherencia al prompt llega más lejos
Más allá de la calidad visual, Imagen 4 sigue los prompts con una precisión poco habitual. Las instrucciones de composición como "una silla roja a la izquierda del encuadre con una ventana detrás" se traducen en el resultado con las relaciones espaciales indicadas realmente respetadas.
Esto importa a los profesionales. Un fotógrafo de producto que necesita una disposición concreta, un diseñador gráfico que busca un ambiente determinado, un creador de contenido que necesita una escena sin reconstruirla cinco veces. Imagen 4 reduce de forma notable ese ciclo de iteraciones.
Cómo se compara con la competencia
Imagen 4 frente a DALL-E 3
DALL-E 3, integrado en ChatGPT, sigue teniendo el mayor alcance. La mayoría de las personas que han generado una imagen con IA lo han hecho a través de la interfaz de OpenAI. Imagen 4 se adelanta en calidad visual pura en comparaciones directas. DALL-E 3 tiende a un aspecto algo estilizado e ilustrativo incluso con ajustes de alto fotorrealismo. Los resultados de Imagen 4 se parecen más a fotografías tomadas con una cámara que a renders de software.
| Característica | Imagen 4 | DALL-E 3 |
|---|
| Fotorrealismo | Muy alto | Alto |
| Renderizado de texto | Excelente | Bueno |
| Adherencia al prompt | Excelente | Muy buena |
| Resolución | Hasta 2K | 1024x1024 nativa |
| Acceso | Google AI Studio, Vertex AI | ChatGPT, API |
Imagen 4 frente a Flux
Flux Pro de Black Forest Labs es ahora mismo el competidor de código abierto más sólido. Flux 1.1 Pro es accesible, muy utilizado y produce resultados impresionantes en fotografía de retrato y de moda. Flux 2 Pro y Flux 2 Max llegan aún más lejos en resolución y detalle.
Donde los modelos Flux tienden a superar a Imagen 4 es en la flexibilidad estilística. El ecosistema Flux admite modelos LoRA ajustados, guía de pose con ControlNet y flujos de relleno e inpainting. Imagen 4 es un modelo con un criterio más marcado. Destaca en fotorrealismo, pero no tiene el ecosistema de modificadores que Flux ha ido construyendo con el tiempo.
En calidad de imagen pura en escenas fotorrealistas, Imagen 4 compite con Flux 2 Max. Para el control creativo y la amplitud de estilos, gana Flux.
💡 Flux 2 Pro y Flux 2 Max están disponibles ahora en PicassoIA. Si estás comparando tus propios resultados con Imagen 4, estos son los puntos de referencia adecuados.
Imagen 4 frente a Midjourney
Midjourney v7 sigue llevándose la corona en calidad estética para resultados estilizados, artísticos y cinematográficos. La comunidad ha creado una gran biblioteca de convenciones de prompts que producen resultados bellos de forma fiable. Imagen 4 no intenta competir en ese terreno.
Donde Imagen 4 gana a Midjourney es en seguir instrucciones para escenas concretas y factuales. Midjourney interpreta los prompts de forma creativa, a menudo embelleciendo o abstrayendo de maneras que se alejan de la descripción literal. Imagen 4 trata el prompt más como una especificación que como una sugerencia.
| Caso de uso | Mejor opción |
|---|
| Imágenes artísticas o estilizadas | Midjourney v7 |
| Retratos fotorrealistas | Imagen 4 o Flux 2 Max |
| Renderizado de texto en imágenes | Imagen 4 |
| Fotografía de producto | Imagen 4 o Flux Pro |
| Código abierto o acceso por API | Modelos Flux |
| Generación por lotes de gran volumen | Serie GPT Image |
La arquitectura detrás del resultado
Un cerebro de lenguaje más grande para imágenes
Imagen 4 se basa en la arquitectura de modelo de difusión en cascada que Google introdujo en la serie Imagen original. La idea básica: generar una imagen de baja resolución y aplicar después etapas sucesivas de difusión con sobremuestreo para añadir detalle en cada escala.
Lo que cambió en Imagen 4 es el modelo de condicionamiento. Google amplió de forma notable el codificador de texto, usando una variante de su modelo de lenguaje T5 para procesar los prompts con mayor profundidad. Por eso el renderizado de texto y el razonamiento espacial mejoraron tanto. El modelo no se limita a asociar palabras con parches de imagen. Analiza las relaciones semánticas del prompt y las usa para acotar la generación en cada paso de difusión.
El resultado es un modelo en el que las instrucciones complejas se traducen con más frecuencia en resultados coherentes, con menos alucinaciones de objetos o sujetos mal colocados en la escena.
Aprendizaje por refuerzo a partir de retroalimentación humana
Google ha afirmado que Imagen 4 pasó por varias etapas de RLHF (aprendizaje por refuerzo a partir de retroalimentación humana), dirigidas específicamente a la adherencia al prompt y la calidad estética. Es el mismo método que hizo que los modelos GPT siguieran mucho mejor las instrucciones en lenguaje natural, ahora aplicado a la generación de imágenes a gran escala.
En la práctica, Imagen 4 se comporta más como un modelo calibrado por la preferencia humana que como uno que simplemente se entrenó con un gran conjunto de datos. Cuando los resultados se apartan de lo que los usuarios quieren de verdad, el entrenamiento con RLHF devuelve al modelo hacia la alineación. Esto se nota sobre todo en la precisión de la composición y en que el modelo evita de forma constante artefactos habituales de generación, como sombras desalineadas o manos anatómicamente incorrectas.
Dónde puedes acceder a Imagen 4
Google AI Studio
Google AI Studio es el principal punto de acceso para el público. A través de la interfaz de Gemini, Imagen 4 está disponible para generar imágenes a partir de prompts de texto directamente en el navegador. La interfaz es limpia y rápida. No necesitas gestionar parámetros de difusión ni ajustes de muestreador. Escribe un prompt y obtén una imagen.
Para quienes llegan desde Midjourney o la generación de imágenes de ChatGPT, la experiencia resulta familiar. Los resultados tienden a verse pulidos desde el primer momento, sin necesidad de un ajuste extenso del prompt para alcanzar una calidad aceptable.
Vertex AI para uso en producción
Para el acceso por API y los despliegues en producción, Google ofrece Imagen 4 a través de Vertex AI. Es el nivel empresarial, pensado para pipelines de producción, generación de gran volumen e integración en productos y aplicaciones existentes.
Vertex AI también da acceso a Imagen 4 Ultra, la versión de mayor calidad, orientada específicamente a casos de uso profesionales y comerciales. El nivel Ultra produce un detalle notablemente más nítido y una precisión de color mejor que el endpoint de API estándar.
Integrado en Google Workspace
Google ha integrado Imagen 4 en productos de Workspace como Slides, Docs y Meet. Las funciones de generación de imágenes de estas herramientas funcionan con Imagen en segundo plano, lo que lo convierte en uno de los modelos de generación de imágenes más desplegados por número de usuarios, aunque reciba menos atención en la comunidad entusiasta que Midjourney o las versiones de Stable Diffusion.
Escribir prompts que funcionan con Imagen 4
La especificidad da sus frutos
La fuerte adherencia al prompt de Imagen 4 significa que recibes lo que pones. Los prompts vagos siguen produciendo buenas imágenes, pero el modelo premia la especificidad. En lugar de "una mujer en la playa", prueba con "una mujer con un vestido de lino crema de pie sobre una costa rocosa al atardecer dorado, mirando hacia otro lado de la cámara". El contexto adicional se traduce directamente en el resultado.
Esto difiere de cómo funciona Midjourney. Con Midjourney, los prompts cortos y evocadores suelen superar a los largos y descriptivos, porque el modelo interpreta con libertad y añade sus propias decisiones estéticas. Imagen 4 es más literal. Aprovéchalo a tu favor.
💡 Para resultados fotorrealistas, añade lenguaje específico de cámara: "tomada con 85mm f/1.8, Kodak Portra 400, luz natural desde la izquierda". Imagen 4 ha sido entrenado para asociar este vocabulario con el realismo fotográfico y aplica la estética de forma constante.
3 estilos de prompt que mejor funcionan
Tres marcos que producen resultados sólidos con Imagen 4 de forma constante:
- Prompts de fotografía: especificaciones de cámara, tipo de película, dirección de la luz, características de la lente. "Fotografía aérea, lente de 24mm, f/8, hora dorada, Sony A1"
- Descripción de escena: sujeto, entorno, hora del día, ambiente. "Un cruce concurrido de Tokio de noche, reflejos de lluvia en el asfalto, desenfoque por movimiento en los peatones"
- Dirección de composición: ángulo de cámara, encuadre, relaciones de profundidad. "Toma en contrapicado mirando hacia arriba, poca profundidad de campo, sujeto del primer plano nítido, fondo bokeh"
Lo que todavía no funciona bien
Algunos patrones de prompt producen resultados irregulares con Imagen 4:
- Pedir varias cadenas de texto distintas en una misma imagen (sigue siendo poco fiable con más de dos elementos de texto)
- Conceptos muy abstractos o surrealistas que requieren una metáfora visual en lugar de una descripción literal
- Peticiones concretas de estilos visuales protegidos por derechos de autor o de parecidos de celebridades (se aplica un filtrado de seguridad estricto)
La carrera más amplia de la generación de imágenes con IA
Flux 2 y el impulso de los modelos abiertos
Flux 2 Pro y Flux 2 Max representan la competencia más sólida de arquitectura abierta frente a Imagen 4. Estos modelos no están encerrados tras una API cerrada. Los desarrolladores pueden desplegarlos, ajustarlos mediante ajuste fino y construir aplicaciones especializadas sobre ellos.
Esta es una diferencia estructural con Imagen 4. Imagen funciona en la infraestructura de Google y bajo las condiciones de Google. El ecosistema Flux es distribuido, modificable y ampliable. Para muchos casos de uso profesionales, esa apertura pesa más que las puntuaciones de los benchmarks.
Recraft V4 Pro es otro contendiente sólido para flujos de trabajo de diseño gráfico e ilustración. Produce una tipografía excepcionalmente limpia y una precisión de tipo vectorial, lo que lo convierte en la opción adecuada para activos de marca y maquetas de diseño en los que Imagen 4 podría sobrecargar el resultado de texturas.
GPT Image 1.5 y GPT Image 2
Los modelos de generación de imágenes de OpenAI siguen siendo centrales en esta carrera. GPT Image 1.5 y GPT Image 2 están muy integrados en la experiencia de ChatGPT y ofrecen un rendimiento sólido en el seguimiento de instrucciones, sobre todo en escenas que requieren interpretar descripciones contextuales complejas. La serie GPT Image se beneficia de la profundidad de los modelos de lenguaje de OpenAI: la edición de ida y vuelta mediante conversación resulta más natural que con modelos de imagen independientes.
Imagen 4 compite directamente con la serie GPT Image en adherencia al prompt y fotorrealismo. Ninguno de los dos modelos tiene una ventaja definitiva en todos los casos de uso.
Ideogram V3 y los especialistas en tipografía
Ideogram V3 Turbo y Ideogram V3 Quality construyeron su reputación con un renderizado de texto preciso mucho antes de que llegara Imagen 4. Ideogram sigue siendo el especialista cuando el requisito principal es una tipografía limpia y legible integrada en las imágenes. Para carteles, gráficos para redes sociales y visuales de marketing con textos concretos, Ideogram mantiene una ventaja nacida de un enfoque arquitectónico deliberado en el problema del texto dentro de la imagen.
Las mejoras de texto de Imagen 4 reducen mucho esa distancia, pero Ideogram ofrece resultados más precisos con regularidad cuando el texto es el centro de la imagen y no un detalle accesorio.
Qué significa esto para los creadores
El techo de calidad sigue subiendo
Hace dos años, detectar una imagen generada por IA era en su mayoría sencillo. Hoy, los resultados de Imagen 4, Flux 2 Max y Midjourney v7 son funcionalmente indistinguibles de la fotografía para la mayoría de los espectadores y en la mayoría de los contextos. El techo de calidad ha superado el punto en el que esa distinción tiene peso práctico para la mayoría de las aplicaciones.
Esto cambia la forma en que los creadores deben pensar en las herramientas de imagen con IA. La pregunta ya no es "¿es lo bastante bueno?". Es "¿qué herramienta hace lo que necesito, a qué costo, con qué flujo de trabajo?".
La especialización frente a los flujos de trabajo con un solo modelo
A medida que cada modelo se fortalece, también se diferencian. Imagen 4 destaca en fotorrealismo y renderizado de texto. Midjourney v7 domina el espacio estético artístico. Los modelos Flux ofrecen programabilidad y ajuste fino. Ideogram es el referente en tipografía. Recraft sirve al diseño gráfico.
Ningún modelo domina todos los casos de uso. Los profesionales que trabajen con generación de imágenes con IA en 2027 construirán flujos de trabajo con varios modelos, eligiendo la herramienta adecuada para cada resultado concreto en lugar de usar una sola plataforma para todo.
💡 El enfoque multimodelo es más práctico en plataformas que te dan acceso a todos ellos en un mismo lugar. Comparar resultados entre modelos con el mismo prompt es la forma más rápida de calibrar qué modelo encaja con cada tarea.
Crea tus propias imágenes con IA ahora
Imagen 4 elevó el listón de lo que un modelo de texto a imagen puede hacer en fotorrealismo, renderizado de texto y adherencia al prompt. Es el modelo de generación de imágenes más capaz de Google hasta la fecha, y compite en serio con cualquier otro modelo de primer nivel del sector.
Pero la idea más importante de este momento en la generación de imágenes con IA no tiene que ver con un modelo concreto. Es que el campo ha alcanzado un nivel de capacidad en el que la herramienta adecuada depende de tu tarea específica, y tener acceso a todas ellas en un solo lugar es una ventaja real.
En PicassoIA puedes trabajar con Flux Pro, Flux 2 Max, GPT Image 2, Recraft V4 Pro, Ideogram V3 Turbo y más de 90 otros modelos de texto a imagen, todo en un mismo lugar. Elige un prompt, ejecútalo en varios modelos y observa las diferencias directamente. Esa es la forma más rápida de ver lo que hace realmente cada modelo, no leyendo sobre ello, sino ejecutando tus propios prompts y comparando los resultados lado a lado.
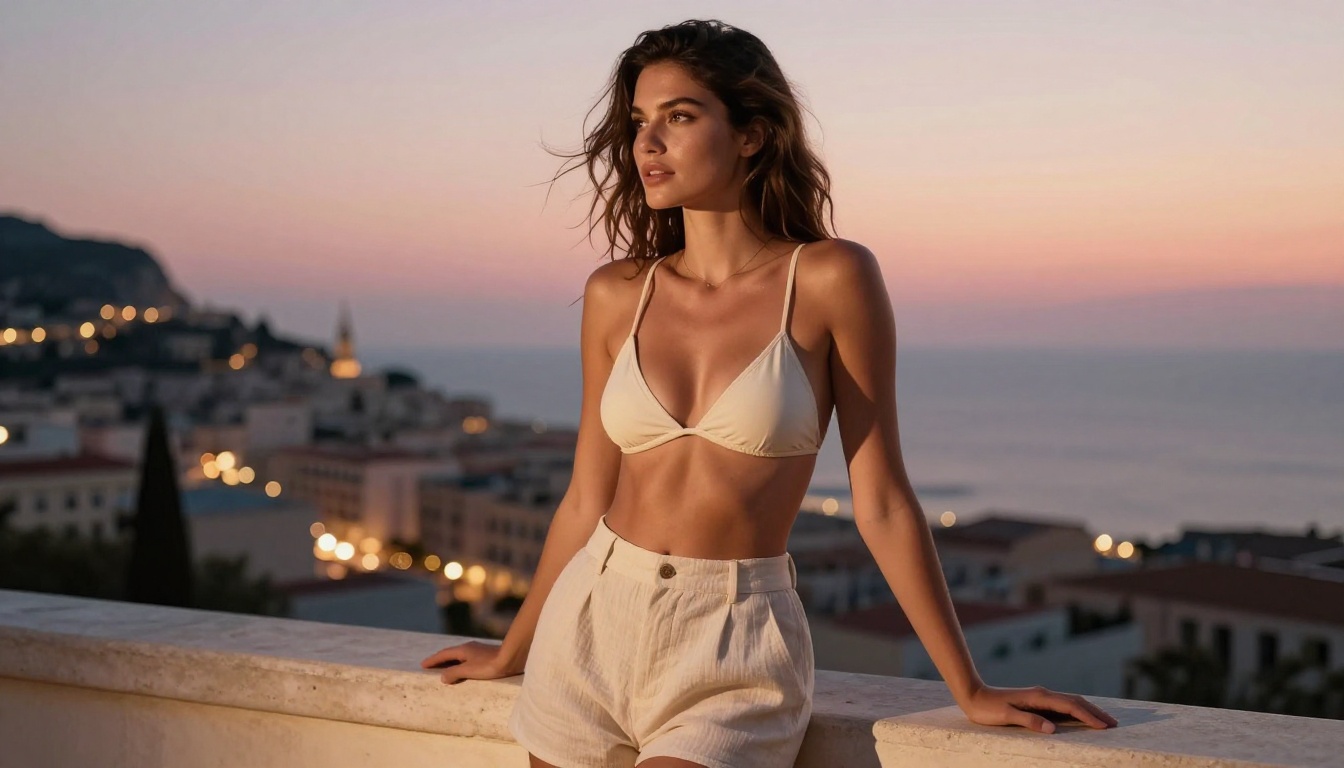
Elige un sujeto. Escribe un prompt. Mira qué producen con él, ahora mismo, los mejores modelos de generación de imágenes del mundo.


