Google vient de publier Imagen 4, qui redistribue les cartes dans la génération de texte vers image, de façon qui compte aussi bien pour les professionnels que pour les créateurs occasionnels. Si vous suivez ce domaine depuis l’époque des résultats flous en 512x512 jusqu’à la génération quasi photoréaliste d’aujourd’hui, vous savez à quelle vitesse les benchmarks évoluent. Imagen 4 se place au sommet de la gamme de génération d’images de Google DeepMind, et apporte des améliorations notables sur tous les critères qui comptent : le photoréalisme, le respect des prompts et le rendu de texte dans les images.
Cet article passe en revue tout ce qu’il faut savoir. Ce que fait réellement Imagen 4, comment fonctionne son architecture, sa position face à DALL-E 3, Flux et Midjourney, et ce que cela change pour quiconque travaille avec des outils d’IA pour les images.
Ce que fait réellement Imagen 4
Le photoréalisme à un nouveau niveau
La progression la plus visible d’Imagen 4 tient au réalisme des résultats. Les versions précédentes de la série Imagen avaient une douceur caractéristique, notamment sur les détails fins comme les cheveux, les textures de tissu et les reflets de lumière. Imagen 4 corrige l’essentiel de ce défaut.
Le modèle produit des images allant jusqu’à 2K de résolution en natif, avec un grain, une profondeur de champ et un rendu des matières qui rivalisent avec la photographie de studio dans de nombreuses conditions. Les portraits montrent une texture de peau au niveau du pore. Les paysages restituent une lumière volumétrique avec la brume atmosphérique que l’on obtiendrait avec un appareil plein format. Les plis des tissus et les reflets spéculaires sur les surfaces vitrées tiennent à l’examen de près.
Un détail photoréaliste à ce niveau n’était auparavant accessible qu’en combinant un modèle de base performant à plusieurs passes d’upscaling et de raffinement. Imagen 4 l’obtient en une seule étape de génération.
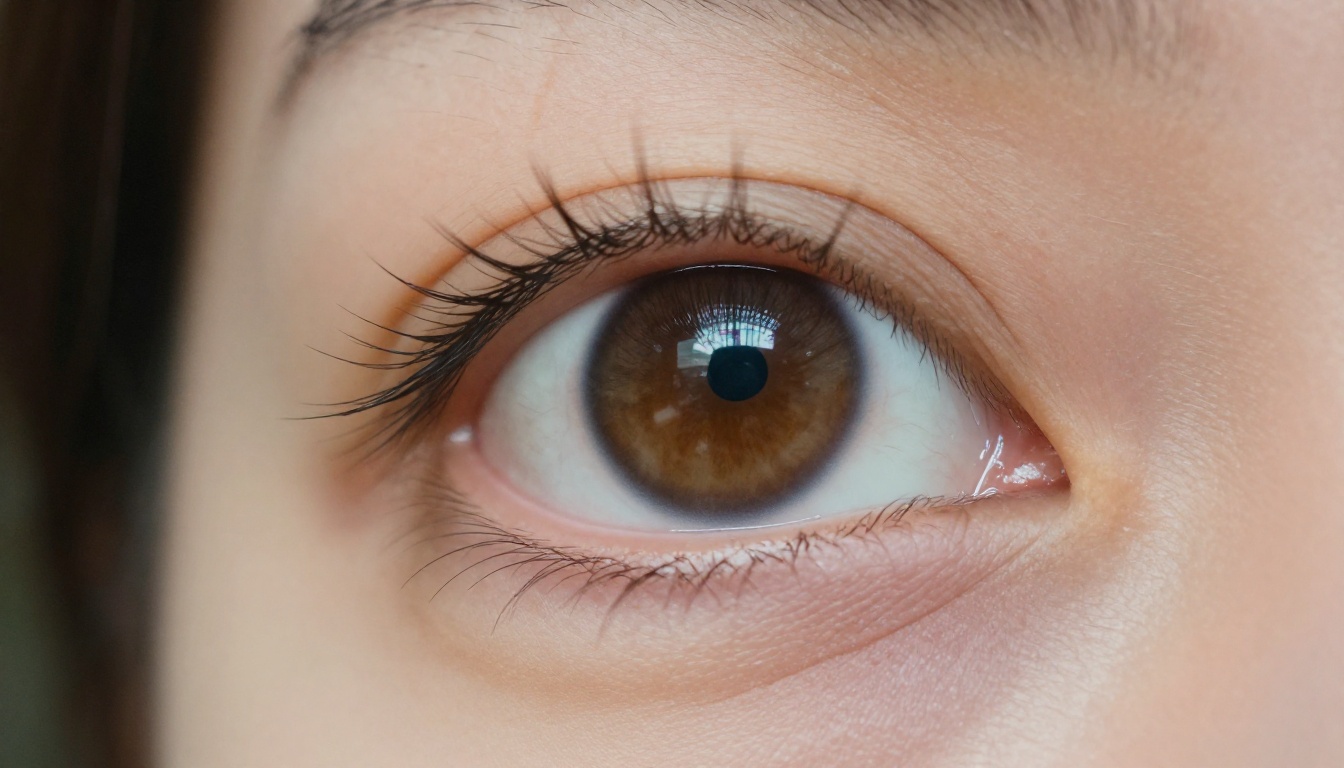
💡 Imagen 4 peut restituer un grain de film visible, des imperfections d’objectif et une aberration chromatique lorsqu’on lui demande une « photographie argentique » ou un « plan analogique ». Le modèle a été entraîné à distinguer les artefacts photographiques authentiques du bruit numérique.
Le texte dans les images : un problème de longue date enfin résolu
Le rendu de texte dans les images a été le point faible de tous les modèles de génération d’images pendant des années. DALL-E 3 a fait des progrès significatifs. Midjourney v6 s’est amélioré. Imagen 4 est le premier modèle à gérer des textes complexes, composés de plusieurs mots, avec une précision constante.
Demandez une enseigne de magasin portant un nom commercial précis, une couverture de magazine avec un titre ou une inscription sur un gâteau d’anniversaire, et Imagen 4 restitue correctement les lettres dans la grande majorité des cas. Ce n’est pas un exploit anodin. Les architectures de diffusion antérieures peinaient avec le texte, car les caractères n’ont pas de relations spatiales cohérentes pendant le processus de débruitage. L’encodeur de texte plus grand d’Imagen 4 et son fine-tuning par RLHF semblent avoir résolu ce problème au niveau architectural.
Le respect des prompts va plus loin
Au-delà de la qualité visuelle, Imagen 4 suit les prompts avec une précision inhabituelle. Des consignes de composition comme « une chaise rouge à gauche du cadre, avec une fenêtre derrière elle » se retrouvent dans le résultat, avec les relations spatiales indiquées effectivement respectées.
Cela compte pour les professionnels. Un photographe produit qui a besoin d’un agencement précis, un graphiste qui recherche une ambiance particulière, un créateur de contenu qui veut une scène sans la reconstruire cinq fois. Imagen 4 réduit nettement cette boucle d’itérations.
Imagen 4 ou DALL-E 3
DALL-E 3, intégré à ChatGPT, conserve la plus large audience. La plupart des personnes ayant généré une image par IA l’ont fait via l’interface d’OpenAI. Imagen 4 l’emporte en matière de qualité visuelle pure dans les comparaisons directes. DALL-E 3 tend vers un rendu légèrement stylisé, presque illustratif, même avec des réglages de photoréalisme élevés. Les rendus d’Imagen 4 ressemblent davantage à des photographies prises avec un appareil qu’à des rendus issus d’un logiciel.
| Caractéristique | Imagen 4 | DALL-E 3 |
|---|
| Photoréalisme | Très élevé | Élevé |
| Rendu de texte | Excellent | Bon |
| Respect des prompts | Excellent | Très bon |
| Résolution | Jusqu’à 2K | 1024x1024 natif |
| Accès | Google AI Studio, Vertex AI | ChatGPT, API |
Imagen 4 ou Flux
Flux Pro de Black Forest Labs est actuellement le principal concurrent open source. Flux 1.1 Pro est accessible, largement utilisé et produit des résultats saisissants pour la photographie de portrait et de mode. Flux 2 Pro et Flux 2 Max vont encore plus loin en matière de résolution et de détail.
Là où les modèles Flux tendent à dépasser Imagen 4, c’est dans la souplesse stylistique. L’écosystème Flux prend en charge les modèles LoRA issus de fine-tuning, le guidage de pose ControlNet ainsi que les flux de travail de remplissage et d’inpainting. Imagen 4 est un modèle plus affirmé. Il excelle en photoréalisme, mais ne dispose pas de l’écosystème de modificateurs que Flux a construit au fil du temps.
Pour la qualité d’image brute dans des scènes photoréalistes, Imagen 4 rivalise avec Flux 2 Max. Pour le contrôle créatif et la diversité des styles, Flux l’emporte.
💡 Flux 2 Pro et Flux 2 Max sont disponibles dès maintenant sur PicassoIA. Si vous comparez vos propres résultats à Imagen 4, ce sont les bons points de référence.
Imagen 4 ou Midjourney
Midjourney v7 reste en tête pour la qualité esthétique des rendus stylisés, artistiques et cinématographiques. La communauté a constitué une vaste bibliothèque de conventions de prompts qui produisent des résultats régulièrement très beaux. Imagen 4 n’essaie pas de rivaliser sur ce terrain.
Là où Imagen 4 prend l’avantage sur Midjourney, c’est dans le suivi des instructions pour des scènes précises et factuelles. Midjourney interprète les prompts de façon créative, en embellissant ou en abstrayant souvent, ce qui s’écarte de la description littérale. Imagen 4 traite le prompt davantage comme une spécification que comme une suggestion.
| Cas d’usage | Meilleure option |
|---|
| Images artistiques ou stylisées | Midjourney v7 |
| Portraits photoréalistes | Imagen 4 ou Flux 2 Max |
| Rendu de texte dans les images | Imagen 4 |
| Photographie produit | Imagen 4 ou Flux Pro |
| Accès open source ou API | Modèles Flux |
| Génération en grand volume | Série GPT Image |
L’architecture derrière le résultat
Un cerveau de langage plus grand pour les images
Imagen 4 repose sur l’architecture de modèle de diffusion en cascade que Google avait introduite dans la série Imagen d’origine. Le principe de base : générer une image basse résolution, puis appliquer des étapes successives de diffusion par suréchantillonnage pour ajouter des détails à chaque échelle.
Ce qui a changé dans Imagen 4, c’est le modèle de conditionnement. Google a considérablement agrandi l’encodeur de texte, en utilisant une variante de son modèle de langage T5 pour traiter les prompts en profondeur. C’est pourquoi le rendu de texte et le raisonnement spatial ont tant progressé. Le modèle ne se contente pas d’associer des mots à des zones de l’image. Il analyse les relations sémantiques du prompt et s’en sert pour contraindre la génération à chaque étape de diffusion.
Le résultat est un modèle qui traduit plus souvent des consignes complexes en images cohérentes, avec moins d’objets hallucinés ou de sujets mal placés dans la scène.
L’apprentissage par renforcement à partir de retours humains
Google a indiqué qu’Imagen 4 a suivi plusieurs étapes de RLHF (apprentissage par renforcement à partir de retours humains), visant spécifiquement le respect des prompts et la qualité esthétique. C’est la même méthode qui a rendu les modèles GPT nettement meilleurs pour suivre des instructions en langage naturel, appliquée désormais à la génération d’images à grande échelle.
En pratique, Imagen 4 se comporte davantage comme un modèle calibré par les préférences humaines que comme un simple modèle entraîné sur un vaste jeu de données. Lorsque les résultats s’écartent de ce que les utilisateurs souhaitent réellement, l’entraînement RLHF ramène le modèle vers l’alignement. Cela se voit surtout dans la précision de la composition et dans la façon dont le modèle évite systématiquement des artefacts courants comme des ombres mal alignées ou des mains anatomiquement incorrectes.
Où accéder à Imagen 4
Google AI Studio
Google AI Studio est le principal point d’accès grand public. Via l’interface Gemini, Imagen 4 permet de générer des images à partir de prompts textuels directement dans le navigateur. L’interface est épurée et rapide. Vous n’avez pas à gérer les paramètres de diffusion ni les réglages d’échantillonneur. Saisissez un prompt, obtenez une image.
Pour ceux qui viennent de Midjourney ou de la génération d’images de ChatGPT, l’expérience est familière. Les résultats sont généralement soignés dès le départ, sans qu’un long travail sur les prompts soit nécessaire pour atteindre une qualité acceptable.
Vertex AI pour la production
Pour l’accès API et les déploiements en production, Google propose Imagen 4 via Vertex AI. C’est l’offre entreprise, conçue pour les chaînes de production, la génération en grand volume et l’intégration dans des produits et applications existants.
Vertex AI donne aussi accès à Imagen 4 Ultra, la variante la plus haut de gamme, positionnée spécifiquement pour les cas d’usage professionnels et commerciaux. La version Ultra produit des détails nettement plus nets et une meilleure justesse des couleurs que le point d’accès API standard.
Intégré à Google Workspace
Google a intégré Imagen 4 aux produits Workspace, dont Slides, Docs et Meet. Les fonctions de génération d’images de ces outils reposent sur Imagen en arrière-plan, ce qui en fait l’un des modèles de génération d’images les plus déployés en nombre brut d’utilisateurs, même s’il suscite moins d’attention dans la communauté passionnée que Midjourney ou les versions de Stable Diffusion.
Rédiger des prompts efficaces avec Imagen 4
La précision paie
La forte capacité d’Imagen 4 à respecter les prompts signifie que vous obtenez ce que vous y mettez. Les prompts vagues produisent encore de bonnes images, mais le modèle récompense la précision. Au lieu de « une femme à la plage », essayez « une femme en robe de lin crème debout sur une côte rocheuse à l’heure dorée, regardant ailleurs que l’objectif ». Le contexte supplémentaire se traduit directement dans le résultat.
C’est différent de la façon dont fonctionne Midjourney. Avec Midjourney, des prompts courts et évocateurs surpassent souvent les descriptions longues, car le modèle interprète librement et ajoute ses propres choix esthétiques. Imagen 4 est plus littéral. Tirez-en parti.
💡 Pour des résultats photoréalistes, ajoutez un vocabulaire propre à l’appareil photo : « shot on 85mm f/1.8, Kodak Portra 400, natural light from left ». Imagen 4 a été entraîné à associer ce vocabulaire au réalisme photographique et en applique l’esthétique de manière constante.
3 styles de prompts qui fonctionnent le mieux
Trois cadres qui produisent systématiquement de bons résultats avec Imagen 4 :
- Prompts photographiques : caractéristiques de l’appareil, type de pellicule, direction de la lumière, particularités de l’objectif. « Aerial photography, 24mm lens, f/8, golden hour, Sony A1 »
- Description de scène : sujet, environnement, moment de la journée, ambiance. « A crowded Tokyo intersection at night, rain reflections on pavement, motion blur on pedestrians »
- Direction de composition : angle de prise de vue, cadrage, relations de profondeur. « Low angle shot looking upward, shallow depth of field, foreground subject sharp, background bokeh »
Ce qui ne fonctionne pas encore bien
Certains schémas de prompts donnent des résultats inconstants avec Imagen 4 :
- Demander plusieurs chaînes de texte distinctes dans une même image (encore peu fiable au-delà de deux éléments textuels)
- Concepts très abstraits ou surréalistes qui nécessitent une métaphore visuelle plutôt qu’une description littérale
- Demandes précises de styles visuels protégés par le droit d’auteur ou de ressemblances de célébrités (un filtrage de sécurité strict s’applique)
La course plus large de la génération d’images par IA
Flux 2 et la poussée des modèles ouverts
Flux 2 Pro et Flux 2 Max constituent la concurrence open-architecture la plus solide face à Imagen 4. Ces modèles ne sont pas enfermés derrière une API fermée. Les développeurs peuvent les déployer, les affiner et construire des applications spécialisées par-dessus.
C’est une différence structurelle avec Imagen 4. Imagen fonctionne sur l’infrastructure de Google, selon les conditions de Google. L’écosystème Flux est distribué, modifiable et extensible. Pour de nombreux cas d’usage professionnels, cette ouverture compte davantage que les scores bruts des benchmarks.
Recraft V4 Pro est un autre concurrent sérieux pour les flux de travail de design graphique et d’illustration. Il produit une typographie exceptionnellement nette et une précision proche du vectoriel, ce qui en fait le bon choix pour les éléments de marque et les maquettes de design, là où Imagen 4 pourrait sur-texturer le résultat.
GPT Image 1.5 et GPT Image 2
Les modèles de génération d’images d’OpenAI restent au cœur de cette course. GPT Image 1.5 et GPT Image 2 sont étroitement intégrés à l’expérience ChatGPT et offrent de solides performances pour le suivi des instructions, en particulier pour les scènes qui exigent l’analyse de descriptions contextuelles complexes. La série GPT Image profite de la profondeur des modèles de langage d’OpenAI : les allers-retours d’édition par la conversation y sont plus naturels qu’avec des modèles d’image autonomes.
Imagen 4 rivalise directement avec la série GPT Image sur le respect des prompts et le photoréalisme. Aucun des deux modèles ne prend un avantage définitif sur tous les cas d’usage.
Ideogram V3 et les spécialistes de la typographie
Ideogram V3 Turbo et Ideogram V3 Quality ont bâti leur réputation sur la précision du rendu de texte bien avant l’arrivée d’Imagen 4. Ideogram reste le spécialiste lorsque l’exigence principale est une typographie nette et lisible intégrée aux images. Pour les affiches, les visuels de réseaux sociaux et les supports marketing comportant un texte précis, Ideogram conserve un avantage, fondé sur une orientation architecturale délibérée vers le problème du texte dans l’image.
Les progrès d’Imagen 4 sur le texte réduisent sensiblement cet écart, mais Ideogram produit des résultats plus constamment précis lorsque le texte est au centre de l’image plutôt qu’un détail secondaire.
Ce que cela change pour les créateurs
Le plafond de qualité continue de monter
Il y a deux ans, repérer une image générée par IA était en grande partie simple. Aujourd’hui, les résultats d’Imagen 4, de Flux 2 Max et de Midjourney v7 sont pratiquement impossibles à distinguer d’une photographie pour la plupart des spectateurs, dans la plupart des contextes. Le plafond de qualité a dépassé le point où cette distinction a un poids pratique pour la majorité des usages.
Cela change la façon dont les créateurs doivent envisager les outils de génération d’images par IA. La question n’est plus « est-ce assez bien ? ». Elle devient « quel outil fait ce dont j’ai besoin, à quel coût, avec quel flux de travail ? »
La spécialisation plutôt que les flux à modèle unique
À mesure que chaque modèle se renforce, les modèles se différencient aussi. Imagen 4 excelle en photoréalisme et en rendu de texte. Midjourney v7 domine l’espace esthétique artistique. Les modèles Flux offrent la programmabilité et le fine-tuning. Ideogram domine la typographie. Recraft sert le design graphique.
Aucun modèle unique ne domine tous les cas d’usage. Les professionnels qui travaillent avec la génération d’images par IA en 2027 construisent des flux de travail multimodèles, en choisissant l’outil adapté à chaque résultat précis plutôt que de s’en remettre à une seule plateforme pour tout.
💡 L’approche multimodèle est plus pratique sur les plateformes qui vous donnent accès à tous les modèles au même endroit. Comparer les résultats de plusieurs modèles pour un même prompt est le moyen le plus rapide de savoir quel modèle convient à quelle tâche.
Créez vos propres images par IA dès maintenant
Imagen 4 a relevé la barre de ce qu’un modèle de texte vers image peut faire en matière de photoréalisme, de rendu de texte et de respect des prompts. C’est le modèle de génération d’images le plus performant de Google à ce jour, et il rivalise sérieusement avec tous les autres modèles haut de gamme du secteur.
Mais l’enseignement le plus important de ce moment de la génération d’images par IA ne concerne aucun modèle en particulier. Le domaine a atteint un niveau de capacités où le bon outil dépend de votre tâche précise, et disposer de tous ces outils au même endroit est un véritable avantage.
Sur PicassoIA, vous pouvez travailler avec Flux Pro, Flux 2 Max, GPT Image 2, Recraft V4 Pro, Ideogram V3 Turbo, ainsi que plus de 90 autres modèles de texte vers image, au même endroit. Choisissez un prompt, lancez-le sur plusieurs modèles et voyez les différences directement. C’est le moyen le plus rapide de comprendre ce que fait réellement chaque modèle, non en lisant à leur sujet, mais en lançant vos propres prompts et en comparant les résultats côte à côte.
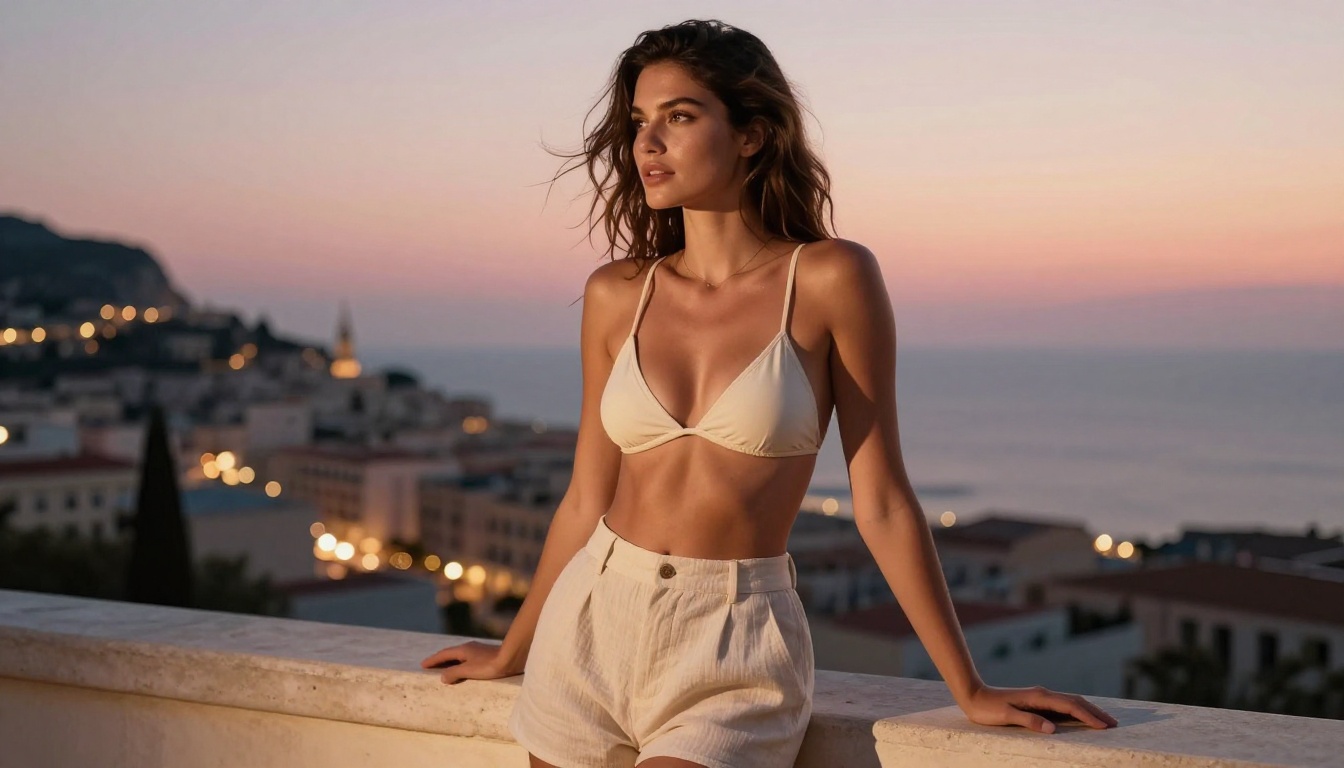
Choisissez un sujet. Rédigez un prompt. Voyez ce que produisent aujourd’hui les meilleurs modèles de génération d’images au monde.


