O Google acaba de lançar o Imagen 4, e ele muda o cenário competitivo da geração de imagens por texto de maneiras que importam tanto para profissionais quanto para criadores casuais. Se você acompanha essa área desde a época das imagens borradas de 512x512 até a geração quase fotorrealista de hoje, sabe como os benchmarks evoluem rápido. O Imagen 4 fica no topo da linha de geração de imagens do Google DeepMind e traz melhorias relevantes em todas as dimensões que importam: fotorrealismo, aderência ao prompt e renderização de texto dentro das imagens.
Este artigo detalha tudo o que você precisa saber. O que o Imagen 4 realmente faz, como funciona sua arquitetura, onde ele se posiciona em relação ao DALL-E 3, ao Flux e ao Midjourney, e o que isso significa para quem trabalha com ferramentas de IA para imagens.
O que o Imagen 4 realmente faz
Fotorrealismo em um novo padrão
A melhoria mais visível do Imagen 4 está em quão reais parecem as imagens. As versões anteriores da série Imagen tinham uma suavidade característica, especialmente em detalhes finos como cabelo, texturas de tecido e luz refletida. O Imagen 4 resolve a maior parte disso.
O modelo produz imagens em até resolução 2K de forma nativa, com granulação, profundidade de campo e renderização de materiais que rivalizam com a fotografia de estúdio em muitas condições. Retratos mostram textura de pele em nível de poros. Paisagens renderizam luz volumétrica com o tipo de névoa atmosférica que você capturaria em uma câmera full-frame. Dobras de tecido e reflexos especulares em superfícies de vidro se sustentam quando examinados de perto.
Detalhe fotorrealista nesse nível antes só era possível combinando um modelo base forte com várias passagens de upscaling e refinamento. O Imagen 4 entrega isso em uma única etapa de geração.
💡 O Imagen 4 consegue renderizar granulação de filme visível, imperfeições de lente e aberração cromática quando recebe o prompt "fotografia de filme" ou "foto analógica". O modelo foi treinado para distinguir artefatos fotográficos autênticos de ruído digital.
Texto em imagens: um problema antigo resolvido
A renderização de texto em imagens tem sido o ponto fraco de todos os modelos de geração de imagens há anos. O DALL-E 3 avançou de forma significativa. O Midjourney v6 melhorou. O Imagen 4 é o primeiro modelo a lidar com texto complexo, de várias palavras, em imagens com precisão consistente.
Peça uma placa de loja com um nome específico de negócio, uma capa de revista com uma manchete ou uma inscrição em bolo de aniversário, e o Imagen 4 renderiza as letras corretamente na grande maioria dos casos. Isso não é uma conquista trivial. Arquiteturas de difusão anteriores tinham dificuldade com texto porque os caracteres não têm relações espaciais coerentes durante o processo de remoção de ruído. O encoder de texto maior do Imagen 4 e o fine-tuning com RLHF parecem ter resolvido isso no nível arquitetural.
A aderência ao prompt vai mais fundo
Além da qualidade visual, o Imagen 4 segue prompts com uma precisão incomum. Instruções de composição como "uma cadeira vermelha no lado esquerdo do quadro com uma janela atrás dela" se traduzem na saída com as relações espaciais especificadas de fato respeitadas.
Isso importa para profissionais. Um fotógrafo de produtos que precisa de um arranjo específico, um designer gráfico que precisa de um clima particular, um criador de conteúdo que precisa de uma cena sem refazê-la cinco vezes. O Imagen 4 reduz bastante esse ciclo de iteração.
Como ele se compara à concorrência
Imagen 4 ou DALL-E 3
O DALL-E 3, integrado ao ChatGPT, ainda tem o maior alcance. A maioria das pessoas que já geraram uma imagem com IA fez isso pela interface da OpenAI. O Imagen 4 se destaca na qualidade visual pura em comparações lado a lado. O DALL-E 3 tende a um visual levemente estilizado e ilustrativo, mesmo em configurações de fotorrealismo altas. As imagens do Imagen 4 parecem mais fotos tiradas com uma câmera do que renderizações de software.
| Recurso | Imagen 4 | DALL-E 3 |
|---|
| Fotorrealismo | Muito alto | Alto |
| Renderização de texto | Excelente | Bom |
| Aderência ao prompt | Excelente | Muito bom |
| Resolução | Até 2K | 1024x1024 nativa |
| Acesso | Google AI Studio, Vertex AI | ChatGPT, API |
Imagen 4 ou Flux
O Flux Pro, da Black Forest Labs, é atualmente o concorrente de código aberto mais forte. O Flux 1.1 Pro é acessível, amplamente usado e produz resultados impressionantes para retratos e fotografia de moda. O Flux 2 Pro e o Flux 2 Max avançam ainda mais em resolução e detalhe.
Onde os modelos Flux tendem a superar o Imagen 4 é na flexibilidade estilística. O ecossistema Flux oferece suporte a modelos LoRA com fine-tuning, orientação de pose com ControlNet e fluxos de trabalho de preenchimento e inpainting. O Imagen 4 é um modelo mais opinativo. Ele se destaca no fotorrealismo, mas não tem o ecossistema de modificadores que o Flux construiu com o tempo.
Para a qualidade bruta de imagem em cenas fotorrealistas, o Imagen 4 é competitivo com o Flux 2 Max. Para controle criativo e amplitude de estilos, o Flux vence.
💡 O Flux 2 Pro e o Flux 2 Max estão disponíveis agora no PicassoIA. Se você está comparando seus próprios resultados com o Imagen 4, esses são os pontos de comparação certos.
Imagen 4 ou Midjourney
O Midjourney v7 ainda detém a coroa em qualidade estética para imagens estilizadas, artísticas e cinematográficas. A comunidade criou uma vasta biblioteca de convenções de prompts que produzem resultados bonitos de forma confiável. O Imagen 4 não tenta competir nesse eixo.
Onde o Imagen 4 supera o Midjourney é na obediência a instruções para cenas específicas e factuais. O Midjourney interpreta prompts de forma criativa, muitas vezes embelezando ou abstraindo de maneiras que divergem da descrição literal. O Imagen 4 trata o prompt mais como uma especificação do que como uma sugestão.
| Caso de uso | Melhor opção |
|---|
| Imagens artísticas ou estilizadas | Midjourney v7 |
| Retratos fotorrealistas | Imagen 4 ou Flux 2 Max |
| Renderização de texto em imagens | Imagen 4 |
| Fotografia de produtos | Imagen 4 ou Flux Pro |
| Código aberto ou acesso via API | Modelos Flux |
| Geração em lote de alto volume | Série GPT Image |
A arquitetura por trás do resultado
Um "cérebro" de linguagem maior para imagens
O Imagen 4 se baseia na arquitetura de modelo de difusão em cascata que o Google introduziu na série Imagen original. A ideia básica: gerar uma imagem de baixa resolução e, em seguida, aplicar etapas sucessivas de difusão de upsampling para adicionar detalhes em cada escala.
O que mudou no Imagen 4 é o modelo de condicionamento. O Google ampliou significativamente o encoder de texto, usando uma variante do seu modelo de linguagem T5 para processar prompts com mais profundidade. É por isso que a renderização de texto e o raciocínio espacial melhoraram tanto. O modelo não apenas associa palavras a partes da imagem. Ele analisa as relações semânticas do prompt e as usa para restringir a geração em cada etapa de difusão.
O resultado é um modelo em que instruções complexas se traduzem em saídas coerentes com mais frequência, com menos objetos alucinados ou sujeitos mal posicionados na cena.
Aprendizado por reforço a partir de feedback humano
O Google afirmou que o Imagen 4 passou por várias etapas de RLHF (aprendizado por reforço a partir de feedback humano), voltadas especificamente para a aderência ao prompt e a qualidade estética. É o mesmo método que tornou os modelos GPT significativamente melhores em seguir instruções em linguagem natural, agora aplicado à geração de imagens em grande escala.
O efeito prático é que o Imagen 4 se comporta mais como um modelo calibrado pela preferência humana do que apenas treinado em um grande conjunto de dados. Quando as saídas se afastam do que os usuários realmente querem, o treinamento com RLHF puxa o modelo de volta ao alinhamento. Isso aparece com mais clareza na precisão de composição e na evitação consistente de artefatos comuns de geração, como sombras desalinhadas ou mãos anatomicamente incorretas.
Onde você pode acessar o Imagen 4
Google AI Studio
O Google AI Studio é o principal ponto de acesso voltado ao consumidor. Pela interface do Gemini, o Imagen 4 está disponível para gerar imagens a partir de prompts de texto diretamente no navegador. A interface é limpa e rápida. Você não precisa gerenciar parâmetros de difusão ou configurações de amostragem. Digite um prompt e receba uma imagem.
Para quem vem do Midjourney ou da geração de imagens do ChatGPT, a experiência é familiar. Os resultados tendem a ficar polidos logo de início, sem necessidade de muito ajuste de prompt para chegar a uma qualidade aceitável.
Vertex AI para uso em produção
Para acesso via API e implantações em produção, o Google oferece o Imagen 4 pelo Vertex AI. Esse é o nível empresarial, criado para pipelines de produção, geração de alto volume e integração em produtos e aplicativos existentes.
O Vertex AI também dá acesso ao Imagen 4 Ultra, a variante de maior qualidade, posicionada especificamente para casos de uso profissionais e comerciais. O nível Ultra produz detalhes visivelmente mais nítidos e melhor precisão de cor do que o endpoint de API padrão.
Integrado ao Google Workspace
O Google integrou o Imagen 4 a produtos do Workspace, incluindo Slides, Docs e Meet. Os recursos de geração de imagem nessas ferramentas rodam o Imagen por baixo dos panos, o que faz dele um dos modelos de geração de imagens mais amplamente implantados em número bruto de usuários, mesmo que receba menos atenção na comunidade entusiasta do que o Midjourney ou as variantes do Stable Diffusion.
Especificidade compensa
A forte aderência ao prompt do Imagen 4 significa que você recebe de volta o que colocou. Prompts vagos ainda produzem boas imagens, mas o modelo recompensa a especificidade. Em vez de "uma mulher na praia", experimente "uma mulher com um vestido de linho creme, em pé em uma costa rochosa na hora dourada, olhando para longe da câmera". O contexto adicional se traduz diretamente na saída.
Isso difere da forma como o Midjourney funciona. Com o Midjourney, prompts curtos e evocativos muitas vezes superam os longos e descritivos, porque o modelo interpreta de forma livre e acrescenta suas próprias escolhas estéticas. O Imagen 4 é mais literal. Use isso a seu favor.
💡 Para saídas fotorrealistas, adicione linguagem específica de câmera: "fotografado com 85mm f/1.8, Kodak Portra 400, luz natural pela esquerda". O Imagen 4 foi treinado para associar esse vocabulário ao realismo fotográfico e aplica a estética de forma consistente.
3 estilos de prompt que funcionam melhor
Três estruturas que produzem resultados fortes de forma consistente com o Imagen 4:
- Prompts de fotografia: especificações de câmera, tipo de filme, direção da luz, características da lente. "Fotografia aérea, lente de 24mm, f/8, hora dourada, Sony A1"
- Descrição de cena: sujeito, ambiente, hora do dia, clima. "Um cruzamento movimentado de Tóquio à noite, reflexos da chuva no asfalto, desfoque de movimento nos pedestres"
- Direção de composição: ângulo da câmera, enquadramento, relações de profundidade. "Plano de baixo para cima, profundidade de campo rasa, sujeito em primeiro plano nítido, fundo com bokeh"
O que ainda não funciona bem
Alguns padrões de prompt produzem resultados inconsistentes com o Imagen 4:
- Pedir vários textos distintos em uma imagem (ainda pouco confiável com mais de dois elementos de texto)
- Conceitos altamente abstratos ou surrealistas que exigem metáfora visual em vez de descrição literal
- Pedidos específicos de estilos visuais protegidos por direitos autorais ou semelhanças de celebridades (aplicam-se filtros de segurança rigorosos)
Flux 2 e a aposta nos modelos abertos
O Flux 2 Pro e o Flux 2 Max representam a concorrência mais forte de arquitetura aberta ao Imagen 4. Esses modelos não estão trancados atrás de uma API fechada. Desenvolvedores podem implantá-los, fazer fine-tuning e construir aplicações especializadas sobre eles.
Essa é uma diferença estrutural em relação ao Imagen 4. O Imagen roda na infraestrutura do Google e sob os termos do Google. O ecossistema Flux é distribuído, modificável e extensível. Para muitos casos de uso profissionais, essa abertura importa mais do que as pontuações brutas de benchmark.
O Recraft V4 Pro é outro concorrente forte para fluxos de trabalho de design gráfico e ilustração. Ele produz tipografia excepcionalmente limpa e precisão de aparência vetorial, o que o torna a escolha certa para ativos de marca e maquetes de design em que o Imagen 4 poderia sobrecarregar a textura da saída.
GPT Image 1.5 e GPT Image 2
Os modelos de geração de imagens da OpenAI continuam centrais nessa corrida. O GPT Image 1.5 e o GPT Image 2 estão fortemente integrados à experiência do ChatGPT e oferecem bom desempenho em obediência a instruções, especialmente para cenas que exigem a análise de descrições contextuais complexas. A série GPT Image se beneficia da profundidade do modelo de linguagem da OpenAI: a edição de ida e volta por meio de conversa é mais natural do que com modelos de imagem independentes.
O Imagen 4 compete diretamente com a série GPT Image em aderência ao prompt e fotorrealismo. Nenhum dos modelos tem uma vantagem definitiva em todos os casos de uso.
Ideogram V3 e os especialistas em tipografia
O Ideogram V3 Turbo e o Ideogram V3 Quality construíram sua reputação com renderização precisa de texto muito antes da chegada do Imagen 4. O Ideogram ainda é o especialista quando o requisito principal é uma tipografia limpa e legível incorporada às imagens. Para cartazes, gráficos para redes sociais e peças de marketing com textos específicos, o Ideogram tem uma vantagem construída a partir de um foco arquitetural deliberado no problema do texto em imagens.
As melhorias de texto do Imagen 4 reduzem bastante essa diferença, mas o Ideogram produz resultados mais consistentes e precisos quando o texto é o centro da imagem, e não um detalhe secundário.
O que isso significa para criadores
O teto de qualidade continua subindo
Dois anos atrás, identificar uma imagem gerada por IA era, em grande parte, simples. Hoje, as saídas do Imagen 4, do Flux 2 Max e do Midjourney v7 são, na prática, indistinguíveis de fotografias para a maioria dos espectadores na maioria dos contextos. O teto de qualidade ultrapassou o ponto em que essa distinção tem peso prático para a maioria das aplicações.
Isso muda a forma como os criadores precisam pensar sobre as ferramentas de IA para imagens. A pergunta já não é "isso é bom o suficiente?". É "qual ferramenta faz o que preciso, a que custo, com qual fluxo de trabalho?".
Especialização em vez de fluxos de trabalho com um único modelo
À medida que os modelos se fortalecem, eles também se diferenciam. O Imagen 4 se destaca em fotorrealismo e renderização de texto. O Midjourney v7 domina o espaço estético artístico. Os modelos Flux oferecem programabilidade e fine-tuning. O Ideogram domina a tipografia. O Recraft atende ao design gráfico.
Nenhum modelo único domina todos os casos de uso. Profissionais que trabalham com geração de imagens por IA em 2027 estão montando fluxos de trabalho com vários modelos, escolhendo a ferramenta certa para cada saída específica, em vez de recorrer a uma única plataforma para tudo.
💡 A abordagem com vários modelos é mais prática em plataformas que dão acesso a todos eles em um só lugar. Comparar as saídas de vários modelos para o mesmo prompt é a forma mais rápida de calibrar qual modelo serve para cada tarefa.
O Imagen 4 elevou o padrão do que um modelo de texto para imagem pode fazer em fotorrealismo, renderização de texto e aderência ao prompt. É o modelo de geração de imagens mais capaz do Google até hoje, e disputa seriamente com todos os outros modelos de ponta do setor.
Mas o insight mais importante deste momento da geração de imagens com IA não está em nenhum modelo específico. Está no fato de que o campo atingiu um nível de capacidade em que a ferramenta certa depende da sua tarefa específica, e ter acesso a todas elas em um só lugar é uma vantagem real.
No PicassoIA, você pode trabalhar com o Flux Pro, o Flux 2 Max, o GPT Image 2, o Recraft V4 Pro, o Ideogram V3 Turbo e mais de 90 outros modelos de texto para imagem em um só lugar. Escolha um prompt, execute-o em vários modelos e veja as diferenças diretamente. Essa é a forma mais rápida de entender o que cada modelo realmente faz: não lendo sobre ele, mas executando seus próprios prompts e comparando os resultados lado a lado.
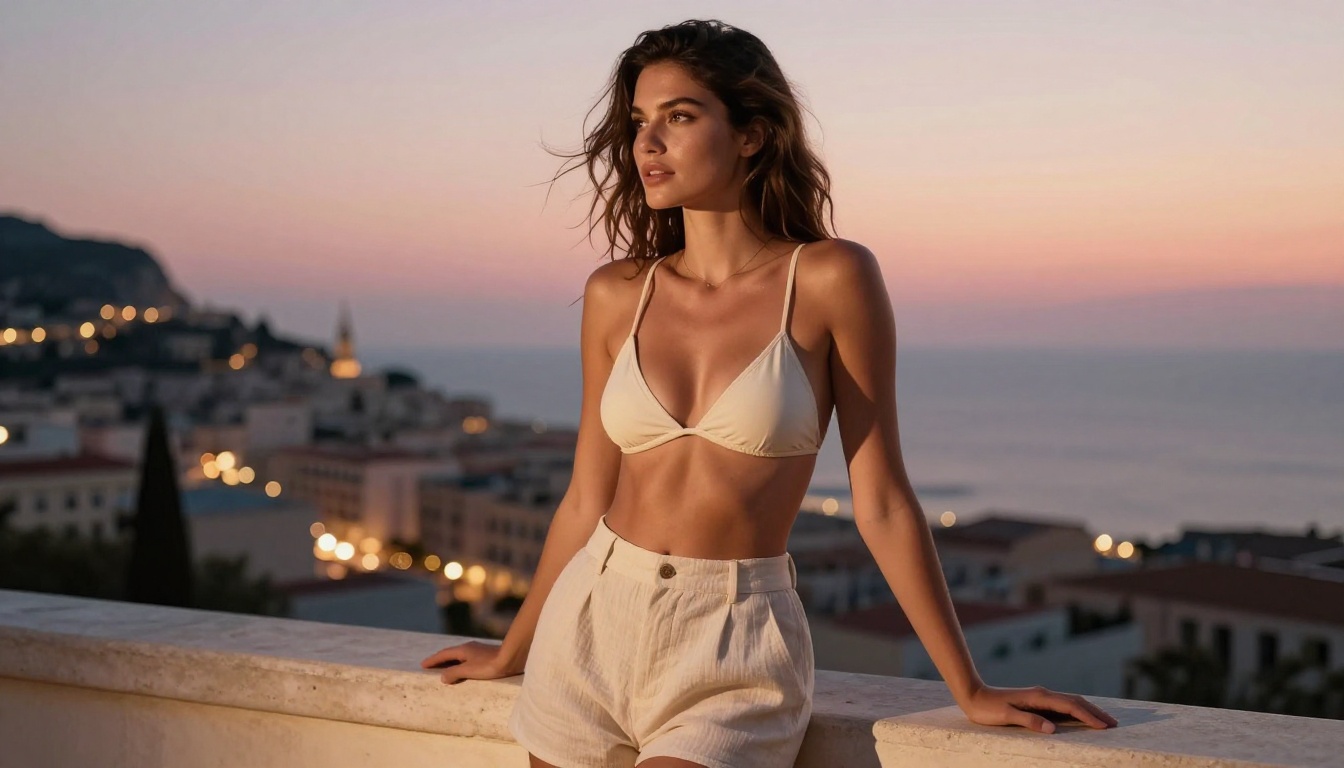
Escolha um sujeito. Escreva um prompt. Veja o que os melhores modelos de geração de imagens do mundo produzem com ele agora mesmo.


