La edición de video con múltiples entradas no es una simple actualización menor. Es la diferencia entre una herramienta que genera clips y una herramienta que en realidad entiende lo que intentas construir. Kling v3 Omni Video es el primer modelo de la gama Kling que gestiona varias referencias de entrada a la vez y combina prompts de texto, imágenes del sujeto y referencias de estilo en un único resultado coherente. El resultado es un flujo de trabajo de generación de video que se parece menos a adivinar y más a dirigir.
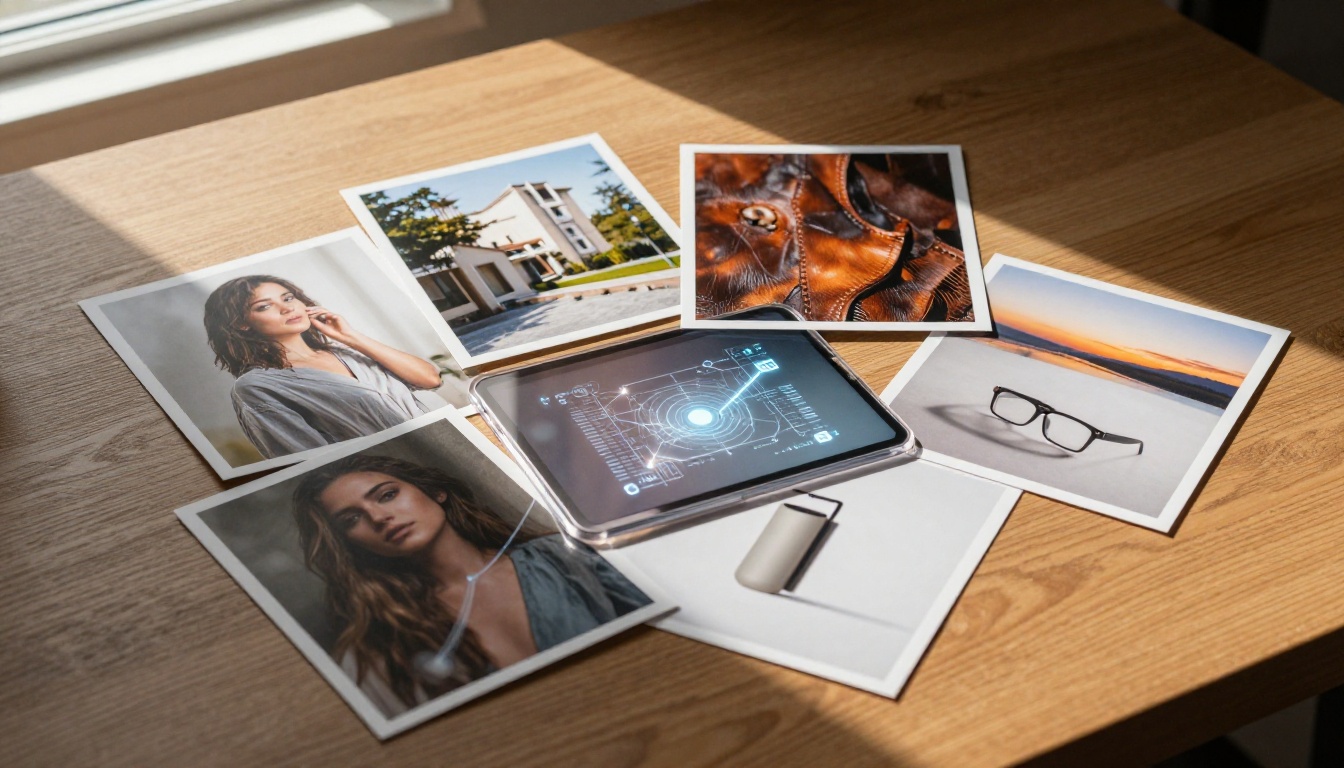
Qué significa realmente "múltiples entradas"
La mayoría de los modelos de generación de video trabajan desde una sola fuente: un prompt de texto o una imagen de referencia. Escribes lo que quieres, o muestras lo que quieres, y el modelo hace lo posible por interpretar esa única señal. La limitación se nota pronto. Los prompts solo de texto tienen dificultades con la precisión visual. Las entradas de una sola imagen pierden detalle cuando el movimiento se extiende más allá del primer fotograma.
La edición con múltiples entradas resuelve esto permitiendo que el modelo triangule a partir de varias fuentes a la vez. En lugar de deducir tu intención a partir de una sola señal, lee varias simultáneamente y las sintetiza en un resultado que respeta todas.
Texto y referencias de imagen a la vez
Kling v3 Omni Video acepta un prompt de texto de movimiento junto con una o más imágenes de referencia. Esas imágenes pueden cumplir funciones distintas. Una puede definir el sujeto principal, otra el entorno de fondo y una tercera puede anclar el estilo de iluminación. El modelo lee cada entrada por lo que aporta y las pondera en conjunto durante la generación.
Esto es fundamentalmente distinto de las versiones anteriores de Kling. Kling v2.6 y Kling v2.1 Master eran herramientas sólidas de imagen a video, pero trabajaban con una única imagen principal y el texto solo guiaba el movimiento. La arquitectura Omni amplía esto para aceptar entradas estructurales que dan forma a todo el resultado, no solo al fotograma inicial.
Cómo procesa el modelo las entradas combinadas
Internamente, el modelo procesa las entradas de referencia mediante un mecanismo de atención cruzada que pondera la contribución de cada entrada según su función en el prompt. Si tu prompt de texto dice "la mujer camina por la calle de la ciudad", el modelo usa la imagen de referencia del sujeto para definir el aspecto de la mujer, la referencia del entorno para definir la calle y el texto para definir la trayectoria del movimiento.
💡 Consejo: Cuando uses varias referencias de imagen, asegúrate de que cada una aporte algo distinto. Introducir dos imágenes parecidas del mismo sujeto desde casi el mismo ángulo añade ruido en lugar de información.
Los 3 modos que maneja Kling v3 Omni
El sistema de múltiples entradas de Kling v3 Omni Video cubre tres casos de uso distintos. Cada uno sirve a un tipo diferente de creador.
Imagen a video con referencia de sujeto
Es el modo más directo. Proporcionas una fotografía de alta calidad de tu sujeto, escribes un prompt de movimiento y el modelo anima al sujeto manteniendo su aspecto en cada fotograma. El color del pelo, los detalles de la ropa, la estructura facial e incluso texturas concretas se mantienen coherentes a lo largo de todo el clip.
Para el trabajo con personajes, esto elimina la necesidad de describir al personaje por completo con texto. En lugar de escribir "una mujer con el pelo oscuro y ondulado que lleva una chaqueta roja", le muestras al modelo exactamente a quién te refieres. La precisión es inmediata y los resultados son mucho más constantes.
La variante Kling v3 Motion Control lleva esto más lejos al añadir control directo del movimiento corporal, pero el modelo Omni principal maneja la animación libre de personajes sin esas restricciones.
Mezcla de estilo y escena
El segundo modo usa las imágenes de referencia no para definir un sujeto, sino para definir un estilo visual o un entorno. Podrías aportar una fotografía de un callejón concreto de Barcelona y, después, usar un prompt de texto para situar a un personaje caminando por él sin haber rodado allí.
Esto funciona porque el modelo separa el contenido semántico (lo que hay en la imagen) de la información de estilo y espacio (cómo está iluminado, cómo son las superficies, cómo se organiza el espacio). Una imagen de referencia de un lugar se convierte en un plano visual y no en una instrucción estricta de "anima esto".
💡 Consejo: Para las referencias de lugares, las fotos de arquitectura con condiciones de iluminación constantes funcionan mejor que las instantáneas de teléfono. El modelo lee la dirección de la luz y la calidad de las sombras directamente de la imagen de referencia.
Capas de prompts de movimiento
El tercer modo consiste en combinar descripciones de movimiento con imágenes de referencia que muestran el contexto de ese movimiento. Podrías aportar una imagen de un bailarín en mitad de una pose y un prompt de texto que describa la trayectoria del movimiento, y el modelo interpola entre la referencia estática y el movimiento descrito.
Esto resulta especialmente eficaz para el tipo de trabajo que antes exigía animación fotograma a fotograma: gestos concretos, movimientos de cámara precisos, presentaciones de producto controladas en las que la trayectoria del movimiento importa tanto como la identidad visual del objeto.
Dónde se quedan cortos los modelos de una sola entrada
Para entender lo que Kling v3 Omni Video hace bien, hay que entender qué hacen mal los modelos de una sola entrada. Estos no son defectos exclusivos de la competencia. También fueron limitaciones de las versiones anteriores de Kling.
El problema de la coherencia
Cuando un modelo solo de texto genera un video, tiene que inventar los detalles visuales desde cero. Cada fotograma es una nueva interpretación de tu descripción. El resultado: un personaje que se ve sutilmente distinto en el fotograma 12 y en el 48, o un fondo que cambia de tono de color a mitad del clip.
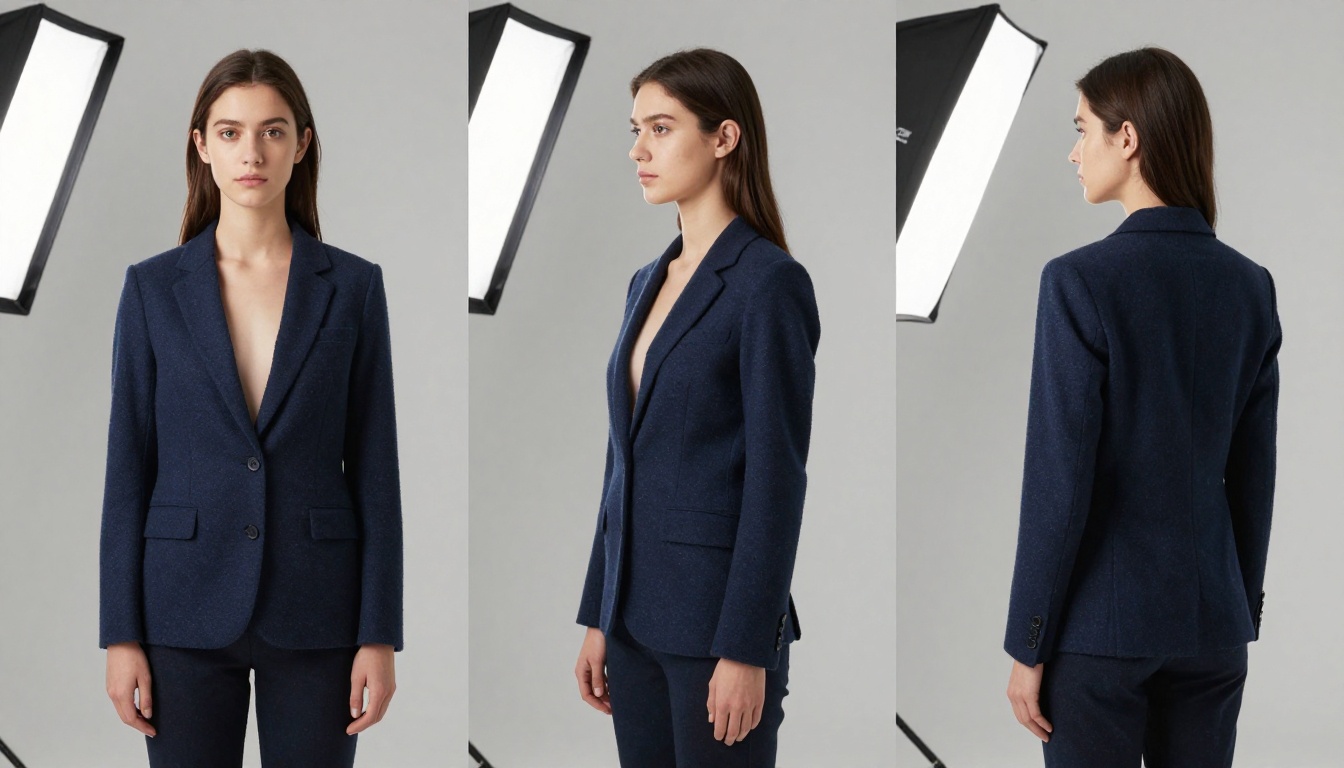
Los modelos de entrada de una sola imagen mejoran esto, pero aún tienen dificultades cuando el movimiento aleja al sujeto de su pose inicial. Una vez que un personaje gira 90 grados desde el ángulo de su referencia, el modelo está básicamente extrapolando, y ahí es donde empieza la deriva de identidad.
Las múltiples entradas dan al modelo varios puntos de anclaje. Puede triangular el aspecto desde distintos ángulos aportados como referencias, lo que reduce de forma notable la deriva incluso en secuencias de movimiento complejas.
Deriva estilística a lo largo del tiempo
Incluso los modelos con una gran coherencia en una sola imagen suelen dejar que el estilo se desvíe en clips más largos. La iluminación cálida de una imagen de referencia se desvanece hacia la mitad del clip y vuelve de forma irregular al final. La gradación de color cambia ligeramente. Son artefactos de un modelo que pierde el rastro de la referencia a medida que su atención se desplaza hacia generar un movimiento plausible.
La arquitectura Omni mantiene las referencias de estilo activas durante toda la generación, en lugar de usarlas solo para condicionar el fotograma inicial. Esto es lo que lo diferencia de verdad de modelos como Veo 3 o Hailuo 02, que destacan en texto a video cinematográfico, pero no ofrecen el mismo anclaje de sujeto con múltiples referencias.
Cómo Kling v3 Omni mantiene los visuales coherentes
La coherencia es lo que separa los clips que de verdad puedes usar de los que lucen impresionantes durante tres segundos y luego se desmoronan.
Fidelidad del sujeto a lo largo de los fotogramas
Kling v3 Omni Video logra la fidelidad del sujeto mediante la vinculación de referencia: la imagen de referencia del sujeto no es solo una entrada de condicionamiento en el fotograma cero, sino que se mantiene como una restricción persistente durante todo el proceso de difusión. El modelo comprueba de forma continua los fotogramas generados contra la referencia durante el muestreo.
En la práctica, esto significa que la textura de la ropa se mantiene fiel. Una camisa a rayas sigue siendo a rayas, con el ancho de raya correcto, en lugar de disolverse en un patrón vago. Los detalles de joyería persisten. Los rasgos faciales siguen siendo reconocibles durante el movimiento en lugar de suavizarse hasta una aproximación genérica.
| Característica | Modelos de una sola imagen | Kling v3 Omni Video |
|---|
| Coherencia del sujeto durante 5s | Moderada (80-90%) | Alta (95%+) |
| Conservación del estilo a mitad del clip | Se degrada | Se mantiene |
| Compatibilidad con referencias de varios ángulos | No | Sí |
| Separación entre fondo y sujeto | Limitada | Sólida |
| Fidelidad del movimiento al prompt | Buena | Excelente |
Coherencia temporal
La coherencia temporal se refiere a lo suave que es la conexión de un fotograma con el siguiente a lo largo de todo el clip. Un video incoherente parece una presentación de diapositivas: cada fotograma es plausible por separado, pero las transiciones entre ellos resultan bruscas o físicamente imposibles.
La arquitectura de múltiples entradas ayuda a la coherencia temporal porque el modelo tiene más restricciones que respetar. Con solo un prompt de texto, el modelo tiene una libertad enorme para interpretar cada fotograma. Con una referencia de sujeto y una referencia de estilo fijadas, el espacio de soluciones se estrecha y las decisiones restantes sobre las trayectorias del movimiento y las transiciones de iluminación se controlan mejor.
💡 Consejo: Para la máxima coherencia temporal, mantén tu prompt de movimiento específico pero no sobrecargado. Una sola acción clara por clip funciona mejor que tres acciones simultáneas metidas en un mismo prompt.
Los flujos de trabajo que más se benefician
No todos los proyectos de video necesitan la edición con múltiples entradas. Para gráficos de movimiento abstractos o clips de texto a video estilizados, un modelo como Seedance 2.5 o Ray 3.2 dará resultados igual de buenos con menos configuración. La edición con múltiples entradas aporta su valor en flujos de trabajo concretos.
Flujos de trabajo de animación de personajes
Si animas a una persona o un personaje concreto en varios clips, la edición con múltiples entradas ahorra muchísimo tiempo. Sin ella, escribes la misma descripción detallada del personaje en cada prompt y esperas que el modelo la interprete de forma coherente. Con ella, aportas la referencia una sola vez y el modelo se encarga del resto.
Esto es especialmente importante en contenidos seriados: canales de YouTube que construyen videos recurrentes protagonizados por personajes, campañas de marketing con un portavoz de marca o proyectos narrativos que siguen al mismo protagonista a lo largo de varias escenas. Cada clip puede tener un movimiento, un entorno y un ambiente distintos, pero el personaje sigue siendo visualmente idéntico.
Videos de presentación de productos
El marketing de productos encaja a la perfección con los flujos de trabajo de múltiples entradas. Tienes fotografía de producto de alta calidad en tu biblioteca existente. Quieres que ese producto concreto, con sus colores y acabados exactos, se vea en movimiento en distintos escenarios.
Con la edición de múltiples entradas puedes aportar la fotografía del producto como referencia de sujeto, describir el escenario y el movimiento en texto, y generar un video de producto coherente sin volver a rodar. El modelo lee el acabado exacto de la superficie del producto a partir de tu foto de referencia y no de tu descripción.
Para las marcas de comercio electrónico, esto reduce lo que normalmente sería una sesión de video de un día entero a un prompt y unas pocas imágenes de referencia.
Transiciones de escena con estilo unificado
Los cineastas documentales y de ficción que trabajan con video de IA se enfrentan a un problema concreto: cada clip generado se ve ligeramente distinto, y eso hace que los cortes resulten bruscos. La edición con múltiples entradas lo resuelve permitiendo usar un fotograma de un clip anterior como referencia de estilo o de entorno para el siguiente, encadenando la coherencia visual a lo largo de una secuencia.
Esto se parece mucho a lo que los flujos tradicionales de VFX llaman "desarrollo de look". Una vez que fijas el look de una escena, cada plano de esa escena se gradúa para encajar. La edición con múltiples entradas te permite hacer lo mismo en el momento de la generación, no en postproducción.
Alternativas sólidas en PicassoIA
Kling v3 Omni Video no es el único modelo de PicassoIA que merece la pena conocer para trabajos guiados por referencias o de múltiples entradas. Según tus necesidades concretas, estas alternativas pueden encajarte mejor.
Wan 2.7 R2V para trabajos basados en referencias
Wan 2.7 R2V (Reference-to-Video) está construido específicamente en torno al concepto de animar a partir de imágenes de referencia. Destaca en la animación de personajes a partir de una única referencia sólida y produce resultados muy coherentes para contenido centrado en retratos. Si tu flujo de trabajo se centra sobre todo en personajes y tiene pocas necesidades de entorno, Wan 2.7 R2V puede ser más rápido para iterar.
La contrapartida: Wan 2.7 R2V es menos flexible para mezclar varios tipos distintos de referencia. Está optimizado para referencias de sujeto, no para el flujo combinado de sujeto, entorno y estilo que maneja el modelo Omni.
También puedes combinarlo con Wan 2.7 I2V para la animación de imagen a video cuando el enfoque de referencia de sujeto encaje mejor con tu proyecto que el pipeline Omni completo.
Seedance 2.5 para contenido de larga duración
Seedance 2.5 admite hasta 30 segundos por generación, lo que lo convierte en la opción adecuada cuando la duración importa más que la coherencia entre múltiples referencias. Para contenido en redes sociales en el que un único clip largo con variación natural de IA es aceptable, Seedance 2.5 ofrece calidad cinematográfica con audio nativo a gran escala.
La versión gratuita, Seedance 2.5 Lite, genera clips más cortos de hasta 10 segundos y merece la pena probarla antes de decidirte por el nivel Pro.
Kling o1 para editar metraje existente
Si ya tienes metraje de video y quieres reestilizarlo en lugar de generarlo desde cero, Kling o1 es el modelo de Kling específico para edición. Reescribe el contenido del video a partir de instrucciones de texto y conserva el movimiento y la estructura subyacentes. Combinado con Wan 2.7 Videoedit o Lucy Edit 2, tienes un pipeline de postproducción completo dentro de PicassoIA.
Para escalar después el metraje generado, Real ESRGAN Video se encarga del escalado a 4K y Video Increase Resolution lleva la salida a 8K cuando importa la máxima calidad de entrega.
Cómo usar Kling v3 Omni en PicassoIA
Kling v3 Omni Video está disponible directamente en PicassoIA. El flujo de trabajo es sencillo una vez que entiendes cómo los campos de entrada se corresponden con la arquitectura del modelo.
Paso a paso
Paso 1: Prepara tus imágenes de referencia.
Reúne las imágenes que quieras usar como referencia. Para trabajar con personajes, usa un retrato limpio, con buena iluminación y una vista clara del rostro del sujeto y de los detalles específicos de la ropa. Para las referencias de entornos, usa imágenes con iluminación constante y direccional en lugar de tomas planas con cielo cubierto.
Paso 2: Abre la página del modelo.
Ve a Kling v3 Omni Video en PicassoIA. Verás el panel de entrada con campos para la imagen principal, referencias secundarias opcionales y el prompt de texto de movimiento.
Paso 3: Sube tu referencia principal.
La ranura de imagen principal es la más importante. Es la imagen que define tu sujeto o escena principal. Sube la versión de mayor calidad que tengas. El modelo lee a la resolución completa de la imagen subida, así que una referencia 4K nítida producirá un resultado más definido que un recorte comprimido de 720p.
Paso 4: Escribe un prompt de movimiento específico.
Describe el movimiento en términos cronológicos. "La mujer se pone de pie, luego gira ligeramente a la izquierda mientras el pelo se mueve con la brisa" es mejor que "mujer hermosa en un entorno natural". El prompt de movimiento debe añadir información que las referencias no pueden aportar por sí solas.
Paso 5: Define la duración y la resolución.
El modelo admite salidas de 5 a 10 segundos. Para hacer pruebas, 5 segundos es rápido y cubre la mayoría de necesidades de contenido en redes sociales. Las opciones de resolución incluyen 720p y 1080p.
Paso 6: Genera y revisa.
El tiempo de generación varía según la resolución y la carga del servidor, normalmente entre 60 y 90 segundos. Revisa el resultado en busca de problemas de coherencia, especialmente en los fotogramas de la mitad del clip, donde la deriva es más común.
💡 Consejo: Si tu primera salida muestra deriva del sujeto en la segunda mitad del clip, prueba a acortar el prompt de movimiento. Describir el movimiento en exceso obliga al modelo a alejarse más de las restricciones de la referencia.
Consejos de parámetros para mejores resultados
| Parámetro | Configuración recomendada | Por qué |
|---|
| Prompt negativo | "blurry, low quality, distorted face, inconsistent" | Reduce los artefactos |
| Duración | 5 s para pruebas, 10 s para entregas finales | Contrapartida entre velocidad y calidad |
| Resolución | 1080p para entregas | Máxima fidelidad de salida |
| CFG Scale | 7-9 | Equilibra la adherencia al prompt y la naturalidad |
| Fuerza de referencia | 0,8 o más para trabajos con personajes | Prioriza la fidelidad visual |
Si quieres control del movimiento sobre la pose corporal en lugar de animación libre, cambia a Kling v3 Motion Control para una animación guiada por esqueleto de tu sujeto subido.
También conviene saber que Gen 4 Aleph y Aleph 2 de Runway ofrecen un enfoque complementario: editas un fotograma y el modelo reestiliza el video completo para que coincida. En algunos flujos de trabajo, combinar clips generados con Omni y reestilización basada en Aleph te da tanto coherencia en la generación como control después de generar.
Crea tu primer video con múltiples entradas ahora
La generación de video con múltiples entradas cambia la forma de planificar rodajes y producciones. Cuando puedes introducir varias referencias en una sola generación, dejas de pensar en "qué puedo describir" y empiezas a pensar en "qué quiero mostrar". Ese cambio de enfoque es donde está el verdadero beneficio creativo.
Kling v3 Omni Video en PicassoIA ya está disponible, junto con todos los demás modelos de la familia Kling, incluidos Kling v3 Video y Kling v2.5 Turbo Pro para iterar más rápido y a menor costo. Empieza con una imagen de referencia que ya tengas, escribe un único prompt de movimiento claro y genera tu primer clip en menos de dos minutos.
La biblioteca completa de herramientas de generación y edición de video, incluidas Wan 2.7 I2V, LTX 2 Retake y Modify Video, es accesible a través de PicassoIA sin instalar nada. Explora todo en picassoia.com/en/all-models.