L’édition vidéo multi-entrées n’est pas une simple mise à jour mineure. C’est la différence entre un outil qui génère des clips et un outil qui comprend vraiment ce que vous cherchez à créer. Kling v3 Omni Video est le premier modèle de la gamme Kling à gérer simultanément plusieurs entrées de référence, en combinant des prompts texte, des images de sujet et des références de style dans un seul rendu cohérent. Résultat : un flux de travail de génération de vidéos qui ressemble moins à un jeu de devinettes et plus à une mise en scène.
Ce que signifie vraiment « multi-entrées »
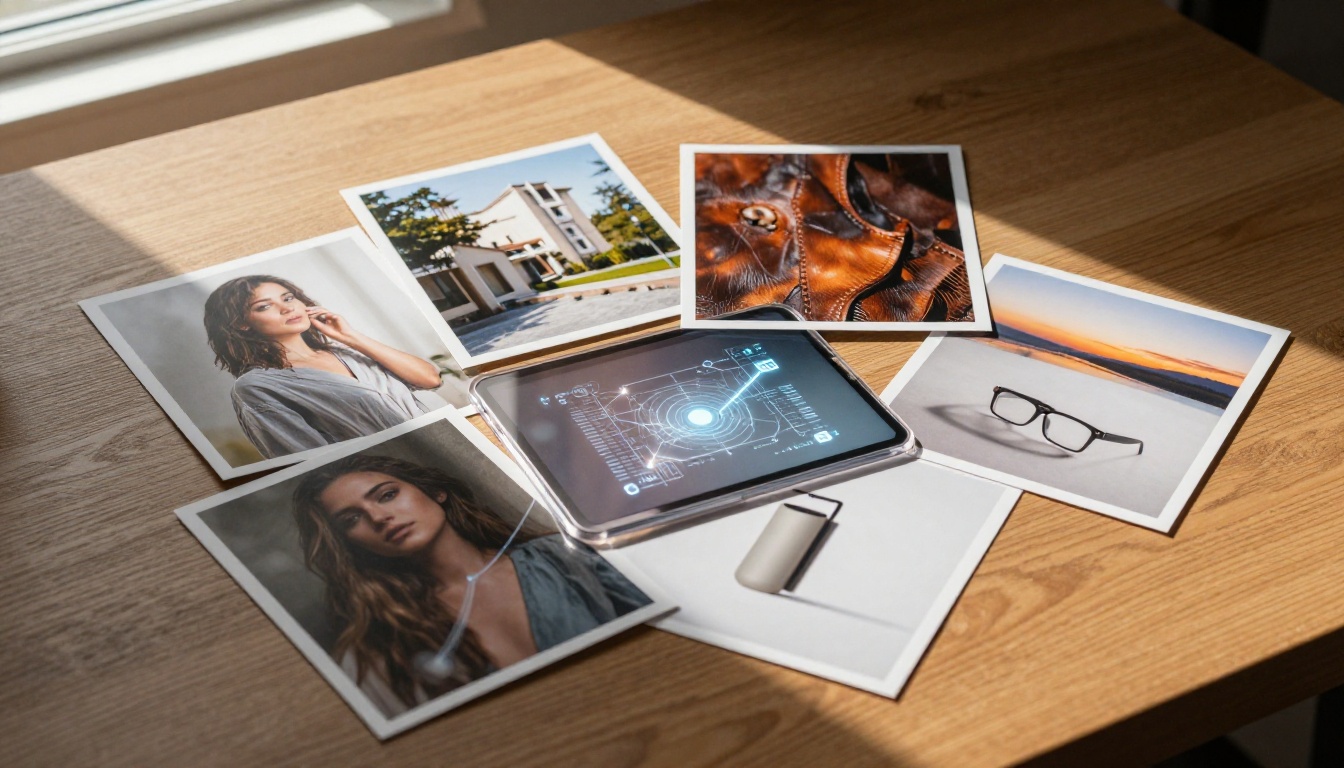
La plupart des modèles de génération vidéo travaillent à partir d’une seule source : soit un prompt textuel, soit une image de référence. Vous décrivez ce que vous voulez, ou vous montrez ce que vous voulez, et le modèle fait de son mieux pour interpréter ce seul signal. La limite apparaît vite. Les prompts uniquement textuels peinent à atteindre la précision visuelle. Les entrées à image unique perdent des détails dès que le mouvement dépasse la première image.
L’édition multi-entrées résout ce problème en permettant au modèle de trianguler à partir de plusieurs sources à la fois. Au lieu de déduire votre intention d’un seul signal, il en lit plusieurs simultanément et les combine en un résultat qui respecte chacun d’eux.
Prompt textuel et références d’images en même temps
Kling v3 Omni Video accepte un prompt textuel de mouvement accompagné d’une ou de plusieurs images de référence. Ces images peuvent jouer des rôles différents. Une image peut définir le sujet principal, une autre l’environnement d’arrière-plan, et une troisième le style d’éclairage. Le modèle lit chaque entrée pour ce qu’elle apporte et les pondère ensemble pendant la génération.
C’est fondamentalement différent des versions précédentes de Kling. Kling v2.6 et Kling v2.1 Master étaient des outils image vers vidéo performants, mais ils travaillaient à partir d’une seule image principale, le texte ne guidant que le mouvement. L’architecture Omni étend cela à des entrées structurelles qui façonnent l’ensemble du résultat, et non seulement l’image de départ.
Comment le modèle traite des entrées empilées
En interne, le modèle traite les entrées de référence à travers un mécanisme d’attention croisée qui pondère la contribution de chaque entrée selon son rôle dans le prompt. Si votre prompt textuel dit « la femme traverse la rue de la ville », le modèle utilise l’image de référence du sujet pour définir l’apparence de la femme, la référence d’environnement pour définir la rue, et le texte pour définir la trajectoire du mouvement.
💡 Astuce : Lorsque vous utilisez plusieurs images de référence, assurez-vous que chacune apporte quelque chose de distinct. Fournir deux images très semblables du même sujet, prises presque sous le même angle, ajoute du bruit plutôt que de l’information.
Les 3 modes gérés par Kling v3 Omni
Le système multi-entrées de Kling v3 Omni Video couvre trois cas d’usage distincts. Chacun répond à un type de créateur différent.
Image vers vidéo avec référence de sujet
C’est le mode le plus direct. Vous fournissez une photographie de haute qualité de votre sujet, rédigez un prompt de mouvement, et le modèle anime le sujet tout en préservant son apparence sur chaque image. La couleur des cheveux, les détails des vêtements, la structure du visage, même certaines textures spécifiques restent cohérents tout au long du clip.
Pour le travail sur les personnages, cela remplace le besoin de décrire entièrement votre personnage en texte. Au lieu d’écrire « une femme aux cheveux bruns ondulés portant une veste rouge », vous montrez au modèle exactement la personne que vous visez. La précision est immédiate, et les résultats sont bien plus constants.
La variante Kling v3 Motion Control va plus loin en ajoutant un contrôle direct des mouvements du corps, mais le modèle Omni de base gère l’animation libre des personnages sans ces contraintes.
Mélange de styles et de scènes
Le second mode utilise les images de référence non pas pour définir un sujet, mais un style visuel ou un environnement. Vous pouvez fournir une photo d’une ruelle précise de Barcelone, puis utiliser un prompt textuel pour placer un personnage qui s’y déplace, sans réellement y tourner.
Cela fonctionne parce que le modèle sépare le contenu sémantique (ce qui figure dans l’image) du style et des informations spatiales (la manière dont la lumière tombe, l’aspect des surfaces, l’agencement de l’espace). Une image de référence de lieu devient un plan visuel plutôt qu’une consigne stricte d’« animer ceci ».
💡 Astuce : Pour les références de lieux, les photographies d’architecture aux conditions d’éclairage constantes donnent de meilleurs résultats que les instantanés pris au smartphone. Le modèle lit directement la direction de la lumière et la qualité des ombres dans l’image de référence.
Superposition de prompts de mouvement
Le troisième mode consiste à empiler des descriptions de mouvement avec des images de référence qui montrent le contexte de ce mouvement. Vous pouvez fournir l’image d’un danseur en pleine pose et un prompt textuel décrivant la trajectoire du mouvement, et le modèle interpole entre la référence statique et le mouvement décrit.
C’est particulièrement efficace pour le type de travail qui exigeait autrefois une animation image par image : gestes précis, mouvements de caméra maîtrisés, présentations de produits contrôlées où la trajectoire compte autant que l’identité visuelle de l’objet.
Là où les modèles à entrée unique échouent
Comprendre ce que Kling v3 Omni Video réussit suppose de comprendre ce que les modèles à entrée unique font mal. Ces limites ne sont pas propres aux concurrents. Elles existaient aussi dans les versions précédentes de Kling.
Le problème de cohérence
Lorsqu’un modèle uniquement textuel génère une vidéo, il doit inventer les détails visuels de toutes pièces. Chaque image est une nouvelle interprétation de votre description. Le résultat : un personnage qui paraît légèrement différent à l’image 12 et à l’image 48, ou un arrière-plan dont la tonalité de couleur change au milieu du clip.
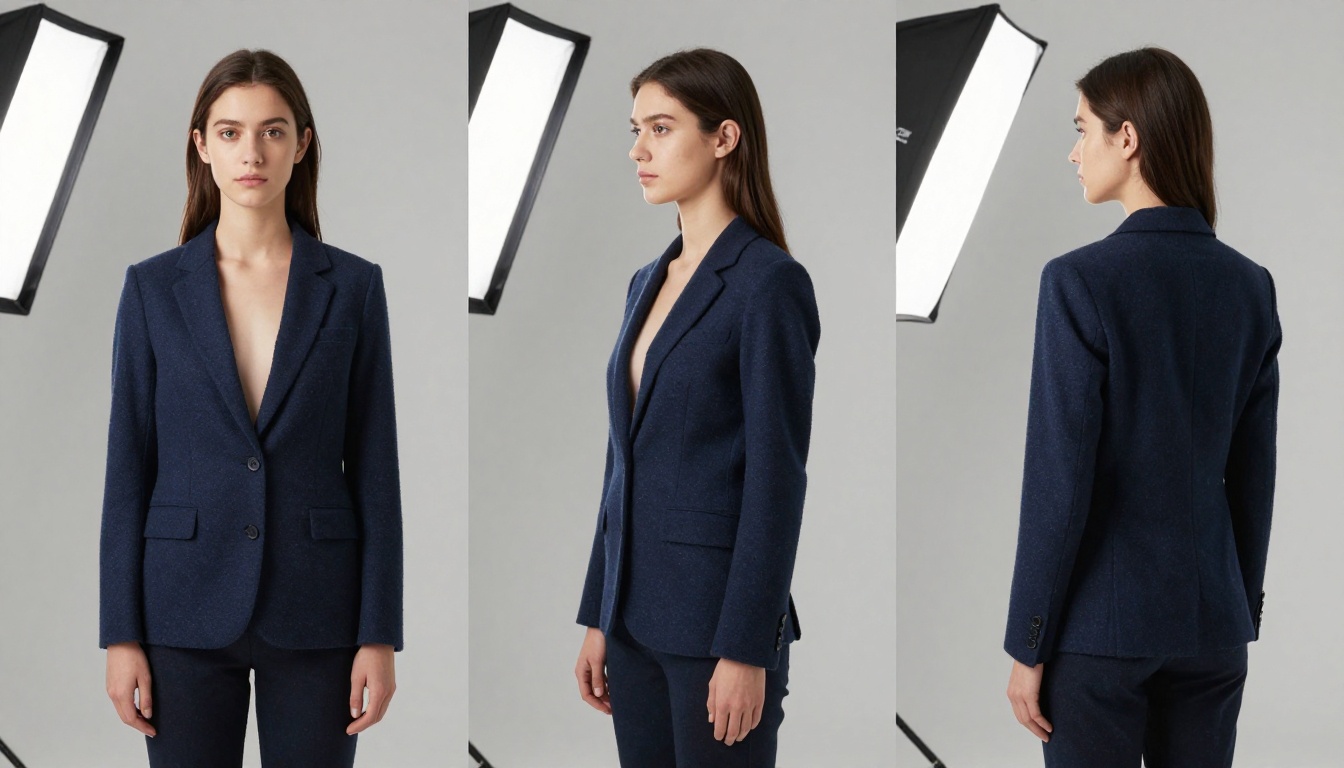
Les modèles à image unique font mieux, mais peinent encore lorsque le mouvement éloigne le sujet de sa pose de départ. Une fois qu’un personnage tourne de 90 degrés par rapport à l’angle de référence, le modèle extrapole, et c’est là que la dérive d’identité commence.
Le multi-entrées donne au modèle plusieurs points d’ancrage. Il peut trianguler l’apparence à partir des différents angles fournis en références, ce qui réduit fortement la dérive, même lors de séquences de mouvement complexes.
La dérive stylistique au fil du temps
Même les modèles qui offrent une bonne cohérence à partir d’une seule image laissent souvent le style dériver sur des clips plus longs. L’éclairage chaleureux d’une image de référence s’estompe vers le milieu du clip et réapparaît de manière inégale à la fin. L’étalonnage des couleurs se décale légèrement. Ce sont des artefacts dus au fait que le modèle perd la trace de la référence lorsque son attention se porte sur la génération d’un mouvement plausible.
L’architecture Omni maintient les références de style actives pendant toute la génération, au lieu de les utiliser uniquement pour conditionner l’image de départ. C’est ce qui la distingue réellement de modèles comme Veo 3 ou Hailuo 02, qui excellent en texte vers vidéo cinématographique, mais n’offrent pas le même ancrage multi-références des sujets.
La cohérence est ce qui sépare les clips réellement utilisables de ceux qui impressionnent pendant trois secondes avant de se déliter.
Fidélité du sujet image après image
Kling v3 Omni Video assure la fidélité du sujet grâce à un ancrage de référence : l’image de référence du sujet n’est pas seulement une entrée de conditionnement à la première image, elle reste une contrainte persistante tout au long du processus de diffusion. Le modèle compare en continu les images générées à la référence pendant l’échantillonnage.
En pratique, cela signifie que la texture des vêtements reste fidèle. Une chemise à rayures reste rayée avec la bonne largeur de rayure, au lieu de se fondre dans un motif vague. Les détails des bijoux persistent. Les traits du visage restent reconnaissables pendant le mouvement, au lieu de se ramollir en une approximation générique.
| Fonctionnalité | Modèles à image unique | Kling v3 Omni Video |
|---|
| Cohérence du sujet sur 5 s | Moyenne (80-90 %) | Élevée (95 % et plus) |
| Préservation du style en cours de clip | Se dégrade | Maintenue |
| Prise en charge de références multi-angles | Non | Oui |
| Séparation arrière-plan et sujet | Limitée | Solide |
| Fidélité du mouvement au prompt | Bonne | Excellente |
Cohérence temporelle
La cohérence temporelle désigne la manière dont une image se relie à la suivante sur l’ensemble du clip. Une vidéo incohérente ressemble à un diaporama : chaque image est plausible prise isolément, mais les transitions entre elles paraissent saccadées ou physiquement impossibles.
L’architecture multi-entrées favorise la cohérence temporelle, car le modèle a davantage de contraintes à respecter. Avec un prompt textuel seul, le modèle dispose d’une liberté considérable pour interpréter chaque image. Avec une référence de sujet et une référence de style verrouillées, l’espace des solutions se resserre, et les décisions restantes sur les trajectoires de mouvement et les transitions d’éclairage deviennent plus maîtrisées.
💡 Astuce : Pour une cohérence temporelle maximale, gardez un prompt de mouvement précis mais pas surchargé. Une seule action claire par clip donne de meilleurs résultats que trois actions simultanées entassées dans un même prompt.
Les flux de travail qui en profitent le plus
Tous les projets vidéo n’ont pas besoin d’édition multi-entrées. Pour les motion designs abstraits ou les clips texte vers vidéo stylisés, un modèle comme Seedance 2.5 ou Ray 3.2 donnera des résultats tout aussi solides avec moins de préparation. L’édition multi-entrées prend toute sa valeur dans des flux de travail précis.
Flux de travail d’animation de personnages
Si vous animez une personne ou un personnage précis sur plusieurs clips, l’édition multi-entrées vous fait gagner énormément de temps. Sans elle, vous réécrivez la même description détaillée du personnage dans chaque prompt en espérant que le modèle l’interprète de manière constante. Avec elle, vous fournissez la référence une seule fois, et le modèle s’occupe du reste.
Cela compte surtout pour les contenus en série : chaînes YouTube qui construisent des vidéos récurrentes centrées sur un personnage, campagnes marketing mettant en scène un porte-parole de marque, ou projets narratifs qui suivent le même protagoniste d’une scène à l’autre. Chaque clip peut présenter un mouvement, des environnements et une ambiance différents, tandis que le personnage reste visuellement identique.
Vidéos de présentation de produits
Le marketing produit se prête parfaitement aux flux multi-entrées. Vous disposez de photos de produits de haute qualité issues de votre bibliothèque existante. Vous voulez présenter ce produit précis, avec ses couleurs et ses finitions exactes, en mouvement dans différents décors.
Le multi-entrées vous permet de fournir les photos du produit comme référence de sujet, de décrire le décor et le mouvement en texte, et de générer une vidéo de produit cohérente sans nouveau tournage. Le modèle lit la finition exacte de la surface du produit dans votre photo de référence, plutôt que dans votre description.
Pour les marques e-commerce, cela ramène ce qui exigerait normalement une journée complète de tournage vidéo à un prompt et quelques images de référence.
Transitions de scène à style harmonisé
Les documentaristes et les réalisateurs de fiction qui travaillent avec la vidéo IA rencontrent un problème particulier : chaque clip généré paraît légèrement différent, ce qui rend les coupures brutales. L’édition multi-entrées résout cela en vous permettant d’utiliser une image d’un clip précédent comme référence de style ou d’environnement pour le suivant, et d’enchaîner ainsi la cohérence visuelle sur une séquence.
C’est proche de ce que les pipelines VFX traditionnels appellent le « look development ». Une fois l’apparence d’une scène verrouillée, chaque plan de cette scène est étalonné pour correspondre. L’édition multi-entrées permet de faire la même chose au moment de la génération, et non en post-production.
Alternatives solides sur PicassoIA
Kling v3 Omni Video n’est pas le seul modèle de PicassoIA qui mérite votre attention pour un travail guidé par référence ou multi-entrées. Selon vos besoins précis, ces alternatives pourraient mieux vous convenir.
Wan 2.7 R2V pour le travail basé sur des références
Wan 2.7 R2V (Reference-to-Video) est conçu spécifiquement autour de l’animation à partir d’images de référence. Il excelle dans l’animation de personnages à partir d’une seule référence solide et produit des résultats très constants pour les contenus orientés portrait. Si votre flux de travail est principalement centré sur les personnages avec peu de besoins environnementaux, Wan 2.7 R2V pourra être plus rapide à itérer.
Le compromis : Wan 2.7 R2V est moins souple pour mélanger plusieurs types de références distincts. Il est optimisé pour les références de sujets, et non pour le flux combiné sujet, environnement et style que gère le modèle Omni.
Vous pouvez aussi l’associer à Wan 2.7 I2V pour l’animation image vers vidéo, lorsque l’approche par référence de sujet convient mieux à votre projet que le pipeline Omni complet.
Seedance 2.5 pour les contenus longs
Seedance 2.5 prend en charge jusqu’à 30 secondes par génération, ce qui en fait le bon choix lorsque la durée compte davantage que la cohérence multi-références. Pour les contenus destinés aux réseaux sociaux, où un long clip unique avec une variation naturelle propre à l’IA est acceptable, Seedance 2.5 offre une qualité cinématographique avec audio natif à grande échelle.
La version gratuite, Seedance 2.5 Lite, gère des clips plus courts allant jusqu’à 10 secondes et mérite d’être testée avant de passer à l’offre Pro.
Kling o1 pour éditer des séquences existantes
Si vous disposez déjà de séquences vidéo et souhaitez les restyliser plutôt que les générer de zéro, Kling o1 est le modèle Kling dédié à l’édition. Il réécrit le contenu vidéo à partir d’instructions textuelles tout en préservant le mouvement et la structure sous-jacents. Combiné à Wan 2.7 Videoedit ou Lucy Edit 2, vous disposez d’un pipeline de post-production complet entièrement sur PicassoIA.
Pour augmenter la résolution des séquences générées ensuite, Real ESRGAN Video gère l’upscaling (augmentation de la résolution) en 4K, et Video Increase Resolution porte la sortie en 8K lorsque la qualité maximale livrable compte.
Kling v3 Omni Video est disponible directement sur PicassoIA. Le flux de travail est simple une fois que vous comprenez comment les champs de saisie correspondent à l’architecture du modèle.
Étape par étape
Étape 1 : Préparez vos images de référence.
Rassemblez les images que vous voulez utiliser comme références. Pour le travail sur les personnages, utilisez un portrait net avec un bon éclairage et une vue claire du visage du sujet et des détails précis de ses vêtements. Pour les références d’environnement, privilégiez des images à l’éclairage constant et directionnel plutôt que des prises de vue grises et uniformes.
Étape 2 : Ouvrez la page du modèle.
Rendez-vous sur Kling v3 Omni Video sur PicassoIA. Vous verrez le panneau de saisie avec les champs pour l’image principale, les références secondaires facultatives et le prompt textuel de mouvement.
Étape 3 : Importez votre référence principale.
L’emplacement de l’image principale est le plus important. C’est l’image qui définit votre sujet ou votre scène principale. Importez la version de meilleure qualité dont vous disposez. Le modèle lit l’image à sa pleine résolution d’import : une référence 4K nette donnera un rendu plus net qu’un recadrage compressé en 720p.
Étape 4 : Rédigez un prompt de mouvement précis.
Décrivez le mouvement en termes chronologiques. « La femme se lève, puis tourne légèrement vers la gauche pendant que ses cheveux bougent avec la brise » vaut mieux que « belle femme dans un cadre naturel ». Le prompt de mouvement doit apporter des informations que les références ne peuvent pas fournir seules.
Étape 5 : Réglez la durée et la résolution.
Le modèle prend en charge des sorties de 5 à 10 secondes. Pour les tests, 5 secondes sont rapides et couvrent la plupart des besoins des contenus sociaux. Les résolutions proposées sont 720p et 1080p.
Étape 6 : Générez et vérifiez.
Le temps de génération varie selon la résolution et la charge du serveur, et dure généralement de 60 à 90 secondes. Vérifiez le résultat pour repérer les problèmes de cohérence, en particulier autour des images du milieu du clip où la dérive est la plus fréquente.
💡 Astuce : Si votre premier résultat présente une dérive du sujet dans la seconde moitié du clip, essayez de raccourcir le prompt de mouvement. Un mouvement trop détaillé pousse le modèle à s’écarter davantage des contraintes de la référence.
Conseils de paramétrage pour de meilleurs résultats
| Paramètre | Réglage recommandé | Pourquoi |
|---|
| Prompt négatif | « flou, faible qualité, visage déformé, incohérent » | Réduit les artefacts |
| Durée | 5 s pour les tests, 10 s pour les versions finales | Compromis entre vitesse et qualité |
| Résolution | 1080p pour les livrables | Fidélité de sortie maximale |
| CFG Scale | 7-9 | Équilibre entre respect du prompt et naturel |
| Force de référence | 0,8 et plus pour le travail sur les personnages | Priorise la fidélité visuelle |
Si vous voulez contrôler la pose du corps plutôt qu’une animation libre, passez à Kling v3 Motion Control pour une animation de votre sujet importé guidée par squelette.
Notons aussi que Gen 4 Aleph et Aleph 2 de Runway proposent une approche complémentaire : vous modifiez une image et le modèle restylise la vidéo complète pour correspondre. Pour certains flux de travail, associer les clips générés par Omni à un restylage Aleph vous donne à la fois la cohérence de génération et le contrôle après génération.
Créez dès maintenant votre première vidéo multi-entrées
La génération de vidéos multi-entrées change la façon dont vous planifiez vos tournages et vos productions. Une fois que vous pouvez intégrer plusieurs références dans une seule génération, vous cessez de penser en termes de « ce que je peux décrire » pour raisonner en termes de « ce que je veux montrer ». C’est ce changement de perspective qui fait toute la valeur créative de l’outil.
Kling v3 Omni Video sur PicassoIA est disponible dès maintenant, aux côtés de tous les autres modèles de la gamme Kling, dont Kling v3 Video et Kling v2.5 Turbo Pro pour itérer plus vite et à moindre coût. Commencez avec une image de référence que vous possédez déjà, rédigez un prompt de mouvement clair et unique, et générez votre premier clip en moins de deux minutes.
L’ensemble des outils de génération et d’édition vidéo, dont Wan 2.7 I2V, LTX 2 Retake et Modify Video, sont accessibles sur PicassoIA sans rien installer. Parcourez tout le catalogue sur picassoia.com/en/all-models.