A edição de vídeo com várias entradas não é uma simples atualização de recurso. É a diferença entre uma ferramenta que gera clipes e uma ferramenta que entende de verdade o que você está tentando criar. O Kling v3 Omni Video é o primeiro modelo da linha Kling a lidar com várias entradas de referência ao mesmo tempo, combinando prompts de texto, imagens de personagens ou objetos e referências de estilo em um único resultado coerente. O resultado é um fluxo de trabalho de geração de vídeo que parece menos um jogo de adivinhação e mais uma direção de cena.
O que significa "múltiplas entradas", na prática
A maioria dos modelos de geração de vídeo trabalha a partir de uma única fonte: um prompt de texto ou uma imagem de referência. Você escreve o que quer, ou mostra o que quer, e o modelo faz o melhor que pode para interpretar esse único sinal. A limitação aparece rápido. Prompts somente de texto têm dificuldade com a especificidade visual. Entradas de uma única imagem perdem detalhes quando o movimento vai além do primeiro quadro.
A edição com múltiplas entradas resolve isso ao permitir que o modelo faça a triangulação a partir de várias fontes ao mesmo tempo. Em vez de inferir sua intenção a partir de um único sinal, ele lê vários simultaneamente e os sintetiza em um resultado que respeita todos eles.
Texto mais referências de imagem, ao mesmo tempo
O Kling v3 Omni Video aceita um prompt de texto com o movimento desejado junto com uma ou mais imagens de referência. Essas imagens podem ter papéis diferentes. Uma pode definir o sujeito principal, outra pode definir o ambiente de fundo, e uma terceira pode ancorar o estilo de iluminação. O modelo lê cada entrada pelo que ela contribui e as pondera em conjunto durante a geração.
Isso é fundamentalmente diferente das versões anteriores do Kling. O Kling v2.6 e o Kling v2.1 Master eram ferramentas fortes de imagem para vídeo, mas operavam com uma única imagem principal, com o texto guiando apenas o movimento. A arquitetura Omni estende isso para aceitar entradas estruturais que moldam o resultado inteiro, e não apenas o primeiro quadro.
Como o modelo processa várias entradas combinadas
Internamente, o modelo processa as entradas de referência por meio de um mecanismo de atenção cruzada que pondera a contribuição de cada entrada com base no papel dela no prompt. Se seu prompt de texto disser "a mulher caminha pela rua da cidade", o modelo usa a imagem de referência do sujeito para definir a aparência da mulher, a referência de ambiente para definir a rua, e o texto para definir o arco do movimento.
💡 Dica: Ao usar várias referências de imagem, garanta que cada uma contribua com algo distinto. Enviar duas imagens parecidas do mesmo sujeito, quase no mesmo ângulo, acrescenta ruído em vez de informação.
Os 3 modos que o Kling v3 Omni cobre
O sistema de múltiplas entradas do Kling v3 Omni Video cobre três casos de uso distintos. Cada um atende a um tipo diferente de criador.
Imagem para vídeo com referência do sujeito
Este é o modo mais direto. Você fornece uma fotografia de alta qualidade do seu sujeito, escreve um prompt de movimento, e o modelo anima o sujeito preservando a aparência dele em cada quadro. Cor do cabelo, detalhes da roupa, estrutura facial e até texturas específicas continuam consistentes ao longo de todo o clipe.
Para trabalhos com personagens, isso dispensa a necessidade de descrever o personagem inteiro em texto. Em vez de escrever "uma mulher de cabelo escuro e ondulado usando uma jaqueta vermelha", você mostra ao modelo exatamente quem você quer dizer. A especificidade é imediata, e os resultados são bem mais consistentes.
A variante Kling v3 Motion Control vai além ao adicionar controle direto do movimento do corpo, mas o modelo Omni principal lida com a animação livre de personagens sem essas restrições.
Mistura de estilo e cena
O segundo modo usa imagens de referência não para definir um sujeito, mas para definir um estilo visual ou um ambiente. Você pode fornecer a fotografia de um beco específico em Barcelona e, em seguida, usar um prompt de texto para colocar um personagem caminhando por ele sem precisar filmar lá.
Isso funciona porque o modelo separa o conteúdo semântico (o que está na imagem) das informações de estilo e espaciais (como ela é iluminada, como são as superfícies, como o espaço está organizado). Uma imagem de referência de um local se torna um projeto visual, e não uma instrução estrita de "animar isto".
💡 Dica: Para referências de locais, fotografias de arquitetura com condições de iluminação consistentes funcionam melhor do que fotos de celular. O modelo lê a direção da luz e a qualidade da sombra diretamente da imagem de referência.
Sobreposição de prompts de movimento
O terceiro modo envolve empilhar descrições de movimento com imagens de referência que mostram o contexto do movimento. Você pode fornecer a imagem de um dançarino no meio de uma pose e um prompt de texto descrevendo o arco do movimento, e o modelo interpola entre a referência estática e o movimento descrito.
Isso é especialmente eficaz para o tipo de trabalho que antes exigia animação quadro a quadro: gestos específicos, movimentos precisos de câmera, revelações controladas de produtos em que a trajetória do movimento importa tanto quanto a identidade visual do objeto.
Onde os modelos de entrada única ficam aquém
Entender o que o Kling v3 Omni Video acerta exige entender o que os modelos de entrada única erram. Essas não são falhas exclusivas dos concorrentes. Também foram limitações das versões anteriores do Kling.
O problema da consistência
Quando um modelo somente de texto gera um vídeo, ele precisa inventar os detalhes visuais do zero. Cada quadro é uma nova interpretação da sua descrição. O resultado: um personagem que parece sutilmente diferente no quadro 12 em relação ao quadro 48, ou um fundo que muda de tom de cor no meio do clipe.
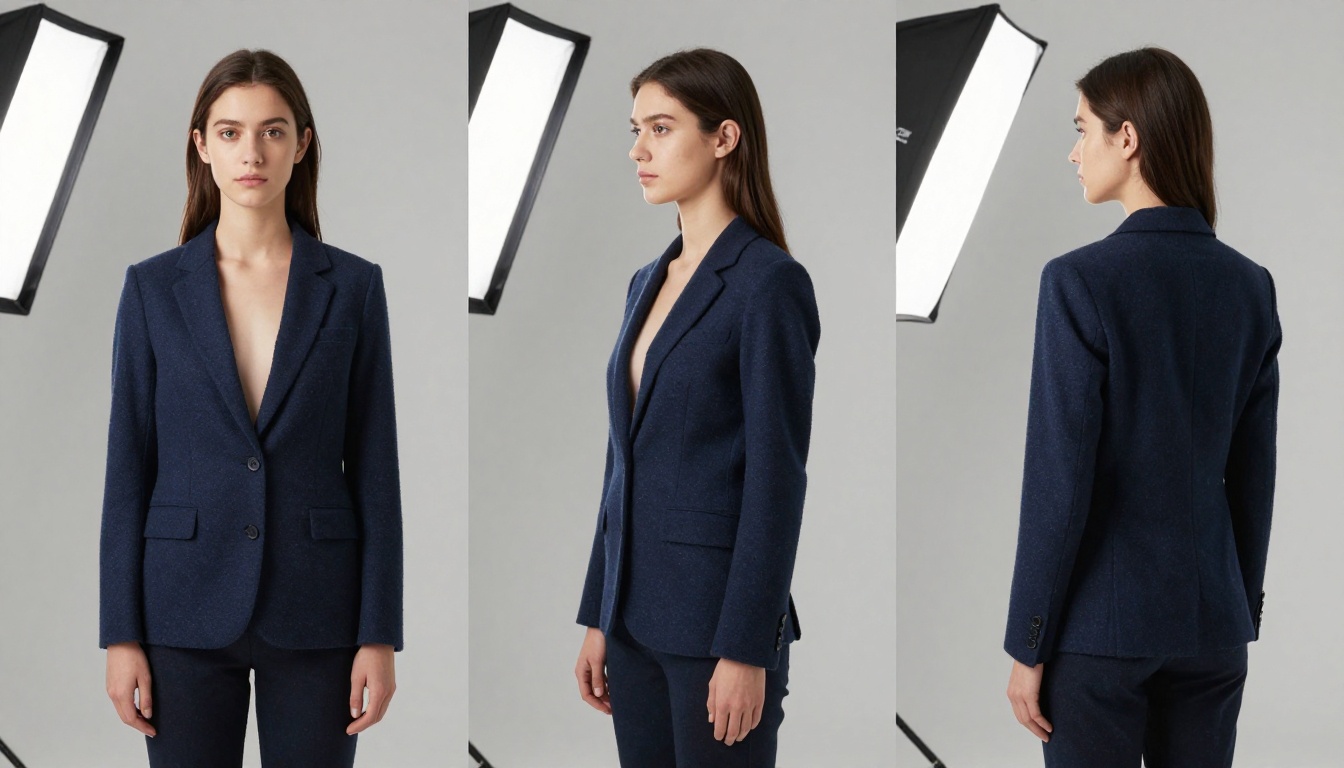
Modelos de entrada de uma única imagem melhoram isso, mas ainda têm dificuldade quando o movimento afasta o sujeito da pose inicial. Quando um personagem gira 90 graus em relação ao ângulo de referência, o modelo está essencialmente extrapolando, e é aí que começa a deriva de identidade.
A entrada múltipla dá ao modelo vários pontos de ancoragem. Ele pode triangular a aparência a partir de diferentes ângulos fornecidos como referências, o que reduz drasticamente a deriva mesmo em sequências de movimento complexas.
Deriva de estilo ao longo do tempo
Mesmo modelos com forte coerência de imagem única costumam deixar o estilo derivar em clipes mais longos. A iluminação quente de uma imagem de referência se apaga no meio do clipe e reaparece de forma irregular no final. A correção de cor muda levemente. Esses são artefatos do modelo perdendo o controle da referência enquanto a atenção se volta para gerar um movimento plausível.
A arquitetura Omni mantém as referências de estilo ativas durante toda a geração, em vez de usá-las apenas para condicionar o primeiro quadro. É isso que a torna genuinamente diferente de modelos como o Veo 3 ou o Hailuo 02, que se destacam em texto para vídeo cinematográfico, mas não oferecem a mesma ancoragem de sujeito com múltiplas referências.
Como o Kling v3 Omni mantém os visuais consistentes
Consistência é o que separa clipes que você realmente pode usar de clipes que impressionam por três segundos e depois desmontam.
Fidelidade do sujeito entre quadros
O Kling v3 Omni Video alcança a fidelidade do sujeito por meio de vinculação de referência: a imagem de referência do sujeito não é apenas uma entrada de condicionamento no quadro zero, ela permanece como uma restrição persistente durante todo o processo de difusão. O modelo verifica continuamente os quadros gerados em relação à referência durante a amostragem.
Na prática, isso significa que a textura da roupa continua fiel ao original. Uma camisa listrada continua listrada, com a largura correta das listras, em vez de se dissolver em um padrão vago. Detalhes de joias persistem. Traços faciais continuam reconhecíveis durante o movimento, em vez de suavizar em uma aproximação genérica.
| Recurso | Modelos de imagem única | Kling v3 Omni Video |
|---|
| Consistência do sujeito em 5s | Moderada (80-90%) | Alta (95%+) |
| Preservação do estilo no meio do clipe | Degrada | Mantida |
| Suporte a referências de múltiplos ângulos | Não | Sim |
| Separação entre fundo e sujeito | Limitada | Forte |
| Fidelidade do movimento ao prompt | Boa | Excelente |
Coerência temporal
Coerência temporal se refere a quão suavemente um quadro se conecta ao seguinte ao longo de todo o clipe. Um vídeo incoerente parece uma apresentação de slides: cada quadro é plausível isoladamente, mas as transições entre eles parecem bruscas ou fisicamente impossíveis.
A arquitetura de múltiplas entradas ajuda a coerência temporal porque o modelo tem mais restrições a respeitar. Só com um prompt de texto, o modelo tem enorme liberdade para interpretar cada quadro. Com uma referência de sujeito e uma referência de estilo travadas, o espaço de soluções se estreita, e as decisões restantes sobre trajetórias de movimento e transições de iluminação ficam mais controladas.
💡 Dica: Para máxima coerência temporal, mantenha seu prompt de movimento específico, mas não sobrecarregado. Uma ação clara por clipe funciona melhor do que três ações simultâneas espremidas em um único prompt.
Fluxos de trabalho que mais se beneficiam
Nem todo projeto de vídeo precisa de edição com múltiplas entradas. Para motion graphics abstratos ou clipes estilizados de texto para vídeo, um modelo como o Seedance 2.5 ou o Ray 3.2 vai produzir resultados igualmente fortes com menos configuração. A edição com múltiplas entradas se justifica em fluxos de trabalho específicos.
Fluxos de animação de personagens
Se você está animando uma pessoa ou um personagem específico em vários clipes, a edição com múltiplas entradas economiza muito tempo. Sem ela, você escreve a mesma descrição detalhada do personagem em cada prompt e torce para que o modelo a interprete de forma consistente. Com ela, você fornece a referência uma vez e o modelo cuida do resto.
Isso importa especialmente para conteúdos em série: canais do YouTube que constroem vídeos recorrentes com personagens, campanhas de marketing com um porta-voz da marca, ou projetos de narrativa que acompanham a mesma protagonista em várias cenas. Cada clipe pode ter movimentos, ambientes e humores diferentes, mas o personagem continua visualmente idêntico.
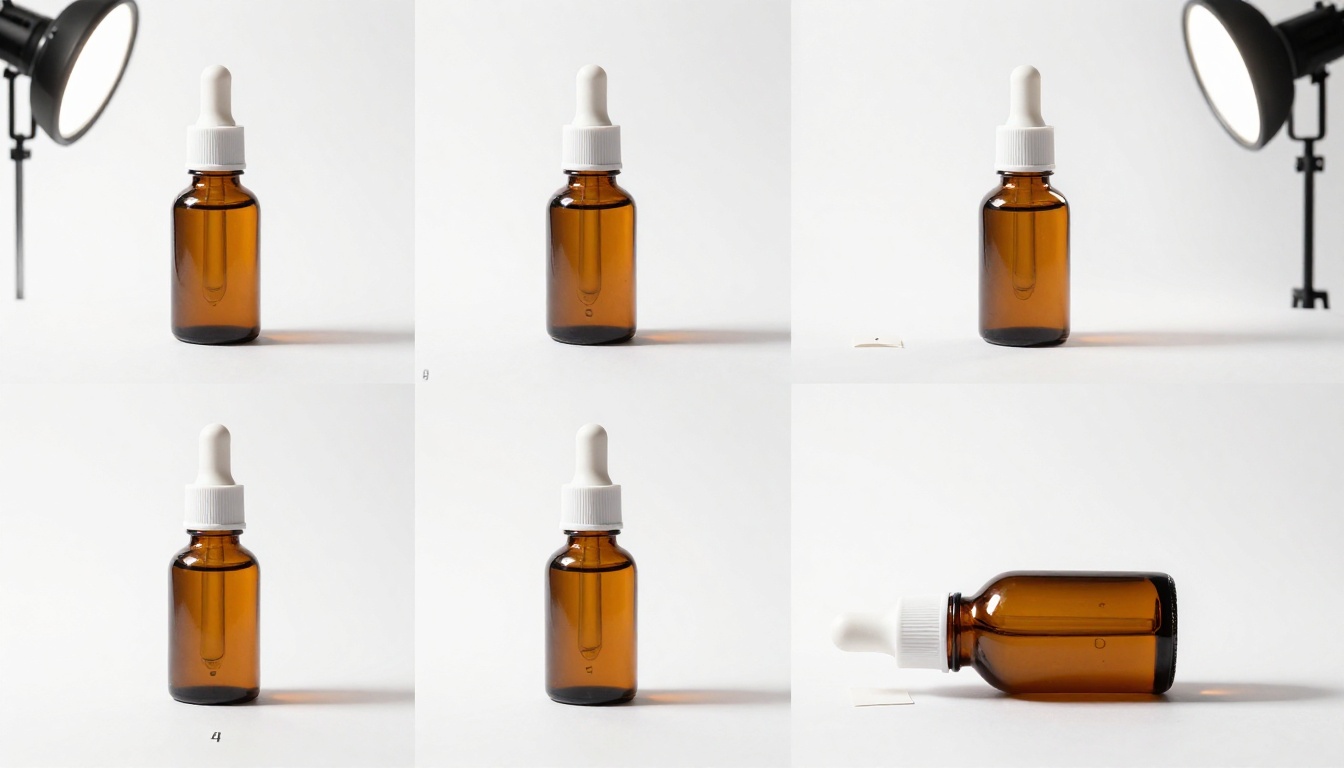
Vídeos de vitrine de produtos
O marketing de produtos está em um lugar perfeito para fluxos de trabalho com múltiplas entradas. Você tem fotografias de produto de alta qualidade da sua biblioteca existente. Quer que aquele produto específico, com suas cores e acabamentos exatos, apareça em movimento em vários cenários.
A edição com múltiplas entradas permite alimentar as fotos do produto como referência de sujeito, descrever o cenário e o movimento em texto e gerar um vídeo consistente do produto sem refazer a filmagem. O modelo lê o acabamento exato da superfície do produto a partir da sua foto de referência, e não a partir da sua descrição dele.
Para marcas de e-commerce, isso condensa o que normalmente seria uma sessão de gravação de um dia inteiro em um prompt e algumas imagens de referência.
Transições de cena com estilo combinado
Cineastas de documentário e de narrativa que trabalham com vídeo de IA enfrentam um problema específico: cada clipe gerado parece um pouco diferente, o que torna os cortes abruptos. A edição com múltiplas entradas resolve isso ao permitir usar um quadro de um clipe anterior como referência de estilo ou de ambiente para o próximo, encadeando a consistência visual ao longo de uma sequência.
Isso se aproxima do que os pipelines tradicionais de VFX chamam de "desenvolvimento de look". Depois de travar o visual de uma cena, cada plano dessa cena recebe a mesma correção de cor. A edição com múltiplas entradas permite fazer a mesma coisa no momento da geração, e não na pós-produção.
Alternativas fortes no PicassoIA
O Kling v3 Omni Video não é o único modelo no PicassoIA que vale conhecer para trabalhos guiados por referência ou com múltiplas entradas. Dependendo das suas necessidades específicas, estas alternativas podem se adequar melhor.
Wan 2.7 R2V para trabalhos baseados em referência
O Wan 2.7 R2V (Reference-to-Video) é construído especificamente em torno do conceito de animar a partir de imagens de referência. Ele se destaca na animação de personagens a partir de uma única referência forte e produz resultados muito consistentes para conteúdo com foco em retratos. Se o seu fluxo é principalmente centrado em personagens, com necessidades ambientais limitadas, o Wan 2.7 R2V pode ser mais rápido para iterar.
A contrapartida: o Wan 2.7 R2V é menos flexível para misturar vários tipos distintos de referência. Ele é otimizado para referências de sujeito, e não para o fluxo combinado de sujeito, ambiente e estilo que o modelo Omni cobre.
Você também pode combiná-lo com o Wan 2.7 I2V para animação de imagem para vídeo quando a abordagem de referência de sujeito se encaixar melhor no seu projeto do que o pipeline Omni completo.
Seedance 2.5 para conteúdo de longa duração
O Seedance 2.5 suporta até 30 segundos por geração, o que o torna a escolha certa quando a duração importa mais do que a consistência com múltiplas referências. Para conteúdo de redes sociais em que um único clipe longo com variação natural de IA é aceitável, o Seedance 2.5 entrega qualidade cinematográfica com áudio nativo em escala.
A versão gratuita, o Seedance 2.5 Lite, lida com clipes mais curtos de até 10 segundos e vale a pena testar antes de se comprometer com o plano Pro.
Kling o1 para editar filmagens existentes
Se você já tem filmagens e quer redefinir o estilo delas em vez de gerar do zero, o Kling o1 é o modelo Kling específico para edição. Ele reescreve o conteúdo do vídeo com base em instruções de texto, preservando o movimento e a estrutura subjacentes. Combinado com o Wan 2.7 Videoedit ou o Lucy Edit 2, você tem um pipeline completo de pós-produção inteiramente dentro do PicassoIA.
Para aumentar a resolução dos vídeos gerados depois, o Real ESRGAN Video faz upscaling para 4K, e o Video Increase Resolution leva a saída a 8K quando a qualidade máxima de entrega importa.
Como usar o Kling v3 Omni no PicassoIA
O Kling v3 Omni Video está disponível diretamente no PicassoIA. O fluxo é simples depois que você entende como os campos de entrada se relacionam com a arquitetura do modelo.
Passo a passo
Passo 1: Prepare suas imagens de referência.
Reúna as imagens que você quer usar como referência. Para trabalhos com personagens, use um retrato limpo, com boa iluminação e uma visão clara do rosto do sujeito e dos detalhes específicos da roupa. Para referências de ambiente, use imagens com iluminação consistente e direcional, em vez de tomadas chapadas de céu nublado.
Passo 2: Abra a página do modelo.
Acesse a página do Kling v3 Omni Video no PicassoIA. Você verá o painel de entrada com campos para a imagem principal, referências secundárias opcionais e o prompt de texto com o movimento.
Passo 3: Envie sua referência principal.
O campo da imagem principal é o mais importante. Essa é a imagem que define seu sujeito ou cena principal. Envie a versão de maior qualidade que você tiver. O modelo lê na resolução total enviada, então uma referência nítida em 4K vai gerar um resultado mais definido do que um recorte comprimido em 720p.
Passo 4: Escreva um prompt de movimento específico.
Descreva o movimento em termos cronológicos. "A mulher se levanta, depois vira levemente para a esquerda enquanto o cabelo se move com a brisa" é melhor do que "mulher bonita em um cenário natural". O prompt de movimento deve acrescentar informações que as referências não podem fornecer sozinhas.
Passo 5: Defina a duração e a resolução.
O modelo aceita saídas de 5 a 10 segundos. Para testes, 5 segundos é rápido e atende à maioria das necessidades de conteúdo para redes sociais. As opções de resolução incluem 720p e 1080p.
Passo 6: Gere e revise.
O tempo de geração varia conforme a resolução e a carga do servidor, normalmente de 60 a 90 segundos. Revise o resultado em busca de problemas de consistência, especialmente nos quadros do meio do clipe, onde a deriva é mais comum.
💡 Dica: Se sua primeira saída tiver deriva do sujeito na segunda metade do clipe, tente encurtar o prompt de movimento. Um movimento descrito em excesso força o modelo a se afastar ainda mais das restrições da referência.
Dicas de parâmetros para melhores resultados
| Parâmetro | Configuração recomendada | Por quê |
|---|
| Prompt negativo | "borrado, baixa qualidade, rosto distorcido, inconsistente" | Reduz artefatos |
| Duração | 5s para testes, 10s para versões finais | Contrapartida entre velocidade e qualidade |
| Resolução | 1080p para entregas | Máxima fidelidade de saída |
| CFG Scale | 7-9 | Equilibra a adesão ao prompt e a naturalidade |
| Força da referência | 0.8+ para trabalhos com personagens | Prioriza a fidelidade visual |
Se você quer controle de movimento sobre a pose do corpo em vez de animação livre, mude para o Kling v3 Motion Control para animação guiada por esqueleto do sujeito enviado.
Vale notar também que o Gen 4 Aleph e o Aleph 2, da Runway, oferecem uma abordagem complementar: você edita um quadro e o modelo redesenha o vídeo inteiro para combinar. Em certos fluxos de trabalho, combinar clipes gerados pelo Omni com a redefinição de estilo baseada no Aleph dá a você consistência de geração e controle pós-geração.
A geração de vídeo com múltiplas entradas muda a forma como você planeja gravações e produções. Quando você consegue alimentar várias referências em uma única geração, deixa de pensar em "o que consigo descrever" e passa a pensar em "o que quero mostrar". Essa mudança de perspectiva é onde está o verdadeiro benefício criativo.
O Kling v3 Omni Video no PicassoIA já está disponível, junto com todos os outros modelos da linha Kling, incluindo o Kling v3 Video e o Kling v2.5 Turbo Pro, para iterações mais rápidas e com custo menor. Comece com uma imagem de referência que você já tem, escreva um único prompt de movimento claro e gere seu primeiro clipe em menos de dois minutos.
A biblioteca completa de ferramentas de geração e edição de vídeo, incluindo o Wan 2.7 I2V, o LTX 2 Retake e o Modify Video, está acessível pelo PicassoIA sem instalar nada. Veja tudo em picassoia.com/en/all-models.