La mayoría de la gente que busca un LoRA NSFW para ComfyUI se atasca en los mismos tres puntos: el flujo de trabajo no hace nada, los resultados salen quemados o no sabe qué archivo es seguro descargar. Este artículo resuelve los tres. Obtienes un flujo de trabajo mínimo y gratuito que puedes reconstruir en cinco minutos, ajustes iniciales para Flux, Z-Image y SDXL, estructuras de prompt que producen fotografía de glamour y estilo lencería, y una lista clara para encontrar archivos LoRA sin jugarte el equipo.
Todo lo que aparece aquí está pensado para trabajo para adultos, no explícito y fotorrealista: bikinis, lencería, boudoir, playa y glamour editorial. Si quieres el mismo look sin instalar nada, al final hay una opción sin GPU.
Qué hace realmente un LoRA NSFW
Un LoRA es un pequeño archivo complementario, normalmente de entre 20 MB y 400 MB, que empuja un modelo base hacia un estilo, un vocabulario de poses, un aspecto de tejido o un tipo de cuerpo. No reemplaza tu checkpoint. Se coloca encima, por eso el mismo LoRA puede verse genial en un modelo base y muy mal en otro.
LoRA frente a checkpoint
| Elemento | Tamaño típico | Qué controla | Costo de cambio |
|---|
| Checkpoint (modelo base) | 2 a 24 GB | Realismo general, anatomía, lógica de la iluminación | Lento, descarga grande |
| LoRA | 20 a 400 MB | Estilo, detalle de la ropa, hábitos de pose, aspecto de la piel | Instantáneo, un nodo |
| Embedding | Menos de 1 MB | Un solo concepto mediante un token | Instantáneo |
La conclusión práctica: elige primero el modelo base y luego busca LoRA entrenados sobre él.
Empareja el modelo base
Esta es la razón número uno por la que un LoRA "no hace nada" o produce fotogramas negros y con ruido. Un LoRA entrenado en SDXL no funciona en Flux, y un LoRA de Flux no funciona en SDXL. Mira la etiqueta del modelo base en la página de descarga antes de guardar nada.
💡 Prueba rápida: si tu imagen parece estática, un gris desvaído o una masa derretida evidente con strength 1.0, el modelo base y el LoRA casi seguro no coinciden.
El flujo de trabajo gratuito, paso a paso
No necesitas un monstruo de 60 nodos. Un flujo de trabajo limpio para LoRA tiene siete nodos y cada uno tiene una función.
Nodos que necesitas
- Load Checkpoint (o los nodos separados Load Diffusion Model, Load CLIP y Load VAE para Flux y Z-Image).
- Load LoRA. Va justo después del cargador del checkpoint y recibe las salidas de modelo y CLIP.
- CLIP Text Encode para el prompt positivo.
- CLIP Text Encode para el prompt negativo (sáltalo o déjalo vacío en Flux).
- Empty Latent Image para la resolución.
- KSampler para seed, steps, CFG, sampler y scheduler.
- VAE Decode conectado a Save Image.
El único truco está en el orden de conexiones. Las salidas de modelo y CLIP del checkpoint pasan primero al nodo Load LoRA. Después, las salidas de Load LoRA alimentan el KSampler y los dos codificadores de texto. Si conectas los codificadores de texto directamente al checkpoint, el LoRA se carga pero nunca se usa, y es un fallo silencioso muy común.
Estructura de carpetas
Coloca los archivos aquí y pulsa R en ComfyUI para actualizar las listas:
ComfyUI/models/checkpoints para checkpoints de estilo SDXLComfyUI/models/diffusion_models para modelos de estilo Flux y Z-ImageComfyUI/models/loras para el propio LoRAComfyUI/models/vae y ComfyUI/models/text_encoders para los extras
💡 Crea subcarpetas como loras/flux y loras/sdxl. Cuando tu biblioteca llegue a 50 archivos, te alegrará haberlo hecho.
Conexión en cinco minutos
Añade el nodo Load LoRA, elige tu archivo y pon strength_model y strength_clip con el mismo valor, empezando en 0.8. Añade la palabra desencadenante, si el autor la indica, al principio de tu prompt positivo. Lanza un lote de cuatro con semillas distintas. Juzga el LoRA por el lote, nunca por una sola imagen.
Para apilar un segundo LoRA (por ejemplo, un LoRA de textura de piel más un LoRA de prenda), encadena otro nodo Load LoRA después del primero y baja ambos a unos 0.5 a 0.7.
Ajustes que realmente funcionan
Estos son puntos de partida, no leyes. Cada página de LoRA suele indicar sus propios valores recomendados, y esos prevalecen sobre cualquier cosa de esta tabla.
| Ajuste | Modelos de estilo Flux | Estilo Z-Image Turbo | Estilo SDXL |
|---|
| Strength del LoRA | 0.7 a 1.0 | 0.6 a 0.9 | 0.6 a 0.9 |
| Steps | 20 a 28 | 8 a 10 | 25 a 35 |
| CFG / guidance | 2.5 a 4 | 1 | 5 a 7 |
| Sampler | euler | euler o res_multistep | dpmpp_2m |
| Scheduler | simple o beta | simple | karras |
| Resolución | 1024 x 1536 | 1024 x 1536 | 832 x 1216 |
| Prompt negativo | No se usa | No se usa | Sí, corto |
Ajustes para Flux y Z-Image
Los modelos de estilo Flux usan guidance, no el CFG clásico, así que mantenlo bajo. Subirlo por encima de 4.5 da piel de plástico y sombras duras. Los modelos turbo como Z Image Turbo están pensados para muy pocos steps, así que más steps no ayudan. Subirlos suele añadir ruido.
Ajustes para SDXL
SDXL depende de un prompt negativo bien hecho y de un CFG intermedio. Si pasas de 8, obtienes piel sobresaturada y dura. Si la imagen parece quemada, baja primero el CFG y luego el strength.
Strength y apilado
- Demasiado fuerte (por encima de 1.0): manos deformadas, patrones repetidos, brillo plástico, rostros que parecen todos iguales.
- Demasiado débil (por debajo de 0.4): el LoRA apenas se ve y desperdicias su palabra desencadenante.
- Punto óptimo: de 0.65 a 0.9 para un LoRA suelto, de 0.4 a 0.7 cada uno cuando apilas dos o tres.
💡 Prueba con un XY plot o, sencillamente, ejecuta la misma semilla con 0.5, 0.7, 0.9 y 1.1. Noventa segundos de pruebas ahorran una hora de adivinanzas.
Prompts que se mantienen elegantes
El look que buscas es el de una sesión de glamour de revista, no una instantánea anónima. Eso significa describir la fotografía, no solo a la persona. La cámara, el objetivo, la luz y la tela hacen la mayor parte del trabajo.
Una estructura de prompt que funciona
Usa este orden: palabra desencadenante, sujeto, prenda, pose, escenario, luz, cámara, textura.
Ejemplo para un modelo de estilo Flux o Z-Image:
trigger_word, mujer adulta de unos veintitantos años, bikini rojo de dos piezas, de pie en una terraza de estuco blanco, mano en el pelo, luz contraluz dorada desde la derecha, 85mm f/1.8, profundidad de campo reducida, poros visibles en la piel, ligeras pecas, grano fino de película, color Kodak Portra 400
Ejemplo para SDXL:
trigger_word, foto de una mujer adulta, body de encaje champán, sentada en el borde de una cama de hotel, luz suave de ventana con cielo nublado, objetivo de 70mm, textura natural de la piel, tonos cálidos apagados, grano de película
Prompt negativo solo para SDXL:
cartoon, illustration, 3d render, plastic skin, extra fingers, deformed hands, blurry, watermark, text, low quality
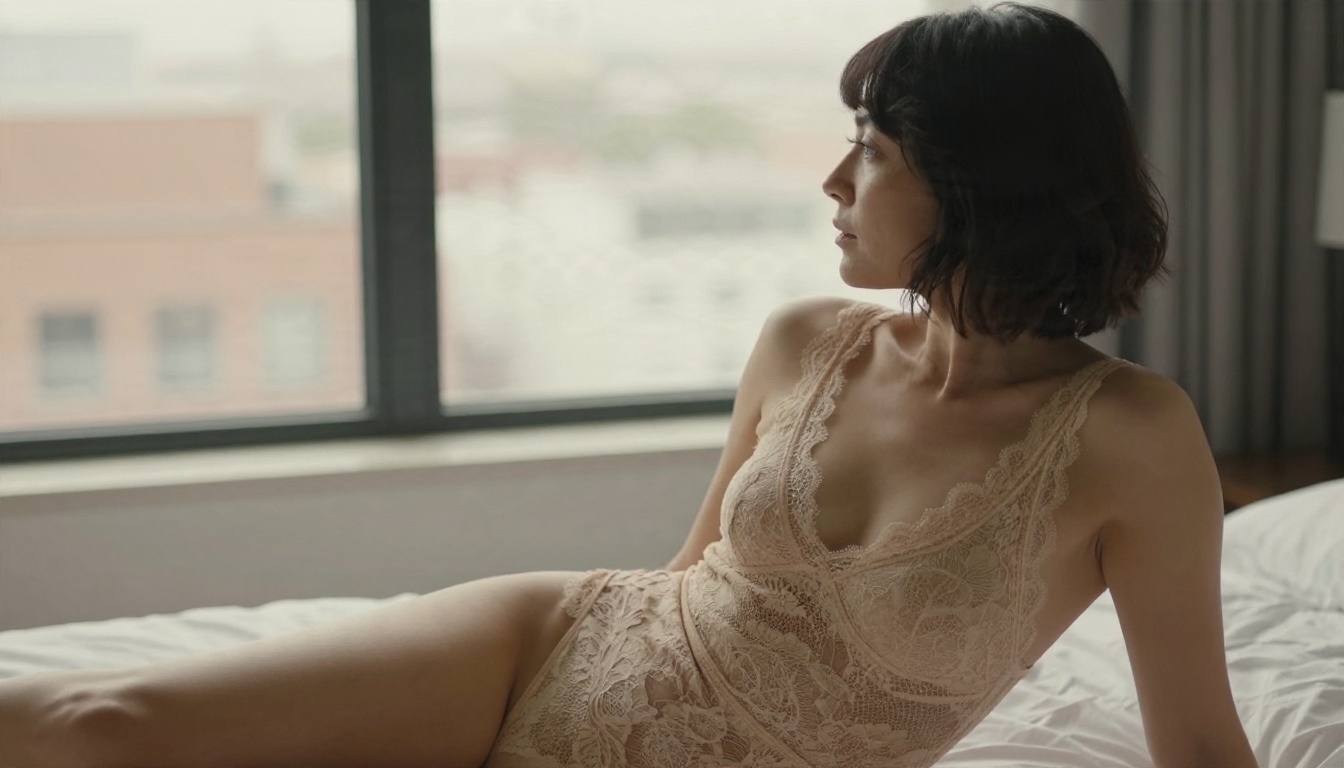
Palabras que afinan el realismo
- Luz: "luz suave de ventana desde la izquierda", "contraluz de hora dorada", "luz difusa de día nublado", "lámpara cálida de tungsteno".
- Cámara: "85mm f/1.8", "35mm f/2", "disparo a la altura de los ojos", "ángulo bajo".
- Textura: "poros visibles", "trama del tejido", "detalle de encaje", "brillo natural de la piel", "mechones sueltos".
- Look de película: "Kodak Portra 400", "grano fino", "transición suave de las altas luces".
Palabras que dan problemas
Evita acumular etiquetas de calidad vagas como "masterpiece, best quality, ultra detailed, 8k, hdr" en los modelos de estilo Flux actuales. Se diseñaron para sistemas antiguos y tienden a añadir un aspecto falso, con nitidez excesiva. Una sola indicación concreta de cámara vale más que diez adjetivos vacíos.
Mantén a los sujetos adultos e inventados
Describe sujetos adultos y ficticios. No uses un LoRA creado a partir del rostro de una persona real sin su consentimiento y nunca crees nada que involucre a menores. Es un límite tanto legal como de simple decencia, y los sitios de alojamiento de LoRA con buena reputación eliminan el contenido que lo traspasa.
Tres lugares concentran la mayor parte de lo que usa la gente.
| Fuente | Ideal para | Cuidado con |
|---|
| Civitai | La biblioteca más grande, imágenes de muestra con los ajustes incrustados | Revisa la etiqueta del modelo base, los filtros de contenido y la licencia de cada archivo |
| Hugging Face | Repositorios más limpios, versiones oficiales y de investigación | Menor selección NSFW, nombres de archivo menos amigables |
| Entrenamiento propio | Look exacto, control total | Necesita entre 20 y 60 imágenes limpias y una GPU o un entrenador en la nube |
Una comprobación de seguridad en cinco puntos
Antes de colocar un archivo en models/loras, repasa esta lista:
- Formato: descarga solo
.safetensors. Evita los archivos pickle .ckpt y .pt, que pueden ejecutar código al cargarse.
- Modelo base: coincide con tu checkpoint (Flux, SDXL, Z-Image, etc.).
- Imágenes de muestra: al menos algunas generaciones que se parezcan al estilo que buscas, con los ajustes visibles.
- Licencia: lee lo que permite el autor, sobre todo para uso comercial.
- Comentarios: revisa si hay reportes de archivos rotos, palabras desencadenantes incorrectas o extras incluidos.
💡 Mantén ComfyUI actualizado e instala nodos personalizados solo desde fuentes de confianza. Un LoRA son datos, pero un paquete de nodos "obligatorio" que aparece sin más es código.
Entrenar el tuyo
Si no encuentras el look que buscas, entrénalo. Un conjunto de datos ordenado de 25 a 40 fotografías coherentes y bien iluminadas, etiquetadas con una sola palabra desencadenante, a menudo superará a un LoRA descargado entrenado con datos desordenados. Una opción alojada como Qwen Image LoRA Trainer Legacy elimina el requisito de hardware local, y después puedes usar pipelines de estilo Flux 2 Klein 9B Base LoRA o Flux 2 Klein 4B Base LoRA para obtener resultados impulsados por LoRA.
Cómo solucionar los problemas habituales
| Problema | Causa probable | Solución |
|---|
| El LoRA no tiene ningún efecto visible | Codificadores de texto conectados al checkpoint, no al nodo LoRA | Vuelve a conectar para que Load LoRA alimente el sampler y ambos codificadores |
| Imagen negra o con ruido | Modelo base no coincidente | Usa un LoRA creado para tu modelo base |
| Color quemado o sobresaturado | CFG o strength demasiado altos | Baja el CFG a 5 (SDXL) o el guidance a 3 (Flux), el strength a 0.7 |
| Piel de plástico | Guidance demasiado alto, etiquetas de calidad con nitidez excesiva | Baja el guidance, añade "poros visibles, textura natural de la piel" |
| El mismo rostro siempre | Strength por encima de 1.0 o un LoRA muy centrado en el rostro | Baja a 0.6 a 0.8, varía las seeds y los descriptores |
| Manos mal hechas | Resolución baja o pocos steps | Sube la resolución, añade una pasada de detalle o un inpaint de manos |
| Error de memoria insuficiente | Modelo grande con poca VRAM | Usa un modelo más pequeño o cuantizado, baja la resolución, cierra otras aplicaciones |
Escala al final, no al principio
Genera a una resolución normal, elige tu mejor fotograma y luego escálalo. Real ESRGAN ofrece un aumento limpio de 4x sin rehacer la composición, lo que conserva el detalle de piel y tela que ya te gusta.
¿Sin GPU? Ejecútalo en PicassoIA
ComfyUI es potente, pero un buen flujo de trabajo necesita una tarjeta gráfica decente, drivers, nodos y archivos de modelo que encajen entre sí. Si esa es la parte que no te gusta, sáltatela.
Cómo usar cualquier flujo de trabajo de ComfyUI en PicassoIA
Any ComfyUI Workflow toma un pipeline exportado desde ComfyUI y lo ejecuta en la nube, así que tu montaje funciona sin una GPU local.
- En ComfyUI, activa el modo desarrollador en los ajustes y usa Save (API format) para exportar tu flujo de trabajo como JSON.
- Abre la página del modelo y pega el JSON en el campo workflow_json, o indica una URL que lo contenga.
- Si tu flujo de trabajo necesita una imagen de referencia o un conjunto de archivos, súbelo en input_file.
- Elige un output_format: webp para archivos pequeños, png para calidad sin pérdida, jpg para compartir.
- Ajusta output_quality. El valor por defecto de 95 es un buen equilibrio.
- Deja randomise_seeds activado para obtener resultados nuevos en cada ejecución. Desactívalo cuando quieras repetir una seed.
- Si una ejecución se comporta de forma extraña, activa force_reset_cache para empezar de cero.
💡 Empieza con un flujo de trabajo de prueba pequeño. Un grafo de siete nodos es más fácil de depurar que uno de cuarenta.
Rutas más rápidas al mismo look
Si solo quieres la fotografía de glamour terminada y no necesitas un grafo de nodos, un modelo centrado en el prompt es más rápido. Para trabajo para adultos, no explícito, estos son los que conviene probar, en este orden:
- Seedream 4.5 es la primera parada. Es rápido, maneja la piel, la tela y la luz de forma convincente y entrega resultados nítidos y de alta resolución sin buscar ningún LoRA.
- PicassoIA Image Editor Pro ofrece generaciones ilimitadas, lo que lo hace ideal para iterar sobre prendas, poses y fondos, o para editar una foto que ya tienes.
- Z Image Turbo da imágenes nítidas en segundos cuando quieres probar ideas de prompt con rapidez.
- Nano Banana Pro es una buena opción para resultados en 4K y ediciones cuidadosas.
- Qwen Image 3 Pro entrega retratos fotorrealistas con luz natural.
¿ComfyUI local o en la nube?
| Factor | ComfyUI local + LoRA | Modelos de PicassoIA |
|---|
| Tiempo de configuración | Horas | Minutos |
| Hardware | GPU potente, mucha VRAM | Cualquier navegador |
| Control sobre los nodos | Total | Subida de flujo de trabajo o basado en prompts |
| Archivos LoRA personalizados | Cualquiera que descargues o entrenes | Basados en flujos de trabajo o modelos compatibles con LoRA |
| Costo de iteración | Electricidad y tiempo | Ilimitado con Image Editor Pro |
| Ideal para | Entusiastas que experimentan con pipelines | Resultados rápidos con mínimo esfuerzo |
Muchos creadores usan ambos: prototipan el look con prompts y, cuando saben exactamente lo que quieren, fijan un flujo de trabajo en ComfyUI.
Prueba hoy tu propio flujo de trabajo
Ya tienes las piezas: un flujo de trabajo de siete nodos, ajustes iniciales para tres familias de modelos, estructuras de prompt basadas en un lenguaje fotográfico real, una lista de seguridad para descargas y una opción en la nube para cuando tu GPU no da más de sí.
Elige una prenda, un lugar y una dirección de luz, escribe un solo prompt en el orden mostrado arriba y genera cuatro semillas. Cambia una sola variable por ejecución. Hacia el décimo lote sabrás qué strength de LoRA se ve mejor en tu modelo base.
Cuando quieras resultados sin la configuración, abre Seedream 4.5 o PicassoIA Image Editor Pro y ejecuta los mismos prompts. Si quieres probar otro modelo, el catálogo completo está en picassoia.com/en/all-models. Construye, prueba, compara y quédate con lo que funcione.


