A maioria das pessoas que pesquisam um LoRA NSFW para ComfyUI trava nos mesmos três pontos: o fluxo de trabalho não faz nada, os resultados ficam queimados ou elas não sabem qual arquivo é seguro para baixar. Este artigo resolve os três. Você recebe um fluxo de trabalho gratuito e minimalista que pode montar de novo em cinco minutos, configurações iniciais para Flux, Z-Image e SDXL, estruturas de prompt que produzem fotografia de glamour e estilo lingerie, e um checklist claro para encontrar arquivos de LoRA sem arriscar o seu PC.
Tudo aqui é voltado para trabalhos adultos, não explícitos e fotorrealistas: biquínis, lingerie, boudoir, praia e glamour editorial. Se você quer o mesmo visual sem instalar nada, há uma rota sem GPU perto do final.
O que um LoRA NSFW realmente faz
Um LoRA é um pequeno arquivo complementar, geralmente entre 20 MB e 400 MB, que empurra um modelo base em direção a um estilo, um vocabulário de poses, um aspecto de tecido ou um tipo de corpo. Ele não substitui o seu checkpoint. Ele fica por cima dele, e é por isso que o mesmo LoRA pode ficar ótimo em um modelo base e péssimo em outro.
LoRA ou checkpoint
| Item | Tamanho típico | O que controla | Custo de troca |
|---|
| Checkpoint (modelo base) | 2 a 24 GB | Realismo geral, anatomia, lógica de iluminação | Lento, download grande |
| LoRA | 20 a 400 MB | Estilo, detalhes de roupa, hábitos de pose, aparência da pele | Instantâneo, um nó |
| Embedding | Abaixo de 1 MB | Um único conceito por meio de um token | Instantâneo |
A conclusão prática: escolha primeiro o modelo base e só depois procure LoRAs treinados nele.
Combine com o modelo base
Este é o principal motivo de um LoRA "não fazer nada" ou produzir quadros pretos e com ruído. Um LoRA treinado para SDXL não funciona no Flux, e um LoRA do Flux não funciona no SDXL. Olhe o selo do modelo base na página de download antes de salvar qualquer coisa.
💡 Teste rápido: se a sua imagem parece chiado, um cinza desbotado ou uma bagunça derretida evidente com força 1.0, o modelo base e o LoRA quase certamente não combinam.
O fluxo de trabalho gratuito, passo a passo
Você não precisa de um monstro de 60 nós. Um fluxo limpo de LoRA tem sete nós, e cada um tem uma função.
Nós necessários
- Load Checkpoint (ou os nós separados Load Diffusion Model, Load CLIP e Load VAE para Flux e Z-Image).
- Load LoRA. Fica logo após o carregador do checkpoint e recebe as saídas de modelo e CLIP.
- CLIP Text Encode para o prompt positivo.
- CLIP Text Encode para o prompt negativo (pule ou deixe vazio no Flux).
- Empty Latent Image para a resolução.
- KSampler para seed, passos, CFG, sampler e scheduler.
- VAE Decode ligado a Save Image.
O único truque é a ordem das conexões. As saídas de modelo e CLIP do checkpoint vão primeiro para o nó Load LoRA. As saídas do Load LoRA alimentam então o KSampler e os dois codificadores de texto. Se você ligar os codificadores de texto direto no checkpoint, o LoRA é carregado mas nunca é usado, e essa é uma falha silenciosa bem comum.
Organização das pastas
Coloque os arquivos aqui e pressione R no ComfyUI para atualizar as listas:
ComfyUI/models/checkpoints para checkpoints no estilo SDXLComfyUI/models/diffusion_models para modelos no estilo Flux e Z-ImageComfyUI/models/loras para o próprio LoRAComfyUI/models/vae e ComfyUI/models/text_encoders para os extras
💡 Crie subpastas como loras/flux e loras/sdxl. Quando sua biblioteca chegar a 50 arquivos, você vai ficar feliz por ter feito isso.
Conexões em cinco minutos
Adicione o nó Load LoRA, escolha seu arquivo e defina strength_model e strength_clip com o mesmo valor, começando em 0.8. Adicione a palavra-gatilho, se o autor indicar uma, no início do seu prompt positivo. Gere um lote de quatro com seeds diferentes. Avalie o LoRA pelo lote, nunca por uma única imagem.
Para empilhar um segundo LoRA (por exemplo, um LoRA de textura de pele mais um LoRA de roupa), encadeie outro nó Load LoRA depois do primeiro e reduza os dois para algo em torno de 0.5 a 0.7.
Configurações que realmente funcionam
Estes são pontos de partida, não regras. Cada página de LoRA costuma listar seus próprios valores recomendados, e eles prevalecem sobre qualquer coisa nesta tabela.
| Ajuste | Modelos estilo Flux | Estilo Z-Image Turbo | Estilo SDXL |
|---|
| Força do LoRA | 0.7 a 1.0 | 0.6 a 0.9 | 0.6 a 0.9 |
| Passos | 20 a 28 | 8 a 10 | 25 a 35 |
| CFG / guidance | 2.5 a 4 | 1 | 5 a 7 |
| Sampler | euler | euler ou res_multistep | dpmpp_2m |
| Scheduler | simple ou beta | simple | karras |
| Resolução | 1024 x 1536 | 1024 x 1536 | 832 x 1216 |
| Prompt negativo | Não usado | Não usado | Sim, curto |
Ajustes para Flux e Z-Image
Modelos estilo Flux usam guidance, não o CFG clássico, então mantenha o valor baixo. Passar de 4.5 gera pele de plástico e sombras duras. Modelos turbo como Z Image Turbo são feitos para poucos passos, então mais passos não ajudam. Aumentá-los muitas vezes só acrescenta ruído.
Ajustes para SDXL
O SDXL depende de um prompt negativo bem feito e de um CFG de faixa média. Acima de 8 você obtém pele supersaturada e com aparência áspera. Se a imagem parecer queimada, reduza primeiro o CFG e depois a força.
Força e empilhamento
- Forte demais (acima de 1.0): mãos distorcidas, padrões repetidos, brilho de plástico, rostos que parecem todos iguais.
- Fraco demais (abaixo de 0.4): o LoRA quase não aparece e você desperdiça a palavra-gatilho.
- Ponto ideal: 0.65 a 0.9 para LoRAs isolados, 0.4 a 0.7 cada um ao empilhar dois ou três.
💡 Teste com um XY plot ou simplesmente rode a mesma seed com 0.5, 0.7, 0.9 e 1.1. Noventa segundos de teste economizam uma hora de adivinhação.
Prompts que mantêm o bom gosto
O visual que você quer é o de um ensaio de glamour de revista, não de um instantâneo anônimo. Isso significa descrever a fotografia, não apenas a pessoa. Câmera, lente, luz e tecido fazem a maior parte do trabalho.
Uma estrutura de prompt que funciona
Use esta ordem: palavra-gatilho, sujeito, roupa, pose, cenário, luz, câmera, textura.
Exemplo para um modelo estilo Flux ou Z-Image:
trigger_word, mulher adulta na casa dos vinte e poucos anos, biquíni vermelho de duas peças, em pé em um terraço de estuque branco, mão no cabelo, luz de contraluz dourada vinda da direita, 85mm f/1.8, profundidade de campo rasa, poros visíveis na pele, sardas leves, granulação fina de filme, cor Kodak Portra 400
Exemplo para SDXL:
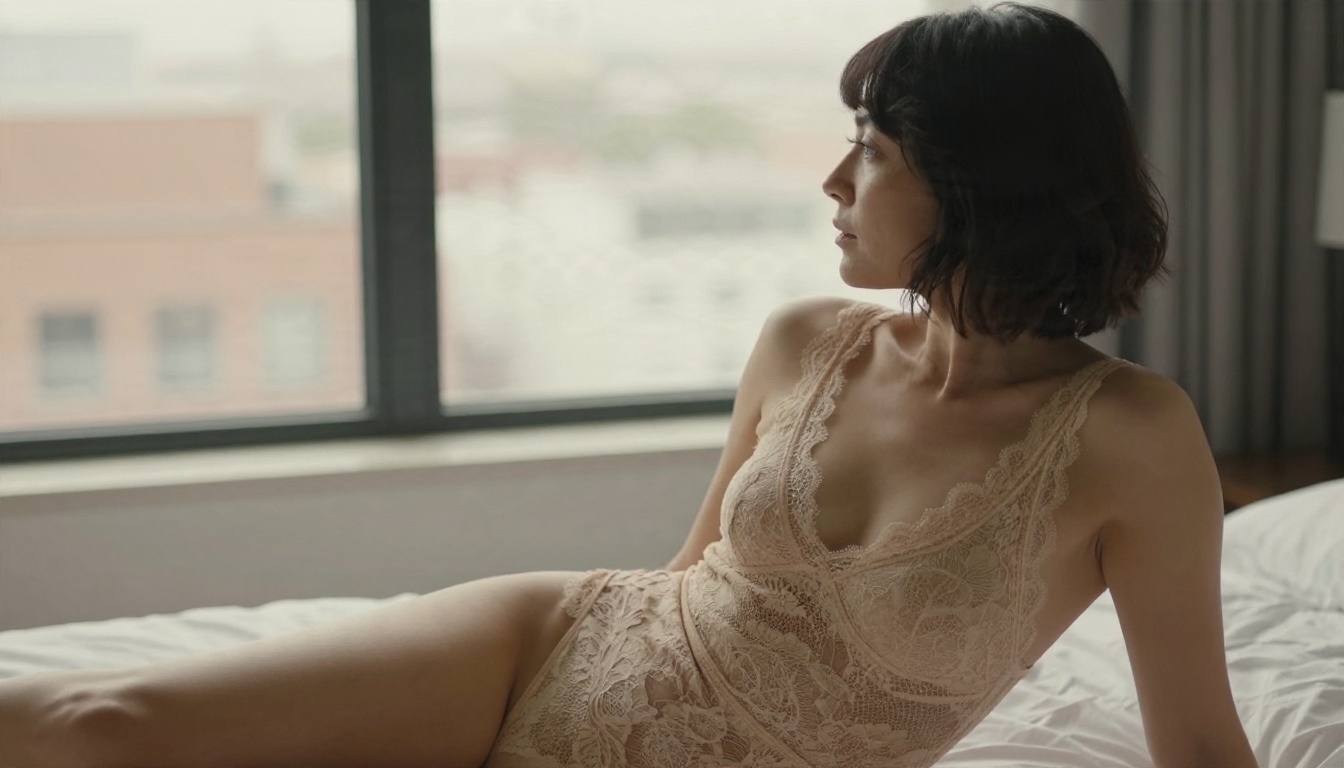
trigger_word, foto de uma mulher adulta, body de renda champanhe, sentada na beira de uma cama de hotel, luz difusa de janela com céu nublado, lente de 70mm, textura natural da pele, tons quentes e suaves, granulação de filme
Prompt negativo apenas para SDXL:
cartoon, ilustração, render 3d, pele de plástico, dedos extras, mãos deformadas, borrado, marca d'água, texto, baixa qualidade
Palavras que aumentam o realismo
- Luz: "luz suave de janela vinda da esquerda", "contraluz de hora dourada", "luz difusa de dia nublado", "lâmpada quente de tungstênio".
- Câmera: "85mm f/1.8", "35mm f/2", "fotografado na altura dos olhos", "ângulo baixo".
- Textura: "poros visíveis", "trama do tecido", "detalhe de renda", "brilho natural da pele", "fios de cabelo soltos".
- Aparência de filme: "Kodak Portra 400", "granulação fina", "transição suave das altas luzes".
Palavras que causam problemas
Evite empilhar tags genéricas de qualidade como "masterpiece, best quality, ultra detailed, 8k, hdr" em modelos estilo Flux atuais. Elas foram feitas para sistemas mais antigos e tendem a dar um aspecto falso e com nitidez exagerada. Uma linha concreta de câmera vale mais do que dez adjetivos vazios.
Mantenha os sujeitos adultos e inventados
Descreva sujeitos adultos e fictícios. Não use um LoRA criado a partir do rosto de uma pessoa real sem o consentimento dela e nunca crie nada que envolva menores de idade. Essa é uma linha tanto legal quanto de decência básica, e os serviços de hospedagem de LoRA confiáveis removem o conteúdo que a ultrapassa.
Três lugares respondem pela maior parte do que as pessoas usam.
| Fonte | Melhor para | Atenção a |
|---|
| Civitai | A maior biblioteca, imagens de exemplo com configurações incorporadas | Verifique o selo do modelo base, os filtros de conteúdo e a licença de cada arquivo |
| Hugging Face | Repositórios mais limpos, lançamentos oficiais e de pesquisa | Seleção NSFW menor, nomes de arquivo menos amigáveis |
| Treino próprio | Aparência exata, controle total | Exige de 20 a 60 imagens limpas e uma GPU ou um treinador na nuvem |
Checagem de segurança em cinco pontos
Antes de colocar um arquivo em models/loras, passe por esta lista:
- Formato: baixe apenas
.safetensors. Evite arquivos pickle .ckpt e .pt, que podem executar código ao serem carregados.
- Modelo base: combina com o seu checkpoint (Flux, SDXL, Z-Image e assim por diante).
- Imagens de exemplo: pelo menos algumas gerações que tenham o estilo que você quer, com as configurações mostradas.
- Licença: leia o que o autor permite, especialmente para uso comercial.
- Comentários: procure relatos de arquivos quebrados, palavras-gatilho erradas ou extras embutidos.
💡 Mantenha o ComfyUI atualizado e instale nós personalizados apenas de fontes em que você confia. Um LoRA é dado, mas um pacote de nós personalizados "obrigatório" é código.
Treinando o seu próprio
Se você não encontrar o visual que quer, treine o seu. Um conjunto de dados organizado, com 25 a 40 fotografias consistentes e bem iluminadas, legendadas com uma única palavra-gatilho, muitas vezes supera um LoRA baixado treinado com dados bagunçados. Uma opção hospedada como Qwen Image LoRA Trainer Legacy elimina a exigência de hardware local, e depois você pode usar pipelines no estilo Flux 2 Klein 9B Base LoRA ou Flux 2 Klein 4B Base LoRA para gerar resultados guiados por LoRA.
Resolvendo os problemas mais comuns
| Problema | Causa provável | Correção |
|---|
| O LoRA não tem efeito visível | Codificadores de texto ligados ao checkpoint, não ao nó LoRA | Refaça as conexões para que o Load LoRA alimente o sampler e os dois codificadores |
| Imagem preta ou com ruído | Modelo base incompatível | Use um LoRA feito para o seu modelo base |
| Cor queimada e supersaturada | CFG ou força alta demais | Reduza o CFG para 5 (SDXL) ou o guidance para 3 (Flux), a força para 0.7 |
| Pele de plástico | Guidance alto demais, tags de qualidade com nitidez exagerada | Reduza o guidance, acrescente "poros visíveis, textura natural da pele" |
| Mesmo rosto sempre | Força acima de 1.0 ou LoRA muito focado em rosto | Baixe para 0.6 a 0.8 e varie seeds e descritores |
| Mãos ruins | Resolução baixa ou poucos passos | Aumente a resolução, adicione uma passagem de detalhe ou um inpaint para as mãos |
| Erro de falta de memória | Modelo grande em pouca VRAM | Use um modelo menor ou quantizado, reduza a resolução, feche outros aplicativos |
Faça o upscaling por último, não primeiro
Gere em uma resolução normal, escolha seu melhor quadro e depois faça o upscaling. Real ESRGAN oferece um aumento limpo de 4x sem refazer a composição, o que preserva os detalhes de pele e tecido de que você já gosta.
Sem GPU? Rode no PicassoIA
O ComfyUI é poderoso, mas um bom fluxo de trabalho exige uma placa de vídeo decente, drivers, nós e arquivos de modelo que sejam compatíveis entre si. Se essa é a parte de que você não gosta, pule essa etapa.
Como usar qualquer fluxo de trabalho do ComfyUI no PicassoIA
Any ComfyUI Workflow pega um pipeline exportado do ComfyUI e o executa na nuvem, então a sua montagem funciona sem uma GPU local.
- No ComfyUI, ative o modo dev nas configurações e use Save (API format) para exportar seu fluxo de trabalho como JSON.
- Abra a página do modelo e cole o JSON no campo workflow_json, ou informe uma URL para ele.
- Se o seu fluxo precisar de uma imagem de referência ou de um conjunto de arquivos, envie-os em input_file.
- Escolha um output_format: webp para arquivos pequenos, png para sem perda, jpg para compartilhar.
- Defina a output_quality. O padrão de 95 é um bom equilíbrio.
- Deixe randomise_seeds ligado para obter resultados novos a cada execução. Desligue quando quiser repetir uma seed.
- Se uma execução se comportar de forma estranha, ative force_reset_cache para começar do zero.
💡 Mantenha seu fluxo de teste pequeno no começo. Um grafo de sete nós é mais fácil de depurar do que um de quarenta.
Caminhos mais rápidos para o mesmo visual
Se você só quer a fotografia de glamour pronta e não precisa de um grafo de nós, um modelo que trabalha a partir do prompt é mais rápido. Para trabalhos adultos e não explícitos, estes são os que vale testar, nesta ordem:
- Seedream 4.5 é a primeira parada. É rápido, lida bem com pele, tecido e luz, e entrega resultados nítidos em alta resolução sem precisar caçar LoRAs.
- PicassoIA Image Editor Pro oferece gerações ilimitadas, o que o torna ideal para iterar em roupas, poses e fundos, ou para editar uma foto que você já tem.
- Z Image Turbo entrega imagens nítidas em segundos quando você quer testar ideias de prompt rapidamente.
- Nano Banana Pro é uma boa escolha para resultados em 4K e edições cuidadosas.
- Qwen Image 3 Pro entrega retratos fotorrealistas com luz natural.
ComfyUI local ou nuvem?
| Fator | ComfyUI local + LoRA | Modelos do PicassoIA |
|---|
| Tempo de configuração | Horas | Minutos |
| Hardware | GPU potente, muita VRAM | Qualquer navegador |
| Controle sobre os nós | Total | Envio de fluxo de trabalho ou baseado em prompt |
| Arquivos LoRA personalizados | Qualquer um que você baixe ou treine | Modelos baseados em fluxo de trabalho ou com suporte a LoRA |
| Custo de iteração | Eletricidade e tempo | Ilimitado com o Image Editor Pro |
| Melhor para | Quem gosta de montar pipelines | Resultados rápidos com pouca complicação |
Muitos criadores usam os dois: prototipam o visual com prompts e depois fixam um fluxo de trabalho no ComfyUI quando já sabem exatamente o que querem.
Teste seu próprio fluxo de trabalho hoje
Agora você tem as peças: um fluxo de sete nós, configurações iniciais para três famílias de modelos, estruturas de prompt baseadas em linguagem real de fotografia, um checklist de segurança para downloads e uma opção em nuvem para quando sua GPU não dá conta.
Escolha uma roupa, um local e uma direção de luz, escreva um único prompt na ordem mostrada acima e renderize quatro seeds. Mude apenas uma variável por execução. Ao chegar ao décimo lote, você saberá qual força de LoRA fica melhor no seu modelo base.
Quando quiser resultados sem a configuração, abra Seedream 4.5 ou PicassoIA Image Editor Pro e rode os mesmos prompts. Se quiser testar outro modelo, o catálogo completo está em picassoia.com/en/all-models. Monte, teste, compare e guarde o que funciona.


