Patrones de prompt para modelos de video con IA que funcionan de verdad
Un desglose estructurado de los patrones de prompt que de verdad producen resultados de video con IA constantes. Desde la fórmula básica de sujeto, acción y entorno hasta ajustes específicos para Wan 2.7, Kling v3, Veo 3.1, Sora 2 y Seedance 2.0, con chuletas, plantillas de prompt negativo y soluciones a los fallos más comunes.
La diferencia entre un prompt de video que funciona y uno que falla casi nunca está en el vocabulario. Está en la estructura. Los modelos de video con IA no leen los prompts como lo hacen las personas. Analizan las relaciones espaciales, las pistas temporales y los vectores de movimiento a partir de la secuencia de palabras que les das. Si los escribes mal, obtienes sujetos que parpadean, deriva de cámara y escenas que se disuelven en ruido a mitad del clip. Si los escribes bien, obtienes metraje que se sostiene como algo rodado con una cámara real.
Este artículo desglosa los patrones de prompt concretos que producen resultados constantes y de alta calidad en los principales modelos de video con IA disponibles hoy: desde Wan 2.7 T2V hasta Kling v3 Video, y de Veo 3.1 a Seedance 2.0.
Por qué la mayoría de los prompts fallan desde el principio
Los 3 patrones que fallan siempre
1. El volcado de sustantivos. "Montaña, atardecer, mujer, caminando, cinematográfico." Esto le dice al modelo cinco cosas, pero no le da ninguna relación entre ellas. ¿La mujer camina hacia la montaña? ¿Se aleja de ella? El modelo adivina, y adivina de forma distinta en cada fotograma.
2. La acumulación de adjetivos. "Hermoso, impresionante, espectacular, sobrecogedor, atardecer mágico." Acumular sinónimos no amplifica el efecto. Lo diluye. El modelo promedia estos descriptores y produce un resultado mediocre que no se inclina por ninguno de ellos.
3. La escena pasiva. "Un bosque. Hay un río. Hay pájaros." Sin dirección de movimiento, sin acción del sujeto y sin lógica temporal. Los modelos de video necesitan saber qué está pasando a lo largo del tiempo, no solo qué existe en el encuadre.
Lo que el modelo analiza realmente
Los modelos modernos de generación de video procesan los prompts en capas. Primero extraen el sujeto principal y le asignan prioridad de movimiento. Después leen el contexto ambiental para construir el plano de fondo. Por último, interpretan los modificadores temporales, como "lentamente", "de repente" o "la cámara se aleja", para coreografiar el movimiento a lo largo de la duración del clip.
Si tu sujeto queda enterrado en medio de una larga lista de adjetivos, o si las pistas de movimiento aparecen antes de que el entorno esté establecido, el modelo pierde coherencia. Las tres a cinco primeras palabras son las que más peso tienen.
💡 Regla general: sujeto primero, acción segunda, entorno tercero, modificadores al final. Desviarte de esto corre por tu cuenta.
La fórmula básica del prompt
La fórmula que supera de forma constante a todas las demás en los modelos de video es:
[Sujeto + Acción] + [Entorno/Fondo] + [Instrucciones de cámara] + [Iluminación/Atmósfera] + [Modificadores de estilo]
Sujeto, acción y entorno
Cada palabra aquí tiene peso. Compara estos dos prompts:
Débil: "Una mujer con un vestido blanco en la naturaleza"
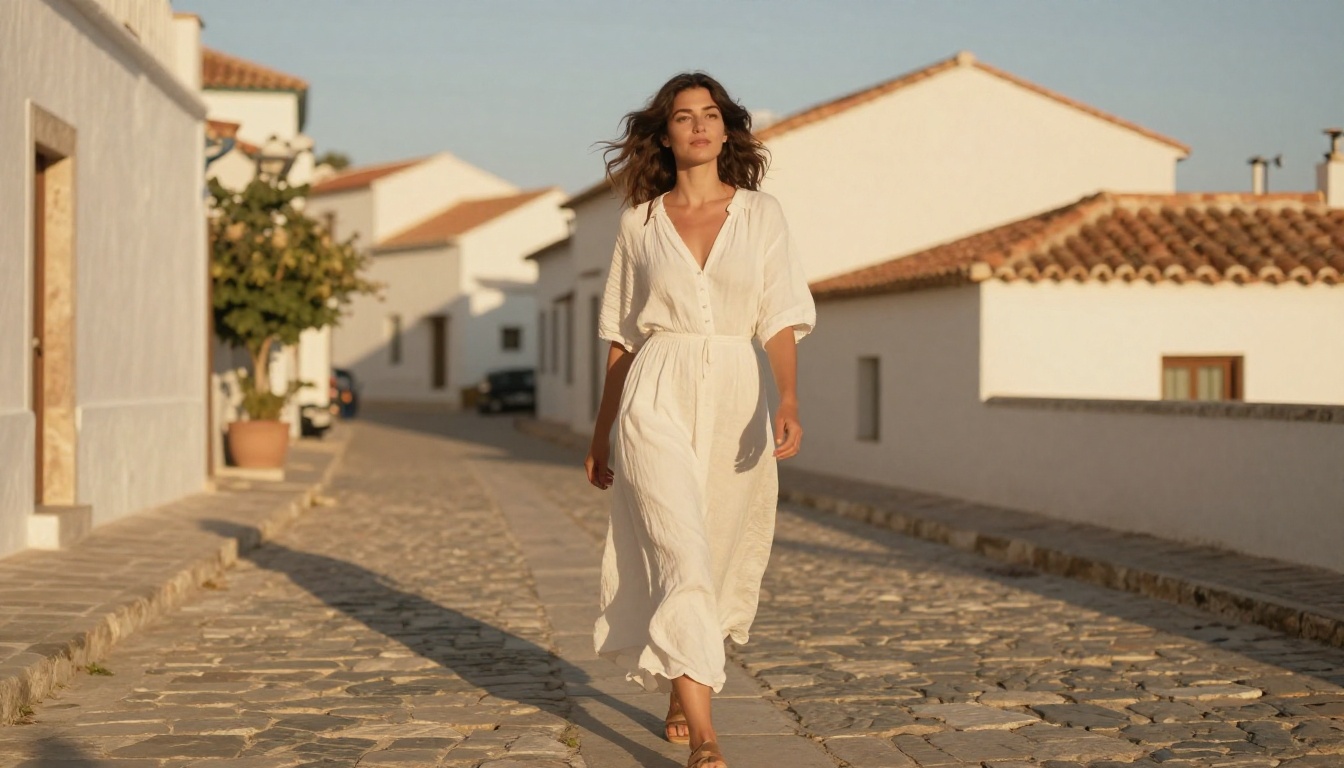
Fuerte: "Una mujer con un vestido de lino blanco y vuelo camina descalza por un prado de flores silvestres bañado por el sol"
La segunda versión le da al modelo un sujeto, un atributo físico, un verbo de acción específico y un entorno definido. Ahora el modelo puede anclar al sujeto de forma coherente a lo largo de los fotogramas.
Cuando tu sujeto es una persona, incluye: textura de la ropa, complexión aproximada y un verbo de acción concreto. No "de pie ahí", sino "se gira despacio para mirar a la cámara". No "sentada", sino "se inclina hacia delante sobre una mesa de madera".
Para sujetos no humanos, como paisajes, productos u objetos, ancla su posición concreta en el encuadre: "una cafetera espresso negra en primer plano" o "un coche antiguo estacionado en diagonal en una calle de ciudad mojada por la lluvia".
Movimiento y dirección de cámara
Aquí es donde la mayoría de los prompts desperdician rendimiento. El movimiento de cámara y el movimiento del sujeto son dos cosas distintas, y tratarlos igual arruina ambos.
El movimiento del sujeto describe lo que hace tu elemento principal: "camina despacio", "gira la cabeza", "las olas rompen y se retiran".
El movimiento de cámara describe lo que hace la cámara virtual: "avance lento con dolly", "plano de seguimiento en contrapicado", "retroceso con grúa aérea", "ligero temblor de cámara en mano".
Indícalos por separado, y pon el movimiento de cámara al final para que el modelo lo use como envoltorio coreográfico:
"Una mujer con un vestido rojo se gira despacio hacia la cámara en un patio soleado. Avance lento con dolly desde la altura de la cintura. Lente de 35 mm."
Capa de atmósfera e iluminación
La iluminación es la variable más importante entre un resultado plano y algo que parece cinematográfico. Especifica:
Dirección: "luz de la mañana desde la izquierda", "contraluz del sol poniente", "sombra moteada desde arriba"
Calidad: "luz suave y difusa", "contraste duro de mediodía", "brillo cálido de hora dorada"
Temperatura de color: "tonos ámbar cálidos", "nublado azul grisáceo y frío"
No te limites a decir "iluminación cinematográfica". Esa frase se ha usado tanto que casi no significa nada para la mayoría de los modelos. Describe la luz como lo haría un director de fotografía: de dónde viene y qué hace con el rostro o la superficie del sujeto.
💡 Consejo avanzado: añadir una referencia concreta de película, como "perfil de color Kodak Portra 400" o "rodado en 16 mm", le indica al modelo que quieres textura orgánica, grano natural y luces algo desaturadas. Rinde mucho más de lo que aparenta en la calidad del resultado.
Patrones de prompt según el tipo de escena
Cada categoría de escena necesita un énfasis estructural distinto. Así se ponderan tus prompts.
Escenas narrativas y cinematográficas
En los clips narrativos, la lógica temporal es fundamental. El modelo necesita saber qué pasa primero, qué pasa después y cómo responde la cámara.
Usa palabras de movimiento conectivas: "luego", "mientras", "cuando". Crean relaciones de causa y efecto a lo largo de los fotogramas.
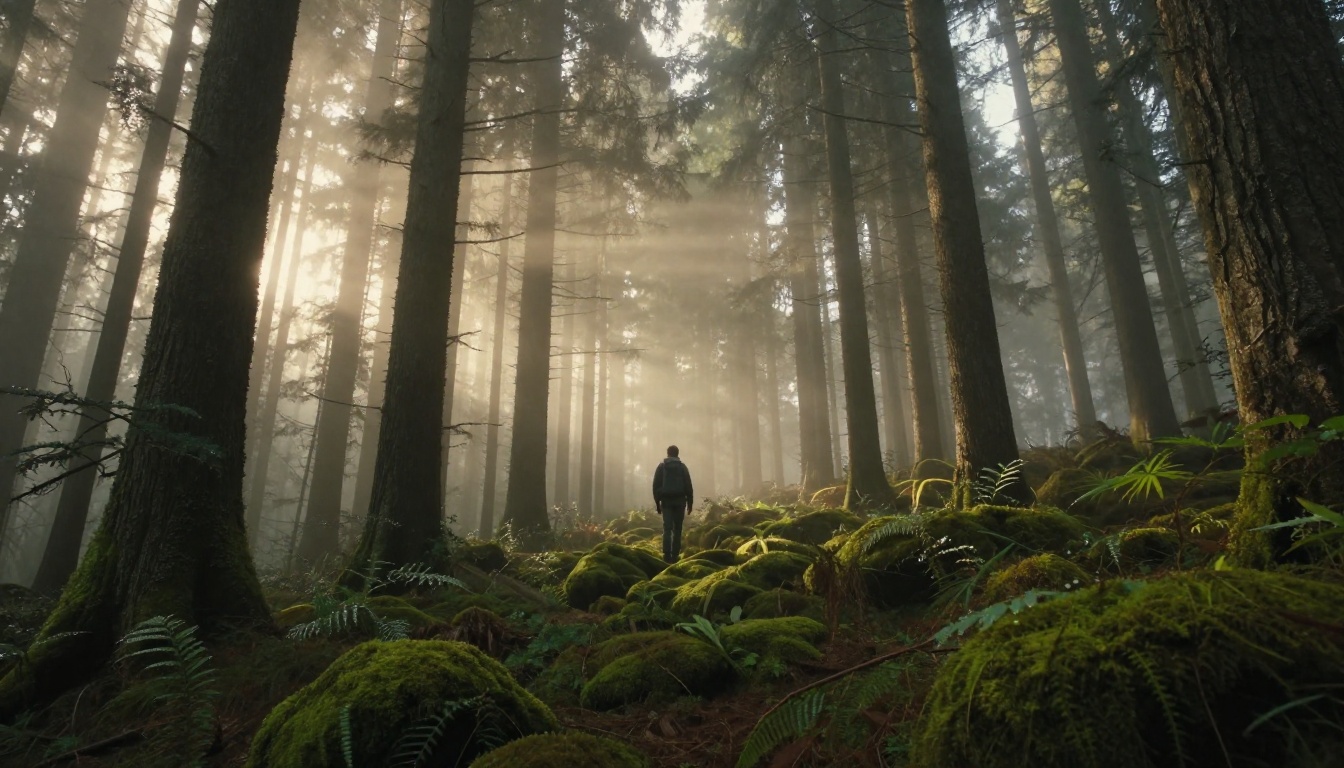
"Una excursionista solitaria corona una cresta al amanecer y se detiene a mirar el valle. La cámara se aleja lentamente con un plano de grúa amplio, revelando la escala de las montañas que la rodean. Luz dorada y cálida desde la derecha."
Para lograr un efecto dramático, Kling v3 Video y Veo 3.1 son los que mejor manejan la lógica temporal. Ambos interpretan de forma fiable las palabras de movimiento conectivas y mantienen la coherencia del sujeto durante el movimiento de cámara.
Metraje de producto y estilo de vida
Las tomas de producto necesitan precisión espacial. Dile al modelo exactamente dónde está el producto en el encuadre, qué lo rodea y cómo interactúa la luz con la superficie del producto.
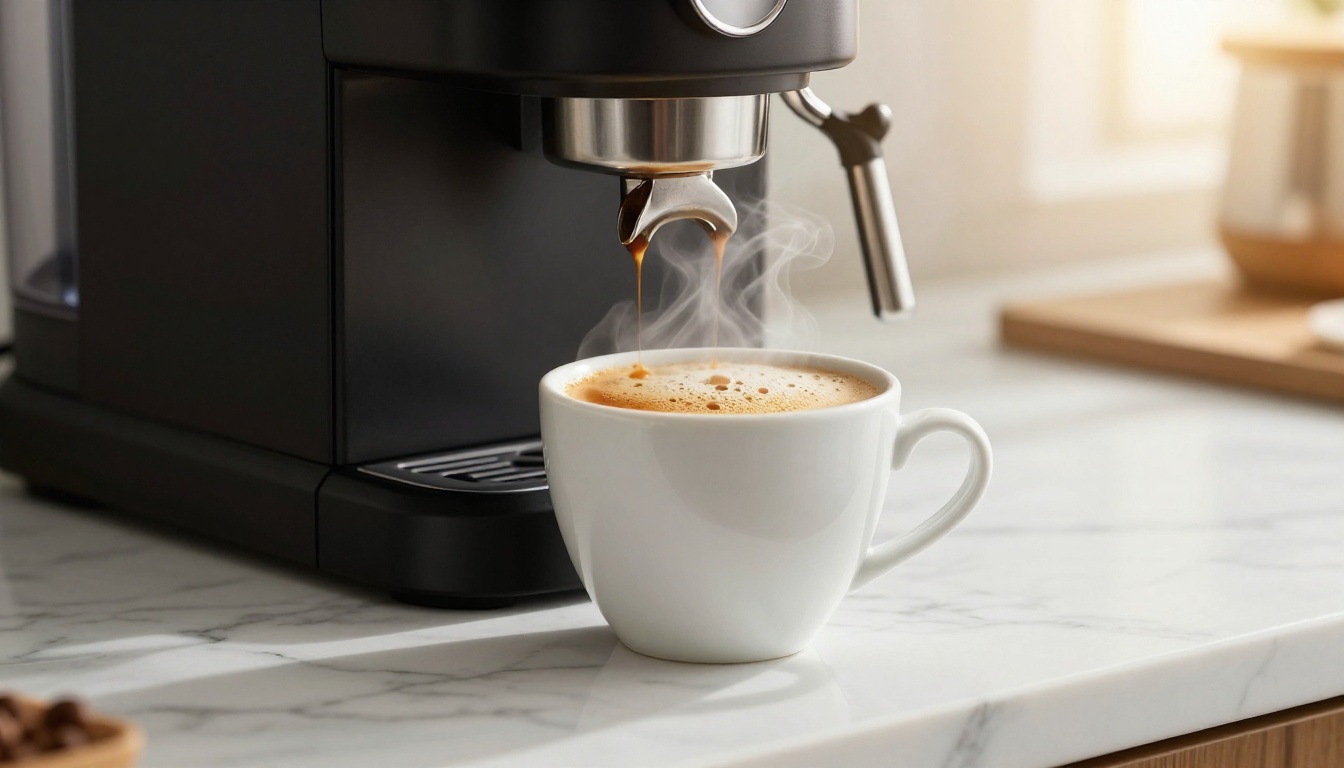
"Una cafetera espresso negra y elegante, en primer plano nítido, sobre una encimera de mármol blanco, con vapor que sube desde la boquilla. Fondo de cocina cálido y desenfocado con luz matutina de ventana. Cambio de enfoque lento desde la cafetera hasta el vapor. Objetivo macro de 100 mm."
Para trabajos de producto, LTX 2 Pro y LTX 2.3 Pro destacan por mantener un detalle nítido del objeto y una separación limpia del fondo en salidas 4K.
Retrato y movimiento de personajes
Los retratos dependen por completo de lo bien que el modelo mantenga la coherencia facial a lo largo de los fotogramas. La deformación del sujeto es el fallo más común aquí. Contrarréstalo:
Añadiendo una expresión neutra de base: "expresión neutra, sonrisa natural y leve"
Especificando la dirección de la cabeza y de los ojos: "mirando directamente a la cámara, ligera inclinación hacia abajo"
Manteniendo el movimiento mínimo y lento: "movimiento sutil del pelo con la brisa, giro lento de cabeza"
"Una joven segura de sí misma, con el pelo corto y oscuro, mira directamente a la cámara con una sonrisa natural y leve, de pie en una azotea urbana al anochecer. La luz de contorno del sol poniente a su espalda crea un halo cálido. Objetivo de retrato de 85 mm f/1.4. Acercamiento lento, el sujeto llena el encuadre al final del clip."
Cómo usar Wan 2.7 T2V en PicassoIA
Wan 2.7 T2V es uno de los modelos de texto a video más capaces disponibles para producir clips en 1080p con una fuerte coherencia temporal. Así puedes obtener los mejores resultados en PicassoIA.
Paso 2: en el campo del prompt, estructura tu entrada con la fórmula de arriba. Wan 2.7 responde especialmente bien a las pistas de movimiento de cámara colocadas al final del prompt, una vez que el sujeto y el entorno ya están bien establecidos.
Paso 3: configura la resolución en 1080p. Wan 2.7 mantiene la nitidez mucho mejor en resoluciones de salida más altas, y la diferencia con 720p se nota.
Paso 4: en clips que requieran continuidad de movimiento (como una persona caminando por una escena), usa el campo de prompt negativo para excluir: blurry, flickering, morphing, distorted, low quality, static, duplicate subject.
Paso 5: lanza tu primera generación. Si el sujeto se desvía en los primeros 2 segundos, tu descripción del entorno es demasiado escasa. Añade más anclajes espaciales al fondo antes de volver a generar.
Paso 6: para flujos de trabajo de imagen a video sobre la misma escena, cambia a Wan 2.7 I2V, que te permite animar una imagen fija generada con un prompt de continuación, fijando la apariencia del sujeto desde el primer fotograma.
Consejos de parámetros para Wan 2.7
Parámetro
Valor recomendado
Notas
Steps
30-40
Más steps = más detalle, generación más lenta
CFG Scale
7-9
Mantente por debajo de 10 para evitar el exceso de nitidez
Motion Strength
0.6-0.8
Por encima de 0.9 provoca inestabilidad del sujeto
Clip Length
5-8 segundos
Punto ideal para la coherencia
Negative Prompt
Ver la sección siguiente
Incluir siempre
💡 Wan 2.7 T2V maneja mejor que la mayoría las escenas con multitudes y los entornos complejos. Si tu escena tiene varios elementos, es una mejor primera opción que modelos centrados en un solo sujeto, como Motion 2.0.
Ajustes del prompt específicos por modelo
Cada modelo tiene sesgos integrados a partir de sus datos de entrenamiento. Conocerlos hace que tus prompts den en el blanco en lugar de adivinar.
Kling v3 y Kling v2.6
Kling v3 Video y Kling v2.6 son potencias cinematográficas que responden con fuerza a la terminología de cine y de dirección de fotografía.
Lo que funciona: las especificaciones de lente (35mm prime, anamorphic), las referencias de cine (shot on 35mm film) y los movimientos de cámara explícitos (Steadicam tracking shot, dolly zoom).
Lo que no funciona: las palabras de ambiente abstractas sin anclaje espacial. "Atmósfera mística" produce resultados irregulares. "Niebla suave que se extiende por el suelo del bosque al amanecer" no.
Kling v2.6 también admite entradas de control de movimiento, lo que te permite trazar trayectorias de cámara directamente. Combínalo con un prompt de texto sólido y podrás replicar con precisión movimientos de dolly o de panorámica. Para la máxima calidad de salida de la familia Kling, Kling v2.1 Master produce resultados impresionantes en 1080p cuando se le dan prompts cinematográficos detallados.
Veo 3.1 y Sora 2
Veo 3.1 y Sora 2 se basan en modelos fundacionales entrenados con corpus de video masivos. Manejan la física del mundo real mejor que la mayoría.
Para estos modelos, apóyate en descriptores de realismo físico: "tensión superficial del agua", "tela que cae de forma natural por la gravedad", "sombra que se desplaza por la pared cuando el sujeto pasa junto a la ventana".
Sora 2 responde especialmente bien a prompts escritos como tratamientos de cine: frases completas, lenguaje natural, estructura de causa y efecto. Es menos sensible al orden de los tokens que otros modelos. Sora 2 Pro amplía esto con una duración de clip mayor y una mejor retención de detalle.
Veo 3.1 Fast es la variante más rápida: ideal para iterar cuando pruebas estructuras de prompt antes de lanzar una generación a calidad completa.
Seedance 2.0 y Pixverse v6
Seedance 2.0 y Pixverse v6 generan ambos con audio nativo, lo que cambia la forma de escribir los prompts. Incluye descriptores de sonido ambiente aunque te centres en lo visual: guían la capa de audio del modelo y crean un resultado más cohesionado.
"Las olas rompen contra rocas de basalto al atardecer, con bruma en el aire. El sonido del agua revuelta y del viento. Cámara lenta, lente de 70 mm."
Pixverse v6 maneja con excelente resultado el movimiento rápido (secuencias de acción, deporte, fenómenos naturales). Seedance 2.0 es más sólido en metraje lento y emotivo con presencia de personajes. Para generar más rápido con el mismo motor, Seedance 2.0 Fast mantiene la mayor parte de la calidad con una fracción del tiempo de generación.
LTX 2 Pro y LTX 2.3 Pro
LTX 2 Pro y LTX 2.3 Pro son generadores con resolución nativa 4K. A esta resolución, el detalle de textura en tu prompt rinde frutos. Describe los materiales de superficie de forma explícita: "veta de roble envejecida", "cuero cosido a mano", "aluminio cepillado".
Estos modelos también responden bien a los prompts de transición de iluminación: "luz de la mañana que pasa a la tarde, sombras que se alargan". Pueden representar cambios sutiles de luz a lo largo del tiempo que la mayoría de los modelos aplanan en una exposición estática.
Prompts negativos que solucionan el 80 % de los problemas
Los prompts negativos no son un añadido de última hora. En la generación de video son estructurales.
Exclusiones por defecto
Este prompt negativo base funciona en la mayoría de los modelos:
blurry, out of focus, flickering, morphing, distorted face, duplicate subject,
deformed limbs, low quality, pixelated, watermark, text overlay, jumpcut,
static background, color banding, overexposed, underexposed
Aplícalo a cada generación antes de ajustar cualquier otra cosa.
Negativos según el estilo
Para metraje cinematográfico:
cartoon, illustration, anime, CGI, unrealistic, neon, oversaturated, digital art
Para clips de retrato y personajes:
two faces, extra limbs, asymmetrical features, unnatural skin texture, plastic look,
over-retouched skin
💡 Nota específica del modelo: Gen 4.5 de Runway responde especialmente bien a los prompts negativos. Su campo de prompt negativo tiene un efecto más fuerte sobre el estilo del resultado que la mayoría de la competencia, así que dedica tiempo a esto antes de ajustar tu prompt positivo.
Tablas chuleta de prompts
Vocabulario de movimiento de cámara
Efecto que quieres
Palabras que funcionan
Avance lento hacia el sujeto
"avance lento con dolly", "zoom in gradual"
Retroceso para revelar escala
"retroceso con grúa", "dolly inverso", "zoom out a gran angular"
Seguir a un sujeto en movimiento
"plano de seguimiento", "seguimiento tipo Steadicam", "panorámica a la izquierda"
Cámara bloqueada, sin movimiento
"plano estático", "trípode bloqueado", "sin movimiento de cámara"
Energía de cámara en mano
"ligero temblor de cámara en mano", "ligero balanceo de cámara"
Perspectiva aérea
"metraje de dron", "vista cenital", "plano general aéreo desde arriba"
Escala de intensidad de movimiento
Intensidad
Palabras a usar
Apenas se mueve
"movimiento imperceptible", "el pelo apenas se mueve en quietud"
"camina por", "brisa moderada", "gira de forma constante"
Activo
"paso ligero", "corriendo", "olas rompiendo"
Dinámico
"a toda velocidad", "explosivo", "panorámica rápida de latigazo"
Qué hacer cuando el resultado falla
Fotogramas borrosos o irregulares
Esto suele significar que tu entorno está poco descrito. El modelo tiene demasiados grados de libertad en el fondo y lo rellena de forma distinta en cada fotograma. Solución: añade 2 o 3 elementos concretos de fondo con posición: "muro de piedra desgastado a la izquierda", "una hilera de cipreses en el plano medio a la derecha".
Revisa también tu ajuste de motion strength. Si está por encima de 0.85, bájalo. Los valores altos de motion strength agravan la inconsistencia del fondo en todos los modelos.
El sujeto se deforma a mitad del clip
Esto ocurre cuando la descripción del sujeto es ambigua, la pista de movimiento es demasiado agresiva o ambas cosas. Tres soluciones:
Añade un anclaje de pose: "de pie con el peso en el pie izquierdo y la mano derecha apoyada en la cadera" le da al modelo un estado físico inicial al que volver entre fotogramas.
Reduce la duración del clip: un clip de 3 segundos tiene una coherencia del sujeto notablemente mejor que uno de 9 segundos para sujetos complejos.
Usa imagen a video: genera primero una imagen fija de tu sujeto y luego anímala con Wan 2.7 I2V o Kling v2.6. Así se fija la apariencia del sujeto en el fotograma cero y el problema de coherencia desaparece por completo.
Movimiento antinatural
El movimiento antinatural suele venir de verbos de movimiento vagos. "Moverse" o "ir" no le dan nada al modelo con lo que trabajar. Sustitúyelos por acciones físicas concretas que incluyan contexto de velocidad:
En lugar de "se mueve hacia la cámara", usa "camina a un ritmo lento y deliberado hacia la cámara, con las pisadas visibles en el suelo"
En lugar de "el río fluye", usa "la corriente del río avanza de forma constante de derecha a izquierda, captando la luz de la tarde en la superficie"
Pon estos patrones en práctica
Los patrones de este artículo no harán que cada generación sea perfecta, pero sí reducirán de forma notable los resultados fallidos. La verdadera habilidad está en iterar: lanza un prompt, identifica qué elemento falla (sujeto, movimiento, entorno, cámara), corrige solo esa variable y vuelve a lanzarlo.
PicassoIA te da acceso a todos los modelos de video principales que se tratan aquí en un solo lugar. Wan 2.7 T2V, Kling v3 Video, Veo 3.1, Seedance 2.0, Sora 2 y LTX 2.3 Pro están todos disponibles sin cambiar de pestaña ni gestionar claves de API.
Elige un patrón de prompt de este artículo, aplícalo a la escena que te está dando problemas y pruébalo con dos o tres modelos para comparar cómo interpreta cada uno la misma entrada. Solo esa comparación te enseñará más sobre ingeniería de prompts de video que cualquier hoja de referencia.