Patterns de prompts pour modèles vidéo IA qui fonctionnent vraiment
Une analyse structurée des patterns de prompts qui produisent réellement des résultats vidéo IA cohérents. De la formule de base sujet-action-environnement aux ajustements propres à Wan 2.7, Kling v3, Veo 3.1, Sora 2 et Seedance 2.0, avec aide-mémoire, modèles de prompts négatifs et solutions aux échecs les plus courants.
La différence entre un prompt vidéo qui fonctionne et un prompt qui échoue tient rarement au vocabulaire. Elle tient à la structure. Les modèles vidéo IA ne lisent pas les prompts comme des humains. Ils analysent les relations spatiales, les indications temporelles et les vecteurs de mouvement à partir de la séquence de mots que vous leur donnez. Si vous les écrivez mal, vous obtenez des sujets qui scintillent, une caméra qui dérive et des scènes qui se dissolvent dans le bruit à mi-parcours. Si vous les écrivez bien, vous obtenez des séquences cohérentes d’un bout à l’autre, comme si elles avaient été tournées avec une vraie caméra.
Cet article détaille les patterns de prompts précis qui produisent des résultats cohérents et de haute qualité sur les principaux modèles vidéo IA disponibles aujourd’hui : de Wan 2.7 T2V à Kling v3 Video, en passant par Veo 3.1 et Seedance 2.0.
Pourquoi la plupart des prompts échouent dès le départ
Les 3 patterns qui échouent à coup sûr
1. L’amas de noms. « Montagne, coucher de soleil, femme, marche, cinématographique. » Cela indique au modèle cinq éléments, mais ne lui donne aucun lien entre eux. La femme marche-t-elle vers la montagne ? En s’en éloignant ? Le modèle devine, et il devine différemment à chaque image.
2. L’empilement d’adjectifs. « Magnifique, somptueux, superbe, à couper le souffle, coucher de soleil magique. » Empiler des synonymes n’amplifie pas l’effet, il le dilue. Le modèle fait la moyenne de ces descripteurs et produit un résultat médiocre qui ne penche vers aucun d’eux.
3. La scène passive. « Une forêt. Il y a une rivière. Des oiseaux sont présents. » Aucune direction de mouvement, aucune action du sujet, aucune logique temporelle. Les modèles vidéo ont besoin de savoir ce qui se passe au fil du temps, pas seulement ce qui existe dans le cadre.
Ce que le modèle analyse réellement
Les modèles de génération vidéo modernes traitent les prompts en couches. Ils extraient d’abord le sujet principal et lui attribuent une priorité de mouvement. Ils lisent ensuite le contexte environnemental pour construire le plan d’arrière-plan. Enfin, ils interprètent les modificateurs temporels comme « lentement », « soudain » ou « la caméra recule » pour chorégraphier le mouvement sur la durée du clip.
Si votre sujet est enfoui au milieu d’une longue liste d’adjectifs, ou si vos indications de mouvement arrivent avant que l’environnement ne soit posé, le modèle perd en cohérence. Les trois à cinq premiers mots portent le plus de poids.
💡 Règle empirique : sujet en premier, action en deuxième, environnement en troisième, modificateurs en dernier. Vous vous en écartez à vos risques et périls.
La formule de prompt de base
La formule qui surpasse systématiquement toutes les autres sur les modèles vidéo est la suivante :
[Sujet + Action] + [Environnement/Arrière-plan] + [Instructions de caméra] + [Éclairage/Atmosphère] + [Modificateurs de style]
Sujet, action, environnement
Chaque mot compte ici. Comparez ces deux prompts :
Faible : « Une femme en robe blanche dans la nature »
Fort : « Une femme en robe de lin blanc fluide marche pieds nus dans une prairie de fleurs sauvages baignée de soleil »
La seconde version donne au modèle un sujet, un attribut physique, un verbe d’action précis et un environnement défini. Le modèle peut désormais ancrer le sujet de manière cohérente d’une image à l’autre.
Lorsque votre sujet est une personne, indiquez : la texture du vêtement, la corpulence approximative et un verbe d’action précis. Pas « debout là », mais « se tourne lentement pour faire face à la caméra ». Pas « assise », mais « se penche en avant au-dessus d’une table en bois ».
Pour les sujets non humains, comme les paysages, les produits ou les objets, ancrez-les par une position précise dans le cadre : « une machine à expresso noire au premier plan » ou « une voiture ancienne garée en diagonale sur une rue urbaine humide ».
Mouvement et direction de caméra
C’est là que la plupart des prompts passent à côté d’une bonne part de leur efficacité. Le mouvement de caméra et le mouvement du sujet sont deux choses distinctes, et les traiter de la même façon nuit aux deux.
Le mouvement du sujet décrit ce que fait l’élément principal : « marche lentement », « tourne la tête », « les vagues s’écrasent puis se retirent ».
Le mouvement de caméra décrit ce que fait la caméra virtuelle : « lent travelling avant », « plan suiveur en contre-plongée », « mouvement de grue arrière en plongée », « léger tremblement à l’épaule ».
Énoncez-les séparément, et placez le mouvement de caméra en dernier pour que le modèle puisse l’utiliser comme enveloppe chorégraphique :
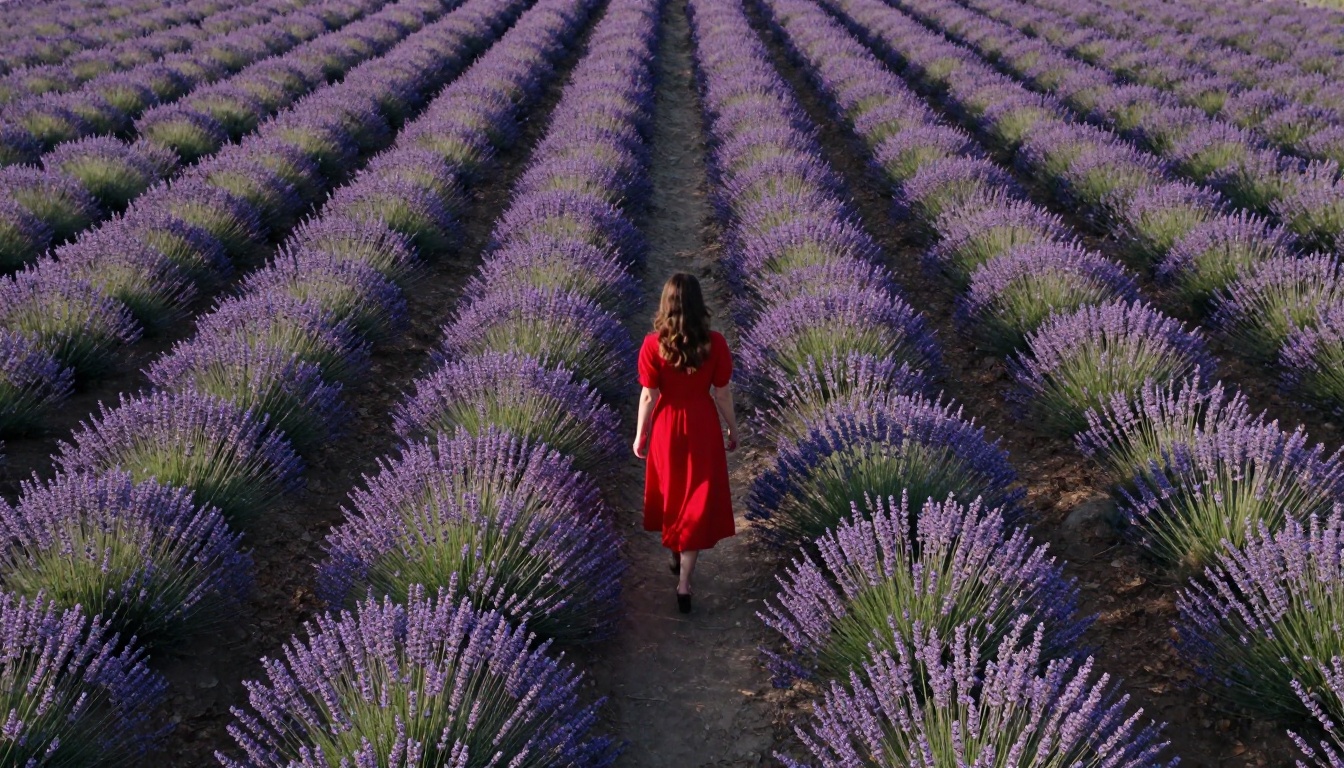
« Une femme en robe rouge se tourne lentement vers la caméra dans une cour ensoleillée. Lent travelling avant à hauteur de taille. Objectif 35 mm. »
Couche d’atmosphère et d’éclairage
L’éclairage est la variable la plus déterminante entre un rendu plat et un résultat qui paraît cinématographique. Précisez :
Direction : « lumière du matin venant de la gauche », « contre-jour du soleil couchant », « ombre tachetée venant du dessus »
Qualité : « lumière douce et diffuse », « contraste dur de midi », « chaleur dorée de l’heure dorée »
Ne vous contentez pas de « éclairage cinématographique ». Cette expression a été tellement utilisée qu’elle ne veut presque plus rien dire pour la plupart des modèles. Décrivez la lumière comme le ferait un directeur de la photographie : d’où elle vient, et ce qu’elle fait au visage ou à la surface du sujet.
💡 Astuce pro : ajouter une référence de pellicule précise, comme « profil colorimétrique Kodak Portra 400 » ou « tourné en 16 mm », signale au modèle que vous voulez une texture organique, un grain naturel et des hautes lumières légèrement désaturées. Cela dépasse largement les attentes en matière de qualité de rendu.
Patterns de prompts selon le type de scène
Les différentes catégories de scènes demandent des accents structurels différents. Voici comment pondérer vos prompts.
Scènes narratives et cinématographiques
Pour les clips qui racontent une histoire, la logique temporelle est primordiale. Le modèle doit savoir ce qui se passe d’abord, ce qui vient ensuite et comment la caméra réagit.
Utilisez des mots de liaison pour le mouvement : « puis », « tandis que », « pendant que ». Ils créent des relations de cause à effet d’une image à l’autre.
« Un randonneur solitaire atteint une crête au lever du soleil et s’arrête pour regarder la vallée en contrebas. La caméra recule lentement en plan de grue large, révélant l’immensité des montagnes qui l’entourent. Lumière dorée et chaude venant de la droite. »
Pour un effet dramatique, Kling v3 Video et Veo 3.1 gèrent le mieux la logique temporelle. Tous deux interprètent fiablement les mots de liaison du mouvement et maintiennent la cohérence du sujet pendant les mouvements de caméra.
Produits et séquences de style de vie
Les plans produits demandent une précision spatiale. Indiquez au modèle exactement où se trouve le produit dans le cadre, ce qui l’entoure et comment la lumière interagit avec la surface du produit.
« Une machine à expresso noire et élégante au premier plan net sur un plan de travail en marbre blanc, de la vapeur s’élevant du bec. Arrière-plan de cuisine chaleureux et flouté avec la lumière matinale de la fenêtre. Lent transfert de mise au point de la machine vers la vapeur qui monte. Objectif macro 100 mm. »
Pour le travail produit, LTX 2 Pro et LTX 2.3 Pro excellent à conserver les détails nets des objets et une séparation propre avec l’arrière-plan en sortie 4K.
Portrait et mouvement de personnage
Les portraits dépendent entièrement de la capacité du modèle à gérer la cohérence faciale d’une image à l’autre. La déformation du sujet est le mode d’échec le plus fréquent ici. Pour le contrer :
Ajoutez une base d’expression neutre : « expression neutre, léger sourire naturel »
Précisez la direction de la tête et du regard : « regarde directement la caméra, léger mouvement de tête vers le bas »
Gardez le mouvement minimal et lent : « légers mouvements de cheveux dans la brise, lente rotation de la tête »
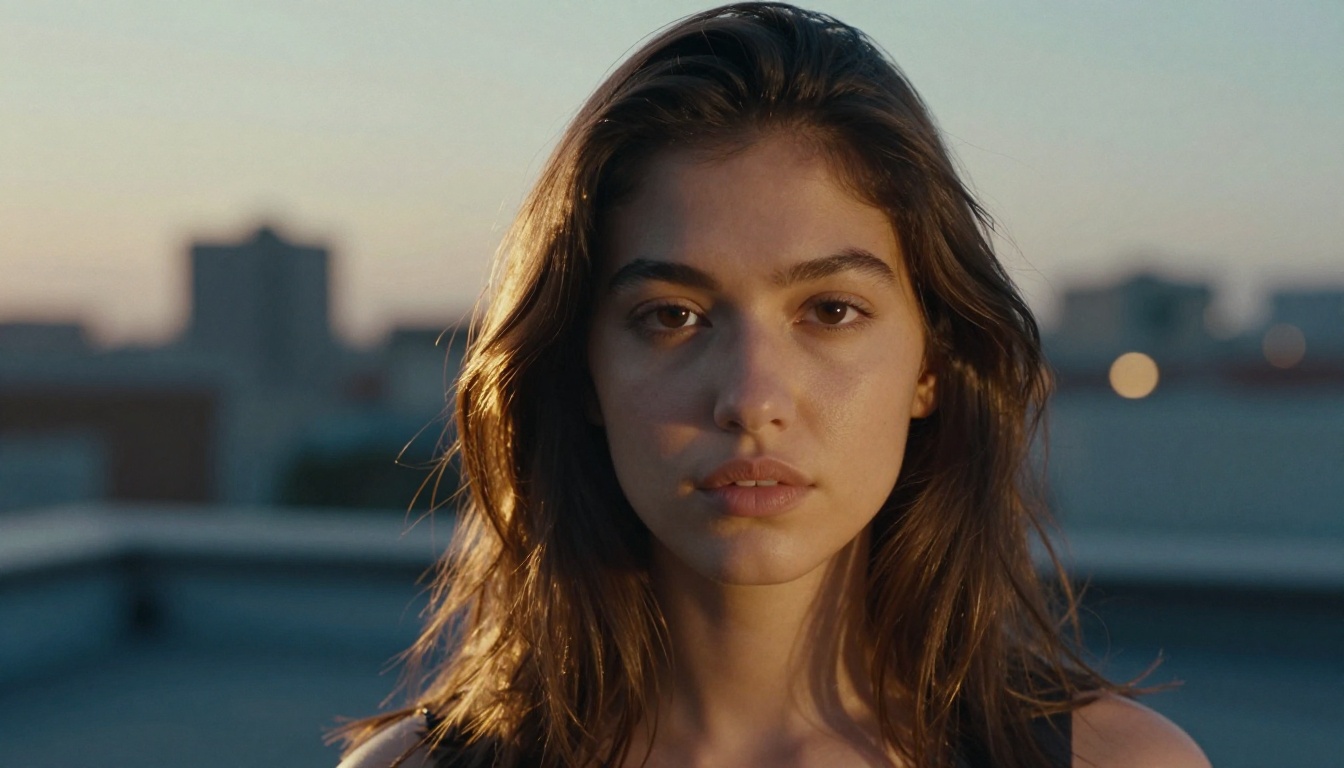
« Une jeune femme sûre d’elle aux cheveux courts et bruns regarde directement la caméra avec un léger sourire naturel, debout sur un toit urbain au crépuscule. Un contre-jour du soleil couchant derrière elle crée un halo chaud. Objectif portrait 85 mm f/1.4. Lent zoom avant, le sujet remplit le cadre à la fin du clip. »
Comment utiliser Wan 2.7 T2V sur PicassoIA
Wan 2.7 T2V est l’un des modèles de texte vers vidéo les plus performants pour produire des clips en 1080p à forte cohérence temporelle. Voici comment obtenir les meilleurs résultats sur PicassoIA.
Étape 2 : dans le champ du prompt, structurez votre saisie selon la formule ci-dessus. Wan 2.7 répond particulièrement bien aux indications de mouvement de caméra placées en fin de prompt, une fois le sujet et l’environnement entièrement posés.
Étape 3 : réglez la résolution sur 1080p. Wan 2.7 conserve bien mieux la netteté à des résolutions de sortie plus élevées, et la différence avec le 720p est visible.
Étape 4 : pour les clips qui exigent une continuité de mouvement (comme une personne qui traverse une scène), utilisez le champ prompt négatif pour exclure : blurry, flickering, morphing, distorted, low quality, static, duplicate subject.
Étape 5 : lancez votre première génération. Si le sujet dérive dans les 2 premières secondes, votre description de l’environnement est trop pauvre. Ajoutez davantage de repères spatiaux à l’arrière-plan avant de relancer.
Étape 6 : pour les flux de travail image vers vidéo sur la même scène, passez à Wan 2.7 I2V, qui permet d’animer une image fixe générée avec un prompt de continuation, en verrouillant l’apparence du sujet dès la première image.
Conseils de paramètres pour Wan 2.7
Paramètre
Valeur recommandée
Remarques
Étapes
30-40
Plus d’étapes = plus de détails, génération plus lente
Échelle CFG
7-9
Restez sous 10 pour éviter une netteté excessive
Intensité du mouvement
0,6-0,8
Au-delà de 0,9, le sujet devient instable
Durée du clip
5-8 secondes
Le point idéal pour la cohérence
Prompt négatif
Voir la section ci-dessous
À toujours inclure
💡 Wan 2.7 T2V gère mieux que la plupart des modèles les scènes de foule et les arrière-plans environnementaux complexes. Si votre scène comporte plusieurs éléments, c’est un meilleur premier choix que des modèles centrés sur un seul sujet comme Motion 2.0.
Ajustements de prompts propres à chaque modèle
Chaque modèle porte des biais ancrés dans ses données d’entraînement. Les connaître permet à vos prompts de donner le résultat voulu, au lieu de deviner.
Kling v3 et Kling v2.6
Kling v3 Video et Kling v2.6 sont de redoutables modèles de cinéma, très sensibles au vocabulaire cinématographique.
Ce qui fonctionne : les spécifications d’objectif (35mm prime, anamorphic), les références cinématographiques (shot on 35mm film) et les mouvements de caméra explicites (Steadicam tracking shot, dolly zoom).
Ce qui ne fonctionne pas : les mots d’ambiance abstraits sans ancrage spatial. « Atmosphère mystique » produit des résultats incohérents. « Brume légère qui glisse sur le sol de la forêt à l’aube » ne le fait pas.
Kling v2.6 prend aussi en charge les entrées de contrôle du mouvement, ce qui permet de tracer directement les trajectoires de caméra. Combinez-le à un prompt textuel solide et vous pouvez reproduire précisément des travellings ou des panoramiques. Pour la qualité de sortie la plus élevée de la famille Kling, Kling v2.1 Master produit des résultats en 1080p remarquables lorsqu’on lui donne des prompts cinématographiques détaillés.
Veo 3.1 et Sora 2
Veo 3.1 et Sora 2 reposent sur des modèles de fondation entraînés sur d’immenses corpus vidéo. Ils gèrent la physique du monde réel mieux que la plupart.
Pour ces modèles, misez sur les descripteurs de réalisme physique : « tension superficielle de l’eau », « tissu qui tombe naturellement sous l’effet de la gravité », « ombre qui glisse sur le mur au passage du sujet devant la fenêtre ».
Sora 2 répond particulièrement bien aux prompts rédigés sous forme de traitements cinématographiques : phrases complètes, langage naturel, structure de cause à effet. Il est moins sensible à l’ordre des tokens que d’autres modèles. Sora 2 Pro pousse cela plus loin avec une durée de clip plus longue et une meilleure conservation des détails.
Veo 3.1 Fast est la variante plus rapide : idéale pour itérer lorsque vous testez des structures de prompts avant de lancer une génération en pleine qualité.
Seedance 2.0 et Pixverse v6
Seedance 2.0 et Pixverse v6 génèrent tous deux avec un son natif, ce qui change la manière d’écrire les prompts. Incluez des descripteurs de son ambiant même si vous vous concentrez sur l’image : ils guident la couche audio du modèle et donnent un résultat plus cohérent.
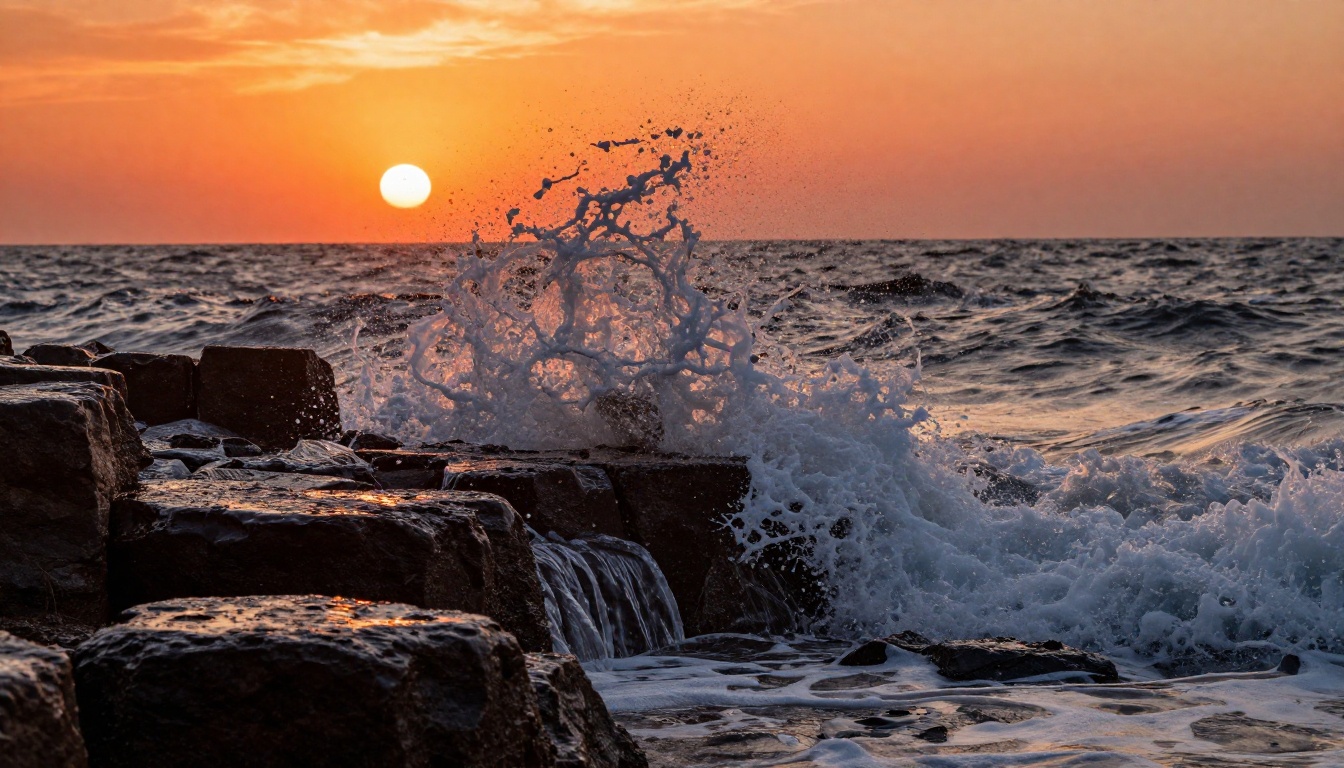
« Des vagues se brisent contre des rochers de basalte au coucher du soleil, de la brume dans l’air. Le bruit de l’eau qui tourbillonne et du vent. Ralenti, objectif 70 mm. »
Pixverse v6 gère exceptionnellement bien les mouvements rapides (séquences d’action, sport, phénomènes naturels). Seedance 2.0 est plus performant sur les séquences lentes et émotionnelles avec une présence de personnage. Pour un délai plus court sur le même moteur, Seedance 2.0 Fast conserve l’essentiel de la qualité pour une fraction du temps de génération.
LTX 2 Pro et LTX 2.3 Pro
LTX 2 Pro et LTX 2.3 Pro sont des générateurs natifs en 4K. À cette résolution, le détail des textures dans votre prompt rapporte gros. Décrivez explicitement les matériaux de surface : « grain de chêne patiné », « cuir cousu main », « aluminium brossé ».
Ces modèles réagissent aussi bien aux prompts de transition d’éclairage : « lumière du matin qui passe à l’après-midi, ombres qui s’allongent ». Ils peuvent rendre des changements subtils de lumière au fil du temps, que la plupart des modèles aplatissent en une exposition statique.
Prompts négatifs qui règlent 80 % des problèmes
Les prompts négatifs ne sont pas une réflexion après coup. Pour la génération vidéo, ils sont structurels.
Exclusions par défaut
Cette base de prompt négatif fonctionne sur la plupart des modèles :
blurry, out of focus, flickering, morphing, distorted face, duplicate subject,
deformed limbs, low quality, pixelated, watermark, text overlay, jumpcut,
static background, color banding, overexposed, underexposed
Appliquez-la à chaque génération avant de modifier quoi que ce soit d’autre.
Négatifs spécifiques au style
Pour les séquences cinématographiques :
cartoon, illustration, anime, CGI, unrealistic, neon, oversaturated, digital art
Pour les portraits et les clips de personnages :
two faces, extra limbs, asymmetrical features, unnatural skin texture, plastic look,
over-retouched skin
💡 Remarque propre au modèle : Gen 4.5 de Runway réagit particulièrement bien aux prompts négatifs. Son champ de prompt négatif a un effet plus marqué sur le style du résultat que la plupart des concurrents. Prenez donc le temps de le soigner avant d’ajuster votre prompt positif.
Tableaux aide-mémoire pour les prompts
Vocabulaire des mouvements de caméra
Effet recherché
Termes efficaces
Lent rapprochement vers le sujet
« lent travelling avant », « zoom avant progressif »
Recul pour révéler l’échelle
« plan de grue arrière », « travelling arrière », « dézoom en plan large »
Suivre un sujet en mouvement
« plan suiveur », « suivi Steadicam », « panoramique à gauche »
Caméra verrouillée, sans mouvement
« plan fixe », « trépied verrouillé », « aucun mouvement de caméra »
Énergie à l’épaule
« léger tremblement à l’épaule », « légère oscillation de caméra »
Perspective aérienne
« images de drone », « vue à vol d’oiseau », « plan d’ensemble en plongée »
Échelle d’intensité du mouvement
Intensité
Termes à utiliser
Quasi immobile
« mouvement imperceptible », « cheveux à peine agités dans l’immobilité »
Subtile
« léger balancement », « lente rotation », « petit mouvement »
Cela signifie généralement que votre environnement est sous-décrit. Le modèle dispose de trop de degrés de liberté dans l’arrière-plan et le remplit différemment à chaque image. Corrigez-le en ajoutant 2 ou 3 éléments d’arrière-plan précis avec leur position : « mur de pierre patiné à gauche », « rangée de cyprès en second plan, à droite ».
Vérifiez aussi votre réglage d’intensité du mouvement. S’il est au-dessus de 0,85, baissez-le. Des valeurs élevées amplifient l’incohérence de l’arrière-plan sur chaque modèle.
Le sujet se déforme en cours de clip
Cela arrive lorsque la description du sujet est ambiguë, que l’indication de mouvement est trop brutale, ou les deux. Trois corrections :
Ajoutez un point d’ancrage de pose : « debout, poids sur le pied gauche, main droite posée sur la hanche » donne au modèle un état physique de départ vers lequel revenir entre les images.
Réduisez la durée du clip : un clip de 3 secondes offre une cohérence du sujet nettement meilleure qu’un clip de 9 secondes pour les sujets complexes.
Utilisez l’image vers vidéo : générez d’abord une image fixe de votre sujet, puis animez-la avec Wan 2.7 I2V ou Kling v2.6. Cela verrouille l’apparence du sujet à l’image zéro et supprime complètement le problème de cohérence.
Mouvement peu naturel
Un mouvement peu naturel vient généralement de verbes de mouvement vagues. « Bouger » ou « aller » ne donnent rien à exploiter au modèle. Remplacez-les par des actions physiques précises qui incluent une indication de vitesse :
Au lieu de « s’avance vers la caméra », écrivez « avance d’un pas lent et délibéré vers la caméra, les pas visibles sur le sol »
Au lieu de « la rivière coule », écrivez « le courant de la rivière glisse régulièrement de droite à gauche, captant la lumière de l’après-midi à la surface »
Mettre ces patterns en pratique
Les patterns de cet article ne rendront pas chaque génération parfaite, mais ils réduiront nettement la part des résultats ratés. La vraie compétence réside dans l’itération : lancez un prompt, identifiez quel élément échoue (sujet, mouvement, environnement, caméra), corrigez cette seule variable, puis relancez.
Choisissez un pattern de prompt de cet article, appliquez-le à la scène qui vous pose problème et testez-le sur deux ou trois modèles pour comparer leur interprétation de la même consigne. Cette seule comparaison vous en apprendra plus sur l’ingénierie des prompts vidéo que n’importe quelle fiche de référence.