Padrões de prompt para modelos de vídeo com IA que realmente funcionam
Uma análise estruturada dos padrões de prompt que realmente geram resultados consistentes em vídeos com IA. Da fórmula central de sujeito, ação e ambiente aos ajustes específicos para Wan 2.7, Kling v3, Veo 3.1, Sora 2 e Seedance 2.0, com guias de consulta rápida, modelos de prompt negativo e soluções para as falhas mais comuns.
A diferença entre um prompt de vídeo que funciona e um que falha raramente está no vocabulário. Está na estrutura. Os modelos de vídeo com IA não leem prompts como os humanos. Eles interpretam relações espaciais, sinais temporais e vetores de movimento a partir da sequência de palavras que você fornece. Se você escrever errado, aparecem sujeitos que tremulam, deriva de câmera e cenas que se dissolvem em ruído no meio do clipe. Se escrever certo, você obtém imagens que se sustentam como algo filmado com uma câmera de verdade.
Este artigo detalha os padrões de prompt específicos que geram resultados consistentes e de alta qualidade nos principais modelos de vídeo com IA disponíveis hoje: do Wan 2.7 T2V ao Kling v3 Video, do Veo 3.1 ao Seedance 2.0.
Por que a maioria dos prompts desmorona logo de cara
Os 3 padrões que falham sempre
1. O despejo de substantivos. "Montanha, pôr do sol, mulher, caminhando, cinematográfico." Isso diz ao modelo cinco coisas, mas não dá nenhuma relação entre elas. A mulher está caminhando em direção à montanha? Para longe dela? O modelo adivinha, e adivinha de forma diferente em cada quadro.
2. A pilha de adjetivos. "Lindo, deslumbrante, maravilhoso, de tirar o fôlego, pôr do sol mágico." Empilhar sinônimos não amplifica o efeito. Ele dilui. O modelo faz uma média desses descritores e produz um resultado medíocre que não se apoia em nenhum deles.
3. A cena passiva. "Uma floresta. Há um rio. Há pássaros." Sem direção de movimento, sem agência do sujeito, sem lógica temporal. Modelos de vídeo precisam saber o que está acontecendo ao longo do tempo, não apenas o que existe no quadro.
O que o modelo realmente interpreta
Os modelos modernos de geração de vídeo processam prompts em camadas. Primeiro extraem o sujeito principal e lhe atribuem prioridade de movimento. Depois leem o contexto ambiental para construir o plano de fundo. Por fim, interpretam modificadores temporais como "lentamente", "de repente" ou "a câmera recua" para coreografar o movimento ao longo da duração do clipe.
Se o seu sujeito estiver enterrado no meio de uma longa lista de adjetivos, ou se os sinais de movimento vierem antes que o ambiente seja estabelecido, o modelo perde a coerência. As três a cinco primeiras palavras têm o maior peso.
💡 Regra prática: Sujeito primeiro, ação em segundo, ambiente em terceiro, modificadores por último. Fugir disso é por sua conta e risco.
A fórmula central do prompt
A fórmula que supera consistentemente todas as outras nos modelos de vídeo é:
[Sujeito + Ação] + [Ambiente/Plano de fundo] + [Instruções de câmera] + [Iluminação/Atmosfera] + [Modificadores de estilo]
Sujeito, ação e ambiente
Cada palavra aqui tem peso. Compare estes dois prompts:
Fraco: "Uma mulher de vestido branco na natureza"
Forte: "Uma mulher com um vestido fluido de linho branco caminha descalça por um campo de flores silvestres banhado de sol"
A segunda versão dá ao modelo um sujeito, um atributo físico, um verbo de ação específico e um ambiente definido. Agora o modelo consegue manter o sujeito consistente ao longo dos quadros.
Quando o seu sujeito é uma pessoa, inclua: textura da roupa, porte aproximado e um verbo de ação específico. Não "parada ali", mas "vira-se devagar para encarar a câmera". Não "sentada", mas "se inclina para a frente sobre uma mesa de madeira".
Para sujeitos não humanos, como paisagens, produtos ou objetos, ancore-os com uma posição específica no quadro: "uma máquina de café expresso preta em primeiro plano" ou "um carro antigo estacionado na diagonal em uma rua da cidade molhada de chuva".
Movimento e direção de câmera
É aqui que a maioria dos prompts desperdiça desempenho. Movimento de câmera e movimento do sujeito são duas coisas separadas, e tratá-las da mesma forma prejudica as duas.
Movimento do sujeito descreve o que o elemento principal faz: "caminha devagar", "vira a cabeça", "as ondas quebram e recuam".
Movimento de câmera descreve o que a câmera virtual faz: "avanço lento em travelling", "plano de rastreamento em ângulo baixo", "recuo aéreo com grua", "leve tremor de câmera na mão".
Declare-os separadamente, e declare o movimento de câmera por último, para que o modelo possa usá-lo como um invólucro coreográfico:
"Uma mulher de vestido vermelho se vira devagar em direção à câmera em um pátio ensolarado. Avanço lento em travelling, a partir da altura da cintura. Lente de 35mm."
Camada de atmosfera e iluminação
A iluminação é a variável mais importante entre um resultado com aparência chapada e algo que parece cinematográfico. Especifique:
Direção: "luz da manhã vindo da esquerda", "contraluz do sol poente", "sombra pontilhada de cima"
Qualidade: "luz suave e difusa", "contraste duro do meio-dia", "brilho quente da hora dourada"
Temperatura de cor: "tons âmbar quentes", "cinza-azulado frio de céu nublado"
Não diga apenas "iluminação cinematográfica". Essa expressão foi tão usada que quase não significa nada para a maioria dos modelos. Descreva a luz como um diretor de fotografia faria: de onde ela vem e o que faz com o rosto ou a superfície do sujeito.
💡 Dica de especialista: Adicionar uma referência de filme específica, como "perfil de cor Kodak Portra 400" ou "filmado em 16mm", sinaliza ao modelo que você quer textura orgânica, granulação natural e realces dessaturados. Ela rende bem mais do que se espera em qualidade de resultado.
Padrões de prompt por tipo de cena
Diferentes categorias de cena exigem ênfases estruturais diferentes. Veja como dar peso aos seus prompts.
Cenas narrativas e cinematográficas
Para clipes com história, a lógica temporal é fundamental. O modelo precisa saber o que acontece primeiro, o que acontece depois e como a câmera reage.
Use palavras de movimento conectivas: "então", "enquanto", "ao mesmo tempo". Elas criam relações de causa e efeito entre os quadros.
"Uma caminhante solitária chega ao topo de uma crista ao nascer do sol, parando para olhar o vale lá embaixo. A câmera recua lentamente em um plano amplo de grua, revelando a escala das montanhas ao redor dela. Luz dourada e quente vinda da direita."
Para efeito dramático, o Kling v3 Video e o Veo 3.1 lidam melhor com a lógica temporal. Ambos interpretam bem as palavras de movimento conectivas e mantêm a consistência do sujeito durante o movimento de câmera.
Filmagens de produtos e estilo de vida
Imagens de produtos exigem precisão espacial. Diga ao modelo exatamente onde o produto está no quadro, o que o cerca e como a luz interage com a superfície do produto.
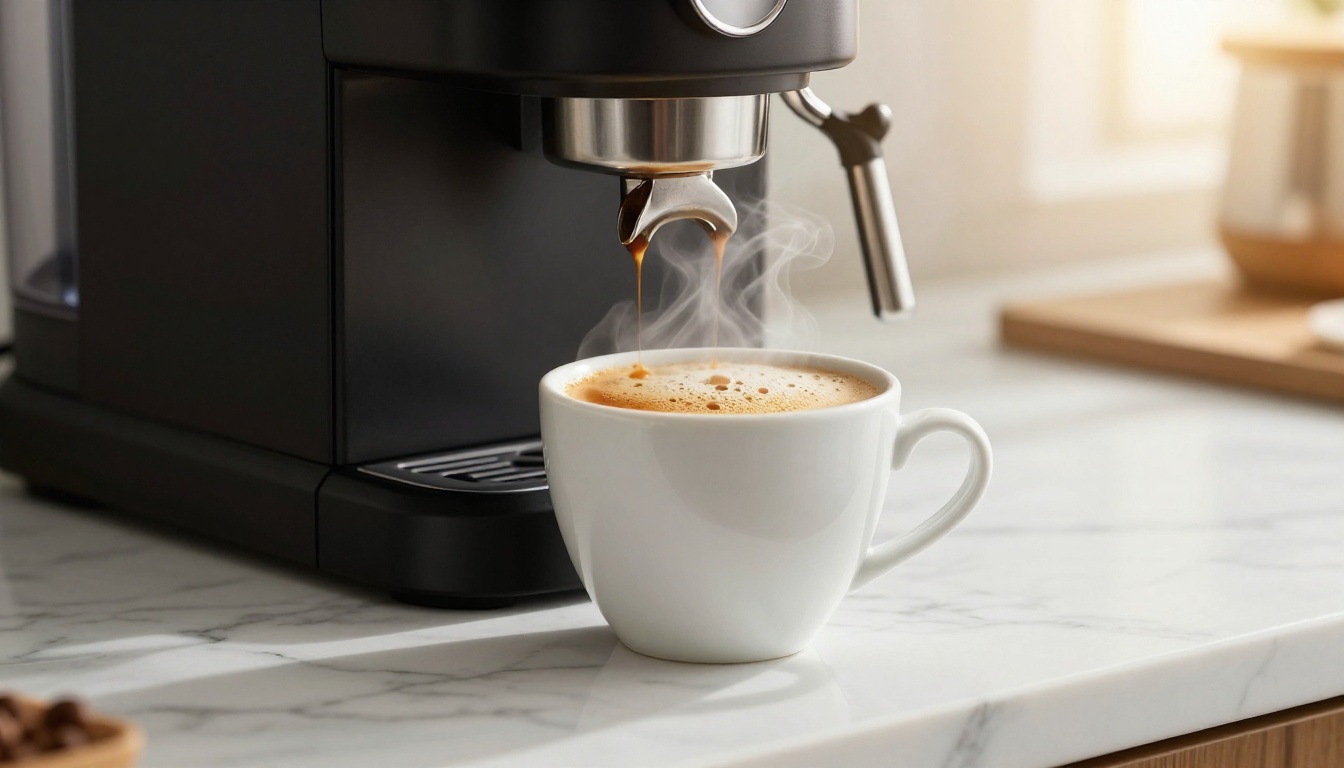
"Uma máquina de café expresso preta e elegante em foco nítido no primeiro plano, sobre uma bancada de mármore branco, com vapor subindo do bico. Fundo de cozinha quente e desfocado com luz de janela da manhã. Puxada lenta de foco do aparelho para o vapor que sobe. Lente macro de 100mm."
Para trabalhos com produtos, o LTX 2 Pro e o LTX 2.3 Pro se destacam em manter detalhes nítidos do objeto e uma separação limpa do fundo na saída em 4K.
Retratos e movimento de personagem
Retratos dependem totalmente de como o modelo lida com a consistência facial ao longo dos quadros. A deformação do sujeito é a falha mais comum aqui. Para combatê-la:
Adicione uma base de expressão neutra: "expressão neutra, leve sorriso natural"
Especifique a direção da cabeça e dos olhos: "olhando diretamente para a câmera, leve inclinação para baixo"
Mantenha o movimento mínimo e lento: "movimento sutil do cabelo com a brisa, virada lenta da cabeça"
"Uma jovem confiante, de cabelo curto e escuro, olha diretamente para a câmera com um leve sorriso natural, em pé num terraço urbano ao anoitecer. A contraluz do sol poente atrás dela cria um halo quente. Lente de retrato de 85mm f/1.4. Zoom lento para dentro, com o sujeito preenchendo o quadro até o fim do clipe."
Como usar o Wan 2.7 T2V no PicassoIA
O Wan 2.7 T2V é um dos modelos de texto para vídeo mais capazes disponíveis para produzir clipes em 1080p com forte coerência temporal. Veja como obter os melhores resultados no PicassoIA.
Passo 2: No campo de prompt, estruture sua entrada usando a fórmula acima. O Wan 2.7 responde especialmente bem a sinais de movimento de câmera colocados no fim do prompt, depois que o sujeito e o ambiente estiverem totalmente estabelecidos.
Passo 3: Defina sua resolução para 1080p. O Wan 2.7 mantém a nitidez muito melhor em resoluções de saída mais altas, e a diferença para 720p é visível.
Passo 4: Para clipes que exigem continuidade de movimento (como uma pessoa caminhando por uma cena), use o campo de prompt negativo para excluir: blurry, flickering, morphing, distorted, low quality, static, duplicate subject.
Passo 5: Execute sua primeira geração. Se o sujeito derivar nos primeiros 2 segundos, sua descrição do ambiente está escassa demais. Acrescente mais âncoras espaciais ao fundo antes de gerar novamente.
Passo 6: Para um fluxo de trabalho de imagem para vídeo na mesma cena, mude para o Wan 2.7 I2V, que permite animar uma imagem fixa gerada com um prompt de continuação, travando a aparência do sujeito desde o primeiro quadro.
Dicas de parâmetros para o Wan 2.7
Parâmetro
Valor recomendado
Observações
Steps
30-40
Mais steps = mais detalhe, geração mais lenta
CFG Scale
7-9
Fique abaixo de 10 para evitar nitidez excessiva
Motion Strength
0,6-0,8
Acima de 0,9 causa instabilidade no sujeito
Duração do clipe
5-8 segundos
Ponto ideal para coerência
Prompt negativo
Veja a seção abaixo
Sempre incluir
💡 O Wan 2.7 T2V lida com cenas de multidão e fundos ambientais complexos melhor do que a maioria. Se a sua cena tiver vários elementos, ele é uma primeira escolha melhor do que modelos focados em um único sujeito, como o Motion 2.0.
Ajustes de prompt específicos por modelo
Cada modelo tem vieses incorporados a partir de seus dados de treinamento. Conhecê-los faz seus prompts acertarem em vez de chutar.
Kling v3 e Kling v2.6
O Kling v3 Video e o Kling v2.6 são potências cinematográficas que respondem fortemente à terminologia de cinema e de cinematografia.
O que funciona: especificações de lente (35mm prime, anamorphic), referências de filmes (shot on 35mm film) e movimentos de câmera explícitos (Steadicam tracking shot, dolly zoom).
O que não funciona: palavras de clima abstratas sem ancoragem espacial. "Atmosfera mística" produz resultados inconsistentes. "Névoa suave rolando pelo chão da floresta ao amanhecer" não produz.
O Kling v2.6 também oferece suporte a entradas de controle de movimento, permitindo desenhar trajetórias de câmera diretamente. Combine isso com um prompt de texto forte e você consegue replicar com precisão movimentos de travelling ou panorâmica. Para a mais alta qualidade de saída da família Kling, o Kling v2.1 Master produz resultados impressionantes em 1080p quando recebe prompts cinematográficos detalhados.
Veo 3.1 e Sora 2
O Veo 3.1 e o Sora 2 são construídos sobre modelos base treinados em corpora de vídeo massivos. Eles lidam com física do mundo real melhor do que a maioria.
Para esses modelos, aposte em descritores de realismo físico: "tensão superficial da água", "tecido caindo naturalmente sob a gravidade", "sombra se movendo pela parede enquanto o sujeito passa pela janela".
O Sora 2 responde especialmente bem a prompts escritos como tratamentos de roteiro de cinema: frases completas, linguagem natural, estrutura de causa e efeito. Ele é menos sensível à ordem dos tokens do que outros modelos. O Sora 2 Pro amplia isso com duração de clipe maior e maior retenção de detalhes.
O Veo 3.1 Fast é a versão mais rápida: perfeita para iterar quando você está testando estruturas de prompt antes de se comprometer com uma geração de qualidade total.
Seedance 2.0 e Pixverse v6
O Seedance 2.0 e o Pixverse v6 geram com áudio nativo, o que muda a forma como você deve escrever os prompts. Inclua descritores de som ambiente mesmo quando estiver focado no visual: eles orientam a camada de áudio do modelo e criam um resultado mais coeso.
"Ondas quebram contra rochas de basalto ao pôr do sol, com névoa no ar. O som da água agitada e do vento. Câmera lenta, lente de 70mm."
O Pixverse v6 lida excepcionalmente bem com movimento rápido (sequências de ação, esportes, fenômenos naturais). O Seedance 2.0 é mais forte em filmagens lentas e emotivas, com presença de personagem. Para uma entrega mais rápida no mesmo motor, o Seedance 2.0 Fast mantém a maior parte da qualidade em uma fração do tempo de geração.
LTX 2 Pro e LTX 2.3 Pro
O LTX 2 Pro e o LTX 2.3 Pro são geradores nativos em 4K. Nessa resolução, o detalhe de textura no seu prompt compensa. Descreva os materiais das superfícies de forma explícita: "veio de carvalho desgastado", "couro costurado à mão", "alumínio escovado".
Esses modelos também respondem bem a prompts de transição de iluminação: "luz da manhã mudando para a tarde, sombras se alongando". Eles conseguem renderizar mudanças sutis de iluminação ao longo do tempo que a maioria dos modelos achata em uma exposição estática.
Prompts negativos que resolvem 80% dos problemas
Prompts negativos não são algo pensado depois. Na geração de vídeo, eles são estruturais.
Exclusões padrão
Esta base de prompt negativo funciona na maioria dos modelos:
blurry, out of focus, flickering, morphing, distorted face, duplicate subject,
deformed limbs, low quality, pixelated, watermark, text overlay, jumpcut,
static background, color banding, overexposed, underexposed
Aplique isto a cada geração antes de ajustar qualquer outra coisa.
Negativos específicos por estilo
Para filmagens cinematográficas:
cartoon, illustration, anime, CGI, unrealistic, neon, oversaturated, digital art
Para clipes de retrato e personagem:
two faces, extra limbs, asymmetrical features, unnatural skin texture, plastic look,
over-retouched skin
💡 Observação específica do modelo: o Gen 4.5, da Runway, responde especialmente bem a prompts negativos. Seu campo de prompt negativo tem efeito mais forte sobre o estilo do resultado do que a maioria dos concorrentes, então invista tempo aqui antes de ajustar seu prompt positivo.
Tabelas de consulta rápida de prompts
Vocabulário de movimento de câmera
Efeito desejado
Palavras que funcionam
Avanço lento em direção ao sujeito
"avanço lento em travelling", "zoom gradual para dentro"
Recuo para revelar escala
"recuo com grua", "travelling reverso", "zoom para abrir o plano"
Acompanhar um sujeito em movimento
"plano de rastreamento", "acompanhamento com Steadicam", "panorâmica para a esquerda"
Câmera travada, sem movimento
"plano estático", "câmera fixa em tripé", "sem movimento de câmera"
Energia de câmera na mão
"leve tremor de câmera na mão", "leve balanço da câmera"
Perspectiva aérea
"imagens de drone", "vista de pássaro", "plano geral aéreo de cima"
Escala de intensidade de movimento
Intensidade
Palavras a usar
Quase parado
"movimento imperceptível", "cabelo mal se movendo na quietude"
Sutil
"balanço suave", "virada lenta", "leve movimento"
Moderado
"caminha por", "brisa moderada", "vira com firmeza"
Ativo
"caminhada rápida", "correndo", "ondas quebrando"
Dinâmico
"em disparada", "explosivo", "panorâmica rápida em whip"
O que fazer quando o resultado quebra
Quadros borrados ou inconsistentes
Isso geralmente significa que seu ambiente está pouco descrito. O modelo tem graus de liberdade demais no fundo e o preenche de forma diferente a cada quadro. Corrija adicionando de 2 a 3 elementos específicos de fundo com posições: "muro de pedra desgastado à esquerda", "fileira de ciprestes no meio da distância à direita".
Verifique também a configuração de motion strength. Se estiver acima de 0,85, reduza. Valores altos de motion strength acumulam inconsistência de fundo em todos os modelos.
O sujeito se deforma no meio do clipe
Isso acontece quando a descrição do sujeito é ambígua, o sinal de movimento é agressivo demais, ou ambos. Três correções:
Adicione uma âncora de pose: "em pé com o peso na perna esquerda, mão direita apoiada no quadril" dá ao modelo um estado físico inicial para retornar entre os quadros.
Reduza a duração do clipe: um clipe de 3 segundos tem consistência de sujeito bem melhor do que um de 9 segundos para sujeitos complexos.
Use imagem para vídeo: gere primeiro uma imagem fixa do seu sujeito e depois anime-a com o Wan 2.7 I2V ou o Kling v2.6. Isso trava a aparência do sujeito no quadro zero e elimina o problema de consistência por completo.
Movimento não natural
O movimento não natural geralmente vem de verbos de movimento vagos. "Mexendo" ou "indo" não dá nada para o modelo trabalhar. Substitua-os por ações físicas específicas que incluam contexto de velocidade:
Em vez de "se move em direção à câmera", use "caminha em ritmo lento e deliberado em direção à câmera, com passos visíveis no chão"
Em vez de "o rio flui", use "a correnteza do rio avança de forma constante da direita para a esquerda, capturando a luz da tarde na superfície"
Coloque esses padrões para trabalhar
Os padrões deste artigo não farão cada geração ficar perfeita, mas vão reduzir os resultados falhos de forma significativa. A habilidade real está na iteração: rode um prompt, identifique qual elemento está falhando (sujeito, movimento, ambiente, câmera), corrija apenas essa variável e rode de novo.
Escolha um padrão de prompt deste artigo, aplique-o à cena com a qual você vem tendo dificuldade e rode-o em dois ou três modelos para comparar como cada um interpreta a mesma entrada. Só essa comparação vai ensinar mais sobre engenharia de prompts para vídeo do que qualquer guia de referência.