La mayoría de las herramientas de video con IA te piden que describas un personaje con palabras y luego esperan que el modelo recuerde lo que querías decir. Seedance 2.0 R2V sigue otro camino: le entregas al modelo imágenes, clips y audio reales, y él construye el video a partir de ellos. El resultado es un abrigo rojo que sigue siendo rojo, un rostro que se mantiene reconocible y un producto que conserva su forma desde el primer fotograma hasta el último. Este artículo cubre los ajustes que puedes cambiar, ejemplos de prompts que puedes copiar, lo que cobran los proveedores por generación y los límites que determinarán cómo planificas una toma.
Puedes usar el modelo en PicassoIA a través de Seedance 2.0, así que los pasos siguientes se basan en los campos de entrada reales y no en suposiciones.
Qué significa realmente R2V
R2V son las siglas de reference-to-video, es decir, video a partir de referencias. En lugar de partir solo de texto (texto a video) o de un fotograma inicial (imagen a video), le das al modelo un conjunto de material de referencia y un prompt que le indica cómo usar cada pieza.
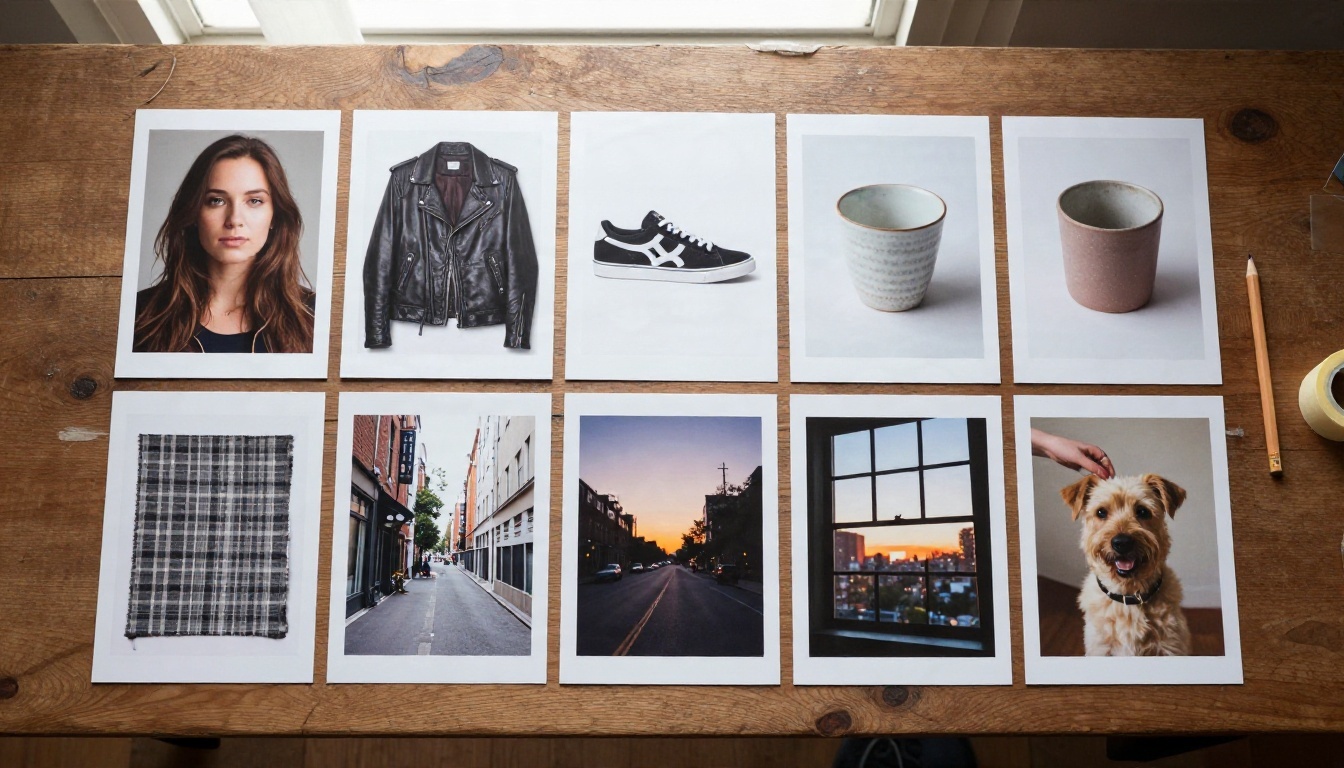
Imágenes de referencia frente al primer fotograma
Esta distinción confunde a mucha gente. Una imagen de primer fotograma fija el inicio del clip, y el modelo anima a partir de ahí. Las imágenes de referencia, en cambio, le indican al modelo cómo son un sujeto, un atuendo, un lugar o un estilo visual, pero es el modelo quien decide cómo componer la escena.
En PicassoIA los dos modos son excluyentes. El campo de imagen (primer fotograma) y el campo del último fotograma no se pueden combinar con imágenes de referencia. Si subes referencias, deja vacíos los campos del primer y del último fotograma.
💡 Regla general: usa un primer fotograma cuando necesites una toma inicial exacta. Usa imágenes de referencia cuando necesites que el mismo personaje o producto aparezca en una escena que todavía estás inventando.
Qué lee el modelo de tus entradas
Seedance 2.0 acepta tres tipos de material de referencia en una misma solicitud:
- Imágenes para la identidad, la ropa, los accesorios, el escenario y el estilo visual
- Videos para el movimiento, el movimiento de cámara y el comportamiento de edición
- Audio para la voz, el ritmo y la sincronización labial
Cada archivo recibe una etiqueta en tu prompt: [Image1], [Video1], [Audio1], y así sucesivamente. El orden de las etiquetas sigue el orden en que subes los archivos. Si omites las etiquetas, el modelo sigue usando tus referencias, pero decide por su cuenta para qué sirve cada una. Etiquetar elimina esa ambigüedad.
Cada ajuste explicado
Esta es la lista completa de entradas tal como aparece para Seedance 2.0 en PicassoIA, con lo que hace cada campo en la práctica.
| Ajuste | Opciones | Predeterminado | Qué hace |
|---|
| Prompt | Texto libre | Obligatorio | Describe la acción, la cámara y el sonido. Los diálogos van entre comillas dobles |
| Imágenes de referencia | Hasta 9 | Vacío | Guía de personaje, estilo y escena |
| Videos de referencia | Hasta 3, 15 s en total | Vacío | Transferencia de movimiento y referencia de estilo |
| Audios de referencia | Hasta 3, 15 s en total | Vacío | Generación guiada por audio y sincronización labial |
| Duración | Segundos enteros, o -1 | 5 | -1 deja que el modelo elija la longitud |
| Resolución | 480p, 720p, 1080p, 4k | 720p | Nitidez de salida y nivel de costo |
| Relación de aspecto | 16:9, 4:3, 1:1, 3:4, 9:16, 21:9, 9:21, adaptive | 16:9 | Forma del encuadre |
| Generar audio | Activado o desactivado | Activado | Diálogos, efectos y música en una sola pasada |
| Semilla | Entero | Aleatoria | Repetir o comparar generaciones |
Imágenes, videos y audio de referencia
Nueve imágenes es un máximo generoso, pero más no siempre es mejor. Entre tres y cinco imágenes bien elegidas suelen funcionar mejor que nueve mezcladas, porque cada imagen extra le da al modelo otra cosa que conciliar. Un retrato limpio, una toma de cuerpo entero y una foto del lugar harán más que un álbum de recortes.
Los videos de referencia están limitados a tres, con una duración combinada de 15 segundos. Funcionan mejor cuando el clip muestra un único movimiento claro: un giro de cabeza, un ciclo de caminata, un travelling lento. Un clip cargado con cinco movimientos no le da al modelo nada concreto que copiar.
El audio de referencia tiene una condición que conviene recordar: requiere al menos una imagen o un video de referencia. No puedes generar un video solo con audio. Sube primero el rostro o la escena, luego adjunta el clip de voz y etiquétalo como [Audio1] en el prompt.
Duración y relación de aspecto
El valor predeterminado es de 5 segundos. Los proveedores que publican rangos para el endpoint de reference-to-video de la versión 2.0 suelen indicar de 4 a 15 segundos. Si pones la duración en -1, la decisión pasa al modelo, que elige una longitud según cuánto sucede en tu prompt. Eso resulta útil para una prueba rápida, pero es impredecible cuando estás calculando el presupuesto.
La relación de aspecto es más sencilla. Usa 16:9 para YouTube y cine, 9:16 para Reels y Shorts, 1:1 para feeds y 21:9 para un encuadre cinematográfico. El ajuste adaptive deja que el modelo elija según tus entradas, lo que funciona bien cuando tus imágenes de referencia comparten una orientación clara.
Resolución y el interruptor de audio
Las opciones de resolución del esquema van de 480p hasta 4k, con 720p como predeterminada. Algunos proveedores limitan la salida por debajo de otros, y tu plan puede restringir los niveles superiores, así que confirma qué permite tu cuenta antes de planificar un flujo de trabajo en 1080p.
El interruptor Generar audio está activado de forma predeterminada. Con él activado, el modelo escribe los diálogos, el sonido ambiente y la música en la misma pasada que la imagen. Desactívalo si vas a componer tú mismo la banda sonora del video o si solo estás probando el movimiento.
Cómo usar Seedance 2.0 en PicassoIA
Sigue estos pasos para ejecutar tu primera generación R2V.
- Abre el modelo. Ve a Seedance 2.0 en PicassoIA.
- Sube imágenes de referencia. Añade de una a cinco imágenes en el campo de imágenes de referencia. Deja vacíos los campos del primer y del último fotograma.
- Añade video o audio opcional. Adjunta un clip de movimiento o un archivo de voz si tu toma los necesita. Recuerda que el audio necesita al menos una imagen o un video junto a él.
- Escribe un prompt etiquetado. Menciona cada archivo por su etiqueta, por ejemplo: "[Image1] camina por una calle lluviosa, cámara siguiendo a la altura del hombro."
- Ajusta la duración y la relación. Empieza con 5 segundos y 16:9 o 9:16.
- Elige la resolución. Prueba en 720p antes de gastar en un nivel superior.
- Mantén el audio activado. A menos que pienses reemplazarlo en la edición.
- Genera y revisa. Cambia una variable cada vez entre ejecuciones y guarda la semilla si quieres comparar.
💡 Prueba barato, termina caro. Haz tus dos o tres primeros intentos en 720p y con una duración corta. Pasa a una resolución mayor solo cuando el movimiento y la identidad se vean bien.
Ejemplos de prompts para copiar
Los buenos prompts de R2V se leen como notas de rodaje. Indican quién aparece, dónde, qué se mueve, cómo se comporta la cámara y qué se escucha.
Coherencia de personajes entre escenas
Sube un retrato claro de tu sujeto como [Image1] y una foto de calle como [Image2].
"[Image1] camina despacio por la calle empedrada y mojada de [Image2], cámara baja siguiéndola de lado. La luz cálida de la cafetería se refleja en los charcos. Lluvia suave, pasos lejanos, piano tranquilo de fondo."
El retrato fija el rostro y la ropa, la foto de calle define el lugar y el prompt aporta el movimiento. Reutiliza el mismo retrato en tu siguiente prompt con otra ubicación y el personaje se conserva.
Fotos de producto
Sube dos o tres ángulos del mismo producto, por ejemplo una vista frontal, una vista lateral y un primer plano de la etiqueta.
"La botella de [Image1] y [Image2] descansa sobre una losa de travertino. Acercamiento lento, luz suave lateral desde la izquierda, el cristal capta un reflejo que se desplaza. Ambiente silencioso de sala, un leve roce de tela."
El trabajo con productos es donde las imágenes de referencia más aportan. Un prompt solo con texto inventará una botella. Un prompt basado en referencias conserva la que de verdad vendes.
Retrato con diálogo hablado
Sube un retrato como [Image1] y una grabación de voz corta como [Audio1].
"[Image1] está sentada junto a la ventana de una cafetería y habla a la cámara con la voz de [Audio1]. Movimiento sutil de cabeza, parpadeo natural, luz de día suave desde la izquierda. Se oyen tazas chocando de fondo."
Los diálogos escritos directamente en el prompt van entre comillas dobles. Si adjuntas audio, etiquétalo y deja que el modelo mueva los labios según la grabación.
Precios sin adivinar
No existe un precio único para Seedance 2.0 R2V. Los costos dependen de la plataforma, la resolución, la duración y, en algunos proveedores, de si tu solicitud incluye un video de referencia.
Lo que cobran los proveedores
Las cifras publicadas por distintos proveedores de API varían mucho, por eso conviene leerlas como rangos y no como presupuestos cerrados:
| Factor | Cómo afecta al costo |
|---|
| Resolución | Los niveles superiores cuestan más por segundo |
| Duración | Se cobra por segundo de salida en la mayoría de los proveedores |
| Video de referencia | Algunos proveedores cobran una tarifa distinta cuando hay un video de entrada |
| Nivel | Las variantes Standard, Fast y Mini tienen precios distintos |
| Plataforma | Los agregadores y las API directas publican tarifas diferentes |
Como baño de realidad, un agregador indica un rango de unos $0.60 a $4.05 por generación según la resolución y la duración, mientras que otros proveedores fijan precios por segundo que van desde unas pocas décimas de dólar hasta bastante más de un dólar. Esas cifras cambian con frecuencia, así que tómalas como una muestra de lo amplia que es la diferencia y revisa el proveedor que vas a usar antes de comprometerte con un lote.
Cómo reducir el costo
- Haz borradores en 480p o 720p. Juzga el movimiento y la identidad antes de pagar por la nitidez.
- Mantén la duración corta. Una prueba de 5 segundos te dice casi todo lo que te diría una de 12.
- Evita el -1 mientras calculas el presupuesto. Una longitud automática puede durar más de lo que habías previsto.
- Limita el exceso de referencias. Menos referencias, pero mejores, significan menos reintentos desperdiciados.
- Usa un nivel más barato para los borradores. Seedance 2.0 Fast y Seedance 2.0 Mini son opciones más ligeras para pasadas rápidas.
Límites con los que te vas a topar
Todo modelo de video tiene sus límites. Conocerlos pronto te ahorra créditos y paciencia.
Límites estrictos
| Límite | Valor |
|---|
| Imágenes de referencia | Hasta 9 |
| Videos de referencia | Hasta 3, 15 segundos en total |
| Audio de referencia | Hasta 3, 15 segundos en total |
| Entrada de audio | Necesita al menos una referencia de imagen o video |
| Primer fotograma e imágenes de referencia | No se pueden usar juntos |
| Último fotograma | Solo funciona con un primer fotograma, y no con referencias |
| Tamaño de imagen al subir | Alrededor de 25 MiB por archivo en algunos proveedores, en PNG, JPEG o WEBP |
| Duración del clip | Aproximadamente de 4 a 15 segundos según los rangos publicados por los proveedores |
Límites blandos
Estos no están escritos en el esquema, pero los notarás enseguida:
- Deriva de identidad con referencias muy cargadas. Si tus imágenes muestran a la misma persona con iluminación o ángulos muy distintos, el modelo puede promediarlas. Elige tomas coherentes y nítidas.
- Instrucciones contradictorias. Pedir una persecución rápida y un ambiente lento y contemplativo en un mismo prompt confunde el resultado.
- Personas reales. Muchos proveedores restringen las fotos de referencia de personas reales e identificables. Las políticas varían según la plataforma, así que revisa las normas del lugar donde generas.
- Escenas largas. Un solo clip es corto. Las historias más largas implican generar varios clips con las mismas referencias y unirlos en el montaje.
- Confusión de versiones. Algunos listados en línea mezclan Seedance 2.0 con la familia más nueva 2.5. Comprueba qué modelo ejecuta realmente un endpoint antes de comparar precios o límites.
💡 Planifica por tomas, no por escenas. Trata cada generación como una única configuración de cámara. Reutiliza las mismas imágenes de referencia en cada montaje y luego ensambla la secuencia en un editor.
Alternativas que vale la pena probar
Seedance 2.0 no es el único modelo de video con referencias en PicassoIA. Según el trabajo, estas opciones merecen una prueba lado a lado:
Ejecuta el mismo prompt y las mismas referencias en dos modelos y compara identidad, movimiento y sonido. Las diferencias aparecen rápido, y la mejor opción suele depender de tu sujeto y no de una clasificación.
Prueba tu propio conjunto de referencias
La forma más rápida de ver lo que puede hacer R2V es crear un pequeño conjunto de referencias propio: un retrato, una ubicación y un accesorio. Escribe un prompt con etiquetas, genera en 720p durante 5 segundos y observa lo fielmente que el resultado sigue tus imágenes. Cambia una sola entrada, como sustituir la foto del lugar o añadir un clip de voz, y compara.
Abre Seedance 2.0 en PicassoIA, sube tus referencias y haz tu primera prueba. Si quieres ver qué más hay disponible, explora todo en picassoia.com/en/all-models y combina la generación de video con herramientas de imagen, audio y escalado para tener un flujo de producción completo.


