Abril de 2026 se perfila como uno de los periodos más intensos de la historia de la IA. En solo siete días, varios laboratorios lanzaron actualizaciones importantes de sus modelos, la generación de video cruzó un nuevo umbral de realismo y varias herramientas que antes parecían experimentales ahora resultan realmente listas para producción. Si intentas seguirle el ritmo a las noticias de IA, este es el resumen de la semana, con lo importante separado del ruido.
La carrera de los LLM no se frena
La categoría de modelos de lenguaje (LLM) se volvió claramente más competitiva esta semana. GPT-5 de OpenAI sigue manteniendo su posición como el modelo de propósito general más desplegado, pero el verdadero impulso está en las versiones que lo rodean. GPT-5 Pro incluye pensamiento extendido integrado para tareas complejas de varios pasos. GPT-5 Mini genera texto al instante con una latencia considerablemente menor, y GPT-5 Nano está pensado para aplicaciones de computación en el borde en tiempo real, donde la velocidad de respuesta es la limitación principal.
Anthropic también ha sido igual de productiva. Claude Opus 4.7 es la opción de gama alta actual para flujos de trabajo que requieren a la vez razonamiento profundo sobre código y entrada visual en un solo modelo. Para escribir, editar y tareas de desarrollo del día a día, Claude 4 Sonnet ofrece un buen equilibrio entre calidad de salida y velocidad de procesamiento que a la mayoría de los equipos le resultará práctico.
La familia Gemini de Google gana profundidad
Gemini 3.1 Pro de Google es el modelo multimodal destacado de la semana. Maneja documentos largos, imágenes y código dentro de una misma ventana de contexto, con una coherencia notablemente mejor que la de versiones anteriores. El más ligero Gemini 3 Flash sigue siendo la opción práctica para aplicaciones sensibles a la velocidad, donde importan más las respuestas en menos de un segundo que la precisión máxima.
DeepSeek sigue siendo relevante
El laboratorio chino DeepSeek se ha vuelto imposible de ignorar. DeepSeek R1 marcó un nuevo estándar para el razonamiento en cadena de pensamiento accesible, y DeepSeek v3.1 funciona en miles de entornos de producción para generar código y texto, igualando a alternativas propietarias en muchos benchmarks a una fracción del costo.
Grok 4 de xAI está llamando la atención en tareas que requieren razonamiento con datos en tiempo real, y Kimi K2 Thinking de Moonshotai ofrece resolución de problemas paso a paso que compite con los mejores modelos de frontera de pago. Kimi K2 Instruct completa la familia con sólidas capacidades de chat de propósito general.
💡 Si quieres probar varios de estos modelos sin cambiar de plataforma, PicassoIA los aloja todos en un mismo lugar, dentro de la sección Large Language Models.
El video de IA alcanza un nuevo techo
La generación de video es la historia más espectacular de la IA esta semana. La distancia entre el video generado por IA y la calidad de producción profesional se está reduciendo más rápido de lo que casi nadie esperaba. Varios modelos lanzados o actualizados esta semana producen resultados que hace apenas dieciocho meses se habrían considerado de primera categoría en un estudio de efectos visuales.
Veo 3.1 de Google marca un nuevo referente
Veo 3.1 de Google genera video en 1080p a partir de prompts de texto, con una coherencia de movimiento que supera a las iteraciones anteriores por un margen claro. La versión rápida, Veo 3.1 Fast, ofrece ese nivel de calidad sin tiempos de espera prolongados, lo que la hace útil en flujos de trabajo creativos iterativos, donde necesitas probar varios conceptos con rapidez. Como referencia, Veo 3, con su generación de audio nativa, sigue siendo una de las experiencias de video de un solo modelo más impresionantes disponibles este mes.
Kling v3 para trabajos cinematográficos
Kling v3 Video de Kwai está ganando tracción entre creadores de video que necesitan movimiento suave y cinematográfico, tanto a partir de prompts de texto como de imágenes estáticas. La variante complementaria Kling v3 Motion Control añade dirección de animación por personaje con una precisión que no era posible en versiones anteriores. Para equipos de producción con necesidades de entrega más rápidas, Kling v2.6 y Kling v2.6 Motion Control siguen siendo opciones sólidas de gama media.
Wan 2.7 impulsa aún más el video de pesos abiertos
El modelo Wan 2.7 T2V convierte texto directamente en video de 1080p con un seguimiento constante del sujeto a lo largo de los fotogramas. Wan 2.7 I2V anima imágenes fijas con una estabilidad temporal impresionante, lo que lo hace especialmente útil para la fotografía de producto y la animación de retratos. La variante complementaria Wan 2.7 R2V extiende estas capacidades a animaciones guiadas por sujetos.
Seedance 2.0 de ByteDance añade audio nativo a los videos generados, lo que elimina la necesidad de posproducción de audio por separado en muchos flujos de trabajo de contenido de formato corto. Seedance 2.0 Fast ofrece resultados similares a mayor velocidad para equipos que priorizan el rendimiento sobre la calidad máxima de salida.
Para salida en 4K, LTX 2.3 Pro de Lightricks es la opción más sólida disponible esta semana. Pixverse v5.6 sigue siendo popular para clips rápidos listos para redes sociales, y Hailuo 2.3 de Minimax llegó con mejoras notables en la calidad del movimiento cinematográfico. Sora 2 Pro de OpenAI también sigue atrayendo atención para trabajos de texto a video de alta fidelidad.
Lo que realmente cambió en el video de IA esta semana:
- El audio nativo ya es estándar en los modelos líderes, no un complemento de pago
- La resolución 4K es accesible sin precios de nivel empresarial
- Los flujos de imagen a video son más coherentes en el tiempo, con menos artefactos entre fotogramas
- El control de movimiento ahora permite dirigir por personaje y por fotograma en varios modelos
💡 Todos los modelos de video mencionados arriba están disponibles en PicassoIA, lo que te permite comparar resultados entre modelos sin suscripciones independientes ni configuración de API.
Generación de imágenes con IA en abril de 2026
La generación de imágenes ya superó la pregunta de "¿es real?". El desafío actual es el control, la coherencia y lo preciso que un modelo sigue los prompts creativos matizados, sobre todo en escenas complejas con varios sujetos o en estilos visuales específicos de una marca.
Lo que a la industria creativa le importa ahora
La categoría de texto a imagen de PicassoIA aloja más de 91 modelos, y la plataforma sigue sumando los lanzamientos más recientes a medida que salen. El foco de esta semana se ha desplazado hacia la fidelidad al prompt y la coherencia de estilo en una serie de resultados, más que hacia la calidad de una sola imagen.
Lo que los equipos creativos están priorizando ahora mismo:
- Salida fotorrealista para flujos de trabajo de marketing y visualización de productos
- Apariencia de personaje coherente entre varias generaciones dentro de un mismo proyecto
- Replicación de estilo a partir de imágenes de referencia con una pérdida mínima de calidad
- Salidas de alta resolución sin artefactos de escalado en las zonas de detalle fino
Los enfoques basados en ControlNet siguen siendo el estándar de la industria para los equipos que necesitan controlar tanto la estructura de la imagen como su estilo visual. El control de pose, la detección de bordes y el condicionamiento por mapas de profundidad dan a los equipos de producción la precisión necesaria para generar exactamente lo que dibujan o toman como referencia, en lugar de depender por completo de cómo interpreta el modelo un prompt de texto.
La combinación de modelos base sólidos y la precisión de ControlNet significa que la generación de imágenes en 2026 ya no es una lotería. Los equipos que invierten tiempo en la estructura de los prompts y en flujos de trabajo con referencias están produciendo recursos visuales coherentes y alineados con la marca, a un ritmo que hace apenas dos años simplemente no era posible.
Modelos de razonamiento que de verdad piensan
La categoría de "modelos de razonamiento" ya no es un interés de nicho. Se está convirtiendo en la expectativa por defecto para cualquier modelo que se use en flujos de trabajo donde la precisión importa más que la velocidad de respuesta.
Por qué el razonamiento importa en 2026
Los modelos de lenguaje estándar predicen el siguiente token a partir del contexto previo. Los modelos de razonamiento resuelven un problema paso a paso antes de producir su salida final. La diferencia práctica es considerable: un modelo de razonamiento es mucho menos propenso a dar una respuesta segura pero equivocada en un problema de lógica o matemáticas.
GPT-5 Pro tiene el pensamiento extendido integrado y activado por defecto. Kimi K2 Thinking aplica el mismo enfoque y es de acceso gratuito. DeepSeek R1 abrió el camino del razonamiento con pesos abiertos, y su influencia se nota en casi todos los nuevos lanzamientos con capacidad de razonamiento de este mes. O4 Mini de OpenAI completa las opciones para equipos que necesitan razonamiento rápido y asequible para tareas lógicas del día a día.
Tres flujos de trabajo en los que los modelos de razonamiento superan a los LLM estándar:
- Matemáticas de varios pasos y problemas cuantitativos, donde los errores intermedios se acumulan y dan respuestas finales equivocadas
- Análisis legal y de contratos, donde la precisión importa más que la fluidez o la velocidad
- Depuración de código, donde el modelo necesita seguir las rutas de ejecución en lugar de adivinar las posibles correcciones
💡 Si tu flujo de trabajo actual usa un LLM estándar para tareas que implican lógica secuencial, cambiar a DeepSeek R1 o Kimi K2 Thinking puede reducir la tasa de errores sin tener que modificar tu estructura de prompts actual.
Llama 4 y el impulso del código abierto
Llama 4 Maverick Instruct y Llama 4 Scout Instruct, de Meta, siguen redefiniendo cómo es la IA de pesos abiertos en producción. Ambos modelos manejan chat, resúmenes, tareas con documentos largos y generación de código con un rendimiento que se acerca mucho al de alternativas propietarias, a una fracción del costo de despliegue.
Para equipos con requisitos de privacidad de datos, restricciones presupuestarias o preferencia por una infraestructura alojada por ellos mismos, la inversión continua de Meta en modelos de pesos abiertos es uno de los avances más significativos de este mes en la práctica. El techo de calidad de los modelos abiertos ha subido de forma notable, y la distancia entre los modelos abiertos y los de pesos cerrados es hoy más estrecha que nunca.
El ecosistema abierto en general también se beneficia de esto. Con Meta Llama 3.1 405B Instruct todavía ampliamente usado en producción y Llama 4 ya disponible, los equipos tienen una ruta de actualización clara dentro de los pesos abiertos que no obliga a cambiar a una API propietaria.
La IA de audio y voz da un paso adelante
La generación de audio tuvo una semana más discreta en cuanto a anuncios destacados, pero las capacidades que se están consolidando y lanzando merecen un seguimiento atento para cualquiera que trabaje en producción de contenido.
El texto a voz suena más humano
La generación actual de modelos de texto a voz produce resultados que son difíciles de distinguir de una voz humana en condiciones de escucha controladas. La variación de tono, el ritmo natural y los matices emocionales mejoran con cada iteración del modelo. Para los creadores de contenido que dependen de locuciones con guion, el umbral de calidad de la narración con IA ha entrado en un terreno realmente útil para la mayoría de los tipos de video, incluidos los explicativos de larga duración y las demostraciones de producto.
Voz a texto con una precisión casi perfecta
En cuanto a la transcripción, los modelos de voz a texto funcionan ahora con niveles de precisión que eliminan la necesidad de una corrección manual significativa en la mayoría de los entornos de grabación habituales. El audio limpio con un solo hablante suele producir transcripciones que requieren muy poca edición antes de publicarse o procesarse más adelante.
Generación de música con IA para equipos de producción
La generación de música con IA se ha convertido en una herramienta práctica para equipos de contenido que necesitan música de fondo, variaciones de jingles o bandas sonoras temáticas bajo demanda. Describir el estado de ánimo, el tempo y la instrumentación deseados mediante un prompt de texto y recibir un resultado pulido en menos de un minuto está cambiando la forma de trabajar de los equipos de producción más pequeños, sobre todo en video para redes sociales, contenido de marca y producción de podcasts.
La superresolución se vuelve más nítida
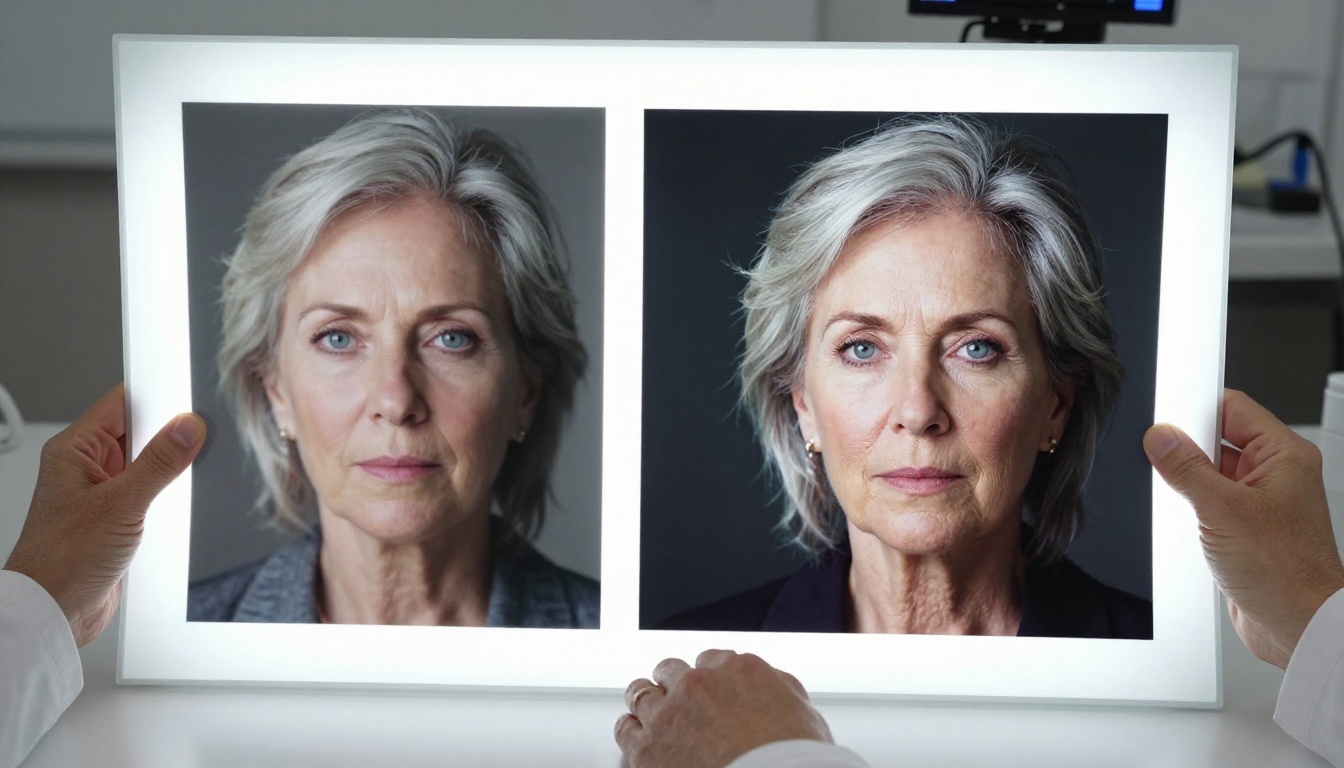
El escalado de imágenes siempre ha sido una de las aplicaciones de IA más prácticas y de uso inmediato, y las novedades de esta semana refuerzan por qué sigue siendo una de las funciones más usadas en PicassoIA.
Los mejores upscalers disponibles ahora mismo
Real ESRGAN sigue siendo la opción gratuita de referencia para escalar fotos a 4 veces su resolución original, con una conservación fiable del detalle general. Para retratos en concreto, Crystal Upscaler produce una textura de piel y un detalle facial notablemente mejores a escala 4x que los modelos de propósito general. Para el techo de calidad más alto, sea cual sea el tipo de sujeto, Image Upscale by Topaz Labs escala hasta 6x manteniendo una nitidez de bordes que los modelos competidores tienden a suavizar. Recraft Crisp Upscale es la opción más sólida para contenido gráfico e ilustraciones, donde importan más los bordes limpios que la simulación de textura fotorrealista.
💡 Si generas imágenes a 512 px o 768 px para ganar velocidad, pasarlas después por Real ESRGAN o Crystal Upscaler produce resultados comparables a una generación nativa en alta resolución en la mayoría de los casos prácticos.
Por qué los lanzamientos de esta semana sí importan
El volumen de lanzamientos de IA ha sido constantemente alto durante meses, pero las novedades de esta semana destacan de una forma concreta: representan una convergencia. Varias modalidades, desde texto hasta video, audio y procesamiento de imagen, están alcanzando al mismo tiempo umbrales de calidad profesional. La barrera para construir flujos de trabajo creativos completos impulsados por IA es más baja que nunca.
Para un desarrollador, un creador o un equipo de negocio, la implicación práctica es esta: las herramientas para producir contenido de nivel profesional a escala ya caben dentro de una sola plataforma accesible, sin una infraestructura técnica profunda ni un equipo numeroso.
Lo que realmente cambió esta semana para los usuarios del día a día:
- Ya no necesitas plataformas especializadas distintas para generar video, crear imágenes y producir audio
- Los modelos de razonamiento ahora son accesibles sin pagar los niveles de API más caros del mercado
- Los modelos de pesos abiertos como Llama 4 y DeepSeek hacen que la IA de calidad empresarial ya no esté reservada a suscripciones de pago elevadas
- El audio nativo en los modelos de video elimina un paso de producción que antes requería herramientas de audio dedicadas y tiempo de posproducción
La combinación de modelos abiertos más sólidos, capacidades nativas multimodales y costos de acceso más bajos significa que 2026 es el año en que la producción impulsada por IA se vuelve una realidad práctica para equipos de cualquier tamaño, no solo para quienes cuentan con grandes presupuestos o infraestructura técnica dedicada.
Pon estas herramientas a trabajar tú mismo
Cada modelo analizado en este artículo está disponible en PicassoIA sin que tengas que gestionar credenciales de API, registrarte en varias plataformas independientes ni configurar tu propia infraestructura en la nube. La plataforma reúne los LLM más recientes, generadores de video, herramientas de imagen y upscalers en un solo lugar, sin necesidad de cambiar de herramienta.
Si quieres poner en práctica las novedades de IA de esta semana de inmediato, esto es por dónde empezar:
La pregunta en 2026 no es si la IA puede encargarse de trabajo creativo profesional. Ya puede. La pregunta es con qué rapidez empiezas a integrar estas herramientas en tu propio flujo de trabajo y a ver los resultados por ti mismo.


