Avril 2026 s’annonce comme l’une des périodes les plus actives de l’histoire de l’IA. En seulement sept jours, plusieurs laboratoires ont publié des mises à jour majeures de modèles, la génération de vidéos a franchi un nouveau seuil de réalisme, et plusieurs outils qui paraissaient encore expérimentaux semblent désormais réellement prêts pour la production. Si vous essayez de suivre l’actualité de l’IA, voici le bilan de la semaine, avec l’essentiel séparé du bruit.
La course aux LLM ne ralentit pas
La catégorie des grands modèles de langage est devenue sensiblement plus concurrentielle cette semaine. Le GPT-5 d’OpenAI continue d’occuper la première place parmi les modèles polyvalents les plus déployés, mais la vraie dynamique se trouve dans les versions qui l’entourent. GPT-5 Pro intègre une réflexion étendue native pour les tâches complexes en plusieurs étapes. GPT-5 Mini génère du texte instantanément avec une latence nettement plus faible, et GPT-5 Nano vise les applications temps réel en périphérie du réseau, où la rapidité de réponse est la contrainte principale.
Anthropic a été tout aussi productif. Claude Opus 4.7 est actuellement l’option haut de gamme pour les flux de travail qui exigent à la fois un raisonnement approfondi sur le code et une entrée visuelle dans un seul modèle. Pour l’écriture, la rédaction et les tâches de développement courantes, Claude 4 Sonnet offre un bon équilibre entre qualité de sortie et vitesse de traitement, que la plupart des équipes trouveront pratique.
La famille Gemini de Google gagne en profondeur
Le Gemini 3.1 Pro de Google est le modèle multimodal phare de la semaine. Il traite les longs documents, les images et le code dans une même fenêtre de contexte, avec une cohérence nettement meilleure que les versions précédentes. Le Gemini 3 Flash, plus léger, reste le choix pratique pour les applications sensibles à la vitesse, où des réponses en moins d’une seconde comptent davantage que la précision maximale.
DeepSeek reste pertinent
Le laboratoire chinois DeepSeek est devenu impossible à ignorer. DeepSeek R1 a fixé une nouvelle référence pour le raisonnement en chaîne de pensée accessible, et DeepSeek v3.1 tourne dans des milliers d’environnements de production pour la génération de code et de texte, rivalisant avec les alternatives propriétaires sur de nombreux benchmarks, à une fraction du coût.
Le Grok 4 de xAI attire l’attention pour les tâches qui exigent un raisonnement sur des données en temps réel, et le Kimi K2 Thinking de Moonshotai propose une résolution de problèmes étape par étape qui rivalise avec les meilleurs modèles de pointe payants. Kimi K2 Instruct complète la famille avec de solides capacités de conversation généraliste.
| Modèle | Idéal pour | Vitesse relative |
|---|
| GPT-5 | Tâches générales, large éventail de capacités | Rapide |
| Claude Opus 4.7 | Code, vision, long contexte | Modérée |
| Gemini 3.1 Pro | Multimodal, travail sur documents | Rapide |
| DeepSeek R1 | Raisonnement, mathématiques, logique | Modérée |
| Grok 4 | Tâches sur données en temps réel | Rapide |
| Kimi K2 Thinking | Problèmes étape par étape | Modérée |
💡 Si vous voulez tester plusieurs de ces modèles sans changer de plateforme, PicassoIA les héberge tous au même endroit, dans la section Large Language Models.
La vidéo atteint un nouveau plafond
La génération de vidéos est l’histoire la plus marquante de l’IA cette semaine. L’écart entre la vidéo générée par IA et la qualité de production professionnelle se réduit plus vite que presque tout le monde ne l’imaginait. Plusieurs modèles sortis ou mis à jour cette semaine produisent des résultats qui auraient été considérés comme haut de gamme dans un studio d’effets visuels il y a seulement dix-huit mois.
Veo 3.1 de Google fixe une nouvelle référence
Veo 3.1 de Google génère de la vidéo en 1080p à partir de prompts textuels, avec une cohérence du mouvement qui surpasse nettement les itérations précédentes. La variante rapide, Veo 3.1 Fast, offre ce niveau de qualité sans longs temps d’attente, ce qui la rend utilisable dans des flux de travail créatifs itératifs où il faut tester rapidement plusieurs concepts. Pour mémoire, Veo 3, avec sa génération audio native, reste l’une des expériences vidéo mono-modèle les plus impressionnantes disponibles ce mois-ci.
Kling v3 pour le travail cinématographique
Kling v3 Video de Kwai gagne du terrain auprès des créateurs vidéo qui ont besoin d’un mouvement fluide et cinématographique, à partir de prompts textuels comme d’images fixes. La variante complémentaire Kling v3 Motion Control ajoute une direction d’animation par personnage avec une précision qui n’était pas possible dans les versions précédentes. Pour les équipes de production qui ont besoin de délais plus courts, Kling v2.6 et Kling v2.6 Motion Control restent de solides options de milieu de gamme.
Wan 2.7 pousse plus loin la vidéo à poids ouverts
Le modèle Wan 2.7 T2V transforme directement le texte en vidéo 1080p, avec un suivi cohérent des sujets d’une image à l’autre. Wan 2.7 I2V anime des images fixes avec une stabilité temporelle impressionnante, ce qui le rend particulièrement utile pour la photographie de produits et l’animation de portraits. La variante complémentaire Wan 2.7 R2V étend ces capacités aux animations pilotées par le sujet.
Seedance 2.0 de ByteDance ajoute un son natif aux vidéos générées, ce qui supprime le besoin d’une post-production audio séparée dans de nombreux flux de travail de contenus courts. Seedance 2.0 Fast offre des résultats similaires à plus grande vitesse, pour les équipes qui privilégient le débit à la qualité maximale de sortie.
Pour une sortie en 4K, LTX 2.3 Pro de Lightricks est la meilleure option disponible cette semaine. Pixverse v5.6 reste populaire pour les clips rapides prêts pour les réseaux sociaux, et Hailuo 2.3 de Minimax a été livré avec des améliorations notables dans la qualité des mouvements cinématographiques. Le Sora 2 Pro d’OpenAI continue lui aussi d’attirer l’attention pour la génération de vidéos haute fidélité à partir de prompts.
Ce qui a réellement changé dans la vidéo IA cette semaine :
- Le son natif est désormais standard dans les modèles de référence, et non plus une option payante
- La résolution 4K est accessible sans tarification réservée aux entreprises
- Les pipelines image vers vidéo sont plus cohérents dans le temps, avec moins d’artefacts entre les images
- Le contrôle du mouvement permet désormais, dans plusieurs modèles, de diriger chaque personnage et chaque image
💡 Tous les modèles vidéo mentionnés ci-dessus sont disponibles sur PicassoIA, ce qui vous permet de comparer les résultats entre modèles sans abonnements séparés ni configuration d’API.
La génération d’images en avril 2026
La génération d’images a dépassé la question « est-ce réel ? ». Le défi actuel porte sur le contrôle, la cohérence et la précision avec laquelle un modèle suit des prompts créatifs nuancés, en particulier pour les scènes complexes à plusieurs sujets ou les styles visuels propres à une marque.
Ce qui intéresse aujourd’hui l’industrie créative
La catégorie texte vers image de PicassoIA héberge plus de 91 modèles, et la plateforme ajoute les dernières sorties au fur et à mesure. Cette semaine, l’accent s’est déplacé vers le respect du prompt et la cohérence du style sur une série de résultats, plutôt que vers la seule qualité d’une image isolée.
Ce que les équipes créatives privilégient en ce moment :
- Un rendu photoréaliste pour les flux de travail de marketing et de visualisation de produits
- Une apparence constante des personnages sur plusieurs générations au sein d’un même projet
- La reproduction de style à partir d’images de référence, avec une dégradation minimale de la qualité
- Des sorties en haute résolution sans artefacts d’upscaling dans les zones de détails fins
Les approches basées sur ControlNet restent la norme du secteur pour les équipes qui ont besoin de contrôler la structure de l’image autant que son style visuel. Le contrôle de la pose, la détection des contours et le conditionnement par carte de profondeur donnent aux équipes de production la précision nécessaire pour générer exactement ce qu’elles esquissent ou ce qu’elles prennent comme référence, au lieu de dépendre entièrement de la façon dont le modèle interprète un prompt textuel.
La combinaison de modèles de base solides et de la précision de ControlNet fait que la génération d’images en 2026 n’est plus une loterie. Les équipes qui consacrent du temps à la structure des prompts et aux flux de travail à partir de références produisent des visuels cohérents et alignés sur la marque, à un rythme qui était tout simplement impossible il y a deux ans.
Des modèles de raisonnement qui réfléchissent vraiment
La catégorie des « modèles de raisonnement » n’est plus un intérêt de niche. Elle devient l’attente par défaut pour tout modèle utilisé dans des flux de travail où la précision compte davantage que la vitesse de réponse.
Pourquoi le raisonnement compte en 2026
Les modèles de langage classiques prédisent le prochain token à partir du contexte précédent. Les modèles de raisonnement résolvent un problème étape par étape avant de produire leur résultat final. La différence pratique est importante : un modèle de raisonnement est bien moins susceptible de donner une réponse fausse mais affirmée à un problème de logique ou de mathématiques.
GPT-5 Pro intègre une réflexion étendue activée par défaut. Kimi K2 Thinking applique la même approche et son accès est gratuit. DeepSeek R1 a ouvert la voie au raisonnement à poids ouverts, et son influence se retrouve dans presque toutes les nouvelles sorties dotées de raisonnement de ce mois-ci. Le O4 Mini d’OpenAI complète les options pour les équipes qui ont besoin d’un raisonnement rapide et abordable pour les tâches de logique courantes.
Trois flux de travail où les modèles de raisonnement surpassent les LLM classiques :
- Les calculs mathématiques et quantitatifs en plusieurs étapes, où les erreurs intermédiaires s’accumulent et faussent le résultat final
- L’analyse juridique et contractuelle, où la précision compte davantage que l’aisance ou la vitesse
- Le débogage de code, où le modèle doit suivre les chemins d’exécution au lieu de deviner les corrections probables
💡 Si votre flux de travail actuel utilise un LLM classique pour des tâches de logique séquentielle, passer à DeepSeek R1 ou à Kimi K2 Thinking peut réduire le taux d’erreur sans modifier votre structure de prompts existante.
Llama 4 et la dynamique open source
Llama 4 Maverick Instruct et Llama 4 Scout Instruct, de Meta, continuent de redéfinir ce à quoi ressemble l’IA à poids ouverts en production. Les deux modèles gèrent la conversation, la synthèse, les tâches sur longs documents et la génération de code avec des performances qui suivent de près les alternatives propriétaires, pour une fraction du coût de déploiement.
Pour les équipes soumises à des exigences de confidentialité des données, à des contraintes budgétaires ou qui préfèrent une infrastructure auto-hébergée, l’investissement continu de Meta dans les modèles à poids ouverts est l’un des développements les plus importants de ce mois-ci. Le plafond de qualité des modèles ouverts a fortement progressé, et l’écart entre les modèles ouverts et les modèles fermés n’a jamais été aussi faible.
L’écosystème open source plus large en profite aussi. Comme Meta Llama 3.1 405B Instruct est toujours largement utilisé en production et que Llama 4 est désormais disponible, les équipes disposent d’une voie de mise à niveau claire à poids ouverts, sans avoir à passer à une API propriétaire.
L’audio et la synthèse vocale franchissent un cap
La génération audio a connu une semaine plus discrète en matière d’annonces phares, mais les capacités consolidées et mises en service méritent un suivi attentif pour quiconque travaille dans la production de contenus.
La synthèse vocale gagne en naturel
La génération actuelle de modèles de synthèse vocale produit des résultats difficiles à distinguer d’une voix humaine dans des conditions d’écoute contrôlées. La variation de ton, le rythme naturel et la nuance émotionnelle progressent à chaque itération. Pour les créateurs de contenus qui s’appuient sur des voix off scénarisées, le seuil de qualité de la narration par IA est désormais franchi, la rendant réellement exploitable pour la plupart des types de vidéos, y compris les explications longues et les démonstrations de produits.
La transcription vocale d’une précision quasi parfaite
Côté transcription, les modèles de reconnaissance vocale atteignent désormais des niveaux de précision qui suppriment le besoin de corrections manuelles importantes dans la plupart des environnements d’enregistrement standards. Un audio propre avec un seul locuteur produit généralement des transcriptions qui demandent très peu de retouches avant publication ou traitement en aval.
La génération de musique par IA pour les équipes de production
La génération de musique par IA est devenue un outil pratique pour les équipes de contenus qui ont besoin de musiques de fond, de variations de jingles ou de compositions thématiques à la demande. Décrire une ambiance, un tempo et une instrumentation souhaités dans un prompt textuel, et recevoir un résultat soigné en moins d’une minute, transforme la façon de travailler des petites équipes de production, en particulier dans la vidéo sociale, le contenu de marque et la production de podcasts.
La super-résolution gagne en netteté
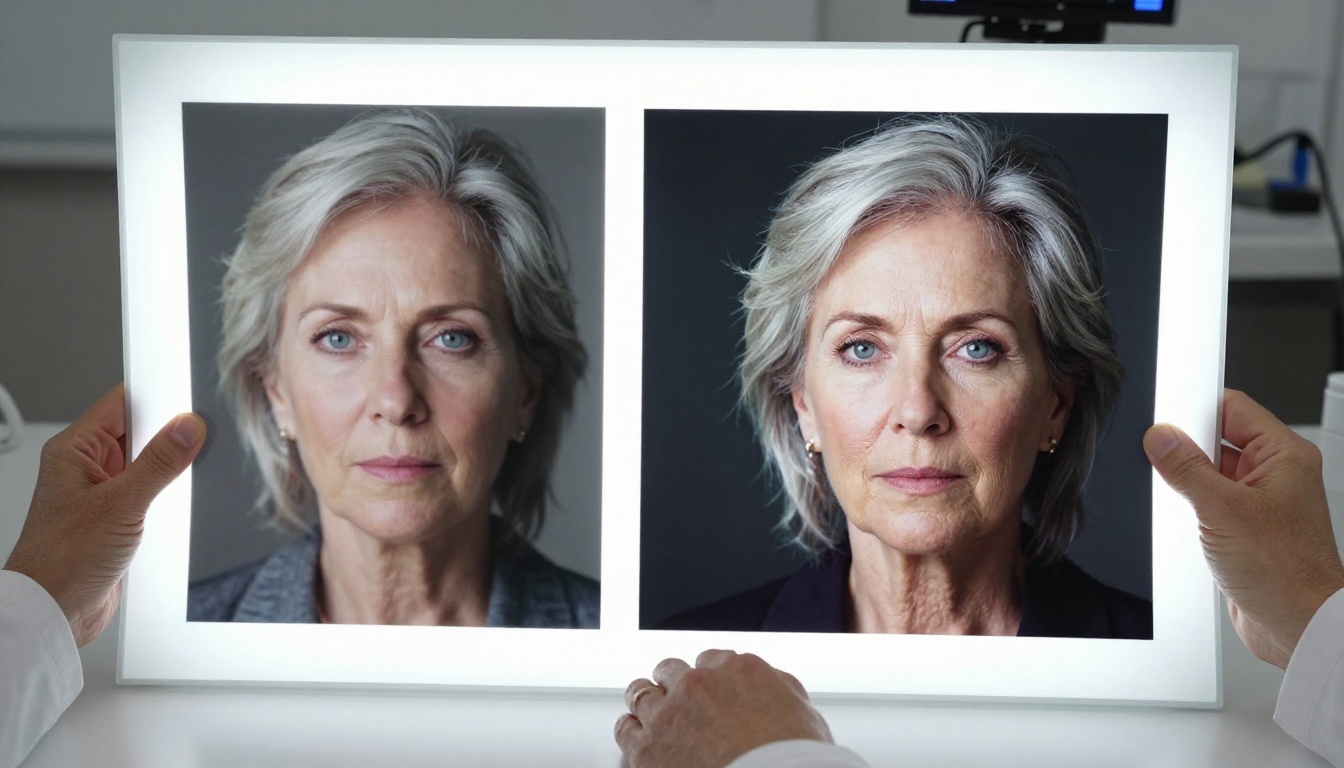
L’augmentation de la résolution d’image a toujours été l’une des applications de l’IA les plus immédiatement utiles, et les mises à jour de cette semaine confirment pourquoi elle reste l’une des fonctions les plus utilisées sur PicassoIA.
Les meilleurs upscalers disponibles dès maintenant
Real ESRGAN reste l’option gratuite de référence pour agrandir des photos à 4 fois leur résolution d’origine, avec une bonne conservation des détails généraux. Pour les portraits en particulier, Crystal Upscaler produit une texture de peau et des détails du visage nettement meilleurs à l’échelle 4x, par rapport aux modèles généralistes. Pour le plafond de qualité le plus élevé, quel que soit le sujet, Image Upscale by Topaz Labs monte jusqu’à 6x tout en conservant une netteté des contours que les modèles concurrents ont tendance à adoucir. Recraft Crisp Upscale est le meilleur choix pour les contenus graphiques et les illustrations, où des contours nets comptent davantage que la simulation d’une texture photoréaliste.
💡 Si vous générez des images en 512 px ou 768 px pour gagner du temps, les passer ensuite dans Real ESRGAN ou Crystal Upscaler donne des résultats comparables à une génération en haute résolution native dans la plupart des cas d’usage concrets.
Pourquoi les sorties de cette semaine comptent vraiment
Le volume des sorties IA est élevé de façon constante depuis des mois, mais les mises à jour de cette semaine se distinguent sur un point précis : elles marquent une convergence. Plusieurs modalités, du texte à la vidéo en passant par l’audio et le traitement d’images, atteignent simultanément des seuils de qualité professionnelle. Les obstacles à la création de flux de travail créatifs complets reposant sur l’IA n’ont jamais été aussi bas.
Pour un développeur, un créateur ou une équipe d’entreprise, la conséquence concrète est la suivante : les outils permettant de produire des contenus de qualité professionnelle à grande échelle tiennent désormais dans une seule plateforme accessible, sans infrastructure technique lourde ni grande équipe.
Ce qui a réellement changé pour les utilisateurs au quotidien cette semaine :
- Vous n’avez plus besoin de plateformes spécialisées distinctes pour la génération de vidéos, la création d’images et la production audio
- Les modèles de raisonnement sont désormais accessibles sans payer les formules API les plus coûteuses du marché
- Les modèles à poids ouverts comme Llama 4 et DeepSeek font que l’IA de qualité entreprise n’est plus réservée aux abonnements premium
- Le son natif dans les modèles vidéo supprime une étape de production qui exigeait auparavant des outils audio dédiés et du temps de post-production
La combinaison de modèles ouverts plus performants, de capacités multimodales natives et de coûts d’accès plus bas fait de 2026 l’année où la production assistée par IA devient une réalité concrète pour les équipes de toutes tailles, et pas seulement pour celles disposant de gros budgets ou d’une infrastructure technique dédiée.
Mettez ces outils en pratique vous-même
Chaque modèle évoqué dans cet article est accessible sur PicassoIA, sans gérer d’identifiants d’API, sans vous inscrire à plusieurs plateformes distinctes et sans configurer votre propre infrastructure cloud. La plateforme réunit les derniers LLM, générateurs de vidéos, outils d’image et upscalers au même endroit, sans avoir à changer d’outil.
Si vous voulez mettre immédiatement en pratique les sorties IA de cette semaine, voici par où commencer :
La question en 2026 n’est pas de savoir si l’IA peut prendre en charge un travail créatif professionnel. Elle en est déjà capable. La question est de savoir à quelle vitesse vous commencerez à intégrer ces outils dans votre propre flux de travail et à en voir les résultats par vous-même.


