अप्रैल 2026 AI के इतिहास के सबसे सक्रिय दौरों में से एक बनता दिख रहा है। सिर्फ़ सात दिनों में कई लैब्स ने बड़े मॉडल अपडेट जारी किए, वीडियो जनरेशन ने यथार्थवाद का एक नया स्तर छुआ, और कुछ टूल, जो पहले प्रयोगात्मक लगते थे, अब सच में प्रोडक्शन के लिए तैयार लगते हैं। अगर आप AI की खबरों से अपडेट रहने की कोशिश कर रहे हैं, तो यह इस हफ़्ते का ब्योरा है, जिसमें काम की बात को शोर से अलग करके रखा गया है।
LLM की दौड़ धीमी नहीं पड़ रही
लार्ज लैंग्वेज मॉडल की श्रेणी इस हफ़्ते उल्लेखनीय रूप से ज़्यादा प्रतिस्पर्धी हो गई। OpenAI का GPT-5 अब भी सबसे व्यापक रूप से इस्तेमाल होने वाला जनरल-पर्पस मॉडल बना हुआ है, लेकिन असली रफ़्तार इसके आसपास के वर्ज़न्स में है। GPT-5 Pro जटिल, बहु-चरणीय कामों के लिए बिल्ट-इन एक्सटेंडेड थिंकिंग के साथ आता है। GPT-5 Mini काफ़ी कम लेटेंसी पर तुरंत टेक्स्ट जनरेट करता है, और GPT-5 Nano रीयल-टाइम एज एप्लिकेशन को निशाना बनाता है, जहाँ रिस्पॉन्स की गति सबसे बड़ी बाधा है।
Anthropic भी उतना ही सक्रिय रहा है। Claude Opus 4.7 उन वर्कफ़्लो के लिए मौजूदा शीर्ष विकल्प है जिन्हें एक ही मॉडल में गहरी कोड रीज़निंग और विज़ुअल इनपुट, दोनों चाहिए। लिखने, एडिट करने और रोज़मर्रा के डेवलपमेंट कामों के लिए, Claude 4 Sonnet आउटपुट क्वालिटी और प्रोसेसिंग स्पीड का मज़बूत संतुलन देता है, जो ज़्यादातर टीमों को व्यावहारिक लगेगा।
Google का Gemini परिवार और गहराई जोड़ता है
Google का Gemini 3.1 Pro इस हफ़्ते का सबसे अलग दिखने वाला मल्टीमोडल मॉडल है। यह लंबे दस्तावेज़ों, इमेज और कोड को एक ही कॉन्टेक्स्ट विंडो में संभालता है, और पिछले वर्ज़न्स की तुलना में इसकी कोहेरेंस काफ़ी बेहतर है। हल्का Gemini 3 Flash उन स्पीड-संवेदनशील एप्लिकेशन के लिए व्यावहारिक विकल्प बना हुआ है, जहाँ अधिकतम सटीकता से ज़्यादा ज़रूरी यह है कि रिस्पॉन्स एक सेकंड से कम में आए।
DeepSeek प्रासंगिक बना हुआ है
चीनी AI लैब DeepSeek को अब नज़रअंदाज़ करना नामुमकिन हो गया है। DeepSeek R1 ने सुलभ चेन-ऑफ़-थॉट रीज़निंग के लिए नया मानक तय किया, और DeepSeek v3.1 कोड और टेक्स्ट जनरेशन के लिए हज़ारों प्रोडक्शन एनवायरनमेंट में चल रहा है। यह कई बेंचमार्क पर मालिकाना विकल्पों के बराबर है, और लागत उसके एक हिस्से जितनी है।
xAI का Grok 4 उन कामों के लिए चर्चा में है जिनमें रीयल-टाइम डेटा पर रीज़निंग चाहिए, और Moonshotai का Kimi K2 Thinking स्टेप-बाय-स्टेप समस्या-समाधान देता है, जो सबसे अच्छे पेड फ़्रंटियर मॉडल्स से मुकाबला करता है। Kimi K2 Instruct मज़बूत जनरल-पर्पस चैट क्षमताओं के साथ इस परिवार को पूरा करता है।
💡 अगर आप प्लेटफ़ॉर्म बदले बिना इनमें से कई मॉडल आज़माना चाहते हैं, तो PicassoIA इन सभी को Large Language Models सेक्शन में एक ही जगह होस्ट करता है।
AI वीडियो ने नई ऊँचाई छुई
इस हफ़्ते AI की सबसे नाटकीय कहानी वीडियो जनरेशन की है। AI से बने वीडियो और प्रोफ़ेशनल प्रोडक्शन क्वालिटी के बीच का फ़ासला उम्मीद से कहीं तेज़ी से घट रहा है। इस हफ़्ते जारी हुए या अपडेट हुए कई मॉडल ऐसा आउटपुट देते हैं, जिसे अठारह महीने पहले तक किसी विज़ुअल इफ़ेक्ट्स स्टूडियो का सर्वश्रेष्ठ काम माना जाता।
Google Veo 3.1 नया बेंचमार्क तय करता है
Google का Veo 3.1 टेक्स्ट प्रॉम्प्ट से 1080p वीडियो बना रहा है, जिसकी मोशन कोहेरेंस पिछले वर्ज़न्स से साफ़ अंतर से बेहतर है। इसका फ़ास्ट वर्ज़न, Veo 3.1 Fast, बिना लंबे इंतज़ार के वही क्वालिटी देता है, जिससे यह उन इटरेटिव क्रिएटिव वर्कफ़्लो में काम आता है जहाँ कई कॉन्सेप्ट जल्दी टेस्ट करने होते हैं। तुलना के लिए, Veo 3 अपने नेटिव ऑडियो जनरेशन के साथ इस महीने उपलब्ध सबसे प्रभावशाली सिंगल-मॉडल वीडियो अनुभवों में से एक बना हुआ है।
सिनेमैटिक काम के लिए Kling v3
Kwai का Kling v3 Video उन वीडियो क्रिएटर्स में लोकप्रिय हो रहा है जिन्हें टेक्स्ट प्रॉम्प्ट और स्टैटिक इमेज, दोनों से स्मूथ, सिनेमैटिक मोशन चाहिए। साथी वर्ज़न Kling v3 Motion Control हर कैरेक्टर के लिए एनिमेशन डायरेक्शन जोड़ता है, और उस स्तर की सटीकता के साथ जो पिछले वर्ज़न्स में संभव नहीं थी। जिन प्रोडक्शन टीमों को तेज़ टर्नअराउंड चाहिए, उनके लिए Kling v2.6 और Kling v2.6 Motion Control मज़बूत मिड-टियर विकल्प बने हुए हैं।
Wan 2.7 ओपन-वेट वीडियो को और आगे ले जाता है
Wan 2.7 T2V सीधे टेक्स्ट को 1080p वीडियो में बदलता है, और फ़्रेम-दर-फ़्रेम सब्जेक्ट को लगातार ट्रैक करता है। Wan 2.7 I2V स्टिल इमेज को प्रभावशाली टेम्पोरल स्टेबिलिटी के साथ एनिमेट करता है, जिससे यह प्रोडक्ट फ़ोटोग्राफ़ी और पोर्ट्रेट एनिमेशन के लिए खास तौर पर उपयोगी है। साथी Wan 2.7 R2V इन क्षमताओं को सब्जेक्ट-ड्रिवन एनिमेशन तक ले जाता है।
ByteDance का Seedance 2.0 वीडियो आउटपुट में नेटिव ऑडियो जोड़ता है, जिससे कई शॉर्ट-फ़ॉर्म कंटेंट वर्कफ़्लो में अलग ऑडियो पोस्ट-प्रोडक्शन की ज़रूरत नहीं रहती। Seedance 2.0 Fast तेज़ गति पर मिलते-जुलते नतीजे देता है, उन टीमों के लिए जो अधिकतम आउटपुट क्वालिटी से ज़्यादा थ्रूपुट को प्राथमिकता देती हैं।
4K आउटपुट के लिए, Lightricks का LTX 2.3 Pro इस हफ़्ते उपलब्ध सबसे मज़बूत विकल्प है। Pixverse v5.6 तेज़, सोशल-रेडी क्लिप्स के लिए लोकप्रिय बना हुआ है, और Minimax का Hailuo 2.3 सिनेमैटिक मूवमेंट की क्वालिटी में उल्लेखनीय सुधार के साथ आया। OpenAI का Sora 2 Pro भी हाई-फ़िडेलिटी प्रॉम्प्ट-टू-वीडियो काम के लिए ध्यान खींचता रहता है।
इस हफ़्ते AI वीडियो में असल में क्या बदला:
- नेटिव ऑडियो अब प्रमुख मॉडल्स में मानक है, प्रीमियम ऐड-ऑन नहीं
- 4K रेज़ोल्यूशन एंटरप्राइज़-टियर कीमत के बिना उपलब्ध है
- इमेज-टू-वीडियो पाइपलाइन फ़्रेम्स के बीच कम आर्टिफ़ैक्ट्स के साथ टेम्पोरली ज़्यादा कंसिस्टेंट हैं
- मोशन कंट्रोल अब कई मॉडल्स में हर कैरेक्टर और हर फ़्रेम के लिए डायरेक्शन देता है
💡 ऊपर बताए गए सभी वीडियो मॉडल PicassoIA पर उपलब्ध हैं, जिससे आप अलग सब्सक्रिप्शन या API सेटअप के बिना मॉडल्स के आउटपुट की तुलना कर सकते हैं।
अप्रैल 2026 में AI इमेज जनरेशन
इमेज जनरेशन "क्या यह असली लगता है?" वाले सवाल से आगे निकल चुका है। अभी की चुनौती कंट्रोल, कंसिस्टेंसी और इस बात की है कि मॉडल बारीक क्रिएटिव प्रॉम्प्ट्स को कितनी सटीकता से फ़ॉलो करता है, खासकर जटिल मल्टी-सब्जेक्ट दृश्यों या ब्रांड-विशेष विज़ुअल स्टाइल्स के लिए।
क्रिएटिव इंडस्ट्री अभी किस बात की परवाह करती है
PicassoIA पर टेक्स्ट-टू-इमेज श्रेणी में 91 से ज़्यादा मॉडल हैं, और नए रिलीज़ आते ही प्लेटफ़ॉर्म उन्हें जोड़ता जाता है। इस हफ़्ते का फ़ोकस सिंगल इमेज की क्वालिटी से ज़्यादा प्रॉम्प्ट एडेरेंस और आउटपुट की एक सीरीज़ में स्टाइल कंसिस्टेंसी की ओर खिसका है।
क्रिएटिव टीमें अभी किन बातों को प्राथमिकता दे रही हैं:
- फ़ोटोरियलिस्टिक आउटपुट मार्केटिंग और प्रोडक्ट विज़ुअलाइज़ेशन वर्कफ़्लो के लिए
- कैरेक्टर की कंसिस्टेंट दिखावट एक ही प्रोजेक्ट के भीतर कई जनरेशन में
- रेफ़रेंस इमेज से स्टाइल रेप्लिकेशन न्यूनतम क्वालिटी गिरावट के साथ
- हाई-रेज़ोल्यूशन आउटपुट बारीक डिटेल वाले हिस्सों में अपस्केलिंग आर्टिफ़ैक्ट्स के बिना
ControlNet-आधारित तरीके उन टीमों के लिए इंडस्ट्री स्टैंडर्ड बने हुए हैं जिन्हें इमेज के स्ट्रक्चर के साथ-साथ विज़ुअल स्टाइल पर भी कंट्रोल चाहिए। पोज़ कंट्रोल, एज डिटेक्शन और डेप्थ मैप कंडीशनिंग प्रोडक्शन टीमों को वही जनरेट करने की सटीकता देते हैं जो वे स्केच या रेफ़रेंस में बनाते हैं, न कि इस पर पूरी तरह निर्भर रहते हैं कि मॉडल टेक्स्ट प्रॉम्प्ट को कैसे समझता है।
मज़बूत बेस मॉडल और ControlNet की सटीकता का मेल बताता है कि 2026 में इमेज जनरेशन अब लॉटरी नहीं रही। जो टीमें प्रॉम्प्ट की संरचना और रेफ़रेंस वर्कफ़्लो में समय लगाती हैं, वे ऐसे ब्रांड-अनुरूप विज़ुअल एसेट्स बना रही हैं जो दो साल पहले इतनी रफ़्तार से संभव ही नहीं थे।
रीज़निंग मॉडल जो सच में सोचते हैं
"रीज़निंग मॉडल" की श्रेणी अब कोई खास रुचि का विषय नहीं रही। ऐसे किसी भी वर्कफ़्लो में, जहाँ सटीकता रिस्पॉन्स की गति से ज़्यादा मायने रखती है, यह डिफ़ॉल्ट अपेक्षा बनती जा रही है।
2026 में रीज़निंग क्यों मायने रखती है
स्टैंडर्ड लैंग्वेज मॉडल पिछले कॉन्टेक्स्ट के आधार पर अगला टोकन प्रेडिक्ट करते हैं। रीज़निंग मॉडल अंतिम आउटपुट देने से पहले किसी समस्या पर स्टेप-बाय-स्टेप काम करते हैं। व्यावहारिक फ़र्क बड़ा है: एक रीज़निंग मॉडल किसी लॉजिक या गणित के सवाल का आत्मविश्वास से दिया गया गलत जवाब देने की संभावना कहीं कम रखता है।
GPT-5 Pro में बिल्ट-इन एक्सटेंडेड थिंकिंग डिफ़ॉल्ट रूप से चालू है। Kimi K2 Thinking भी यही तरीका अपनाता है और उसे एक्सेस करना मुफ़्त है। DeepSeek R1 ने ओपन-वेट रीज़निंग तरीके की शुरुआत की, और इस महीने लगभग हर नए रीज़निंग-सक्षम रिलीज़ में उसका असर दिखता है। OpenAI का O4 Mini उन टीमों के लिए विकल्प पूरा करता है जिन्हें रोज़मर्रा के लॉजिक कामों के लिए तेज़ और किफ़ायती रीज़निंग चाहिए।
तीन वर्कफ़्लो जहाँ रीज़निंग मॉडल स्टैंडर्ड LLM से बेहतर प्रदर्शन करते हैं:
- बहु-चरणीय गणित और मात्रात्मक समस्याएँ जहाँ बीच की गलतियाँ जुड़कर अंतिम जवाब गलत कर देती हैं
- कानूनी और अनुबंध विश्लेषण जहाँ धाराप्रवाहता या गति से ज़्यादा सटीकता मायने रखती है
- कोड डीबगिंग जहाँ मॉडल को संभावित सुधारों का अंदाज़ा लगाने के बजाय एक्ज़ीक्यूशन पाथ को ट्रेस करना पड़ता है
💡 अगर आपका मौजूदा वर्कफ़्लो अनुक्रमिक लॉजिक वाले कामों के लिए स्टैंडर्ड LLM इस्तेमाल करता है, तो DeepSeek R1 या Kimi K2 Thinking पर स्विच करने से आपके मौजूदा प्रॉम्प्ट स्ट्रक्चर में बदलाव किए बिना एरर रेट घट सकता है।
Llama 4 और ओपन-सोर्स की रफ़्तार
Meta के Llama 4 Maverick Instruct और Llama 4 Scout Instruct प्रोडक्शन में ओपन-वेट AI के स्वरूप को लगातार बदल रहे हैं। दोनों मॉडल चैट, सारांश, लंबे दस्तावेज़ों के काम और कोड जनरेशन संभालते हैं, और उनका प्रदर्शन मालिकाना विकल्पों के काफ़ी करीब रहता है, जबकि लागत उसके एक हिस्से जितनी है।
जिन टीमों को डेटा प्राइवेसी की ज़रूरत, बजट की सीमा, या सेल्फ़-होस्टेड इंफ़्रास्ट्रक्चर की पसंद है, उनके लिए ओपन-वेट मॉडल्स में Meta का लगातार निवेश इस महीने की सबसे व्यावहारिक रूप से अहम घटनाओं में से एक है। ओपन मॉडल्स की क्वालिटी की सीमा तेज़ी से बढ़ी है, और ओपन और क्लोज़्ड-वेट मॉडल्स के बीच का फ़ासला आज जितना कम है, उतना पहले कभी नहीं था।
व्यापक ओपन-सोर्स इकोसिस्टम को भी इससे फ़ायदा मिलता है। Meta Llama 3.1 405B Instruct प्रोडक्शन में अब भी व्यापक रूप से इस्तेमाल होता है, और Llama 4 अब उपलब्ध है, इसलिए टीमों के पास एक साफ़ ओपन-वेट अपग्रेड रास्ता है, जिसके लिए किसी मालिकाना API पर स्विच करने की ज़रूरत नहीं।
ऑडियो और स्पीच AI आगे बढ़ता है
हेडलाइन घोषणाओं के मामले में ऑडियो जनरेशन का हफ़्ता कुछ शांत रहा, लेकिन जो क्षमताएँ समेकित होकर जारी हो रही हैं, वे कंटेंट प्रोडक्शन से जुड़े किसी भी व्यक्ति के लिए ध्यान से देखने लायक हैं।
टेक्स्ट-टू-स्पीच और ज़्यादा इंसानी हो रहा है
टेक्स्ट-टू-स्पीच मॉडल्स की मौजूदा पीढ़ी ऐसा आउटपुट दे रही है, जो नियंत्रित सुनने की परिस्थितियों में इंसानी आवाज़ से अलग पहचानना मुश्किल है। टोन में बदलाव, स्वाभाविक गति और भावनात्मक बारीकियाँ हर मॉडल के नए वर्ज़न के साथ बेहतर हो रही हैं। स्क्रिप्टेड वॉइसओवर पर निर्भर क्रिएटर्स के लिए AI-जनरेटेड नैरेशन की क्वालिटी की सीमा अब ज़्यादातर वीडियो प्रकारों के लिए वास्तव में उपयोगी स्तर तक पहुँच गई है, जिसमें लंबे एक्सप्लेनर और प्रोडक्ट डेमो भी शामिल हैं।
स्पीच-टू-टेक्स्ट लगभग परफ़ेक्ट सटीकता पर
ट्रांसक्रिप्शन की ओर, स्पीच-टू-टेक्स्ट मॉडल अब ऐसे सटीकता स्तर पर काम कर रहे हैं जो ज़्यादातर सामान्य रिकॉर्डिंग माहौल में बड़े मैन्युअल सुधार की ज़रूरत खत्म कर देते हैं। एक स्पीकर वाला साफ़ ऑडियो आमतौर पर ऐसे ट्रांसक्रिप्ट देता है, जिन्हें प्रकाशित करने या आगे प्रोसेस करने से पहले बहुत कम एडिटिंग चाहिए।
प्रोडक्शन टीमों के लिए AI म्यूज़िक जनरेशन
AI म्यूज़िक जनरेशन अब उन कंटेंट टीमों के लिए व्यावहारिक टूल बन चुका है, जिन्हें बैकग्राउंड म्यूज़िक, जिंगल के वेरिएशन या थीम वाला स्कोर मांग पर चाहिए। किसी वांछित मूड, टेम्पो और वाद्य-यंत्रों का टेक्स्ट प्रॉम्प्ट से वर्णन करके एक मिनट से कम में पॉलिश्ड आउटपुट पाना छोटी प्रोडक्शन टीमों के काम करने का तरीका बदल रहा है, खासकर सोशल वीडियो, ब्रांडेड कंटेंट और पॉडकास्ट प्रोडक्शन में।
सुपर रेज़ोल्यूशन और साफ़ हुआ
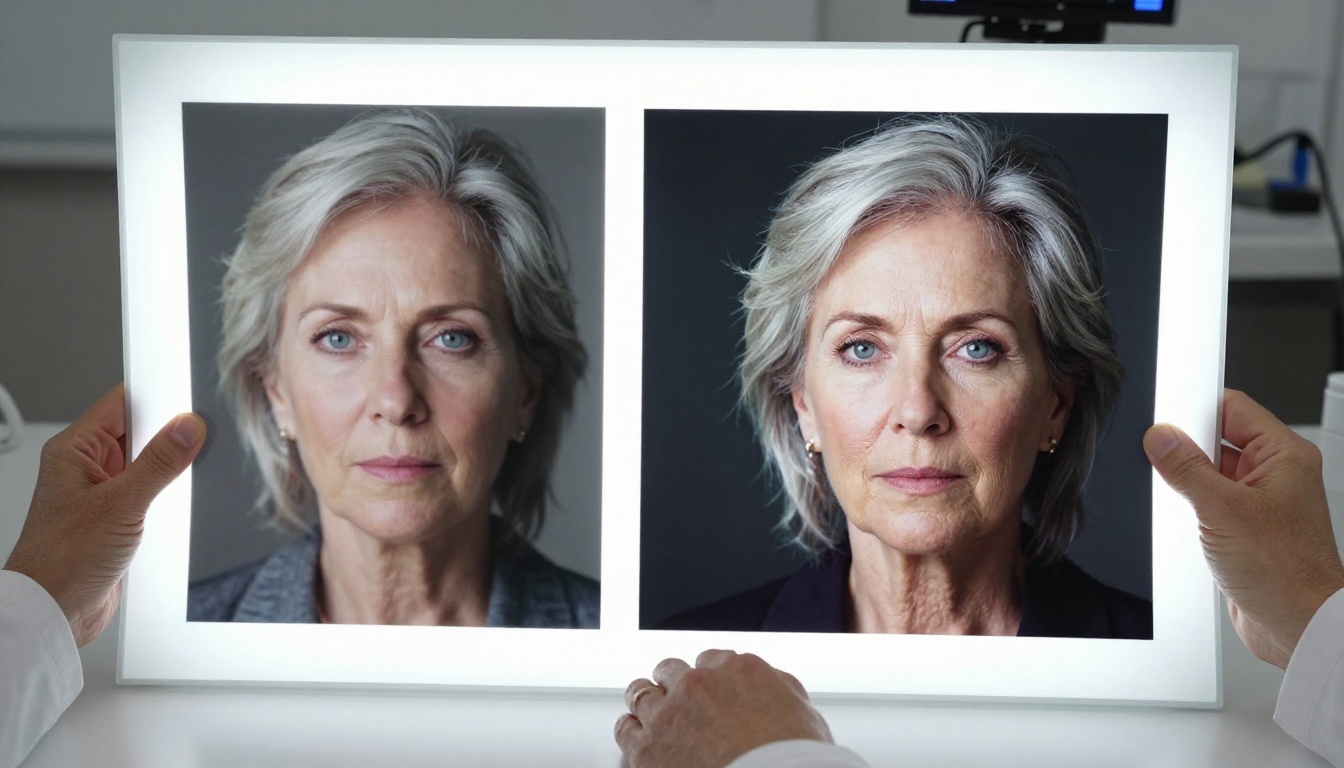
इमेज अपस्केलिंग हमेशा से सबसे तुरंत व्यावहारिक AI अनुप्रयोगों में से एक रही है, और इस हफ़्ते के अपडेट बताते हैं कि यह PicassoIA पर सबसे ज़्यादा इस्तेमाल होने वाले फ़ीचर्स में क्यों बनी हुई है।
अभी उपलब्ध सर्वश्रेष्ठ अपस्केलर
Real ESRGAN फ़ोटो को उनके मूल रेज़ोल्यूशन के 4 गुना तक अपस्केल करने के लिए मुफ़्त विकल्प बना हुआ है, जो सामान्य डिटेल को भरोसेमंद ढंग से सुरक्षित रखता है। खास तौर पर पोर्ट्रेट के लिए, Crystal Upscaler 4x स्केल पर सामान्य-उद्देश्य मॉडल्स की तुलना में स्किन टेक्सचर और चेहरे की डिटेल साफ़ तौर पर बेहतर देता है। सब्जेक्ट के प्रकार से परे सबसे ऊँची क्वालिटी के लिए, Image Upscale by Topaz Labs 6x तक स्केल करता है और किनारों की तीक्ष्णता बनाए रखता है, जिसे प्रतिस्पर्धी मॉडल अक्सर धुंधला कर देते हैं। ग्राफ़िक कंटेंट और इलस्ट्रेशन के लिए, जहाँ साफ़ किनारे फ़ोटोरियलिस्टिक टेक्सचर की नकल से ज़्यादा मायने रखते हैं, Recraft Crisp Upscale सबसे मज़बूत विकल्प है।
💡 अगर आप स्पीड के लिए 512px या 768px पर इमेज जनरेट कर रहे हैं, तो बाद में उन्हें Real ESRGAN या Crystal Upscaler से चलाने पर ज़्यादातर व्यावहारिक उपयोगों में नतीजे नेटिव हाई-रेज़ोल्यूशन जनरेशन के तुलनीय आते हैं।
इस हफ़्ते के रिलीज़ असल में क्यों मायने रखते हैं
AI रिलीज़ की संख्या कई महीनों से लगातार ऊँची रही है, लेकिन इस हफ़्ते के अपडेट एक खास तरीके से अलग दिखते हैं: वे कन्वर्जेंस दिखाते हैं। टेक्स्ट से लेकर वीडियो, ऑडियो और इमेज प्रोसेसिंग तक कई मोडैलिटी एक साथ प्रोफ़ेशनल क्वालिटी के स्तर तक पहुँच रही हैं। पूरे AI-संचालित क्रिएटिव वर्कफ़्लो बनाने की बाधा पहले से कहीं कम है।
डेवलपर, क्रिएटर या बिज़नेस टीम के लिए इसका व्यावहारिक मतलब यह है: प्रोफ़ेशनल-ग्रेड कंटेंट को बड़े पैमाने पर बनाने के टूल अब एक ही सुलभ प्लेटफ़ॉर्म में समा जाते हैं, बिना गहरे तकनीकी इंफ़्रास्ट्रक्चर या बड़ी टीम के।
इस हफ़्ते रोज़मर्रा के यूज़र्स के लिए असल में क्या बदला:
- वीडियो जनरेशन, इमेज क्रिएशन और ऑडियो प्रोडक्शन के लिए अब अलग-अलग विशेष प्लेटफ़ॉर्म की ज़रूरत नहीं रही
- सबसे महंगे API टियर के लिए भुगतान किए बिना अब रीज़निंग मॉडल उपलब्ध हैं
- Llama 4 और DeepSeek जैसे ओपन-वेट मॉडल्स का मतलब है कि एंटरप्राइज़-क्वालिटी AI अब प्रीमियम सब्सक्रिप्शन कीमत के पीछे बंद नहीं है
- वीडियो मॉडल्स में नेटिव ऑडियो एक ऐसा प्रोडक्शन चरण हटाता है, जिसके लिए पहले अलग ऑडियो टूल्स और पोस्ट-प्रोडक्शन समय चाहिए था
मज़बूत ओपन मॉडल्स, मल्टी-मोडल नेटिव क्षमताओं और कम एक्सेस लागत का मेल बताता है कि 2026 वह साल है जब AI-संचालित प्रोडक्शन किसी भी आकार की टीमों के लिए व्यावहारिक हकीकत बन जाता है, सिर्फ़ उनके लिए नहीं जिनके पास बड़े बजट या समर्पित तकनीकी इंफ़्रास्ट्रक्चर हों।
इन टूल्स को खुद आज़माएँ
इस लेख में बताया गया हर मॉडल PicassoIA पर बिना API क्रेडेंशियल मैनेज किए, कई अलग प्लेटफ़ॉर्म पर साइन अप किए बिना, या अपना क्लाउड इंफ़्रास्ट्रक्चर कॉन्फ़िगर किए बिना इस्तेमाल किया जा सकता है। प्लेटफ़ॉर्म नवीनतम LLM, वीडियो जनरेटर, इमेज टूल्स और अपस्केलर एक ही जगह लाता है, टूल्स के बीच बदलने की ज़रूरत के बिना।
अगर आप इस हफ़्ते के AI रिलीज़ को तुरंत काम में लगाना चाहते हैं, तो यहाँ से शुरू करें:
2026 में सवाल यह नहीं है कि क्या AI प्रोफ़ेशनल क्रिएटिव काम संभाल सकता है। वह पहले ही संभाल सकता है। सवाल यह है कि आप इन टूल्स को अपने वर्कफ़्लो में कितनी जल्दी लगाना शुरू करते हैं और नतीजे खुद देखते हैं।


