Si vous avez passé plus de dix minutes avec un générateur d’images NSFW par IA, vous connaissez déjà cette frustration. Vous rédigez le prompt parfait, vous obtenez un résultat époustouflant, vous modifiez un détail mineur pour l’image suivante, et soudain vous vous retrouvez face à une tout autre personne. Un nez différent, une mâchoire différente, des yeux différents. Le personnage que vous aviez en tête a disparu. C’est le principal point de friction du contenu NSFW généré par IA, et c’est la raison pour laquelle la cohérence des personnages est devenue le sujet le plus recherché dans la communauté de l’art par IA.
La bonne nouvelle : en 2027, plusieurs modèles et techniques ont enfin résolu ce problème. Pas parfaitement, mais suffisamment pour créer des séries entières d’images avec le même personnage, dans des scènes, des tenues et des éclairages très différents. Cet article détaille les modèles qui y parviennent le mieux, les outils LoRA qui rendent la cohérence fiable, et les stratégies de prompting qu’utilisent réellement les professionnels.
Pourquoi la cohérence des personnages est si difficile
Le problème que la plupart des générateurs ignorent
Les modèles de texte vers image standard génèrent à partir d’un processus aléatoire. À chaque fois que vous lancez le même prompt, le modèle échantillonne une distribution de probabilités, ce qui signifie que les traits de votre personnage dérivent d’un résultat à l’autre. La forme des yeux, la largeur de la mâchoire, l’arête du nez, voire le teint peuvent changer simplement en modifiant un mot du prompt. Pour une génération occasionnelle, ce n’est pas gênant. Pour créer un personnage cohérent qui apparaît sur plusieurs images, c’est un problème sérieux.
La plupart des générateurs se concentrent sur la réactivité aux prompts et la qualité d’image. Le verrouillage du personnage, c’est-à-dire la capacité à ancrer une géométrie faciale précise d’une génération à l’autre, est un défi technique qui exige soit la gestion du seed, soit l’entraînement d’un LoRA, soit un conditionnement par image de référence.
Ce que signifie vraiment la « cohérence »
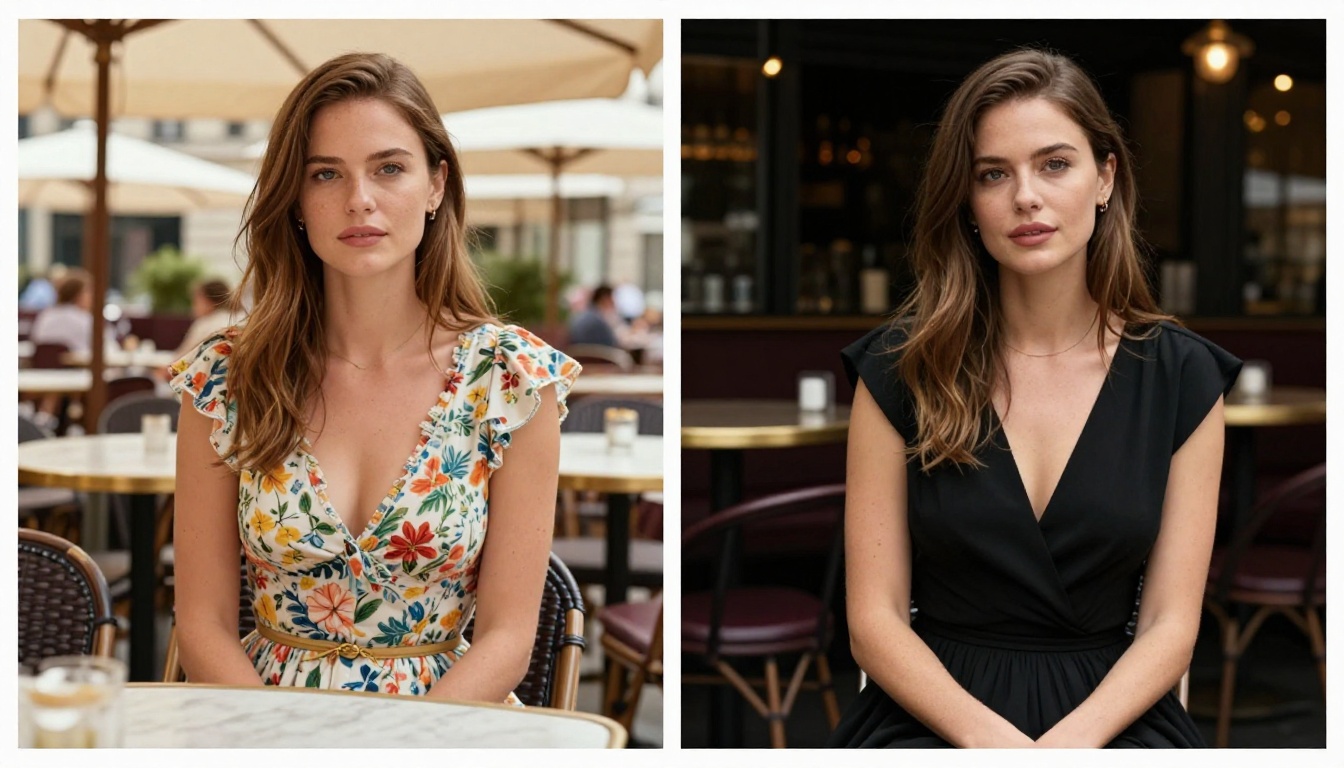
La cohérence des personnages ne signifie pas un clonage pixel par pixel. Elle signifie que le personnage est reconnu comme la même personne d’une image à l’autre, de la même manière qu’un acteur paraît être la même personne dans différentes scènes d’un film. Le test est simple : quelqu’un pourrait-il regarder dix images et croire qu’elles représentent toutes la même femme ? C’est ce niveau qu’il faut atteindre.
Trois facteurs favorisent la cohérence :
- Verrouillage du seed : utiliser le même seed aléatoire d’une génération à l’autre ancre le schéma de bruit
- Entraînement LoRA : le fine-tuning d’un modèle sur des images de référence de votre personnage précis
- Conditionnement par référence : utiliser des techniques image vers image ou ControlNet pour transmettre les caractéristiques d’une image à l’autre
Les meilleurs modèles pour des personnages NSFW cohérents
Flux 1.1 Pro Ultra
Flux 1.1 Pro Ultra de Black Forest Labs est devenu la référence pour la génération de personnages photoréalistes. Son architecture interne répond à des descriptions de personnages très détaillées avec une stabilité remarquable d’un prompt à l’autre. Lorsque vous verrouillez un seed et conservez votre bloc descripteur de personnage (un paragraphe décrivant la personne précise), Flux 1.1 Pro Ultra préserve la géométrie du visage mieux que presque tous les autres modèles de ce niveau.
Ce qui le rend exceptionnel pour le contenu NSFW : il génère la texture de la peau, la profondeur et l’anatomie naturelle avec un réalisme que les modèles plus anciens ne peuvent pas égaler. Le comportement des ombres dans les scènes peu éclairées est particulièrement impressionnant, et le modèle gère les contenus suggestifs de style glamour sans les artefacts de la vallée de l’étrange qui affectent les générateurs moins performants.
💡 Astuce : dans votre prompt, rédigez toujours la description du personnage en premier, avant toute description de scène ou d’action. Cela oblige le modèle à donner la priorité aux traits de la personne avant de construire l’environnement autour d’elle.
Realistic Vision v5.1
Realistic Vision v5.1 a été conçu spécifiquement pour la génération humaine photoréaliste. Son jeu de données d’entraînement penche fortement vers la photographie de portrait, l’imagerie éditoriale et les contenus proches de la mode, ce qui explique précisément pourquoi il offre des résultats cohérents et naturels pour les travaux centrés sur les personnages.
Le modèle répond bien aux prompts de style photographique : précisez l’objectif, l’ouverture, le dispositif d’éclairage et le type de pellicule. Cette précision n’est pas seulement une question d’esthétique. Elle indique au modèle de restreindre sa sortie à un espace photographique plus étroit, ce qui réduit la dérive des traits d’une génération à l’autre.
Pour le contenu glamour NSFW en particulier, Realistic Vision v5.1 gère les teints, les proportions du corps et les textures des tissus avec un naturel qui paraît éditorial plutôt que synthétique.
SDXL Multi-ControlNet LoRA
Pour les utilisateurs qui veulent le niveau de contrôle le plus poussé sur le personnage, SDXL Multi-ControlNet LoRA se place dans une catégorie à part. Les couches ControlNet vous permettent de fournir des références structurelles, des squelettes de pose, des cartes de profondeur ou des images de référence de visage en complément d’un prompt texte. Combiné à un LoRA propre au personnage, cela crée un système de cohérence à trois couches que le modèle a énormément de mal à faire céder.
Le compromis : la configuration demande plus de travail. Il faut des images de référence, régler correctement le poids de ControlNet et équilibrer le prompt texte avec les entrées de conditionnement. Mais pour les utilisateurs qui veulent une cohérence de personnage de niveau professionnel sur des séries longues, le coût de la configuration en vaut la peine.
RealVisXL v3 Multi-ControlNet LoRA
RealVisXL v3 Multi-ControlNet LoRA associe les atouts photoréalistes de l’architecture RealVisXL au contrôle structurel du conditionnement multi-ControlNet. C’est le modèle à privilégier lorsque vous avez besoin à la fois d’un réalisme maximal et d’une cohérence maximale. Il est particulièrement efficace pour les séries de portraits, où les proportions du visage et du corps doivent rester stables d’un changement de scène à l’autre.
LoRA, ou pourquoi tout change
Entraîner un LoRA de personnage
LoRA (Low-Rank Adaptation) est une technique de fine-tuning qui spécialise un modèle autour de concepts visuels précis. Lorsque vous entraînez un LoRA de personnage, vous fournissez au modèle 15 à 30 photos de référence de votre personnage, sous différents angles et avec différents éclairages. Le modèle apprend la topologie spécifique de ce visage : la forme exacte des yeux, la courbe particulière de la mâchoire, la géométrie de la ligne des cheveux.
Une fois entraîné, le poids du LoRA agit comme un ancrage persistant sur la sortie du modèle. Chaque génération qui utilise le LoRA ramènera les traits du personnage vers vos images de référence, quels que soient les changements de scène ou de pose. Pour les séries de personnages NSFW, c’est l’outil le plus puissant disponible.
La meilleure plateforme pour la génération basée sur LoRA est p-image-lora, qui permet de charger un empilement de LoRA et vous donne un contrôle direct sur le mot déclencheur et l’équilibre des poids.
Meilleurs LoRA pour les portraits
Au-delà des LoRA propres aux personnages, plusieurs LoRA de style et d’anatomie améliorent nettement la qualité des portraits NSFW :
- Les LoRA de détail de peau : améliorent le rendu des pores, la diffusion sous-cutanée et les imperfections naturelles de la peau
- LoRA de correction anatomique : corrigent les déformations fréquentes des mains, des doigts et des proportions du corps
- LoRA d’éclairage : fixent des esthétiques lumineuses précises (heure dorée, studio, Rembrandt dramatique)
- LoRA de grain argentique : ajoutent les textures de Kodak Portra, Fuji 400H ou Ilford Delta à n’importe quelle génération
Associer un LoRA de personnage à un LoRA de détail de peau et à un LoRA de grain argentique constitue le flux de travail professionnel pour des séries de personnages cohérentes et de haute qualité.
💡 Astuce : gardez le poids de votre LoRA entre 0,6 et 0,85. Au-delà de 0,9, les artefacts sur le visage et l’effondrement des détails sont fréquents. Le point optimal varie selon le modèle. Testez donc par paliers de 0,05.
À explorer également : Flux Dev LoRA, qui permet de charger des LoRA personnalisés sur le modèle de base Flux Dev, vous offrant le réalisme supérieur de Flux combiné à un contrôle LoRA au niveau du personnage.
Préparer votre personnage
Le flux de travail le plus efficace pour la cohérence des personnages avec Flux sur Flux 1.1 Pro ou Flux 2 Pro commence par un bloc descripteur de personnage. Il s’agit d’un paragraphe fixe qui décrit votre personnage en termes physiques précis. Il ne change pas d’un prompt à l’autre.
Un bon bloc descripteur de personnage comprend :
- Tranche d’âge (« femme dans la vingtaine, vers 25 ans »)
- Cheveux (couleur, texture, longueur, tombée)
- Forme du visage (ovale, en cœur, mâchoire carrée, etc.)
- Yeux (forme, couleur, écartement)
- Signes distinctifs (taches de rousseur, grains de beauté, forme des lèvres, arc des sourcils)
- Teint avec référence photographique (par ex. « beige doré chaud, phototype III »)
Placez ce bloc au début de chaque prompt. Après le bloc, ajoutez la description de la scène. Cette structure oblige le modèle à établir d’abord le personnage.
Garder le même visage d’une scène à l’autre
Au-delà du bloc du personnage, plusieurs choix techniques améliorent la cohérence d’une scène à l’autre :
- Verrouiller le seed : utilisez le même seed aléatoire pour chaque génération d’une série. Le seed contrôle le schéma de bruit initial et, avec un bloc de personnage stable, il crée un point de départ fiable.
- Garder un angle de caméra constant : passer d’une prise de face à un profil net modifie toujours la géométrie faciale perçue. Si vous avez besoin d’angles différents, changez-les progressivement.
- Éviter les changements brusques d’éclairage : un éclairage directionnel marqué modifie fortement la forme du visage perçue. Restez sur des dispositifs d’éclairage cohérents au sein d’une série.
- Utiliser img2img à faible débruitage : pour changer de scène, partez d’une image précédente et utilisez l’image vers image avec une force de débruitage de 30 à 45 %. Le modèle modifiera la scène tout en préservant le personnage.
Comparatif : les meilleurs générateurs d’images NSFW par IA
Des astuces de prompting qui fonctionnent vraiment
Verrouillage du seed et ancres de style
La plupart des plateformes exposent un paramètre de seed. Copiez le seed de toute génération que vous voulez poursuivre. Combiné à votre bloc de personnage, le même seed agit comme une ancre d’identité qui réduit nettement la dérive des traits.
Les ancres de style fonctionnent en complément du verrouillage du seed. Il s’agit de formulations techniques précises qui restreignent l’espace de sortie visuel :
"Kodak Portra 400, 85mm f/1.8, natural light" oriente le modèle vers la photographie éditoriale"Rembrandt lighting, studio setup, white backdrop" verrouille le schéma d’éclairage"frontal portrait, eye-level camera" empêche une dérive involontaire de l’angle
Appliquez ces ancres de style de manière cohérente à travers votre série, et même sans LoRA, vous obtiendrez une sortie de personnage nettement plus cohérente.
Techniques d’image de référence
Plusieurs flux de travail basés sur SDXL prennent en charge le prompting par image ou l’injection de référence de visage. Dans ces modes, vous fournissez une image de votre personnage en plus du prompt texte. Le modèle utilise les deux entrées pour générer, l’image apportant la géométrie faciale que le texte seul ne peut pas spécifier parfaitement.
Cette technique est particulièrement efficace combinée à ControlNet. Utilisez l’image de référence comme entrée ControlNet de visage ou de contours (canny) avec un poids de 0,4 à 0,6, puis laissez le prompt texte gérer la scène. Résultat : le visage du personnage est ancré à votre référence, tandis que le reste répond à votre direction créative.
💡 Astuce : pour l’image de référence, utilisez un portrait net, de face, avec une expression neutre et un éclairage uniforme. Un éclairage très contrasté ou dramatique dans l’image de référence perturbe le conditionnement et se retrouve dans l’éclairage de votre sortie.
Le rôle de la super-résolution
Une fois vos images de personnage cohérentes obtenues, le flux de travail ne s’arrête pas à la génération. L’upscaling par super-résolution préserve et enrichit les détails fins, la texture de la peau, les mèches de cheveux et le tissage des tissus, qui démontrent la cohérence du personnage en grand format d’impression ou sur écran.
Les outils de super-résolution disponibles sur PicassoIA peuvent augmenter la résolution de 2x à 4x tout en préservant le grain photographique et le détail de la peau, qui font paraître les images de personnages NSFW véritablement réelles plutôt que synthétiquement lisses. Passer vos images finales dans un upscaling 2x est l’étape de finition professionnelle qui distingue les séries de personnages soignées des rendus bruts.
De même, si une image générée présente des artefacts faciaux ou une anatomie légèrement erronée, les outils d’inpainting peuvent corriger précisément certaines zones sans régénérer toute l’image. C’est particulièrement utile pour conserver une belle pose et une expression réussie tout en corrigeant une forme d’œil légèrement incohérente.
Les erreurs courantes qui brisent la cohérence
Même avec les bons modèles, ces habitudes détruisent la cohérence des personnages :
- Modifier le descripteur du personnage en cours de série : même de petits changements de mots modifient la façon dont le modèle interprète le personnage. Rédigez-le une fois, figez-le, puis collez-le partout.
- Ignorer les prompts négatifs : sans prompts négatifs qui bloquent les déformations et les styles cartoon, les modèles dérivent vers leurs biais par défaut. Incluez toujours
"deformed, blurry, cartoon, illustration, painting" dans les négatifs.
- Changer de modèle en cours de série : chaque modèle a sa propre interprétation d’un même prompt. Changer de modèle oblige à recommencer le calibrage du personnage.
- Trop décrire la scène : lorsque la description de la scène dépasse en longueur le bloc du personnage, le modèle privilégie la scène au personnage. Gardez les descriptions de scène plus courtes que le bloc du personnage.
- Négliger la gestion du seed : sans verrouillage du seed, chaque génération est un nouveau tirage au sort. Le seed est gratuit et prend trois secondes à noter. Enregistrez-le systématiquement.
Commencez votre propre série de personnages
La technologie permettant de produire des images de personnages NSFW cohérentes et belles existe désormais et est pleinement accessible. Tous les modèles présentés ici sont disponibles sur PicassoIA, où vous pouvez lancer Flux 1.1 Pro Ultra, Realistic Vision v5.1, SDXL Multi-ControlNet LoRA et l’ensemble des générateurs compatibles LoRA, au même endroit.
Commencez avec un personnage que vous savez décrire en détail. Rédigez le bloc descripteur. Choisissez un seed. Générez dix variations du même personnage dans des scènes différentes. Affinez le bloc en fonction de ce à quoi le modèle réagit. Après quelques itérations, vous disposerez d’une formule de personnage fiable qui produit des résultats cohérents à chaque fois.
L’écart entre « image IA » et « série de personnages IA » ne tient pas à la technologie. Il tient au flux de travail. Vous l’avez maintenant.