Se você já passou mais de dez minutos com qualquer gerador de imagens de IA NSFW, já conhece a frustração. Você cria o prompt perfeito, obtém um resultado de tirar o fôlego, ajusta um detalhe mínimo para a imagem seguinte e, de repente, está diante de uma pessoa completamente diferente. Outro nariz, outra mandíbula, outros olhos. O personagem que você tinha em mente desapareceu. Este é o maior problema do conteúdo NSFW gerado por IA e o motivo pelo qual a consistência de personagem se tornou o tema mais pesquisado na comunidade de arte com IA.
A boa notícia: em 2027, vários modelos e técnicas finalmente resolveram este problema. Não perfeitamente, mas o bastante para criar séries inteiras de imagens com o mesmo personagem em cenas, roupas e iluminações bem diferentes. Este guia reúne os modelos que fazem isso melhor, as ferramentas de LoRA que tornam a consistência confiável e as estratégias de prompt que os profissionais realmente usam.
Por que a consistência de personagem é tão difícil
O problema que a maioria dos geradores ignora
Os modelos padrão de texto para imagem geram a partir de aleatoriedade. Toda vez que você executa o mesmo prompt, o modelo faz uma amostragem a partir de uma distribuição de probabilidade, o que significa que as características do seu personagem variam entre as saídas. Formato dos olhos, largura da mandíbula, ponte do nariz, até o tom da pele pode mudar só com a troca de uma palavra no prompt. Para uma geração casual, isso não é problema. Para criar um personagem coerente que aparece em várias imagens, é um problema sério.
A maioria dos geradores se concentra na capacidade de resposta ao prompt e na qualidade da imagem. O bloqueio de personagem, ou seja, a capacidade de fixar a geometria facial específica entre as gerações, é um desafio técnico que exige gerenciamento de seed, treinamento de LoRA ou condicionamento por referência.
O que "consistência" realmente significa
Consistência de personagem não significa um clone perfeito pixel a pixel. Significa que o personagem é lido como a mesma pessoa em imagens diferentes, do mesmo jeito que um ator parece ser a mesma pessoa em cenas diferentes de um filme. O teste é simples: alguém conseguiria olhar para dez imagens e acreditar que todas mostram a mesma mulher? Esse é o padrão.
Três fatores impulsionam a consistência:
- Bloqueio de seed: Usar o mesmo seed aleatório em todas as gerações fixa o padrão de ruído
- Treinamento de LoRA: Fazer o fine-tuning de um modelo com imagens de referência do seu personagem específico
- Condicionamento por referência: Usar técnicas de imagem para imagem ou ControlNet para transferir as características às imagens seguintes
Os melhores modelos para personagens NSFW consistentes
Flux 1.1 Pro Ultra
O Flux 1.1 Pro Ultra, da Black Forest Labs, se tornou o padrão de ouro para geração de personagens fotorrealistas. Sua arquitetura interna responde a descrições de personagem muito detalhadas com estabilidade notável entre os prompts. Quando você bloqueia um seed e mantém seu bloco de descrição central do personagem (um parágrafo que descreve a pessoa específica), o Flux 1.1 Pro Ultra mantém a geometria facial melhor do que quase qualquer outro modelo nesse nível.
O que o torna excepcional para trabalhos NSFW: ele gera textura da pele, profundidade e anatomia natural com um realismo que os modelos mais antigos não alcançam. O comportamento das sombras em cenas de pouca luz é particularmente impressionante, e o modelo lida com conteúdo sugestivo e de estilo glamour sem os artefatos de vale da estranheza que afetam geradores menos avançados.
💡 Dica: No seu prompt, escreva sempre a descrição do personagem primeiro, antes de qualquer descritor de cena ou ação. Isso faz o modelo priorizar as características da pessoa antes de construir o ambiente ao redor dela.
Realistic Vision v5.1
O Realistic Vision v5.1 foi criado especificamente para a geração de seres humanos fotorrealistas. Seu conjunto de treinamento tende fortemente para fotografia de retrato, imagens editoriais e conteúdo ligado à moda, e é exatamente por isso que ele entrega resultados consistentes e naturalistas para trabalhos centrados no personagem.
O modelo responde bem a prompts no estilo fotográfico: especifique a lente, a abertura, a configuração de iluminação e o tipo de filme. Essa especificidade não é apenas um enquadramento estético. Ela sinaliza ao modelo para restringir a saída a um espaço fotográfico mais estreito, o que reduz a variação de características entre as gerações.
Para conteúdo NSFW de estilo glamour em especial, o Realistic Vision v5.1 lida com tons de pele, proporções corporais e texturas de tecido com uma naturalidade que parece editorial, e não sintética.
SDXL Multi-ControlNet LoRA
Para quem quer o nível mais profundo de controle sobre o personagem, o SDXL Multi-ControlNet LoRA está em outra categoria. As camadas do ControlNet permitem fornecer referências estruturais, esqueletos de pose, mapas de profundidade ou imagens de referência de rosto por cima de um prompt de texto. Combinado com um LoRA específico do personagem, isso cria um sistema de consistência em três camadas que é extremamente difícil de quebrar para o modelo.
A contrapartida: exige mais configuração. Você precisa de imagens de referência, precisa ajustar corretamente o peso do ControlNet e precisa equilibrar o prompt de texto com as entradas de condicionamento. Mas, para quem quer consistência de personagem de nível profissional em séries longas, o custo da configuração compensa.
RealVisXL v3 Multi-ControlNet LoRA
O RealVisXL v3 Multi-ControlNet LoRA combina os pontos fortes em fotorrealismo da arquitetura RealVisXL com o controle estrutural do condicionamento multi-ControlNet. Este é o modelo a escolher quando você precisa de realismo máximo e consistência máxima ao mesmo tempo. Ele é particularmente forte em séries de retratos em que as proporções do rosto e do corpo precisam permanecer fixas entre as mudanças de cena.
LoRA e por que ele muda tudo
Treinando um LoRA de personagem
LoRA (Low-Rank Adaptation) é uma técnica de fine-tuning que especializa um modelo em conceitos visuais específicos. Ao treinar um LoRA de personagem, você fornece ao modelo entre 15 e 30 fotos de referência do seu personagem, de ângulos diferentes e com iluminações diferentes. O modelo aprende a topologia específica daquele rosto: o formato exato dos olhos, a curva particular da mandíbula, a geometria da linha do cabelo.
Depois de treinado, o peso do LoRA funciona como uma âncora persistente sobre a saída do modelo. Toda geração que usa o LoRA puxará as características do personagem de volta para suas imagens de referência, não importa quanto a cena ou a pose mudem. Para séries NSFW com personagens, esta é a ferramenta mais poderosa disponível.
A melhor plataforma para geração baseada em LoRA é o p-image-lora, que permite carregar um conjunto de LoRAs e oferece controle direto sobre a palavra-gatilho e o equilíbrio de pesos.
Os melhores LoRAs para retratos
Além dos LoRAs específicos de personagem, vários LoRAs de estilo e anatomia melhoram bastante a qualidade dos retratos NSFW:
- LoRAs de detalhe de pele: Melhoram a renderização dos poros, a dispersão subsuperficial e as imperfeições naturais da pele
- LoRAs de correção anatômica: Corrigem distorções comuns em mãos, dedos e proporções do corpo
- LoRAs de iluminação: Fixam estéticas de luz específicas (hora dourada, estúdio, Rembrandt dramático)
- LoRAs de granulação de filme: Adicionam texturas de Kodak Portra, Fuji 400H ou Ilford Delta a qualquer geração
Empilhar um LoRA de personagem com um LoRA de detalhe de pele e um LoRA de granulação de filme é o fluxo de trabalho profissional para séries de personagens consistentes e de alta qualidade.
💡 Dica: Mantenha o peso do seu LoRA entre 0,6 e 0,85. Acima de 0,9, costuma haver artefatos no rosto e colapso de detalhes. O ponto ideal varia de modelo para modelo, então teste em incrementos de 0,05.
Também vale explorar o Flux Dev LoRA, que permite carregar LoRAs personalizados sobre o modelo base Flux Dev, dando a você o realismo superior do Flux combinado com controle de LoRA em nível de personagem.
Como usar o Flux para consistência de personagem
Configurando seu personagem
O fluxo de trabalho mais eficaz para consistência de personagem baseada em Flux no Flux 1.1 Pro ou no Flux 2 Pro começa com um bloco descritor do personagem. Trata-se de um parágrafo fixo que descreve seu personagem em termos físicos precisos. Ele não muda entre os prompts.
Um bom bloco descritor do personagem inclui:
- Faixa etária ("mulher de meados dos 20 anos")
- Cabelo (cor, textura, comprimento, como cai)
- Formato do rosto (oval, coração, mandíbula quadrada etc.)
- Olhos (formato, cor, espaçamento)
- Características marcantes (sardas, pintas, formato dos lábios, arco das sobrancelhas)
- Tom de pele com referência fotográfica (ex.: "bege dourado quente, tipo Fitzpatrick III")
Cole este bloco no início de todo prompt. Depois do bloco, acrescente a descrição da cena. Essa estrutura obriga o modelo a estabelecer primeiro o personagem.
Mantendo o mesmo rosto em cenas diferentes
Além do bloco do personagem, várias escolhas técnicas melhoram a consistência entre cenas:
- Bloqueie o seed: Use o mesmo seed aleatório em todas as gerações de uma série. O seed controla o padrão de ruído inicial e, com um bloco de personagem estável, isso cria um ponto de partida confiável.
- Mantenha o ângulo da câmera consistente: Passar de um plano frontal para um perfil lateral acentuado sempre alterará a geometria facial percebida. Se você precisar de ângulos diferentes, faça a mudança gradualmente.
- Evite mudanças drásticas de iluminação: A iluminação direcional forte altera bastante o formato do rosto percebido. Mantenha configurações de iluminação consistentes dentro de uma série.
- Use img2img com denoising baixo: Para mudanças de cena, parta de uma imagem anterior e use imagem para imagem com força de denoising entre 30% e 45%. O modelo mudará a cena preservando o personagem.
Comparação: os principais geradores de IA NSFW
Dicas de prompt que realmente funcionam
Bloqueio de seed e âncoras de estilo
A maioria das plataformas expõe um parâmetro de seed. Copie o seed de qualquer geração que você queira continuar. Combinado com o bloco do personagem, o mesmo seed funciona como uma âncora de identidade que reduz de forma significativa a variação de características.
As âncoras de estilo funcionam junto com o bloqueio de seed. São frases técnicas específicas que restringem o espaço da saída visual:
"Kodak Portra 400, 85mm f/1.8, natural light" puxa o modelo em direção à fotografia editorial"Rembrandt lighting, studio setup, white backdrop" fixa o esquema de iluminação"frontal portrait, eye-level camera" evita desvios indesejados de ângulo
Aplique essas âncoras de estilo de forma consistente em toda a série e, mesmo sem LoRA, você verá uma saída de personagem muito mais consistente.
Técnicas com imagem de referência
Vários fluxos de trabalho baseados em SDXL oferecem suporte a prompt por imagem ou injeção de referência de rosto. Nesses modos, você fornece uma imagem do seu personagem junto com o prompt de texto. O modelo usa as duas entradas para gerar, e a imagem fornece a geometria facial que o texto sozinho não consegue especificar com perfeição.
Essa técnica é especialmente poderosa quando combinada com o ControlNet. Use a imagem de referência como entrada de ControlNet de rosto/canny com peso entre 0,4 e 0,6 e deixe o prompt de texto cuidar da cena. O resultado: o rosto do personagem fica ancorado à sua referência, enquanto todo o resto responde à sua direção criativa.
💡 Dica: Para a imagem de referência, use um retrato limpo, frontal, com expressão neutra e iluminação chapada. Referências com iluminação de alto contraste ou dramática confundem o condicionamento e vazam para a iluminação da sua saída.
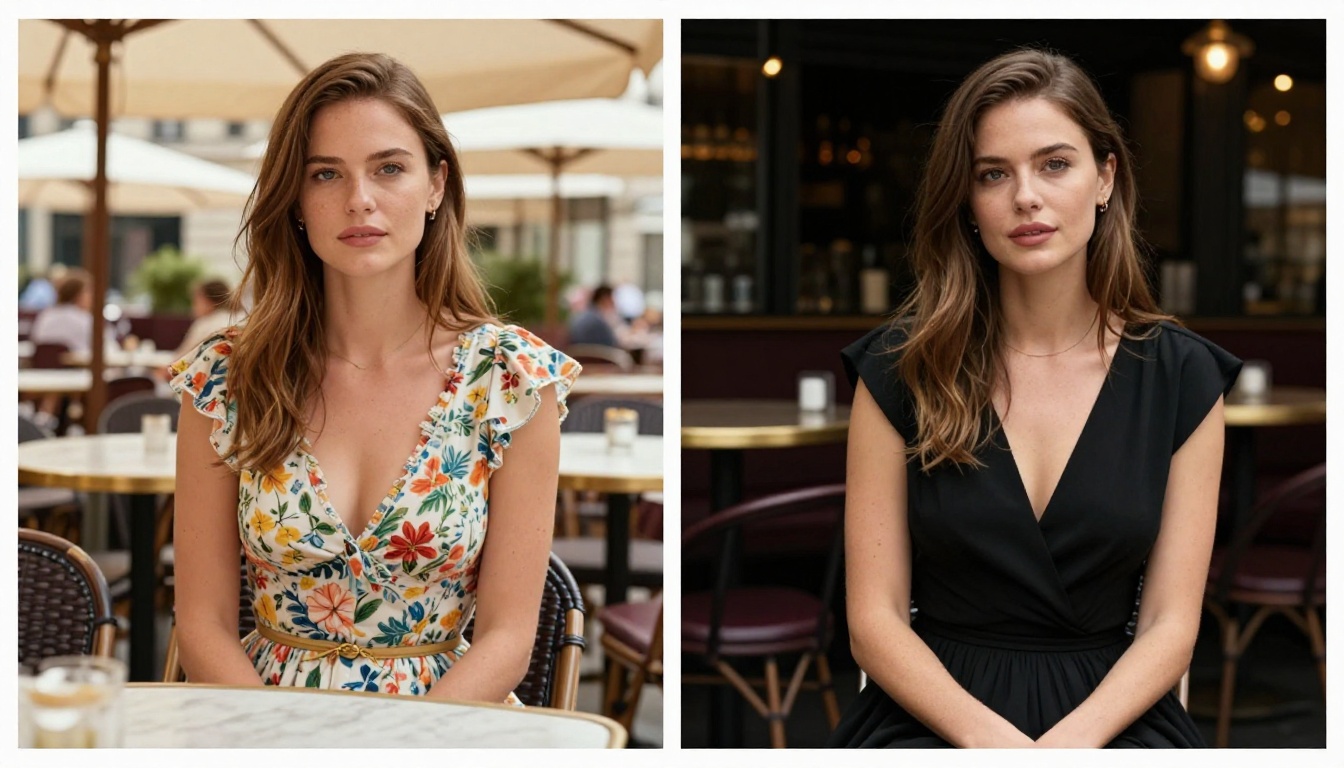
O papel do super-resolution
Depois de obter imagens consistentes do personagem, o fluxo de trabalho não para na geração. O upscaling de super-resolução preserva e realça os detalhes finos, a textura da pele, os fios de cabelo e a trama do tecido, que comprovam a consistência do personagem em impressões ou telas grandes.
As ferramentas de super-resolução disponíveis no PicassoIA podem ampliar de 2x a 4x preservando a granulação fotográfica e os detalhes da pele que fazem as imagens de personagens NSFW parecerem genuinamente reais, e não sinteticamente lisas. Passar suas imagens finais por um upscale de 2x é a etapa de acabamento profissional que separa séries de personagens refinadas de saídas brutas.
De modo semelhante, se alguma imagem gerada apresentar artefatos faciais ou uma anatomia um pouco fora do lugar, as ferramentas de inpainting podem corrigir regiões específicas cirurgicamente, sem regenerar a imagem inteira. Isso é especialmente útil para preservar uma ótima pose e expressão corporal enquanto corrige um formato de olho levemente inconsistente.
Erros comuns que quebram a consistência
Mesmo com os modelos certos, estes hábitos destroem a consistência do personagem:
- Alterar o descritor do personagem no meio da série: Mesmo pequenas mudanças de palavras alteram a forma como o modelo interpreta o personagem. Escreva uma vez, congele e cole em todo lugar.
- Ignorar os prompts negativos: Sem prompts negativos que bloqueiem deformações e estilos de desenho animado, os modelos derivam para seus vieses padrão. Inclua sempre
"deformed, blurry, cartoon, illustration, painting" nos negativos.
- Trocar de modelo no meio da série: Cada modelo tem sua própria interpretação do mesmo prompt. Trocar de modelo significa recomeçar a calibração do personagem.
- Descrever a cena em excesso: Quando a descrição da cena supera o bloco do personagem em extensão, o modelo prioriza a cena em vez do personagem. Mantenha as descrições de cena mais curtas que o bloco do personagem.
- Não gerenciar o seed: Sem o bloqueio de seed, cada geração é uma nova loteria. O seed é gratuito para usar e leva três segundos para anotar. Salve sempre.
Comece a criar sua própria série de personagens
A tecnologia para produzir imagens de personagens NSFW consistentes e bonitas já existe e está totalmente acessível. Os modelos listados aqui estão todos disponíveis no PicassoIA, onde você pode executar o Flux 1.1 Pro Ultra, o Realistic Vision v5.1, o SDXL Multi-ControlNet LoRA e a suíte completa de geradores com suporte a LoRA em um só lugar.
Comece com um personagem que você consiga descrever em detalhes. Escreva o bloco descritor. Escolha um seed. Gere dez variações do mesmo personagem em cenas diferentes. Refine o bloco com base no que o modelo responde. Depois de algumas iterações, você terá uma fórmula de personagem confiável que sempre produz resultados consistentes.
A distância entre "imagem com IA" e "série de personagens com IA" não é a tecnologia. É o fluxo de trabalho. Agora você tem ele.