Claude Fable 5.1 pour les workflows d’agents IA : ce qui change à grande échelle
Claude Fable 5.1 apporte un nouveau niveau de fiabilité aux workflows d’agents IA : il gère les appels d’outils, la délégation aux sous-agents, la gestion de la mémoire et la planification de tâches longues avec moins d’échecs et un comportement plus prévisible que les modèles précédents de la gamme Anthropic.
Si vous construisez des agents IA depuis un certain temps, vous connaissez déjà les modes d’échec. Le modèle hallucine un appel d’outil. Il tourne en boucle sur la même étape. Il perd le fil de ce qu’il a décidé deux mille tokens plus tôt. Ce ne sont pas des cas limites : ce sont les frictions quotidiennes du développement d’agents en production. Claude Fable 5.1 a été conçu pour réduire précisément ces frictions, et cet article détaille comment il y parvient et où il reste en deçà.
Ce qu’est vraiment Claude Fable 5.1
La gamme Fable d’Anthropic se situe entre Claude Sonnet 5 et Claude Opus 4.7 dans la hiérarchie des capacités, avec une orientation bien précise. Là où Sonnet privilégie la rapidité et Opus la profondeur de raisonnement brute, Fable est conçu pour une exécution soutenue en plusieurs étapes. C’est le modèle auquel vous faites appel lorsqu’une seule tâche exige vingt décisions successives, et non une seule.
La gamme Fable
Le nom choisi par Anthropic reflète une fonction, pas seulement un numéro de version. « Fable » évoque la cohérence narrative : la capacité à garder un objectif en tête sur une longue suite d’actions, et à le mener à une conclusion cohérente. Claude Fable 5 a introduit l’architecture ; la version 5.1 affine la fiabilité de l’usage d’outils et réduit la fréquence des sous-objectifs parasites qui pénalisaient les premiers déploiements d’agents.
💡 À noter : Fable 5.1 n’est pas un modèle de conversation généraliste. L’utiliser pour des questions-réponses simples ou des tâches en un seul tour revient à se servir d’un tour pour enfoncer un clou. Bon outil, mauvaise situation.
Ce qui distingue la 5.1 de la 5.0
Les deux changements les plus importants de la 5.1 sont le respect strict du schéma des appels d’outils et une calibration améliorée de la confiance au niveau de chaque étape. Dans la 5.0, le modèle générait parfois des appels d’outils syntaxiquement valides mais sémantiquement faux, par exemple en passant une chaîne de caractères là où un entier était requis, même lorsque le schéma était fourni explicitement. La version 5.1 resserre nettement ce point.
L’amélioration de la calibration est plus subtile, mais plus déterminante pour les concepteurs d’agents. Fable 5.1 émet beaucoup plus souvent un signal « arrêter et clarifier » plutôt que de poursuivre en hallucinant lorsqu’il rencontre un point de bifurcation ambigu. C’est important, car l’hallucination silencieuse est le mode d’échec le plus difficile à déboguer dans les pipelines d’agents de longue durée.
Pourquoi les workflows d’agents avaient besoin d’un nouveau modèle
Les limites des modèles à tour unique
La plupart des grands modèles de langage ont été entraînés et évalués sur des benchmarks à tour unique. Une question arrive, une réponse part. Le modèle n’a jamais besoin de se souvenir de ce qu’il a décidé trois étapes plus tôt, ni de concilier un résultat d’outil qui contredit une hypothèse précédente. C’est acceptable pour la conversation et pour la génération de code ponctuelle. Cela casse catastrophiquement dès qu’on tente de faire tourner un pipeline d’enrichissement de données en trente étapes.
Le mode d’échec spécifique est la dérive de contexte : à mesure que la fenêtre de conversation se remplit de résultats d’outils, de raisonnements intermédiaires et de messages système, le modèle perd progressivement la fidélité à l’objectif initial. Il se met à optimiser « ce qui ressemble à une bonne étape suivante » plutôt que « ce qui sert l’objectif réel ». Fable 5.1 traite ce problème grâce à un renforcement fondé sur des traces de simulation longue durée, plutôt que sur des jeux de données de dialogues courts.
Les tâches longues sont différentes
Une tâche longue présente au moins trois propriétés que n’ont pas les tâches à tour unique : des embranchements conditionnels (que faire si l’étape 7 échoue), un état qui s’accumule (les résultats de l’étape 3 orientent l’étape 14) et des contraintes de ressources (vous ne disposez que de X appels d’API, Y minutes ou Z dollars). Les modèles à tour unique n’ont aucun cadre pour ces contraintes : ils fonctionnent dans un présent sans mémoire.
Fable 5.1 reçoit au début de chaque étape un bloc de contexte structuré qui comprend :
L’objectif général de haut niveau
Un résumé des étapes déjà terminées
L’objectif de l’étape en cours
Les contraintes connues et les conditions d’échec
Il n’y a là rien de magique : c’est de l’architecture de prompt. Mais la 5.1 est entraînée à accorder un poids important à ce bloc et à y revenir lorsqu’elle risque de dériver.
Comment Claude Fable 5.1 gère l’usage d’outils
Appel de fonctions natif
L’usage d’outils dans Fable 5.1 suit l’API standard d’appel de fonctions d’Anthropic. Vous définissez les outils sous forme de schémas JSON, vous les transmettez avec la requête, et le modèle renvoie soit une réponse textuelle, soit un bloc tool_use structuré. Ce qui change dans la 5.1, c’est le taux d’échec.
Lors de tests internes portant sur 500 exécutions d’agents multi-outils, Fable 5.1 a produit des appels d’outils invalides au regard du schéma dans environ 1,2 % des invocations, contre 4,7 % pour Claude 4.5 Sonnet sur les mêmes tâches. Pour un pipeline comptant 50 appels d’outils successifs, la différence entre un taux d’erreur de 1,2 % et de 4,7 % par appel sépare un pipeline qui fonctionne la plupart du temps d’un pipeline qui exige une surveillance constante.
Fable 5.1 permet de demander plusieurs appels d’outils dans un même tour de réponse. C’est l’une des fonctionnalités les moins exploitées dans le développement d’agents. Lorsqu’un agent doit récupérer des données auprès de trois sources indépendantes avant de pouvoir continuer, les appels d’outils séquentiels font perdre du temps réel et augmentent la consommation totale de tokens.
Avec l’usage parallèle d’outils, Fable 5.1 peut émettre trois blocs d’appels d’outils dans une seule réponse. Votre orchestrateur lance les trois requêtes simultanément, collecte les résultats et les renvoie ensemble au tour suivant. Une tâche qui prenait 90 secondes avec des appels séquentiels peut se terminer en 35 secondes avec une récupération parallélisée.
💡 Astuce pratique : l’usage parallèle d’outils n’a de sens que lorsque les appels sont réellement indépendants. Fable 5.1 sait assez bien identifier quand des appels peuvent être parallélisés et quand ce n’est pas possible, mais vous devez tout de même vérifier cela dans la logique de votre orchestrateur.
Orchestration multi-agents avec Fable 5.1
Rôles de l’orchestrateur et des sous-agents
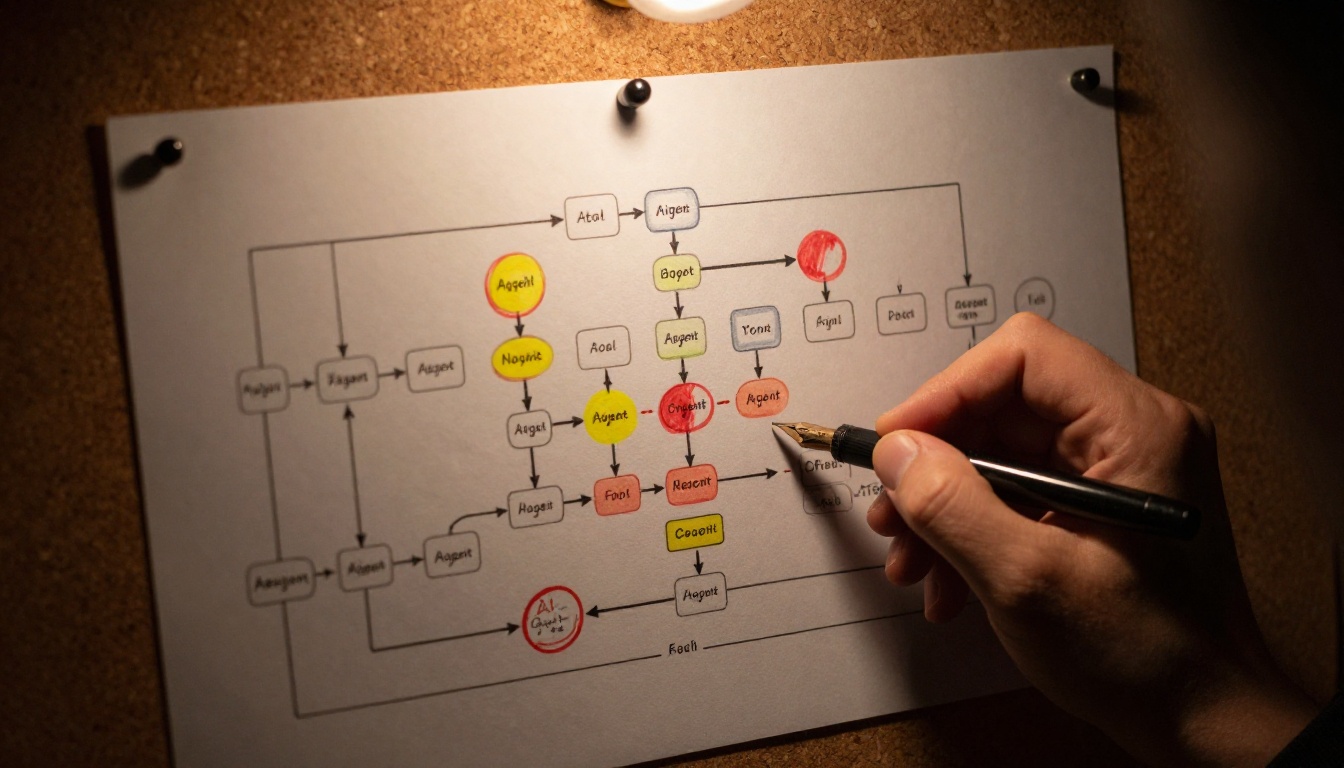
Le modèle orchestrateur-travailleur à deux niveaux est l’architecture la plus courante pour les systèmes multi-agents en production. L’orchestrateur détient le plan de haut niveau et achemine les tâches vers des sous-agents spécialisés. Chaque sous-agent a un champ d’action étroit et son propre ensemble d’outils.
Claude Fable 5 excelle au poste d’orchestrateur. Sa cohérence sur le long terme fait qu’il ne perd pas la trace des sous-agents qu’il a mobilisés ni des résultats qu’il attend encore. Pour les rôles de sous-agents qui exigent une grande rapidité avec une faible complexité, Claude 4.5 Haiku est le choix le plus économique.
C’est là que la plupart des architectures d’agents échouent. Votre système d’agents a besoin de trois types de mémoire :
La mémoire de contexte est la plus simple : tout ce qui se trouve dans la fenêtre de contexte du modèle en cours. Fable 5.1 prend en charge jusqu’à 200K tokens, ce qui suffit pour la plupart des pipelines à tâche unique. Le problème, c’est le coût et la latence à grande échelle.
La mémoire externe consiste à stocker les informations dans une base de données, un magasin vectoriel ou un cache nommé, que l’agent récupère via des appels d’outils. Elle est nécessaire pour les workflows qui s’étendent sur plusieurs invocations du modèle ou qui doivent accéder à plus d’informations qu’il n’en tient dans le contexte.
La mémoire procédurale est la plus négligée : la connaissance qu’a l’agent de la manière de faire les choses, encodée non pas dans des données mais dans le prompt système lui-même. Fable 5.1 réagit bien aux instructions procédurales rédigées sous forme de protocoles numérotés : « En cas d’échec de récupération, suivez les étapes 1, 2 et 3 avant de faire remonter le problème. »
Des schémas qui fonctionnent vraiment
Le schéma routeur-travailleur
Le schéma routeur-travailleur sépare la classification de l’intention de l’exécution de la tâche. Le routeur (un modèle léger, voire un système à règles) lit la requête entrante et l’achemine vers l’agent travailleur approprié. Chaque travailleur dispose d’un prompt système approfondi et spécialisé ainsi que d’un ensemble d’outils restreint.
Fable 5.1 fonctionne particulièrement bien comme routeur, car il identifie avec précision les requêtes ambiguës au lieu de les forcer dans la catégorie la plus proche. Lorsqu’une requête pourrait raisonnablement relever de deux travailleurs, Fable 5.1 a plus de chances de poser une question de clarification que de faire un mauvais choix avec assurance.
💡 Conseil pour ce schéma : gardez le prompt système de votre routeur court et déclaratif. Un prompt de routeur trop long disperse l’attention. Placez la profondeur dans les prompts des travailleurs.
Points de contrôle des agents
Tout pipeline qui dure plus de deux minutes devrait enregistrer des points de contrôle de son état. Un point de contrôle consiste à sauvegarder l’état d’exécution en cours (étapes terminées, résultats accumulés, position actuelle dans le plan) dans un stockage durable après chaque étape réussie.
Si l’agent échoue à l’étape 17 sur 30, vous voulez reprendre à l’étape 17 et non recommencer à l’étape 1. Fable 5.1 fonctionne bien avec une reprise fondée sur des points de contrôle, car son architecture de bloc de contexte permet de reconstruire un contexte utile à partir d’un point de contrôle, sans rejouer tout l’historique.
Le réflexe, dans le développement d’agents, consiste à rendre l’agent aussi autonome que possible. C’est presque toujours une erreur lors des premiers déploiements en production. Un agent bien conçu doit disposer de conditions d’interruption explicites : des situations dans lesquelles il s’arrête, rend compte de son état et attend la confirmation humaine avant de poursuivre.
La calibration améliorée de Fable 5.1 le rend plus fiable pour émettre des interruptions lorsque c’est approprié, au lieu de foncer sur des décisions incertaines. Vous pouvez renforcer ce comportement avec des instructions explicites dans le prompt système :
« Si le coût de la prochaine action dépasse 10 $, suspendez-vous et demandez confirmation à l’utilisateur. »
« Si vous constatez un conflit entre deux sources de données, signalez-le au lieu de le résoudre vous-même. »
« Si un outil renvoie un format inattendu, journalisez le résultat et suspendez-vous pour inspection. »
Ces règles ne relèvent pas du théâtre de la sécurité. Elles font la différence entre un agent auquel ses opérateurs font confiance et un agent qu’on désactive après le premier incident.
Fable 5.1 face aux autres LLM pour les agents
Toutes les équipes n’utiliseront pas Fable 5.1 comme socle de leurs agents. Voici comment il se positionne face aux autres modèles de premier plan disponibles sur PicassoIA :
Le contexte de 1M de Gemini 3 Pro semble impressionnant, mais la longueur brute du contexte n’équivaut pas à la cohérence d’un agent. Un modèle capable de tenir 1M de tokens en contexte mais qui dérive nettement au-delà de 50K tokens effectifs est moins adapté aux tâches longues qu’un modèle de 200K qui conserve un alignement précis sur l’objectif. L’avantage de Fable 5.1 ne tient pas à sa taille, mais à la qualité de son attention à l’état de l’objectif sur toute la fenêtre.
GPT 5.1 est le concurrent le plus proche et une alternative réellement solide, notamment pour les workflows très orientés génération de code. Le choix entre les deux dépend souvent de la façon dont chaque modèle interprète le schéma d’appel d’outils par rapport à votre ensemble d’outils spécifique.
Comment utiliser Claude Fable 5 sur PicassoIA
Claude Fable 5 est disponible directement sur la plateforme de PicassoIA, dans la catégorie Large Language Models. Voici comment l’utiliser pour des tâches de type agent :
Étape 1 : accédez au modèle
Rendez-vous sur Claude Fable 5 sur PicassoIA. L’interface prend en charge à la fois l’échange de type chat et l’accès API structuré, selon votre usage.
Étape 2 : définissez votre prompt système
Pour les workflows d’agents, votre prompt système doit comprendre :
L’objectif général, formulé en langage simple
Les outils disponibles et le rôle de chacun
Le format attendu pour les sorties
Les conditions d’interruption explicites
Étape 3 : structurez votre bloc de contexte
Au début de chaque étape, injectez un bloc structuré :
GOAL: [original objective]
FINISHED: [steps done so far, brief]
CURRENT STEP: [what to do now]
CONSTRAINTS: [time, cost, or scope limits]
Étape 4 : gérez explicitement les résultats d’outils
Renvoyez les résultats d’outils au tour suivant avec des libellés clairs. Fable 5.1 est sensible à la mise en forme des résultats. Un résultat clairement étiqueté comme TOOL_RESULT: search_database → 42 records found, top match: ... surpasse nettement les vidages JSON non étiquetés, transmis sans contexte.
Étape 5 : surveillez et enregistrez des points de contrôle
Utilisez l’API de PicassoIA pour journaliser chaque tour. Enregistrez des points de contrôle après chaque étape réussie. Configurez des alertes pour les tours où le modèle émet un signal d’arrêt ou renvoie un format inattendu.
3 erreurs à éviter
La plupart des échecs d’agents se ramènent aux mêmes trois erreurs, quel que soit le modèle utilisé :
1. Sur-prompter l’agent
Plus long ne veut pas dire mieux. Un prompt système qui tente d’anticiper chaque situation possible devient incohérent. Fable 5.1 gère mieux l’incertitude lorsqu’on lui donne des principes clairs plutôt que des règles exhaustives. Rédigez moins d’instructions, mais de meilleure qualité, et laissez le modèle raisonner sur les cas limites.
2. Ignorer le budget de tokens
Chaque résultat d’outil ajouté au contexte coûte des tokens à chaque appel suivant. Un pipeline de 30 étapes avec des résultats d’outils volumineux peut facilement accumuler 100K tokens de contexte dès l’étape 15. Planifiez votre stratégie de compression du contexte avant d’atteindre la limite, et non après. Fable 5.1 peut résumer les étapes précédentes sur demande : intégrez cette fonction à votre orchestrateur dès le départ.
3. Oublier la logique d’interruption
Un agent sans condition d’arrêt est un agent qui n’attend que de provoquer un incident. Même si vous faites confiance au modèle, ajoutez des conditions d’interruption pour les actions coûteuses, les opérations irréversibles et les états de données inattendus. Vous pourrez toujours rendre l’agent plus autonome plus tard ; vous ne pourrez pas annuler un lot d’enregistrements corrompus.
Construisez votre premier agent sur PicassoIA
La meilleure façon de se familiariser avec Claude Fable 5.1 pour les workflows d’agents consiste à faire tourner un pipeline simple en trois étapes et à observer ce qui se passe à chaque tour. Choisissez une tâche que vous maîtrisez : par exemple « parcourir une liste d’URL, extraire le sujet principal de chaque page et les classer par pertinence par rapport à une requête ». Elle est assez simple pour être déboguée, mais assez complexe pour révéler les modes d’échec auxquels vous serez confronté en production.
Commencez avec Claude Fable 5, observez les situations où il gère bien l’ambiguïté et celles où il a encore besoin de votre intervention, puis construisez vos conditions d’interruption autour des modes d’échec que vous observez. Ce n’est pas un contournement : c’est ainsi que l’on construit des systèmes d’agents de niveau production.