Claude Fable 5.1 para fluxos de trabalho com agentes de IA: o que muda em escala
O Claude Fable 5.1 traz um novo nível de confiabilidade aos fluxos de trabalho com agentes de IA, lidando com chamadas de ferramentas, delegação a sub-agentes, gerenciamento de memória e planejamento de tarefas de longo horizonte com menos falhas e um comportamento mais previsível do que os modelos anteriores da linha da Anthropic.
Se você constrói agentes de IA há algum tempo, já conhece os modos de falha. O modelo inventa uma chamada de ferramenta. Entra em loop no mesmo passo. Perde o fio do que decidiu dois mil tokens atrás. Não são casos raros; são o atrito do dia a dia no desenvolvimento de agentes em produção. O Claude Fable 5.1 foi feito para reduzir exatamente esse atrito, e este artigo explica em detalhes como ele faz isso e onde ainda fica aquém.
O que é de fato o Claude Fable 5.1
A linha Fable da Anthropic fica entre o Claude Sonnet 5 e o Claude Opus 4.7 na hierarquia de capacidades, mas com uma orientação específica. Enquanto o Sonnet otimiza para velocidade e o Opus para profundidade bruta de raciocínio, o Fable é construído em torno da execução sustentada em múltiplas etapas. É o modelo que você escolhe quando uma única tarefa exige vinte decisões sequenciais, e não uma só.
A linha de modelos Fable
A nomenclatura da Anthropic reflete função, e não apenas número de versão. "Fable" sinaliza coerência narrativa: a capacidade de manter um objetivo em mente ao longo de uma longa sequência de ações e levá-lo a uma conclusão consistente. O Claude Fable 5 introduziu a arquitetura; a versão 5.1 aprimora a confiabilidade no uso de ferramentas e reduz a frequência de criação espúria de sub-objetivos que atrapalhava as primeiras implantações de agentes.
💡 Vale saber: o Fable 5.1 não é um modelo de chat de uso geral. Usá-lo para perguntas e respostas simples ou tarefas de um único turno é como usar um torno para cravar um prego. Ferramenta certa, situação errada.
Como a 5.1 difere da 5.0
As duas mudanças mais significativas na 5.1 são a aplicação de esquema nas chamadas de ferramentas e a calibração de confiança em nível de passo aprimorada. Na 5.0, o modelo às vezes gerava chamadas de ferramentas sintaticamente válidas, mas semanticamente quebradas, como passar uma string onde era exigido um inteiro, mesmo quando o esquema havia sido fornecido explicitamente. A versão 5.1 aperta isso consideravelmente.
A melhoria de calibração é mais sutil, mas mais impactante para quem constrói agentes. O Fable 5.1 é bem mais propenso a emitir um sinal de "pare e esclareça" em vez de alucinar adiante ao encontrar um ponto de bifurcação ambíguo. Isso importa porque a alucinação silenciosa é o modo de falha mais difícil de depurar em pipelines de agentes de longa duração.
Por que os fluxos de agentes precisavam de um novo modelo
Os limites dos modelos de turno único
A maioria dos modelos de linguagem foi treinada e avaliada com benchmarks de turno único. Chega uma pergunta; sai uma resposta. O modelo nunca precisa lembrar o que decidiu três passos antes nem conciliar um resultado de ferramenta que contradiz sua suposição anterior. Isso funciona bem para chat e para geração de código pontual. Quebra de forma catastrófica quando você tenta rodar um pipeline de enriquecimento de dados com trinta passos.
O modo de falha específico é o desvio de contexto: à medida que a janela de conversa se enche de resultados de ferramentas, raciocínio intermediário e mensagens de sistema, o modelo perde progressivamente a fidelidade ao objetivo original. Ele passa a otimizar para "o que parece um bom próximo passo" em vez de "o que serve ao objetivo real". O Fable 5.1 trata isso com reforço a partir de traços de simulação de longo horizonte, e não de conjuntos de dados de diálogos curtos.
Tarefas de longo horizonte são diferentes
Uma tarefa de longo horizonte tem pelo menos três propriedades que tarefas de turno único não têm: ramificação condicional (o que fazer quando o passo 7 falha), estado acumulado (resultados do passo 3 informam o passo 14) e restrições de recursos (você só tem X chamadas de API, Y minutos ou Z dólares). Modelos de turno único não têm noção dessas restrições; eles operam em um presente sem estado.
O Fable 5.1 recebe um bloco de contexto estruturado no início de cada passo, que inclui:
O objetivo geral de alto nível
Um resumo dos passos já concluídos
O objetivo do passo atual
Restrições conhecidas e condições de falha
Não há mágica nisso; é arquitetura de prompt. Mas a 5.1 é treinada para dar peso elevado a esse bloco e voltar a ele quando, de outra forma, sairia do rumo.
Como o Claude Fable 5.1 lida com o uso de ferramentas
Chamada de função nativa
O uso de ferramentas no Fable 5.1 segue a API padrão de chamada de funções da Anthropic. Você define as ferramentas como esquemas JSON, envia-as com a requisição, e o modelo devolve uma resposta de texto ou um bloco tool_use estruturado. O que muda na 5.1 é a taxa de falha.
Em testes internos com um conjunto de 500 execuções de agentes com múltiplas ferramentas, o Fable 5.1 produziu chamadas de ferramentas inválidas segundo o esquema em cerca de 1,2% das invocações, contra 4,7% do Claude 4.5 Sonnet nas mesmas tarefas. Para um pipeline com 50 chamadas de ferramentas sequenciais, a diferença entre uma taxa de erro por chamada de 1,2% e de 4,7% separa um pipeline que quase sempre funciona de um que exige supervisão constante.
O Fable 5.1 aceita pedidos de várias chamadas de ferramentas em um único turno de resposta. Este é um dos recursos mais subutilizados no desenvolvimento de agentes. Quando um agente precisa buscar dados em três fontes independentes antes de seguir adiante, chamadas sequenciais desperdiçam tempo e aumentam o uso total de tokens.
Com o uso paralelo de ferramentas, o Fable 5.1 pode emitir três blocos de chamada de ferramenta em uma só resposta. Seu orquestrador dispara as três requisições simultaneamente, reúne os resultados e os devolve juntos no turno seguinte. Uma tarefa que levava 90 segundos com chamadas sequenciais pode terminar em 35 segundos com a busca paralelizada.
💡 Dica prática: o uso paralelo de ferramentas só faz sentido quando as chamadas são de fato independentes. O Fable 5.1 é bom em identificar quando as chamadas podem ser paralelizadas e quando não podem, mas você ainda deve validar isso na lógica do seu orquestrador.
Orquestração multiagente com o Fable 5.1
Papéis de orquestrador e sub-agente
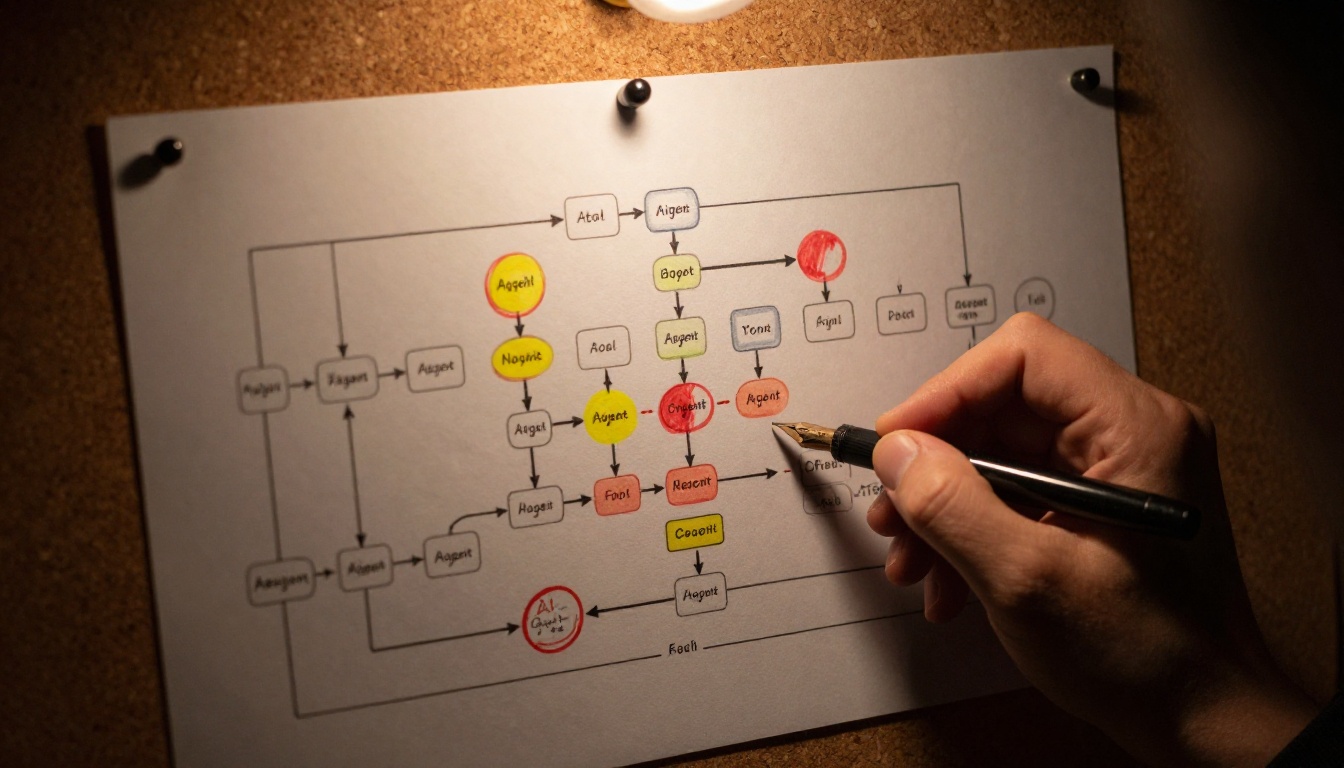
O padrão orquestrador-trabalhador em dois níveis é a arquitetura mais comum em sistemas multiagente de produção. O orquestrador mantém o plano de alto nível e direciona tarefas a sub-agentes especializados. Cada sub-agente tem um foco estreito e seu próprio conjunto de ferramentas.
O Claude Fable 5 se destaca na posição de orquestrador. Sua coerência de longo horizonte significa que ele não perde o controle de quais sub-agentes despachou nem dos resultados que ainda aguarda. Para papéis de sub-agente que exigem alta velocidade com baixa complexidade, o Claude 4.5 Haiku é a escolha mais econômica.
É aqui que a maioria das arquiteturas de agentes erra. Há três tipos de memória de que o seu sistema de agentes precisa:
A memória em contexto é a mais simples: tudo o que está na janela de contexto atual do modelo. O Fable 5.1 suporta até 200 mil tokens, o que basta para a maioria dos pipelines de tarefa única. O problema são o custo e a latência em escala.
A memória externa significa armazenar informações em um banco de dados, em um armazenamento vetorial ou em um cache nomeado, que o agente recupera por meio de chamadas de ferramentas. Isso é necessário para fluxos que se estendem por várias invocações do modelo ou que precisam acessar mais informações do que cabe no contexto.
A memória procedural é a mais negligenciada: o conhecimento do agente sobre como fazer as coisas, codificado não em dados, mas no próprio prompt de sistema. O Fable 5.1 responde bem a instruções procedurais escritas como protocolos numerados: "Quando encontrar uma falha de recuperação, execute os passos 1, 2 e 3 antes de escalar."
Padrões reais que funcionam
O padrão roteador-trabalhador
O padrão roteador-trabalhador separa a classificação de intenção da execução da tarefa. O roteador (um modelo leve ou, até, um sistema baseado em regras) lê a requisição recebida e a encaminha para o agente trabalhador apropriado. Cada trabalhador tem um prompt de sistema profundo e especializado e um conjunto de ferramentas restrito.
O Fable 5.1 funciona especialmente bem como roteador porque identifica com precisão requisições ambíguas, em vez de forçá-las para a categoria mais próxima. Quando uma requisição poderia plausivelmente pertencer a dois trabalhadores, o Fable 5.1 tem mais chance de fazer uma pergunta de esclarecimento do que de fazer uma escolha errada com confiança.
💡 Dica de padrão: mantenha o prompt de sistema do seu roteador curto e declarativo. Prompts de roteador longos dispersam a atenção. Coloque a profundidade nos prompts dos trabalhadores.
Checkpoints de agentes
Todo pipeline que roda por mais de dois minutos deve salvar o seu estado em checkpoints. Fazer checkpoint significa gravar o estado atual da execução (passos concluídos, resultados acumulados, posição atual no plano) em armazenamento durável após cada passo bem-sucedido.
Se o agente falhar no passo 17 de 30, você quer retomar a partir do passo 17, e não recomeçar do passo 1. O Fable 5.1 funciona bem com retomada baseada em checkpoints, porque a arquitetura de bloco de contexto significa que você pode reconstruir um contexto útil a partir de um checkpoint sem reproduzir o histórico completo.
O instinto no desenvolvimento de agentes é tornar o agente o mais autônomo possível. Isso quase sempre é um erro nas primeiras implantações em produção. Um agente bem projetado deve ter condições de interrupção explícitas: situações em que ele pausa, relata seu estado atual e aguarda a confirmação humana antes de prosseguir.
A calibração aprimorada do Fable 5.1 o torna mais confiável ao emitir interrupções quando apropriado, em vez de atropelar decisões incertas. Você pode reforçar isso com instruções explícitas no prompt de sistema:
"Se o custo da próxima ação ultrapassar US$ 10, pause e confirme com o usuário."
"Se você encontrar um conflito entre duas fontes de dados, relate-o em vez de resolvê-lo sozinho."
"Se uma ferramenta retornar um formato inesperado, registre o resultado e pause para inspeção."
Isso não é teatro de segurança. É a diferença entre um agente em que os operadores confiam e um que é desligado após o primeiro incidente.
Fable 5.1 ou outros LLMs para agentes
Nem todas as equipes vão usar o Fable 5.1 como base de seus agentes. Veja como ele se compara a outros modelos de ponta disponíveis no PicassoIA:
O contexto de 1M do Gemini 3 Pro soa impressionante, mas o tamanho bruto do contexto não é o mesmo que coerência de agente. Um modelo que comporta 1M de tokens no contexto, mas se desvia muito após 50 mil tokens efetivos, é pior para tarefas de longo horizonte do que um modelo de 200K que mantém um alinhamento preciso com o objetivo. A vantagem do Fable 5.1 não está no tamanho; está na qualidade da atenção ao estado do objetivo em toda a janela.
O GPT 5.1 é o concorrente mais próximo e uma alternativa realmente forte, especialmente para fluxos com muita geração de código. A escolha entre os dois muitas vezes depende de qual modelo interpreta melhor o esquema de chamadas de ferramentas em relação ao seu conjunto específico de ferramentas.
Como usar o Claude Fable 5 no PicassoIA
O Claude Fable 5 está disponível diretamente na plataforma do PicassoIA, na categoria Large Language Models. Veja como colocá-lo para trabalhar em tarefas no estilo de agente:
Passo 1: acesse o modelo
Vá até o Claude Fable 5 no PicassoIA. A interface oferece tanto interação no estilo chat quanto acesso estruturado por API, dependendo do seu caso de uso.
Passo 2: defina seu prompt de sistema
Para fluxos de agentes, seu prompt de sistema deve incluir:
O objetivo geral, em linguagem simples
As ferramentas disponíveis e o que cada uma faz
O formato esperado para as saídas
Condições de interrupção explícitas
Passo 3: estruture seu bloco de contexto
No início de cada passo, injete um bloco estruturado:
GOAL: [original objective]
FINISHED: [steps done so far, brief]
CURRENT STEP: [what to do now]
CONSTRAINTS: [time, cost, or scope limits]
Passo 4: trate os resultados das ferramentas de forma explícita
Devolva os resultados das ferramentas no turno seguinte, com rótulos claros. O Fable 5.1 é sensível à formatação dos resultados. Um resultado claramente rotulado como TOOL_RESULT: search_database → 42 records found, top match: ... tem desempenho significativamente melhor do que despejos de JSON sem rótulos, passados sem contexto.
Passo 5: monitore e faça checkpoints
Use a API do PicassoIA para registrar cada turno. Grave checkpoints após os passos bem-sucedidos. Configure alertas para os turnos em que o modelo emitir um sinal de parada ou devolver um formato inesperado.
3 erros a evitar
A maioria das falhas de agentes se devem a esses mesmos três erros, independentemente do modelo que você usa:
1. Excesso de prompts para o agente
Mais longo não é melhor. Um prompt de sistema que tenta prever todas as situações possíveis fica incoerente. O Fable 5.1 lida melhor com a incerteza quando recebe princípios claros em vez de regras exaustivas. Escreva menos instruções, e mais fortes, e deixe o modelo raciocinar sobre os casos de borda.
2. Ignorar o orçamento de tokens
Cada resultado de ferramenta anexado ao contexto custa tokens em todas as chamadas seguintes. Um pipeline de 30 passos com resultados de ferramentas ricos pode facilmente acumular 100 mil tokens de contexto até o passo 15. Planeje sua estratégia de compressão de contexto antes de bater no limite, e não depois. O Fable 5.1 consegue resumir passos anteriores quando solicitado; incorpore isso ao seu orquestrador desde o início.
3. Pular a lógica de interrupção
Um agente sem condições de parada é um agente esperando para causar um incidente. Mesmo que você confie no modelo, adicione condições de interrupção para ações de alto custo, operações irreversíveis e estados de dados inesperados. Você sempre pode tornar o agente mais autônomo depois; não há como desfazer um lote de registros corrompidos.
Construa seu primeiro agente no PicassoIA
A melhor forma de se familiarizar com o Claude Fable 5.1 para fluxos de agentes é rodar um pipeline simples de três etapas e estudar o que acontece em cada turno. Escolha uma tarefa que você conheça bem: algo como "pesquisar uma lista de URLs, extrair o tema principal de cada página e ordená-las por relevância para uma consulta". É simples o bastante para depurar, mas complexo o suficiente para expor os modos de falha que você vai enfrentar em produção.
Comece com o Claude Fable 5, observe onde ele lida bem com a ambiguidade e onde ainda precisa da sua intervenção, e construa suas condições de interrupção em torno dos modos de falha específicos que você observar. Isso não é um contorno; é assim que sistemas de agentes de nível de produção são construídos.