La première fois que la plupart des gens ont vu une vidéo Seedance 2.0, ils ont cru qu’elle avait été tournée par des professionnels. Le mouvement est fluide. La texture de la peau accroche la lumière d’une façon qui donne une impression tactile. Le rendu global a un poids cinématographique que les modèles d’IA précédents n’ont jamais réussi à s’en approcher. Si vous cherchez cette qualité pour vos propres projets de vidéos IA NSFW, cet article vous explique exactement comment y parvenir : quels modèles utiliser, comment écrire des prompts qui produisent réellement un rendu cinématographique, et le flux de travail qui sépare un résultat générique d’un résultat qui semble tourné sur un vrai plateau.
Ce qui distingue Seedance 2.0
Seedance 2.0 est un modèle de texte et d’image vers vidéo développé par ByteDance. Ce n’est pas le seul concurrent sérieux dans ce domaine, mais il fixe actuellement la référence pour le mouvement réaliste dans les contenus suggestifs ou adultes. Cela tient à trois éléments : la cohérence temporelle, le naturel du mouvement et la fidélité du rendu de la peau.
Le problème de la cohérence temporelle
La plupart des générateurs vidéo IA peinent sur ce qu’on appelle la cohérence temporelle, c’est-à-dire la constance d’un sujet d’une image à la suivante. Un visage qui se déforme légèrement d’une image à l’autre, des cheveux qui scintillent ou des vêtements qui se tordent trahissent une génération par IA. C’est particulièrement visible dans les plans rapprochés et les portraits, là où le spectateur observe activement le sujet.
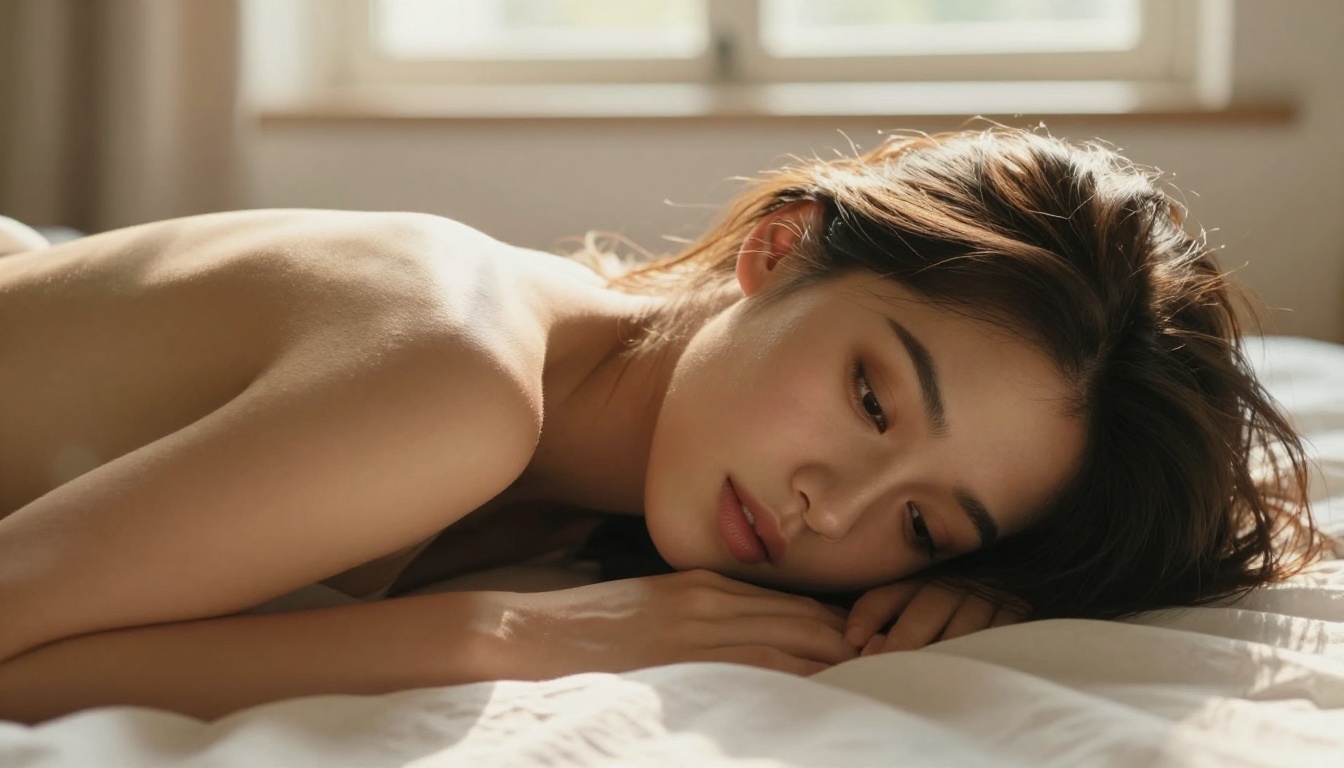
Seedance 2.0 gère ce problème nettement mieux que ses prédécesseurs. Les visages conservent leur structure lors des mouvements complets de la tête. Les cheveux suivent des trajectoires physiquement plausibles. La teinte de la peau ne fluctue pas quand la lumière change. Le résultat est une vidéo qui paraît captée plutôt que synthétisée.
Le rendu de la peau et des textures
C’est sans doute là que Seedance 2.0 s’impose le plus nettement. Le modèle restitue les micro-détails de la peau avec une précision que les modèles précédents ne parvenaient pas à maintenir pendant le mouvement. Vous obtenez :
- Une diffusion sous-cutanée naturelle sur les zones de peau claire
- Un comportement réaliste des ombres de pores sous un éclairage directionnel
- Un contact précis entre tissu et peau (les vêtements suivent le corps, sans flotter au-dessus)
- Un micro-mouvement des mèches de cheveux qui réagit à une physique suggérée
Pour les contenus NSFW en particulier, cette exactitude physique fait la différence entre « ça ressemble à une scène de jeu vidéo » et « ça ressemble à une vraie personne ».
L’intégration du son natif
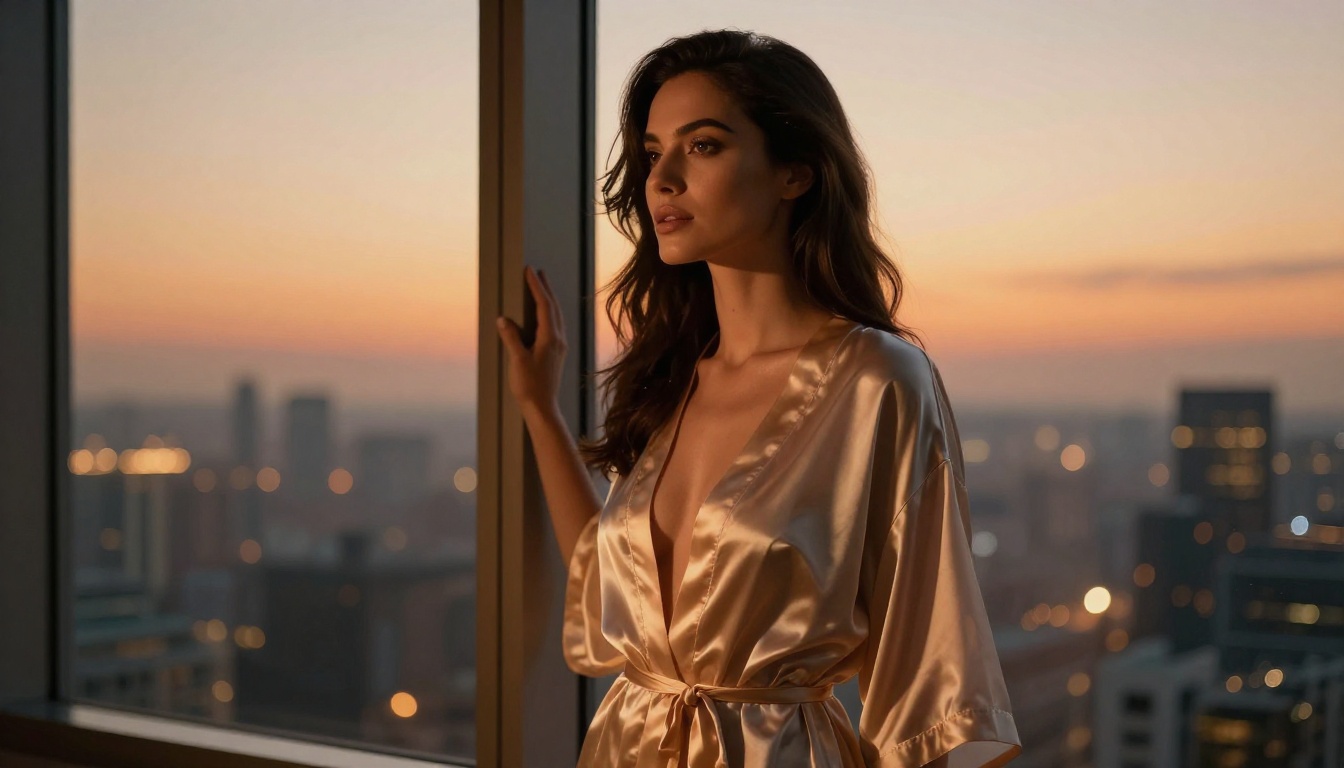
Un point souvent négligé : Seedance 2.0 génère avec un son natif. Les ambiances sonores, la respiration et les sons d’environnement peuvent être présents dans le rendu sans aucun post-traitement. Pour la création de vidéos NSFW immersives, cela augmente fortement la valeur de production, sans effort supplémentaire de votre part.
💡 Astuce : Utilisez Seedance 2.0 Fast pour vos 3 à 4 premières itérations de prompt. Ne passez à la version complète que lorsque le concept vous satisfait. C’est le moyen le plus rapide d’itérer sans consommer inutilement vos crédits.
L’architecture des prompts pour un rendu cinématographique
Obtenir un rendu NSFW cinématographique avec n’importe quel modèle relève presque entièrement du problème de prompt. Le modèle ne peut restituer que ce que vous décrivez. Des prompts vagues donnent des résultats vagues. Voici comment construire des prompts qui livrent régulièrement.
La structure de prompt en cinq couches
Considérez chaque prompt comme une structure à cinq couches, chacune responsable d’une dimension différente du résultat :
| Couche | Ce qu’elle couvre | Exemple |
|---|
| Sujet | Qui, ce qu’il ou elle porte, position du corps | « femme en peignoir de satin noir, assise au bord du lit » |
| Environnement | Cadre, détails de l’arrière-plan | « chambre d’hôtel de charme faiblement éclairée, lumières de la ville à travers des rideaux transparents » |
| Éclairage | Source, direction, qualité | « unique lampe de chevet chaude à droite, contre-jour doux qui souligne l’épaule » |
| Caméra | Angle, objectif, mouvement | « plan moyen, 85 mm, travelling lent vers l’avant » |
| Atmosphère | Ambiance, style cinéma, texture | « Kodak Portra 800, grain cinématographique, étalonnage de fin de soirée » |
Il suffit d’une seule couche manquante pour obtenir le plus souvent un résultat plat et générique. L’éclairage et l’atmosphère sont les deux couches que la plupart des gens oublient, et ce sont celles qui pèsent le plus dans l’effet « IA bon marché ».
Ce qu’il ne faut pas écrire
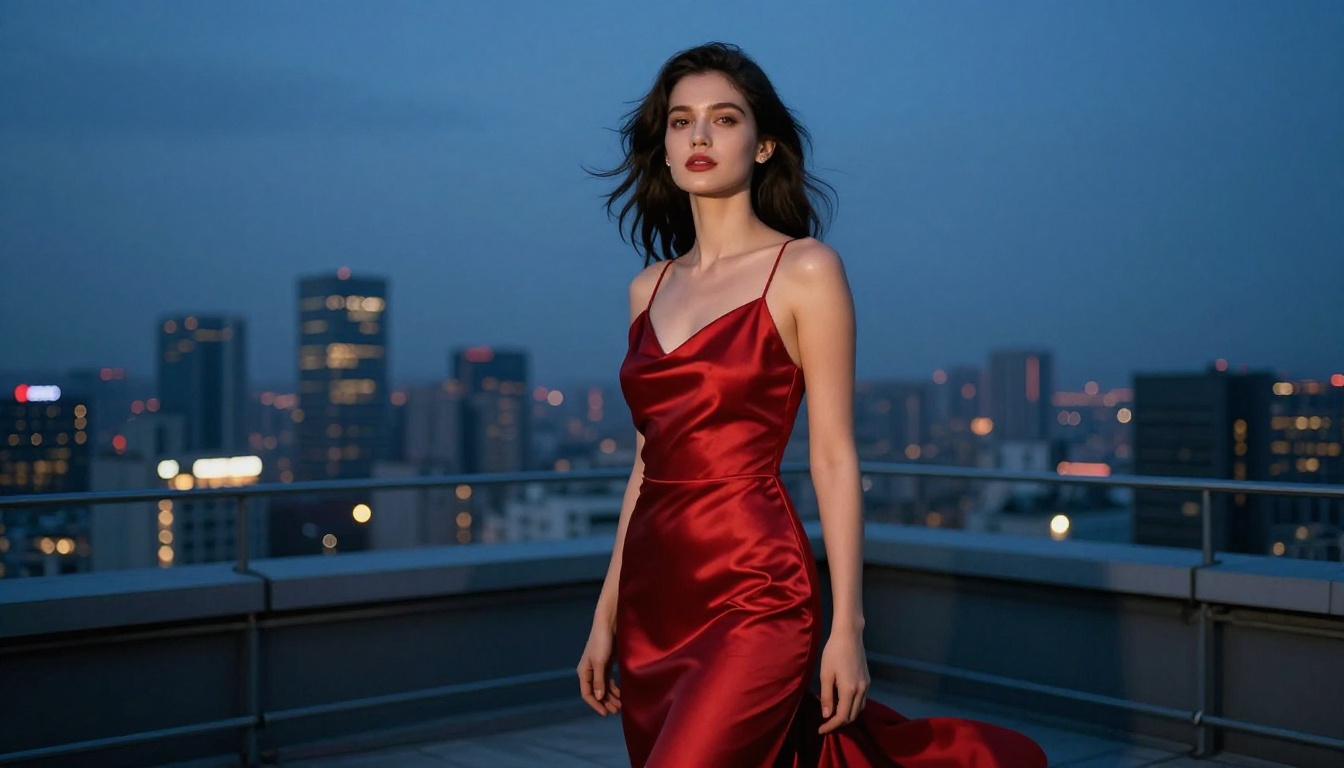
L’erreur la plus fréquente consiste à rédiger des prompts NSFW centrés sur le contenu explicite, en laissant tout le reste non spécifié. Le modèle n’a pas besoin de détails explicites pour produire un rendu sensuel. Il a besoin de détails cinématographiques.
Prompt faible : « femme sexy en lingerie, réaliste, 4k »
Prompt efficace : « femme élégante en combinaison de soie ivoire allongée contre une tête de lit sombre, lumière de fin de soirée provenant d’un lampadaire qui crée un dégradé chaud sur le tissu, plan moyen, 85 mm f/1.8, grain de film léger, intimité sombre et langoureuse, Kodak Portra 400 »
Le second prompt donne au modèle tout ce qu’il lui faut pour produire un rendu qui semble tourné en décor réel.
💡 Astuce : Décrivez le comportement de la lumière (comment elle tombe, où vont les ombres) plutôt que de simplement nommer les sources. « Une lueur de lampe chaude qui se répand sur l’épaule gauche et crée une ombre douce sur le bord du cou » donnera toujours de meilleurs résultats que « éclairage de lampe chaud ».
Les meilleurs modèles pour ce style aujourd’hui
Seedance 2.0 est la vedette, mais ce n’est pas le seul modèle qui mérite votre attention. Selon le type de scène, vos contraintes de vitesse et vos objectifs de rendu, voici le haut du panier actuel :
Seedance 2.0 (version complète)
Idéal pour un réalisme maximal, les rendus finaux, la fidélité de la peau et les plans rapprochés de portrait. Seedance 2.0 est aujourd’hui la référence. La génération est plus lente, mais l’écart de qualité est réel dès qu’on travaille à distance de portrait.
Wan 2.6 Texte vers vidéo
Wan 2.6 T2V gère remarquablement bien la simulation de profondeur de champ et la séparation entre arrière-plan et sujet. Utilisez-le pour les compositions de scène complexes, les plans d’environnement ou toute scène riche en profondeur spatiale.
Wan 2.6 Image vers vidéo
Wan 2.6 I2V part d’une image fixe et génère du mouvement à partir de celle-ci. Ce flux de travail est puissant pour les contenus NSFW, car vous pouvez d’abord générer une image fixe précise avec un modèle texte vers image, régler la composition exactement comme vous le souhaitez, puis l’animer. Un contrôle bien supérieur à la simple génération de texte vers vidéo pour des sujets sensibles ou précis.
Kling v3
Kling v3 excelle dans les mouvements physiquement convaincants : le mouvement des tissus, les cheveux qui bougent avec du poids et la dynamique naturelle du corps. Lorsque le mouvement est la priorité et que vous voulez cette impression de « tourné sur un vrai plateau », c’est le modèle à privilégier.
Hailuo 2.3
Hailuo 2.3 est le plus rapide des modèles haut de gamme. Quand vous avez besoin de volume plutôt que de perfection, ou que vous prototypez plusieurs variantes de scène avant de lancer un rendu final, c’est celui qui offre le meilleur équilibre entre vitesse et réalisme.
PixVerse v5.6
PixVerse v5.6 gère de façon exceptionnelle les scénarios dramatiques de lumière et d’ombre : prises de nuit, scènes à la bougie et éclairages intimes à fort contraste. Si votre scène repose davantage sur l’atmosphère que sur la complexité du mouvement, c’est un excellent choix.
LTX-2.3-Pro
LTX-2.3-Pro conserve sa qualité sur des durées vidéo plus longues mieux que la plupart des alternatives. Si vous construisez des séquences de plus de cinq secondes, ce modèle réduit la dégradation de qualité qui apparaît généralement dans les vidéos IA étendues.
Puisque Seedance 2.0 est le modèle autour duquel tout cet article est construit, voici le flux de travail direct pour obtenir les meilleurs résultats.
Étape 1 : choisir votre mode d’entrée
Sur la page de Seedance 2.0, vous verrez deux options d’entrée :
- Texte vers vidéo : construisez votre scène uniquement à partir d’un prompt écrit.
- Image vers vidéo : importez une image fixe de référence, puis décrivez le mouvement.
Pour un contenu NSFW de style cinématographique, image vers vidéo donne systématiquement des résultats plus propres, car vous avez déjà réglé le problème de composition avant que le modèle n’intervienne.
Étape 2 : rédiger un prompt en couches
Appliquez la structure en cinq couches. Ne sautez pas l’éclairage ni l’atmosphère. Voici un exemple concret :
« Femme en dentelle ivoire debout devant une fenêtre de balcon ouverte, lumière chaude de fin d’après-midi qui filtre à travers des rideaux transparents et projette des ombres parallèles douces sur la peau nue, plan moyen en contre-plongée, objectif 50 mm, légère brise visible dans les cheveux et le tissu, étalonnage couleur Kodak Portra 400, dérive lente de la caméra vers la gauche, grain cinématographique »
Étape 3 : régler la durée selon le type de scène
- Portraits en gros plan : 3 à 5 secondes. La qualité tient mieux avec des durées courtes.
- Plans d’environnement ou riches en mouvement : 8 à 10 secondes. Le contexte du mouvement a besoin de place pour se développer.
- Scènes intimes fixes avec mouvement subtil : 5 à 7 secondes, c’est le juste milieu.
Étape 4 : itérer en version rapide, finaliser en version complète
Utilisez Seedance 2.0 Fast pour vos premières tentatives, afin d’affiner le prompt. Ne passez à la version complète que lorsque vous avez validé la composition et l’éclairage. Cette méthode fait gagner beaucoup de temps et de ressources.
💡 Astuce : Tenez un journal personnel de vos prompts les plus performants. Une structure de prompt qui a donné un bon résultat pour une scène donnera généralement de bons résultats dans des configurations similaires. Les dispositifs d’éclairage, en particulier, se transposent bien d’un sujet à l’autre.
Le flux de travail par l’image d’abord
L’une des méthodes les plus fiables pour obtenir un résultat de niveau Seedance consiste à ne pas commencer par la vidéo. Commencez par la génération d’images.
Pourquoi cela fonctionne
Les modèles de texte vers vidéo doivent résoudre deux problèmes difficiles à la fois : à quoi ressemble l’image et comment elle bouge. Lorsque vous fournissez une image de référence solide, vous avez déjà résolu le premier problème. Le modèle peut concentrer toute sa capacité sur un mouvement convaincant, au lieu de partager son attention entre la conception visuelle et la cohérence temporelle.
Le processus en deux étapes
- Générez une image fixe photoréaliste avec un modèle texte vers image. Réglez le sujet, les vêtements, la pose et l’éclairage jusqu’à ce que le cadre soit exactement celui que vous voulez.
- Importez cette image dans Seedance 2.0 ou Wan 2.6 I2V avec un prompt centré sur le mouvement. Restez minimaliste : « léger mouvement de respiration », « mèches qui se soulèvent doucement sous une brise ambiante », « léger mouvement de la tête vers la caméra ».
Le résultat de ce flux de travail paraît nettement plus contrôlé que la seule génération de texte vers vidéo, surtout pour les contenus où la position précise du corps et la composition comptent.
Des dispositifs d’éclairage qui paraissent cinématographiques
Quel que soit le modèle utilisé, certaines descriptions d’éclairage produisent systématiquement un résultat qui paraît professionnel. Ces dispositifs fonctionnent parce qu’ils reprennent la logique de l’éclairage de cinéma réel, et les modèles ont assimilé assez de données filmiques pour les interpréter correctement.
Le dispositif trois points du cinéma
Décrivez une lumière principale, une lumière de remplissage et un contre-jour. Les modèles de génération vidéo IA comprennent le vocabulaire classique de l’éclairage cinématographique et y répondent de manière fiable.
« Lumière principale chaude au tungstène venant du haut à gauche, lumière d’ambiance douce depuis la droite pour effacer les ombres dures, contre-jour froid venant de l’arrière pour détacher le sujet de l’arrière-plan »
Cette seule phrase, dans n’importe quel prompt, oriente immédiatement le résultat vers une esthétique de film professionnelle.
Heure dorée en extérieur
Le scénario d’éclairage le plus indulgent pour un contenu NSFW est l’extérieur à l’heure dorée. Lumière chaude et diffuse, pas d’ombres dures, et une lumière qui flatte naturellement la peau, quelle que soit la distance. Décrivez-la précisément :
« Lumière dorée de fin d’après-midi venant de la gauche de la caméra, dominante orangée chaude sur la peau, longues ombres douces s’étirant à l’opposé du sujet, lumière réfléchie ambiante du sable et de l’eau qui remplit les zones d’ombre »
Bougies et ambiance faible
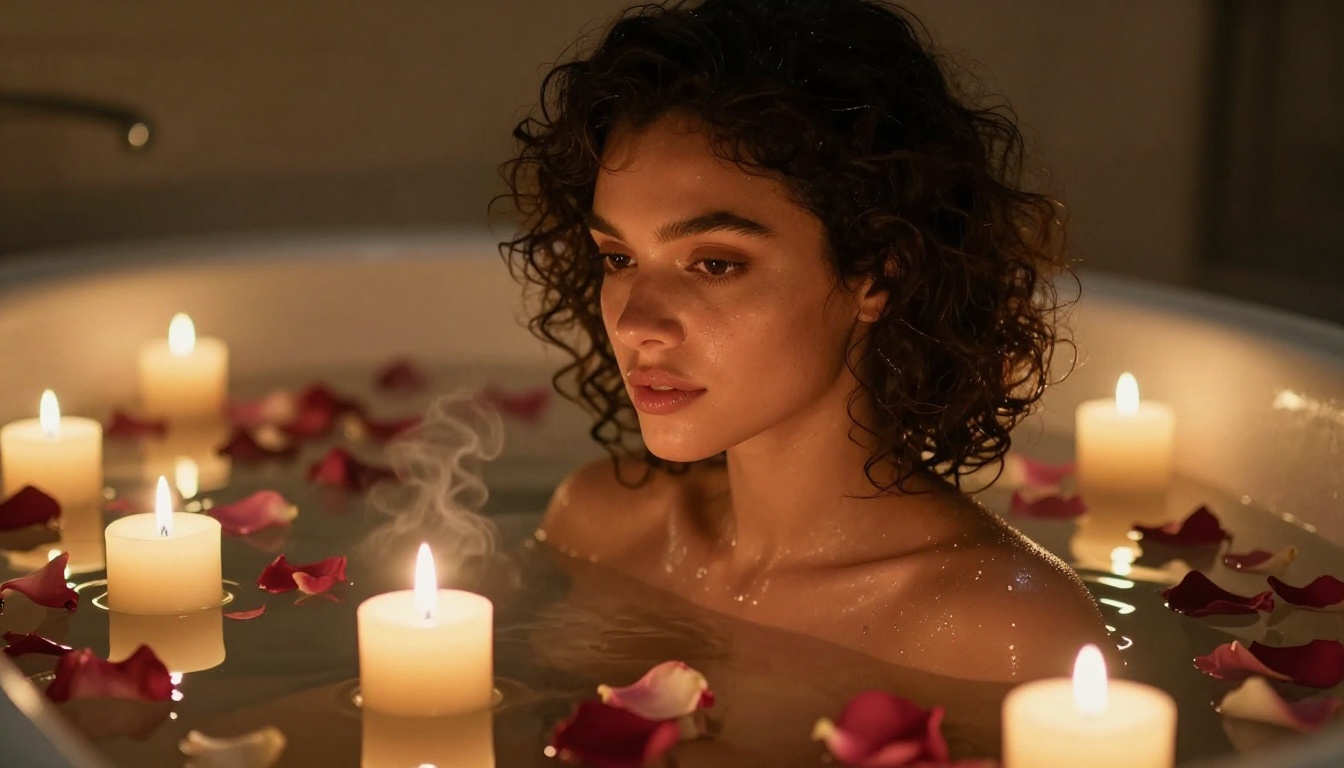
Pour les scènes intérieures intimes, les prompts à la bougie produisent des résultats remarquablement convaincants avec des modèles comme PixVerse v5.6 et Seedance 2.0 :
« Flamme d’une unique bougie comme source de lumière principale, lueur ambrée vacillante enveloppant le sujet depuis la droite, ombres naturelles profondes sur le côté gauche, léger reflet chaud sur la peau venant d’en bas »
La lumière de fenêtre : l’option polyvalente
La lumière douce et directionnelle d’une fenêtre est le dispositif le plus polyvalent. Contrôlable, naturelle et flatteuse quel que soit le teint de peau ou le tissu :
« Lumière du jour diffuse venant d’une grande fenêtre à gauche du cadre, ombres naturelles douces qui tombent sur le milieu du corps, lumière d’ambiance froide venant du mur opposé, ciel légèrement couvert donnant une qualité uniforme »
Les erreurs courantes qui brisent la qualité cinématographique
Même avec le bon modèle et un prompt solide, quelques erreurs récurrentes feront basculer le résultat dans le territoire de « manifestement IA ».
Trop de sujets
Chaque personne supplémentaire dans la scène multiplie la cohérence temporelle que le modèle doit maintenir. Deux personnes qui bougent dans le même cadre doublent les risques de scintillement ou de déformation. Pour un résultat plus propre, gardez les scènes NSFW centrées sur un seul sujet chaque fois que possible.
Descripteurs de style contradictoires
Mélanger des esthétiques de film (Kodak Portra, grain cinématographique, latitude de pose douce) avec des esthétiques numériques hyper nettes (4K net, ultra propre, HDR) produit un résultat incohérent. Choisissez un langage visuel et tenez-vous-y tout au long du prompt.
Poses trop statiques à forte complexité
Les images fixes peuvent tenir n’importe quelle pose. La vidéo oblige le modèle à maintenir cette pose pendant le mouvement. Les positions extrêmes qui exigent un détail fin des articulations (mains près du visage, enchevêtrement complexe des jambes) se dégradent vite en vidéo. Privilégiez des poses de repos naturelles pour un résultat plus propre, puis ajoutez du mouvement avec des verbes de mouvement subtils.
Oublier les verbes de mouvement
Un prompt sans description de mouvement produit un mouvement générique ou brusque. Ajoutez au moins un verbe de mouvement par prompt pour orienter le résultat :
- « expire lentement, léger soulèvement de la poitrine »
- « les doigts effleurent le tissu »
- « les cheveux se soulèvent doucement sous une brise ambiante »
- « tourne lentement la tête vers la caméra »
💡 Astuce : Les petits mouvements subtils paraissent plus réalistes que les grands mouvements spectaculaires. « Léger affaissement de l’épaule » donne toujours de meilleurs résultats que « pose de manière théâtrale ». Les modèles d’IA gèrent bien mieux le micro-mouvement que l’action à grande échelle.
Les résultats de meilleure qualité proviennent généralement de la combinaison de plusieurs outils en séquence, plutôt que de s’appuyer sur un seul modèle pour tout. C’est la méthode qu’adoptent aujourd’hui les créateurs sérieux.
Enchaînement recommandé
| Étape | Outil | Objectif |
|---|
| 1 | Modèle texte vers image | Générer une image fixe de référence précise |
| 2 | Seedance 2.0 | Animer avec un mouvement subtil et contrôlé |
| 3 | Wan 2.6 I2V | Autre animation pour varier ou refaire des prises |
| 4 | Super-résolution / restauration vidéo IA | Augmenter la résolution et stabiliser le rendu final |
Lancer une restauration vidéo IA après la génération permet de récupérer des détails fins et d’éliminer les légers artefacts temporels de n’importe quel modèle, rapprochant nettement le résultat final de la qualité professionnelle, sans coût de nouvelle génération.
Choisir entre les versions de Wan
La famille Wan couvre plusieurs niveaux de vitesse et de qualité. Voici comment choisir laquelle utiliser :
- Wan 2.6 T2V : la meilleure qualité de texte vers vidéo de la série. À utiliser pour la génération pure à partir d’un prompt.
- Wan 2.6 I2V : la meilleure qualité d’image vers vidéo. À utiliser lorsque vous disposez d’une bonne image fixe à animer.
- Wan 2.2 I2V Fast : priorité à la vitesse avec une qualité solide pour l’itération et les brouillons.
Chacune a un usage clair. Les combiner stratégiquement dans votre flux de travail vous permet d’aller vite sur les itérations tout en obtenant un rendu final de haute qualité.
La réutilisation des prompts
Une fois que vous avez une structure de prompt qui fonctionne pour un dispositif d’éclairage ou un type de scène donné, cette structure se transpose à différents sujets. Les variables d’éclairage sont la partie réutilisable. Changez la description du sujet en gardant les couches d’éclairage, de caméra et d’atmosphère identiques, et vous maintiendrez une cohérence visuelle sur une série de résultats, sans repartir de zéro à chaque fois.
Commencez dès maintenant à produire de la vidéo IA cinématographique
L’écart entre une « vidéo IA générique » et une « vidéo IA cinématographique » ne tient pas au modèle. Il tient au flux de travail. Seedance 2.0 vous offre aujourd’hui la meilleure base technique disponible, mais l’architecture des prompts, les descriptions d’éclairage et l’approche par l’image d’abord sont ce qui comble réellement l’écart de qualité entre un résultat oubliable et un résultat dont vous serez fier.
Tous les outils présentés dans cet article sont disponibles sur PicassoIA, au même endroit. Seedance 2.0, Seedance 2.0 Fast, Wan 2.6, Kling v3, Hailuo 2.3, PixVerse v5.6, et plus de 80 autres modèles de texte vers vidéo sont prêts à être utilisés dès maintenant. Commencez par la structure de prompt en cinq couches, itérez vite grâce aux variantes rapides et utilisez le flux de travail par l’image d’abord pour vos scènes les plus prioritaires.
Rien ne vous empêche de faire en sorte que votre prochaine vidéo IA puisse passer pour une scène tournée sur un vrai plateau.


