Na primeira vez que a maioria das pessoas viu um vídeo do Seedance 2.0, achou que ele tinha sido filmado profissionalmente. O movimento é fluido. A textura da pele capta a luz de um jeito que parece tátil. O resultado geral tem um peso cinematográfico que os modelos de IA anteriores nunca chegaram perto de alcançar. Se você tem buscado essa qualidade nos seus próprios projetos de vídeo NSFW com IA, este artigo mostra exatamente como chegar lá: quais modelos usar, como escrever prompts que realmente produzem resultados cinematográficos e o fluxo de trabalho que separa um resultado genérico de algo que parece filmado em um set de verdade.
O que torna o Seedance 2.0 diferente
O Seedance 2.0 é um modelo de texto e imagem para vídeo da ByteDance. Ele não é o único concorrente forte nessa área, mas atualmente define o benchmark para movimento realista em conteúdo sugestivo ou próximo do adulto. O motivo se resume a três coisas: coerência temporal, naturalidade do movimento e fidelidade na renderização da pele.
O problema da coerência temporal
A maioria dos geradores de vídeo com IA tem dificuldade com o que se chama coerência temporal, ou seja, a consistência de um sujeito de um quadro para o seguinte. Um rosto que se deforma sutilmente entre os quadros, um cabelo que oscila ou uma roupa que se distorce são sinais de que algo foi gerado por IA. Isso fica especialmente visível em planos fechados e de retrato, onde o espectador está observando o sujeito com atenção.
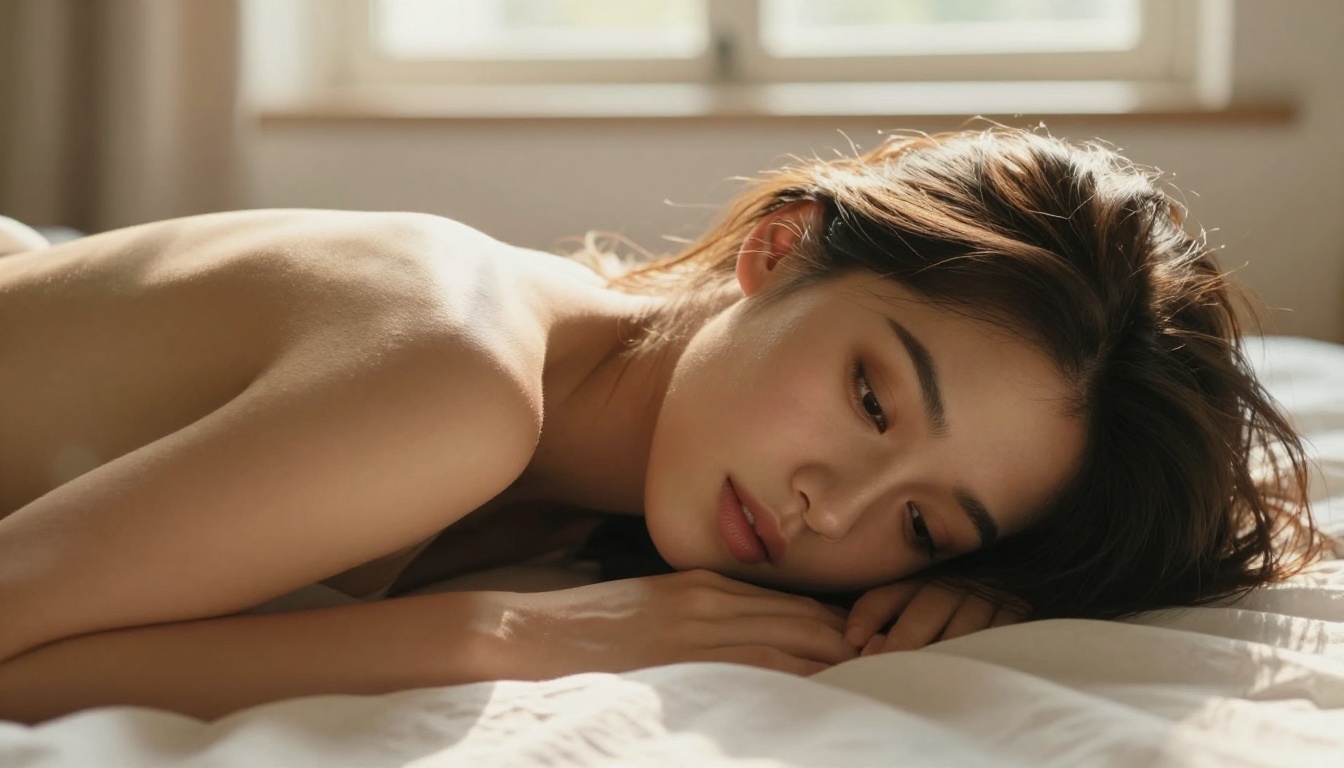
O Seedance 2.0 lida com isso bem melhor que seus antecessores. Os rostos mantêm a estrutura durante movimentos amplos da cabeça. O cabelo flui em trajetórias fisicamente plausíveis. O tom da pele não oscila com a mudança da luz. O resultado é um vídeo que parece capturado e não sintetizado.
Renderização da pele e da textura
Talvez seja aqui que o Seedance 2.0 mais se destaca. O modelo renderiza microdetalhes da pele com uma precisão que os modelos anteriores não conseguiam manter durante o movimento. Você obtém:
- Dispersão subsuperficial natural nas áreas de pele mais clara
- Comportamento realista das sombras dos poros sob iluminação direcional
- Contato preciso entre tecido e pele (a roupa acompanha o corpo, não flutua acima dele)
- Micromovimento dos fios de cabelo que responde a uma física implícita
No caso específico do conteúdo NSFW, essa precisão física é o que separa "parece cena de jogo" de "parece uma pessoa real".
Integração de áudio nativo
Um ponto que costuma passar despercebido: o Seedance 2.0 gera com áudio nativo. Sons ambientes, respiração e áudio do ambiente podem estar presentes no resultado sem nenhum pós-processamento. Para a criação de vídeos NSFW imersivos, isso eleva muito o valor de produção sem nenhum esforço extra da sua parte.
💡 Dica: Use o Seedance 2.0 Fast nas primeiras 3 ou 4 iterações do prompt. Mude para o modelo completo somente quando estiver satisfeito com o conceito. É a forma mais rápida de iterar sem gastar créditos à toa.
Arquitetura de prompt para resultados cinematográficos
Obter um resultado NSFW cinematográfico de qualquer modelo é quase inteiramente um problema de prompt. O modelo só consegue renderizar o que você descreve. Prompts vagos geram resultados vagos. Veja como montar prompts que entregam resultados de forma consistente.
A estrutura de prompt em cinco camadas
Pense em cada prompt como tendo cinco camadas distintas, cada uma responsável por uma dimensão diferente do resultado:
| Camada | O que cobre | Exemplo |
|---|
| Sujeito | Quem, o que está vestindo, posição do corpo | "mulher com roupão de cetim preto, sentada na beirada da cama" |
| Ambiente | Cenário, detalhes do fundo | "quarto de hotel boutique com pouca luz, luzes da cidade através de cortinas transparentes" |
| Iluminação | Fonte, direção, qualidade | "única luz quente de abajur à direita, luz de contorno suave delineando o ombro" |
| Câmera | Ângulo, lente, movimento | "plano médio, 85mm, travelling lento para frente" |
| Atmosfera | Clima, estilo de filme, textura | "Kodak Portra 800, granulação cinematográfica, correção de cor de noite avançada" |
Deixar de fora uma única camada costuma gerar um resultado chapado e genérico. Iluminação e atmosfera são as duas camadas que a maioria das pessoas pula, e são as duas mais responsáveis pelo visual de "IA barata".
O que NÃO escrever
O erro mais comum é escrever prompts NSFW que se concentram muito em conteúdo explícito e deixam todo o resto sem especificação. O modelo não precisa de detalhe explícito para produzir um resultado sensual. Ele precisa de detalhe cinematográfico.
Prompt fraco: "mulher sexy de lingerie, realista, 4k"
Prompt forte: "mulher elegante de camisola de seda marfim recostada contra uma cabeceira escura, luz da noite avançada de um abajur de chão cria um gradiente quente sobre o tecido, plano médio, 85mm f/1.8, granulação suave de filme, intimidade sombria, Kodak Portra 400"
O segundo prompt dá ao modelo tudo que ele precisa para produzir algo que parece filmado em locação.
💡 Dica: Descreva o comportamento da luz (como ela cai, onde as sombras aparecem) em vez de apenas nomear as fontes de luz. "Brilho quente do abajur se acumulando no ombro esquerdo e criando uma sombra suave na borda do pescoço" vai superar "iluminação de abajur quente" em todas as situações.
Os melhores modelos para esse estilo agora
O Seedance 2.0 é o destaque, mas não é o único modelo que vale a pena conhecer. Dependendo do tipo de cena, dos requisitos de velocidade e dos seus objetivos de resultado, esta é a faixa de ponta atual:
Seedance 2.0 (completo)
Ideal para o máximo de realismo, renderizações finais, fidelidade da pele e planos fechados de retrato. O Seedance 2.0 é hoje o padrão de referência. A geração é mais lenta, mas a diferença de qualidade é real quando você trabalha com planos de retrato.
Wan 2.6 Texto para vídeo
O Wan 2.6 T2V lida muito bem com a simulação de profundidade de campo e a separação entre fundo e sujeito. Use para composições de cena complexas, planos de ambiente ou qualquer cena com muita profundidade espacial.
Wan 2.6 Imagem para vídeo
O Wan 2.6 I2V pega uma imagem estática e gera movimento a partir dela. Esse fluxo é poderoso para conteúdo NSFW porque você pode primeiro gerar uma imagem estática precisa com um modelo de texto para imagem, acertar a composição exatamente e depois animá-la. Muito mais controle do que o texto para vídeo puro para sujeitos sensíveis ou que exigem precisão.
Kling v3
O Kling v3 se destaca em movimentos fisicamente convincentes: fluxo de tecido, cabelo com peso e dinâmica corporal natural. Quando o movimento em si é a prioridade e você quer aquela sensação de "filmado em um set de verdade", este é o modelo para escolher.
Hailuo 2.3
O Hailuo 2.3 é a opção de alta qualidade mais rápida. Quando você precisa de volume mais do que de perfeição, ou está prototipando várias variações de cena antes de fazer a renderização final, este oferece o melhor equilíbrio entre velocidade e realismo.
PixVerse v5.6
O PixVerse v5.6 lida com cenários dramáticos de luz e sombra com resultados excepcionais: cenas noturnas, cenas à luz de velas e iluminação íntima de alto contraste. Se a sua cena depende mais da atmosfera do que da complexidade do movimento, esta é uma escolha forte.
LTX-2.3-Pro
O LTX-2.3-Pro mantém a qualidade em durações de vídeo mais longas melhor do que a maioria das alternativas. Se você está montando sequências com mais de cinco segundos, este modelo reduz a degradação de qualidade que costuma aparecer em vídeos de IA mais longos.
Como usar o Seedance 2.0 no PicassoIA
Como o Seedance 2.0 é o modelo em torno do qual todo este artigo foi construído, aqui está o fluxo de trabalho direto para os melhores resultados.
Passo 1: escolha o modo de entrada
Na página do Seedance 2.0 você verá duas opções de entrada:
- Texto para vídeo: construa sua cena inteiramente a partir de um prompt escrito.
- Imagem para vídeo: envie uma imagem de referência e descreva o movimento.
Para conteúdo cinematográfico no estilo NSFW, o modo imagem para vídeo produz resultados mais limpos de forma consistente, porque você já resolveu o problema da composição antes do modelo começar.
Passo 2: monte um prompt em camadas
Aplique a estrutura em cinco camadas. Não pule iluminação e atmosfera. Aqui está um exemplo prático:
"Mulher de renda marfim em pé diante de uma janela de varanda aberta, luz quente do fim da tarde filtrada por cortinas transparentes, projetando sombras paralelas suaves sobre a pele nua, plano médio em contra-plongée, lente de 50mm, brisa suave visível no cabelo e no tecido, correção de cor Kodak Portra 400, panorâmica lenta para a esquerda, granulação cinematográfica"
Passo 3: defina a duração pelo tipo de cena
- Planos fechados de retrato: de 3 a 5 segundos. A qualidade se mantém melhor com durações menores.
- Planos de ambiente ou com muito movimento: de 8 a 10 segundos. O contexto do movimento precisa de espaço para se desenvolver.
- Cenas íntimas e paradas com movimento sutil: de 5 a 7 segundos é o ponto ideal.
Passo 4: itere no Fast, finalize no completo
Use o Seedance 2.0 Fast nas primeiras tentativas para refinar o prompt. Mude para o modelo completo somente quando tiver confirmado que a composição e a iluminação estão como você quer. Esse fluxo economiza tempo e recursos consideravelmente.
💡 Dica: Mantenha um registro pessoal dos seus melhores prompts. Uma estrutura de prompt que gerou um bom resultado para uma cena geralmente gera um bom resultado em configurações semelhantes. Os esquemas de iluminação, em particular, se transferem bem entre sujeitos diferentes.
O fluxo que começa pela imagem
Uma das formas mais confiáveis de chegar a um resultado no nível do Seedance é não começar pelo vídeo. Comece pela geração de imagens.
Por que isso funciona
Os modelos de texto para vídeo precisam resolver dois problemas difíceis ao mesmo tempo: qual é a aparência do quadro e como ele se move. Quando você fornece uma imagem de referência forte, já resolveu o primeiro problema. O modelo pode concentrar toda a sua capacidade em produzir um movimento convincente, em vez de dividir a atenção entre o design visual e a consistência temporal.
O processo em duas etapas
- Gere uma imagem fotorrealista com um modelo de texto para imagem. Ajuste o sujeito, a roupa, a pose e a iluminação até o quadro ficar exatamente como você quer.
- Envie essa imagem para o Seedance 2.0 ou para o Wan 2.6 I2V com um prompt focado no movimento. Mantenha-o mínimo: "movimento sutil de respiração", "leve levantar do cabelo com a brisa ambiente", "leve virada da cabeça em direção à câmera".
O resultado desse fluxo parece bem mais controlado do que o texto para vídeo sozinho, especialmente em conteúdos nos quais a posição exata do corpo e a composição são importantes.
Esquemas de iluminação que parecem cinematográficos
Independentemente do modelo que você usar, certas descrições de iluminação produzem de forma consistente resultados que parecem profissionalmente produzidos. Essas configurações funcionam porque seguem a lógica da iluminação de cinema do mundo real, e os modelos absorveram dados de filme suficientes para interpretá-las com precisão.
A iluminação de três pontos do cinema
Descreva uma luz principal, uma luz de preenchimento e uma luz de contorno. Os modelos de vídeo com IA entendem o vocabulário clássico de iluminação de cinema e respondem a ele de forma confiável.
"Luz principal de tungstênio quente vinda do alto à esquerda, luz ambiente suave de preenchimento pela direita removendo sombras duras, luz de contorno fria por trás separando o sujeito do fundo"
Essa única frase em qualquer prompt vai empurrar o resultado imediatamente em direção à estética profissional de cinema.
Hora dourada ao ar livre
O cenário de iluminação mais favorável para conteúdo NSFW é o exterior na hora dourada. Luz quente e difusa, sem sombras duras, naturalmente favorecedora da pele em qualquer distância. Descreva com precisão:
"Luz do sol da hora dourada do fim da tarde vinda da câmera à esquerda, tom laranja quente sobre a pele, sombras longas e suaves se estendendo para longe do sujeito, luz refletida do ambiente vinda da areia e da água preenchendo as áreas de sombra"
Luz de vela e ambiência baixa
Para cenas íntimas em ambientes fechados, prompts com luz de vela geram resultados notavelmente convincentes em modelos como o PixVerse v5.6 e o Seedance 2.0:
"Chama de uma única vela como fonte principal de luz, brilho âmbar quente tremeluzindo ao envolver o sujeito pela direita, sombras naturais profundas no lado esquerdo, leve brilho quente na pele vindo de baixo"
Luz de janela: a opção versátil
A luz de janela suave e direcional é a configuração mais versátil. Controlável, natural e favorecedora independentemente do tom da pele ou do tecido:
"Luz natural difusa de uma grande janela à esquerda do quadro, sombras suaves e naturais caindo sobre o meio do corpo, luz ambiente fria da parede oposta, céu levemente nublado dando uma qualidade uniforme"
Erros comuns que quebram a qualidade cinematográfica
Mesmo com o modelo certo e um prompt sólido, alguns erros recorrentes vão levar o resultado para o território do "obviamente IA" em todas as vezes.
Sujeitos demais
Cada pessoa adicional na cena multiplica a coerência temporal que o modelo precisa manter. Duas pessoas se movendo no mesmo quadro dobram as chances de oscilação ou distorção. Mantenha as cenas NSFW focadas em um único sujeito sempre que possível, para obter os resultados mais limpos.
Descritores de estilo conflitantes
Misturar estéticas de filme (Kodak Portra, granulação cinematográfica, latitude suave) com estéticas digitais hiper-nítidas (4K nítido, ultralimpo, HDR) cria um resultado conflitante. Escolha uma linguagem visual e mantenha-a ao longo de todo o prompt.
Poses muito estáticas com alta complexidade
Imagens paradas podem sustentar qualquer pose. O vídeo exige que o modelo mantenha essa pose durante o movimento. Posições extremas que exigem detalhe fino das articulações (mãos perto do rosto, arranjos complexos de pernas) se degradam rapidamente em vídeo. Prefira poses de repouso naturais para o resultado mais limpo e depois adicione movimento com verbos de movimento sutis.
Esquecer os verbos de movimento
Um prompt sem descrição de movimento produz movimento genérico ou abrupto. Inclua pelo menos um verbo de movimento por prompt para direcionar o resultado:
- "exala devagar, leve elevação do peito"
- "os dedos percorrem o tecido"
- "o cabelo se levanta suavemente com a brisa ambiente"
- "vira lentamente a cabeça em direção à câmera"
💡 Dica: Movimentos pequenos e sutis parecem mais realistas do que os grandes e dramáticos. "Leve queda do ombro" supera "posa dramaticamente" em todas as situações. Os modelos de IA lidam com micromovimento muito melhor do que com ação em grande escala.
Como combinar modelos para a máxima qualidade
Os resultados de maior qualidade geralmente vêm da combinação de várias ferramentas em sequência, em vez de depender de um único modelo para tudo. É assim que criadores sérios estão trabalhando agora.
Conjunto recomendado
| Passo | Ferramenta | Finalidade |
|---|
| 1 | Modelo de texto para imagem | Gerar uma imagem de referência precisa |
| 2 | Seedance 2.0 | Animar com movimento sutil e controlado |
| 3 | Wan 2.6 I2V | Animação alternativa para variação ou novas tomadas |
| 4 | Super-resolução / restauração de vídeo com IA | Aumentar a resolução e estabilizar o resultado final |
Executar a restauração de vídeo com IA depois da geração recupera detalhes finos e remove artefatos temporais sutis de qualquer modelo, aproximando visivelmente o resultado final de uma qualidade profissional, sem custo de nova geração.
Como escolher entre as versões do Wan
A família Wan abrange várias faixas de velocidade e qualidade. Veja como pensar sobre qual escolher:
- Wan 2.6 T2V: a melhor qualidade de texto para vídeo da série. Use para geração de vídeo puramente a partir de prompt.
- Wan 2.6 I2V: a melhor qualidade de imagem para vídeo. Use quando tiver uma boa imagem estática para animar.
- Wan 2.2 I2V Fast: prioridade para velocidade, com qualidade sólida para iterações e rascunhos.
Cada uma tem um caso de uso claro. Alternar entre elas de forma estratégica no seu fluxo de trabalho permite avançar rápido nas iterações e, ainda assim, alcançar uma renderização final de alta qualidade.
A estratégia de reaproveitar prompts
Quando você tiver uma estrutura de prompt que funciona para um esquema de iluminação ou tipo de cena específico, essa estrutura se transfere para sujeitos diferentes. As variáveis de iluminação são a parte reaproveitável. Mude a descrição do sujeito mantendo as camadas de iluminação, câmera e atmosfera consistentes, e você vai manter a coerência visual em uma série de resultados sem começar do zero a cada vez.
Comece a produzir vídeo de IA cinematográfico agora
A diferença entre "vídeo genérico de IA" e "vídeo cinematográfico de IA" não está no modelo. Está no fluxo de trabalho. O Seedance 2.0 oferece a melhor base técnica disponível hoje, mas a arquitetura de prompt, as descrições de iluminação e a abordagem que começa pela imagem são o que realmente fecha a diferença de qualidade entre um resultado esquecível e algo do que você se orgulharia de mostrar.
Todas as ferramentas deste artigo estão disponíveis no PicassoIA em um só lugar. O Seedance 2.0, o Seedance 2.0 Fast, o Wan 2.6, o Kling v3, o Hailuo 2.3, o PixVerse v5.6 e mais de 80 outros modelos de texto para vídeo estão prontos para uso agora. Comece com a estrutura de prompt em cinco camadas, itere rápido usando as variantes de velocidade e use a abordagem que começa pela imagem para suas cenas de maior prioridade.
Não há motivo para o seu próximo vídeo com IA não poder passar por algo filmado em um set de verdade.


