Comment garder le même look à votre compagne IA sur chaque photo
Générer deux fois le même personnage IA est plus difficile qu’il n’y paraît. Cet article présente les seeds, l’entraînement de LoRA, les images de référence et les meilleurs modèles pour verrouiller le visage, le style et les traits de votre compagne sur chaque photo, chaque scène, à chaque fois.
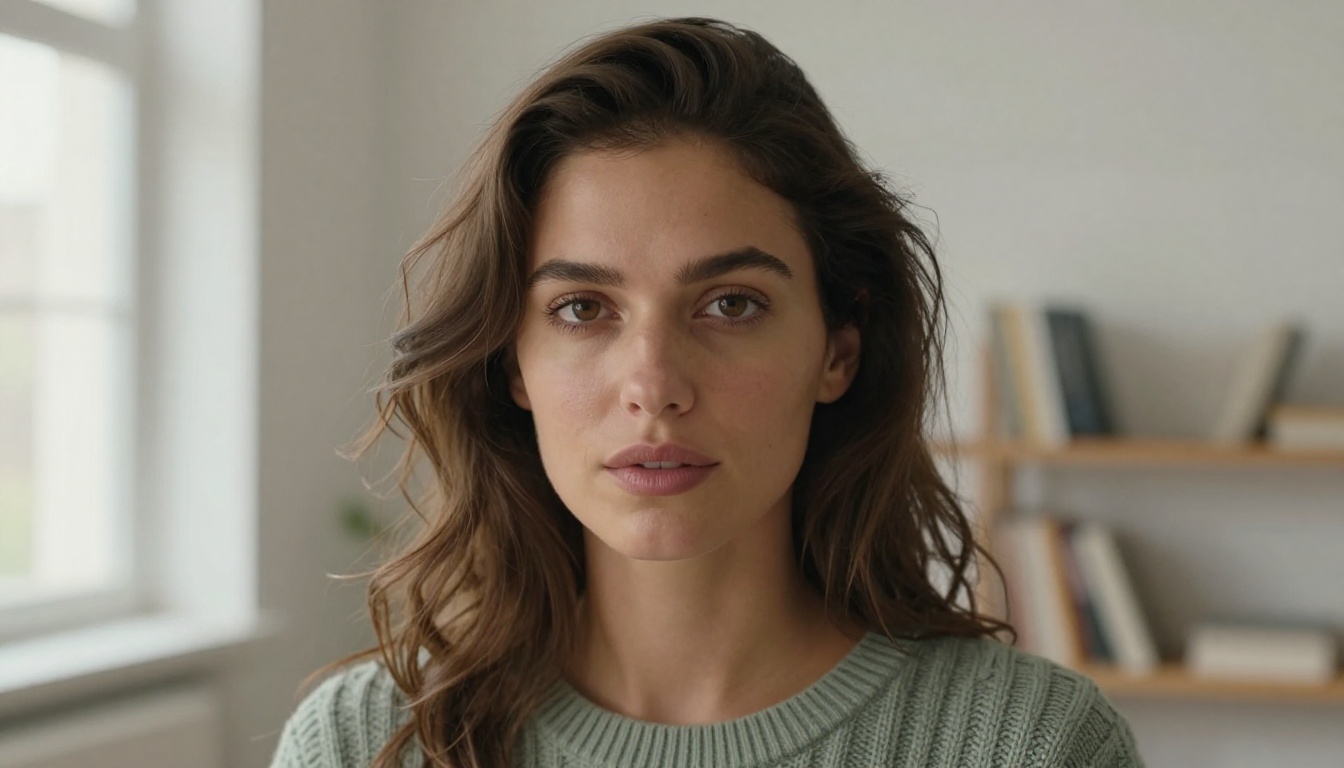
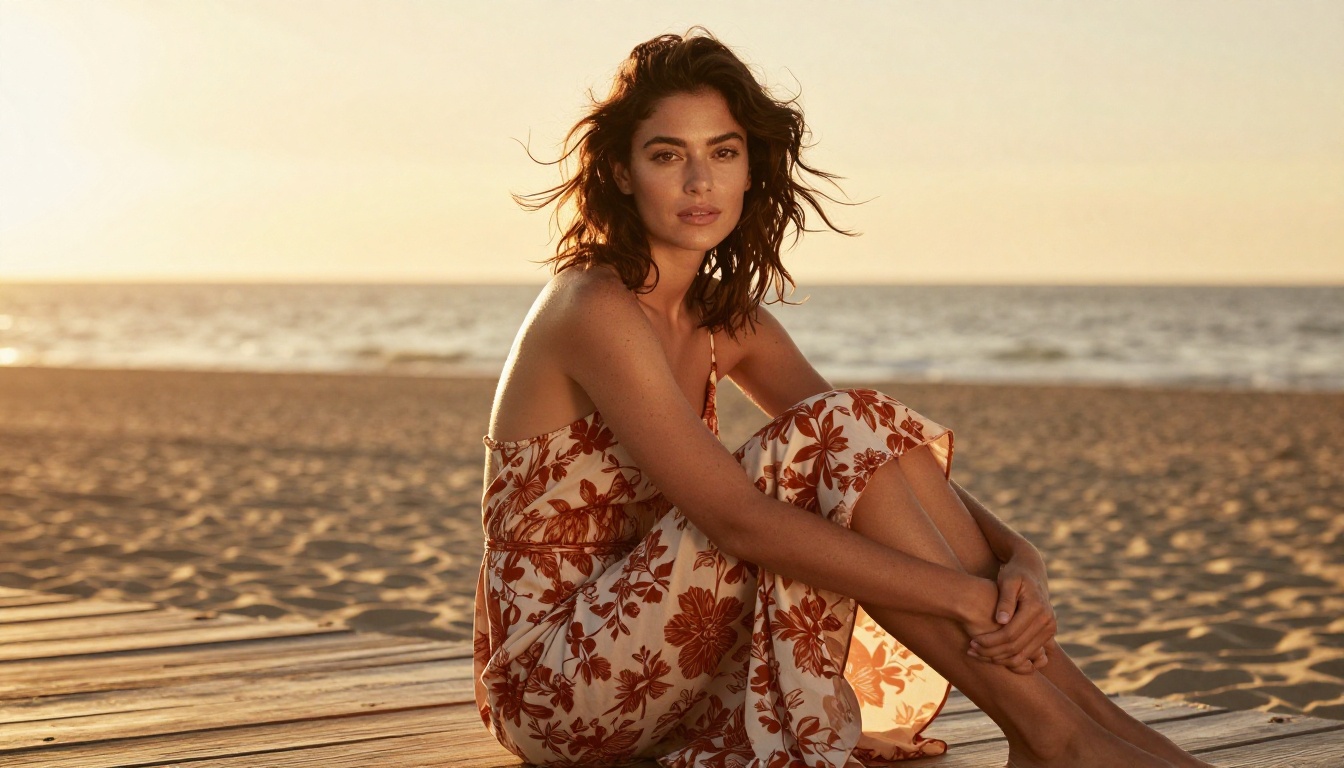
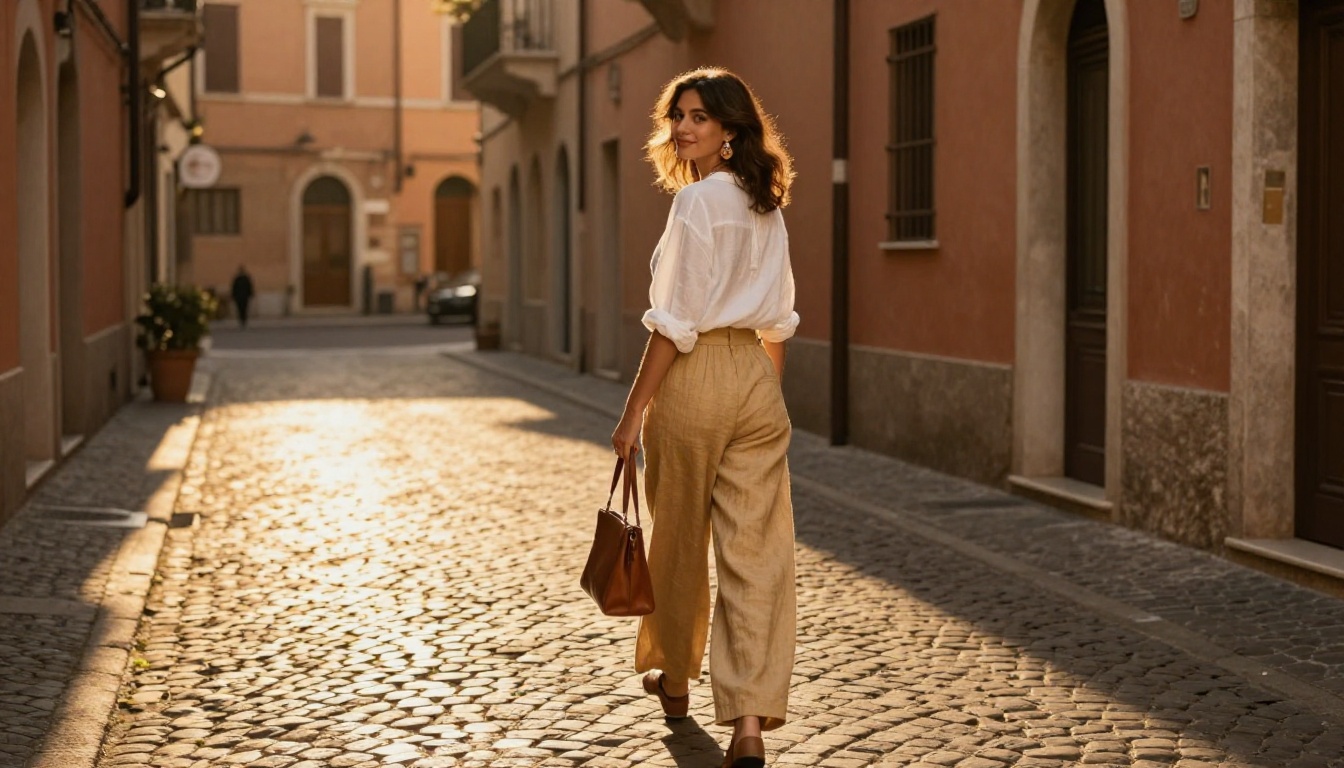
Votre compagne IA était parfaite sur la dernière image. Même visage, même ambiance, exactement comme vous l’imaginiez. Puis vous relancez la génération, changez l’arrière-plan, et elle revient avec un tout autre visage. Une autre forme de nez, un écart différent entre les yeux, des cheveux qui tirent soudain plus sur le roux. Ça vous parle ?
C’est la frustration la plus courante dans la génération de portraits par IA, et elle a des causes concrètes et réparables. Cet article passe en revue chaque méthode qui fonctionne vraiment, du verrouillage rapide par seed à l’entraînement complet de LoRA, pour que votre personnage garde le même look qu’elle soit dans un café parisien ou au coin d’une rue de Tokyo.
Pourquoi votre compagne IA change d’apparence à chaque fois
Le moteur d’aléatoire qui se cache derrière
Chaque modèle de génération d’images repose sur un seed aléatoire : un nombre de départ qui détermine dans quelle direction le modèle puise parmi les données qu’il a apprises. Modifiez la description de la scène, changez l’éclairage, ou ajoutez simplement une virgule à votre prompt, et le point de départ effectif se déplace. Avec lui, le visage de votre personnage change.
Le modèle ne se souvient pas de votre compagne. Il n’existe aucun fichier enregistré qui s’appelle « elle ». Chaque génération est un nouvel échantillon tiré d’une distribution de probabilités. Le mot « brune » restreint l’éventail des possibles, mais il ne fixe pas une personne précise. C’est dans cet écart que se loge l’incohérence.
Ce qui change réellement d’une photo à l’autre
Lorsque vous relancez la génération avec un prompt légèrement modifié, ces éléments sont ceux qui dérivent le plus :
Forme du nez (extrêmement sensible aux changements de mots)
Écart et forme des paupières
Largeur de la mâchoire et définition du menton
Intensité de la couleur des cheveux (un châtain clair et un châtain foncé peuvent basculer sur un seul mot)
Chaleur du teint (un teint olive peut tirer plus vers le jaune ou plus vers le rose)
Proportions générales du visage et structure osseuse
Plus vous modifiez d’éléments dans un prompt, plus le visage se déforme. Ajouter un nouveau lieu, de nouveaux vêtements ou une nouvelle condition d’éclairage augmente la variance. Comprendre cela vous permet de la maîtriser.
Les numéros de seed : votre première ligne de défense
Ce que fait réellement un seed
Un seed est un nombre, compris entre 0 et plus de quatre milliards, qui fixe le point de départ du processus de génération. Deux exécutions avec exactement le même prompt et le même seed produisent des résultats identiques au pixel près. En verrouillant le seed, vous verrouillez une grande partie de l’identité visuelle.
Dès que vous obtenez une génération qui correspond exactement à ce que vous cherchez, notez immédiatement ce numéro de seed. Ce nombre fait désormais partie de l’identité de votre personnage, au même titre que la couleur de ses yeux ou la longueur de ses cheveux.
Utiliser les seeds sur PicassoIA
La plupart des modèles de génération sur PicassoIA affichent un champ seed directement dans le panneau des paramètres. Renseignez-le manuellement plutôt que de le laisser en aléatoire. Pour les modèles qui affichent un seed aléatoire dans les métadonnées après la génération :
Générez une image qui correspond à votre personnage
Repérez le seed dans les détails de la sortie
Copiez-le dans le document de notes de votre personnage
Collez-le manuellement à chaque nouvelle génération
Flux Dev et Flux 2 Pro acceptent tous deux la saisie directe d’un seed, ce qui en fait des choix solides pour les flux de travail de portraits à seed verrouillé. Le gain de cohérence est immédiat dès que vous trouvez le bon seed pour le visage de votre personnage.
Quand les seeds ne suffisent plus
Les seeds ne verrouillent entièrement le résultat que si toutes les autres variables restent identiques. Modifiez le prompt de quelque façon que ce soit : le seed fournit toujours le même point de départ, mais le résultat diffère, car le modèle suit une trajectoire différente. Les seeds seuls ne suffisent pas. Ils doivent être associés à un ancrage précis du prompt pour conserver le visage d’une scène à l’autre.
💡 Enregistrez votre seed avec le prompt complet de votre personnage, dans le même document. Considérez cette combinaison comme une seule unité. Un seed sans son prompt associé perd l’essentiel de sa valeur.
L’ancrage du prompt : écrivez comme un directeur de casting
Construisez la bible de votre personnage
Une bible de personnage est un bloc de description fixe et standardisé que vous collez au début de chaque prompt. Il ne change jamais. La scène change. L’éclairage change. La tenue change. Le bloc consacré au personnage reste identique, mot pour mot.
Voici une structure solide pour une bible de personnage :
Section
Exemple d’entrée
Âge et corpulence
« début de la trentaine, silhouette mince et sportive »
Peau
« teint olive chaud parsemé de taches de rousseur naturelles »
Yeux
« yeux en amande brun miel, cils longs et foncés naturellement »
Cheveux
« cheveux châtain doux en vagues naturelles et souples jusqu’aux épaules »
Signes distinctifs
« fine tache de rousseur près de la lèvre supérieure gauche »
Seed
« seed : 39482817 »
Chaque génération commence par ce bloc exact, avant que la description de la scène ne vienne le compléter. Plus chaque entrée est distinctive et précise, moins le modèle a de marge pour dériver.
L’anatomie d’un prompt cohérent
La formule qui donne les meilleurs résultats à visage verrouillé suit cette structure :
Le bloc du personnage vient toujours en premier. Les modèles traitent les tokens dans l’ordre et accordent plus de poids aux premiers. Placer la description du personnage après les détails de la scène laisse la scène dominer et le visage dériver. Mettre le bloc du personnage en tête garde le visage comme principal point d’ancrage.
Soyez précis sur les détails ethniques et faciaux, pas génériques. « Yeux bruns » produit bien plus de variance que « yeux en amande brun miel aux cils longs et foncés naturellement ». Plus chaque descripteur est unique et précis, plus l’espace de génération se resserre, et plus le résultat est cohérent.
L’entraînement de LoRA : apprendre votre personnage au modèle
Ce que fait l’entraînement de LoRA
LoRA (Low-Rank Adaptation) est un processus de fine-tuning qui apprend à un modèle de base à reconnaître et reproduire une identité visuelle précise. Vous fournissez de 10 à 25 images de référence du même visage, et l’entraîneur construit un petit fichier d’adaptation qui oriente les sorties du modèle vers cette identité.
Après l’entraînement, vous appelez le LoRA dans vos prompts avec un mot déclencheur, et le modèle génère de manière constante ce visage, quels que soient la scène ou les changements d’éclairage. Il conserve la structure osseuse, la texture de la peau, la forme des yeux et les signes distinctifs sur chaque image.
Les résultats sont bien plus stables qu’avec l’ancrage de prompt ou les seeds utilisés seuls. Un LoRA bien entraîné peut placer le même visage sur une plage, dans une salle de réunion ou dans une ambiance de soirée, avec la même géométrie à chaque fois.
Entraînez un LoRA sur PicassoIA
P Image Trainer gère l’entraînement de LoRA directement dans le navigateur, sans GPU local ni configuration technique. Voici la marche à suivre :
Rassemblez de 15 à 20 images de référence de votre personnage (éclairages, angles et expressions variés)
Importez-les dans P Image Trainer
Définissez un mot déclencheur unique, comme « aurelia_companion »
Lancez l’entraînement (il dure généralement de 15 à 30 minutes)
Utilisez le LoRA entraîné dans P Image LoRA en incluant votre mot déclencheur dans chaque prompt
Pour l’entraînement avec des modèles basés sur Qwen, Qwen Image LoRA Trainer Legacy donne de très bons résultats pour la cohérence des portraits photoréalistes.
Ce qui fait de bonnes données d’entraînement :
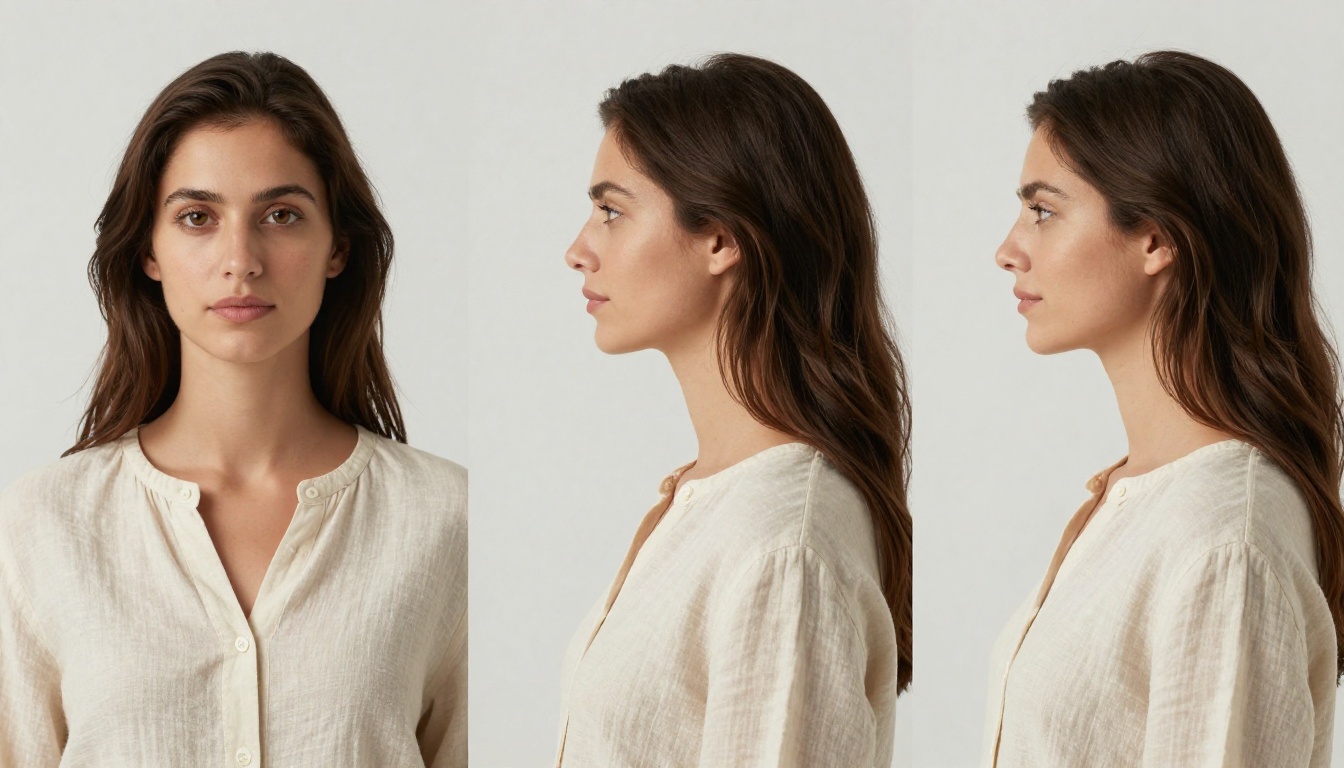
Plusieurs angles du visage : de face, de trois quarts, de profil
Un éclairage varié mais cohérent d’une image à l’autre
Aucun autre visage dominant dans les images d’entraînement
Des images nettes et bien mises au point du début à la fin
💡 15 images nettes sous des angles variés surpasseront toujours 40 images floues aux angles similaires. La qualité prime sur la quantité, et cela vaut directement pour les données d’entraînement.
Les meilleurs modèles pour la cohérence du visage
Tous les modèles ne gèrent pas la cohérence des personnages de la même façon. Certains sont, par leur architecture, mieux adaptés pour maintenir une identité faciale à travers des prompts variés.
Image 01 de Minimax
Image 01 a été spécialement conçu pour la génération de personnages cohérents. Sa description le dit clairement : « Generate Consistent Character Images ». Il gère les demandes multi-images où le personnage doit rester identique dans des poses et des décors différents, avec nettement moins de dérive que les modèles généralistes.
Si votre objectif principal est de conserver une même compagne sur une série de photos, Image 01 est le premier modèle à tester dans votre flux de travail.
Flux Redux Dev pour les variations d’images
Flux Redux Dev crée des variations à partir d’une image source. Donnez-lui votre meilleur portrait de personnage, le plus fidèle, et il génère de nouvelles scènes et de nouvelles poses tout en gardant l’identité faciale ancrée à la source. Il fonctionne comme un outil de cohérence image vers image : votre image de référence porte le visage, et le prompt contrôle ce qui change.
C’est très efficace pour la photo de votre compagne, car vous partez d’une image réelle du visage plutôt que d’une description textuelle.
RealVisXL v3 Multi ControlNet LoRA
RealVisXL v3 Multi ControlNet LoRA combine un rendu photoréaliste, un guidage structurel par ControlNet et une personnalisation par LoRA, le tout en même temps. Vous pouvez lui fournir une référence de pose et un LoRA de visage simultanément, et obtenir ainsi la cohérence du personnage et un contrôle précis de la pose dans une seule génération.
Pour les séries de portraits où votre compagne doit apparaître dans des positions précises sur plusieurs images, cette combinaison est extrêmement efficace.
Qwen Image 2512 pour des visages réalistes
Qwen Image 2512 est conçu spécifiquement pour des « Sharper Text, Realistic Faces ». Les détails fins du visage sont rendus avec une grande fidélité : la texture des pores, la forme précise des yeux et les variations naturelles de la peau ressortent proprement. C’est une option solide lorsque votre bible de personnage comprend des signes distinctifs complexes que vous ne pouvez pas vous permettre de flouter.
Seedream 5 Pro pour une qualité de sortie maximale
Seedream 5 Pro produit des portraits nets en 2K. Associé à une bible de personnage précise et verrouillée et à un seed fixe, il gère la génération de portraits avec une qualité visuelle exceptionnelle. Utilisez-le lorsque la qualité finale de l’image compte autant que le verrouillage de l’identité.
Utiliser les images de référence comme points d’ancrage
La méthode image vers image
Une fois que vous avez un portrait parfait, chaque image suivante doit partir de ce portrait plutôt que du seul texte. La génération image vers image prend votre référence en entrée et applique de nouvelles descriptions de prompt tout en préservant l’identité visuelle de l’image source.
Le paramètre de force contrôle l’écart du modèle par rapport à la source :
0,2 à 0,4 : très proche de la source, seulement de légères modifications
0,5 à 0,6 : modifications modérées, la tenue et le décor peuvent changer de façon convaincante
0,7 à 0,85 : plus de liberté créative, l’identité du visage commence à se relâcher
Pour la cohérence d’une compagne, rester dans la plage de 0,4 à 0,6 vous donne assez de variation pour de nouvelles scènes sans perdre le visage.
PicassoIA Image Editor Pro gère les flux de travail image vers image avec des crédits de génération illimités, ce qui le rend idéal pour itérer sur plusieurs scènes sans pression sur la consommation.
L’inpainting pour changer de décor
Plutôt que de régénérer l’image entière, l’inpainting vous permet de modifier des zones précises tout en gardant le reste verrouillé. Changez l’arrière-plan. Changez la tenue. Changez le moment de la journée. Le visage reste totalement intact, car vous ne l’avez jamais masqué.
Le flux de travail est simple :
Partez de votre meilleur portrait de personnage
Masquez uniquement la zone à modifier (arrière-plan, tenue, environnement)
Décrivez dans le prompt à quoi doit ressembler la nouvelle zone
Générez, en gardant exactement les zones non masquées
P Image Edit gère l’inpainting avec des modifications en moins d’une seconde et une itération rapide. Pour une édition de zones plus complexe combinée à la personnalisation par LoRA, Qwen Image Edit Plus LoRA préserve l’identité lors de changements de décor chirurgicaux.
💡 La règle d’or de l’inpainting : n’incluez jamais le visage dans votre masque, sauf si vous corrigez spécifiquement le visage. Chaque fois que vous repeignez la zone du visage, vous risquez une dérive.
Les modèles 3D comme ancrage de cohérence
Construire une version 3D de votre compagne apporte une dimension de cohérence que la génération texte vers image ne peut tout simplement pas égaler : des proportions faciales géométriquement fixes, qui existent dans un véritable espace tridimensionnel. Faites le rendu sous n’importe quel angle, avec n’importe quel éclairage, et la structure osseuse reste physiquement correcte.
Create Character v1 sur PicassoIA crée automatiquement le squelette d’un personnage 3D à partir d’une image de référence, ce qui vous donne un double numérique posable. Les images rendues à partir de ce modèle deviennent des images d’entrée idéales pour la génération image vers image, car la géométrie du visage reste toujours identique quel que soit l’angle de vue.
Hunyuan 3D 3.1 convertit des photographies en modèles 3D avec une grande fidélité, et Rodin se spécialise dans la génération de ressources 3D exploitables à partir de sources photographiques. Les deux vous donnent quelque chose qu’aucun seed ni aucun prompt ne peut offrir : une géométrie tridimensionnelle cohérente du visage de votre personnage, à utiliser comme point d’ancrage permanent.
Cette approche fonctionne particulièrement bien pour les compagnes qui apparaissent dans des positions corporelles variées, car la géométrie 3D gère la rotation sans les déformations que l’image vers image basée sur le prompt peut parfois introduire.
Combiner les méthodes : l’ensemble multicouche
Aucune méthode ne donne à elle seule une cohérence parfaite. Les meilleurs résultats viennent de l’empilement de plusieurs méthodes dans un même flux de travail :
Méthode
Niveau de cohérence
Meilleur cas d’usage
Verrouillage du seed uniquement
Faible à moyen
Même prompt, variations mineures
Bible de personnage uniquement
Moyen
Scènes variées avec une description stable
Seed + bible de personnage
Moyen à élevé
Contrôle total du prompt avec stabilité
Image vers image
Élevé
Changements de scène à partir d’un portrait de référence
Entraînement de LoRA
Très élevé
Séries de photos au long cours
LoRA + inpainting
Le plus élevé
Modifications chirurgicales, préservation parfaite du visage
Pour une compagne utilisée dans une série de contenus ou un projet narratif, l’ensemble recommandé est : entraînement de LoRA + bible de personnage + inpainting pour les changements de scène. Chaque couche gère un type de variance différent, et ensemble elles couvrent presque tous les cas d’échec.
Utiliser les LLM pour mieux construire les prompts
Rédiger une bible de personnage détaillée et cohérente à partir de zéro demande une réflexion minutieuse. Les grands modèles de langage peuvent aider à la construire plus vite et de façon plus complète qu’en procédant manuellement.
Développer une description brève du personnage en un prompt d’image complet et détaillé
Générer des descriptions de scène variées tout en gardant le bloc du personnage inchangé
Vérifier la cohérence des prompts sur un lot de générations prévues
Suggérer de nouveaux décors et scénarios adaptés à l’esthétique établie de votre personnage
Rédiger des descriptions physiques précises qui réduisent la variance du modèle
Le flux de travail le plus efficace : rédigez votre bible de personnage une seule fois, idéalement avec l’aide d’un LLM pour atteindre le niveau de précision qui réduit la variance de génération, puis verrouillez-la définitivement. Ce bloc ne change plus jamais.
La super-résolution pour le détail final
Même un personnage bien verrouillé gagne à recevoir une passe de netteté à la fin, surtout pour les gros plans de portrait où la texture fine du visage compte.
Clarity Pro Upscaler réalise un upscaling IA photoréaliste qui ajoute des détails de texture fins sans modifier l’identité faciale. Le détail des pores, les mèches de cheveux individuelles et la profondeur de la texture de la peau s’améliorent sans que le visage ne bouge. C’est l’étape finale qui donne aux portraits IA un aspect réellement photographique.
Increase Resolution de Bria gère un upscaling de 2x à 4x avec une préservation du visage intégrée à sa logique de traitement. C’est le choix le plus sûr lorsque vous voulez des dimensions de sortie plus grandes, sans risque que le modèle invente de nouveaux détails du visage.
Ces deux outils s’intègrent naturellement à la fin du pipeline de cohérence : générez l’image avec le visage verrouillé grâce à votre ensemble de méthodes, puis procédez à l’upscaling pour finaliser.
Créez votre compagne sur PicassoIA
La partie la plus difficile, c’est le premier portrait. Une fois que vous avez une image où le visage est exactement juste, le reste du flux de travail en découle naturellement. Commencez avec Image 01 pour vos premières prises de vue du personnage, car son architecture de cohérence rend la première session plus productive. Rédigez votre bible de personnage pendant cette première session, tant que les prompts sont frais et que les résultats sont visibles.
Entraînez ensuite votre LoRA avec ces premières images comme jeu de données. À partir de là, votre compagne dispose d’une identité visuelle permanente qui l’accompagne dans chaque scène, chaque décor, chaque histoire que vous voulez raconter.
Parcourez la collection complète de modèles sur picassoia.com/en/all-models, choisissez votre modèle de départ et construisez la compagne que vous imaginez, chaque génération ressemblant exactement à la précédente.