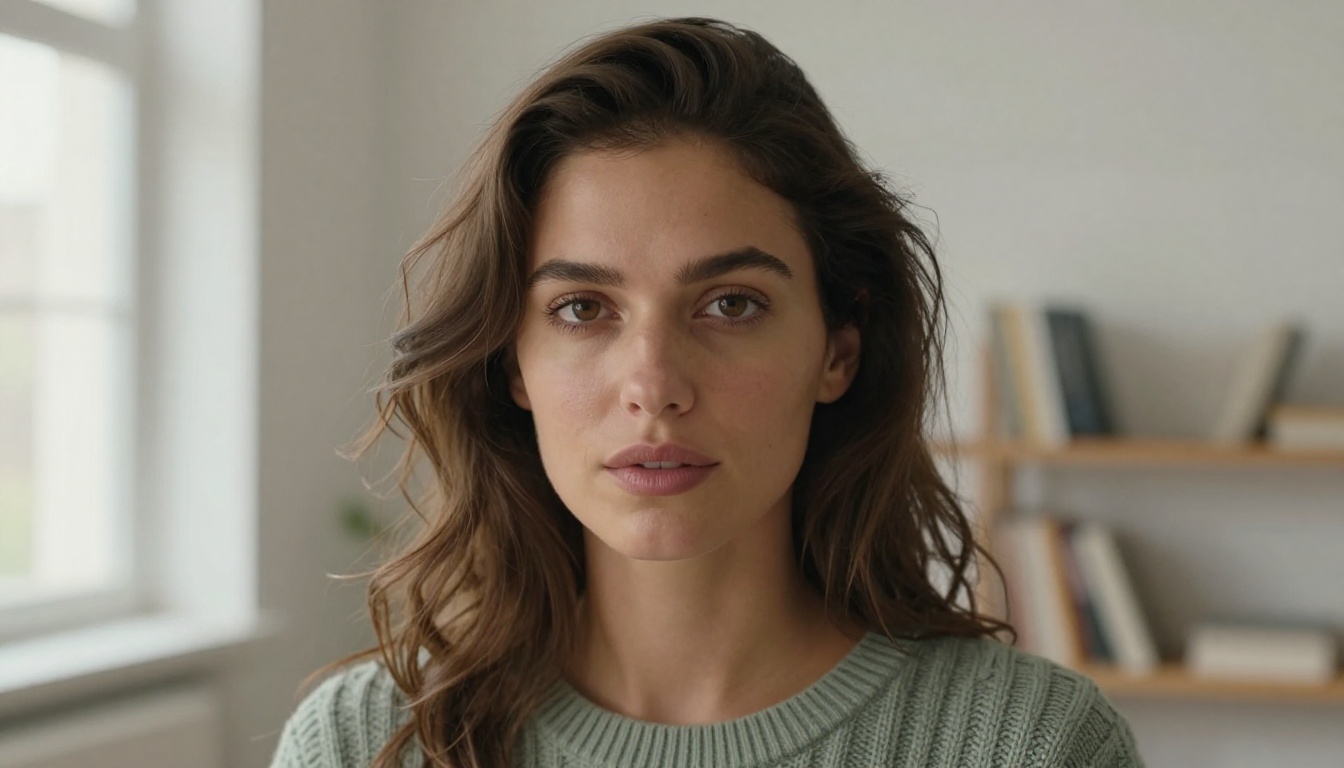
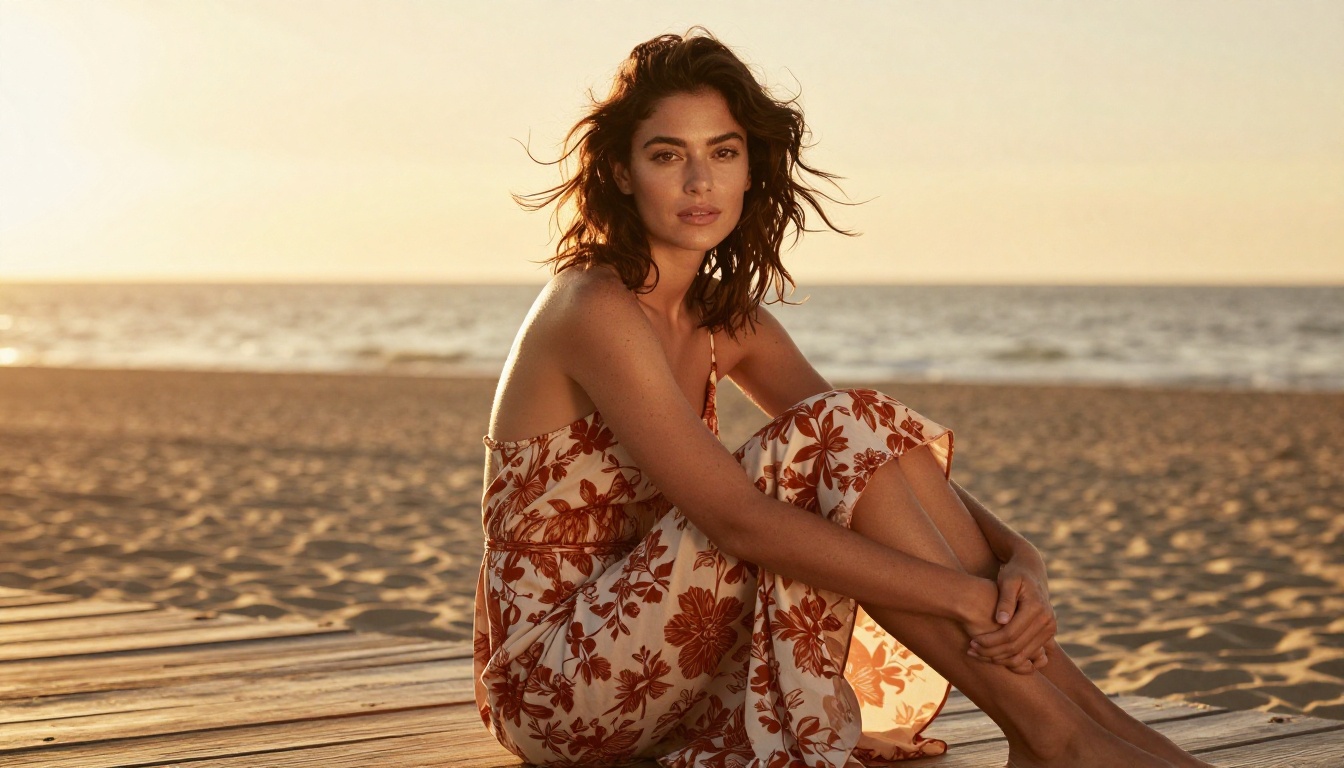
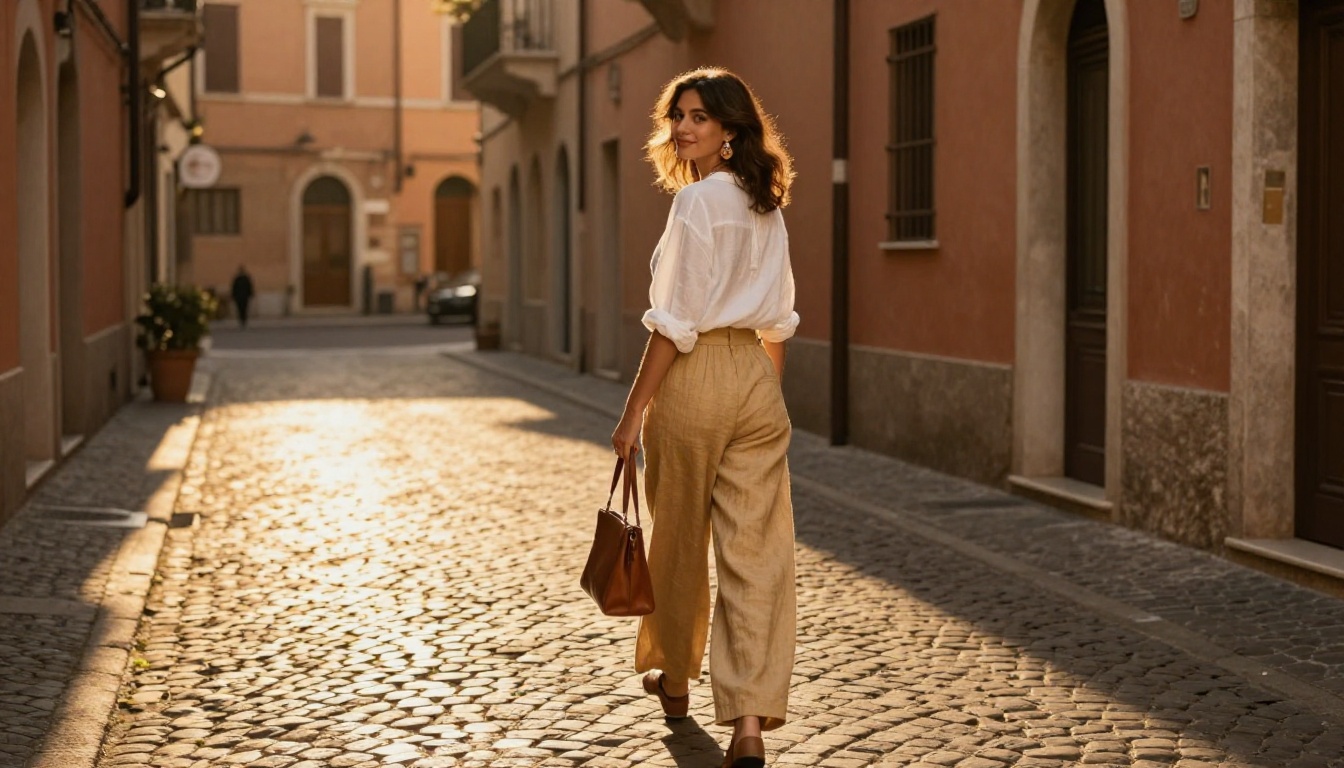
एक ही AI कैरेक्टर को दो बार जेनरेट करना उतना आसान नहीं है जितना लगता है। यह आर्टिकल सीड, LoRA ट्रेनिंग, रेफ़रेंस इमेज और सबसे अच्छे मॉडल के बारे में बताता है, ताकि हर फ़ोटो, हर सीन और हर बार आपके कंपैनियन का चेहरा, स्टाइल और फ़ीचर्स एक जैसे रहें।
आपका AI कंपैनियन अभी-अभी पिछली इमेज में बिल्कुल परफ़ेक्ट लग रहा था। वही चेहरा, वही वाइब, ठीक वैसा ही जैसा आपने कल्पना की थी। फिर आप दोबारा जेनरेट करते हैं, बैकग्राउंड बदलते हैं, और वह बिल्कुल अलग इंसान बनकर सामने आती है। नाक का आकार अलग, आँखों के बीच की दूरी अलग, और बाल किसी तरह अब ज़्यादा लाल। यह सुना-सुना लग रहा है?
AI पोर्ट्रेट जेनरेशन में यह सबसे आम परेशानी है, और इसके ठोस, ठीक किए जा सकने वाले कारण हैं। यह आर्टिकल हर उस तरीके की जानकारी देता है जो सच में काम करता है: सीड को जल्दी लॉक करने से लेकर पूरी LoRA ट्रेनिंग तक, ताकि आपका कैरेक्टर चाहे पेरिस के कैफ़े में हो या टोक्यो की सड़क के कोने पर, एक जैसा दिखे।
आपका AI कंपैनियन हर बार अलग क्यों दिखता है
अंदर का रैंडमनेस इंजन
हर AI इमेज मॉडल एक रैंडम सीड पर चलता है: एक शुरुआती नंबर जो तय करता है कि मॉडल अपने सीखे हुए डेटा में किस दिशा में सैंपल लेगा। सीन का विवरण बदलें, लाइटिंग बदलें, या प्रॉम्प्ट में बस एक कॉमा भी जोड़ दें, तो शुरुआती बिंदु खिसक जाता है। उसके साथ आपके कैरेक्टर का चेहरा भी खिसक जाता है।
मॉडल को आपके कंपैनियन की याद नहीं रहती। उसके पास "उसे" नाम की कोई स्टोर की हुई फ़ाइल नहीं है। हर जेनरेशन संभावना वितरण से एक नया सैंपल है। "ब्रूनेट" शब्द संभावनाओं की रेंज को सीमित करता है, लेकिन किसी एक खास इंसान को तय नहीं करता। यही अंतर इनकंसिस्टेंसी की जड़ है।
शॉट्स के बीच असल में क्या बदलता है
जब आप थोड़े बदले हुए प्रॉम्प्ट के साथ दोबारा जेनरेट करते हैं, तो ये एलिमेंट सबसे ज़्यादा बदलते हैं:
नाक का आकार (शब्दों में हल्के बदलाव के प्रति बेहद संवेदनशील)
आँखों के बीच की दूरी और पलक का आकार
जबड़े की चौड़ाई और ठोड़ी की बनावट
बालों के रंग की गहराई (लाइट ब्रूनेट और डार्क ब्रूनेट में एक ही शब्द के बदलने से फ़र्क आ सकता है)
त्वचा के टोन की गर्माहट (ओलिव टोन ज़्यादा पीला या ज़्यादा गुलाबी दिख सकता है)
चेहरे का कुल अनुपात और हड्डियों की बनावट
प्रॉम्प्ट में जितने ज़्यादा एलिमेंट बदलेंगे, चेहरा उतना ही ज़्यादा खिसकेगा। नई लोकेशन, नए कपड़े या नई लाइटिंग, ये सब वैरिएंस बढ़ाते हैं। इसे समझ लेंगे तो आप इसे कंट्रोल भी कर पाएँगे।
सीड नंबर: आपकी पहली सुरक्षा पंक्ति
सीड असल में क्या करता है
सीड एक नंबर है, जो 0 से लेकर चार अरब से ज़्यादा तक हो सकता है, और यह जेनरेशन प्रोसेस का शुरुआती बिंदु तय करता है। एक ही प्रॉम्प्ट और एक ही सीड के साथ दो रन करने पर पिक्सल-दर-पिक्सल एक जैसे आउटपुट मिलते हैं। सीड लॉक करें तो विज़ुअल पहचान का बड़ा हिस्सा लॉक हो जाता है।
जैसे ही आपको कोई जेनरेशन ठीक वैसी लगे जैसी आप चाहते थे, वह सीड नंबर तुरंत नोट कर लें। अब वह नंबर आपके कैरेक्टर की पहचान का हिस्सा है, उतना ही ज़रूरी जितना उसकी आँखों का रंग या बालों की लंबाई।
PicassoIA पर सीड का इस्तेमाल
PicassoIA पर ज़्यादातर जेनरेशन मॉडल पैरामीटर पैनल में सीड फ़ील्ड सीधे दिखाते हैं। उसे रैंडम पर छोड़ने के बजाय मैन्युअली सेट करें। जिन मॉडल में जेनरेशन के बाद मेटाडेटा में रैंडम सीड दिखता है, उनके लिए यह तरीका अपनाएँ:
एक ऐसी इमेज जेनरेट करें जो आपके कैरेक्टर से मेल खाती हो
जेनरेशन के आउटपुट डिटेल्स में सीड खोजें
उसे अपने कैरेक्टर नोट्स वाले डॉक्यूमेंट में कॉपी करें
हर बार जेनरेट करते समय उसे मैन्युअली वापस डालें
Flux Dev और Flux 2 Pro दोनों सीधे सीड इनपुट सपोर्ट करते हैं, इसलिए सीड-लॉक्ड पोर्ट्रेट वर्कफ़्लो के लिए ये मज़बूत विकल्प हैं। जैसे ही आपको अपने कैरेक्टर के चेहरे के लिए सही सीड मिल जाता है, नतीजा तुरंत एक जैसा दिखने लगता है।
जब सीड कमज़ोर पड़ते हैं
सीड आउटपुट को पूरी तरह तभी लॉक करता है जब बाकी हर वेरिएबल एक जैसा हो। प्रॉम्प्ट में किसी भी तरह का बदलाव करें, तो सीड शुरुआती बिंदु वही रहता है, पर मॉडल एक अलग रास्ते पर चलता है और नतीजा अलग हो जाता है। अकेले सीड काफ़ी नहीं हैं। अलग-अलग सीन में चेहरा बनाए रखने के लिए उन्हें सटीक प्रॉम्प्ट एंकरिंग के साथ जोड़ना होगा।
💡 अपना सीड उसके पूरे कैरेक्टर प्रॉम्प्ट के साथ एक ही डॉक्यूमेंट में सेव करें। इस जोड़ी को एक इकाई मानें। मैच करने वाले प्रॉम्प्ट के बिना सीड की ज़्यादातर वैल्यू खत्म हो जाती है।
प्रॉम्प्ट एंकरिंग: कास्टिंग डायरेक्टर की तरह लिखें
अपनी कैरेक्टर बाइबल बनाएँ
कैरेक्टर बाइबल एक फ़िक्स्ड, मानकीकृत विवरण ब्लॉक है, जिसे आप हर प्रॉम्प्ट की शुरुआत में चिपकाते हैं। यह कभी नहीं बदलता। सीन बदलता है। लाइटिंग बदलती है। आउटफ़िट बदलता है। कैरेक्टर वाला ब्लॉक शब्द-दर-शब्द एक जैसा रहता है।
कैरेक्टर बाइबल का एक अच्छा ढाँचा यह है:
सेक्शन
उदाहरण एंट्री
उम्र और कद-काठी
"early thirties, slender athletic build"
त्वचा
"warm olive skin dusted with natural freckles"
आँखें
"honey-brown almond eyes, naturally long dark lashes"
बाल
"soft brunette hair in loose natural waves past shoulders"
खास निशान
"faint freckle near upper left lip"
सीड
"seed: 39482817"
हर जेनरेशन इसी सटीक ब्लॉक से शुरू होती है, और उसके बाद ही सीन का विवरण आता है। हर एंट्री जितनी अलग और विशिष्ट होगी, मॉडल के बहकने की गुंजाइश उतनी कम होगी।
एक कंसिस्टेंट प्रॉम्प्ट की बनावट
सबसे अच्छे चेहरा-लॉक नतीजे देने वाला फ़ॉर्मूला इस ढाँचे को फ़ॉलो करता है:
कैरेक्टर ब्लॉक हमेशा सबसे पहले आता है। मॉडल टोकन को क्रम से प्रोसेस करते हैं और पहले वाले टोकन को ज़्यादा वज़न देते हैं। अगर कैरेक्टर का विवरण सीन की डिटेल्स के बाद रखा गया, तो सीन हावी हो जाएगा और चेहरा खिसकेगा। कैरेक्टर ब्लॉक को सबसे आगे रखने से चेहरा मुख्य एंकर बना रहता है।
चेहरे और जातीय विशेषताओं के बारे में सटीक रहें, सामान्य न रहें। "Brown eyes" से "honey-brown almond eyes with naturally long dark lashes" की तुलना में कहीं ज़्यादा वैरिएंस आता है। हर डिस्क्रिप्टर जितना अनोखा और सटीक होगा, जेनरेशन की रेंज उतनी सीमित होगी और आउटपुट उतना ही कंसिस्टेंट होगा।
LoRA ट्रेनिंग: मॉडल को अपना कैरेक्टर सिखाना
LoRA ट्रेनिंग क्या करती है
LoRA (Low-Rank Adaptation) एक फ़ाइन-ट्यूनिंग प्रोसेस है, जो बेस मॉडल को किसी खास विज़ुअल पहचान को पहचानना और दोबारा बनाना सिखाती है। आप एक ही चेहरे की 10 से 25 रेफ़रेंस इमेज देते हैं, और ट्रेनर एक छोटी एडैप्टर फ़ाइल बनाता है जो मॉडल के आउटपुट को उस पहचान की ओर मोड़ देती है।
ट्रेनिंग के बाद आप प्रॉम्प्ट में एक ट्रिगर वर्ड के साथ LoRA का रेफ़रेंस देते हैं, और सीन या लाइटिंग बदलने के बावजूद मॉडल लगातार वही चेहरा बनाता है। यह हर इमेज में हड्डियों की बनावट, त्वचा की टेक्सचर, आँखों का आकार और खास निशान बनाए रखता है।
सीड या प्रॉम्प्ट एंकरिंग अकेले इस्तेमाल करने की तुलना में नतीजे कहीं ज़्यादा स्थिर होते हैं। एक अच्छी तरह ट्रेन की गई LoRA एक ही चेहरे को समुद्र किनारे, बोर्डरूम में या शाम के माहौल वाले सीन में हर बार एक ही ज्योमेट्री के साथ रख सकती है।
PicassoIA पर LoRA ट्रेन करें
P Image Trainer LoRA ट्रेनिंग सीधे ब्राउज़र में करता है, और इसके लिए किसी लोकल GPU या तकनीकी सेटअप की ज़रूरत नहीं है। प्रक्रिया यह है:
अपने कैरेक्टर की 15 से 20 रेफ़रेंस इमेज इकट्ठा करें (अलग-अलग लाइटिंग, एंगल और एक्सप्रेशन)
इन्हें P Image Trainer पर अपलोड करें
"aurelia_companion" जैसा एक यूनीक ट्रिगर वर्ड सेट करें
ट्रेनिंग रन शुरू करें (आमतौर पर 15 से 30 मिनट लगते हैं)
ट्रेन की गई LoRA को P Image LoRA में इस्तेमाल करें, हर प्रॉम्प्ट में अपना ट्रिगर वर्ड डालकर
Qwen-बेस्ड मॉडल के साथ ट्रेनिंग के लिए, Qwen Image LoRA Trainer Legacy फ़ोटोरियलिस्टिक पोर्ट्रेट कंसिस्टेंसी के लिए अच्छे नतीजे देता है।
अच्छा ट्रेनिंग डेटा क्या बनाता है:
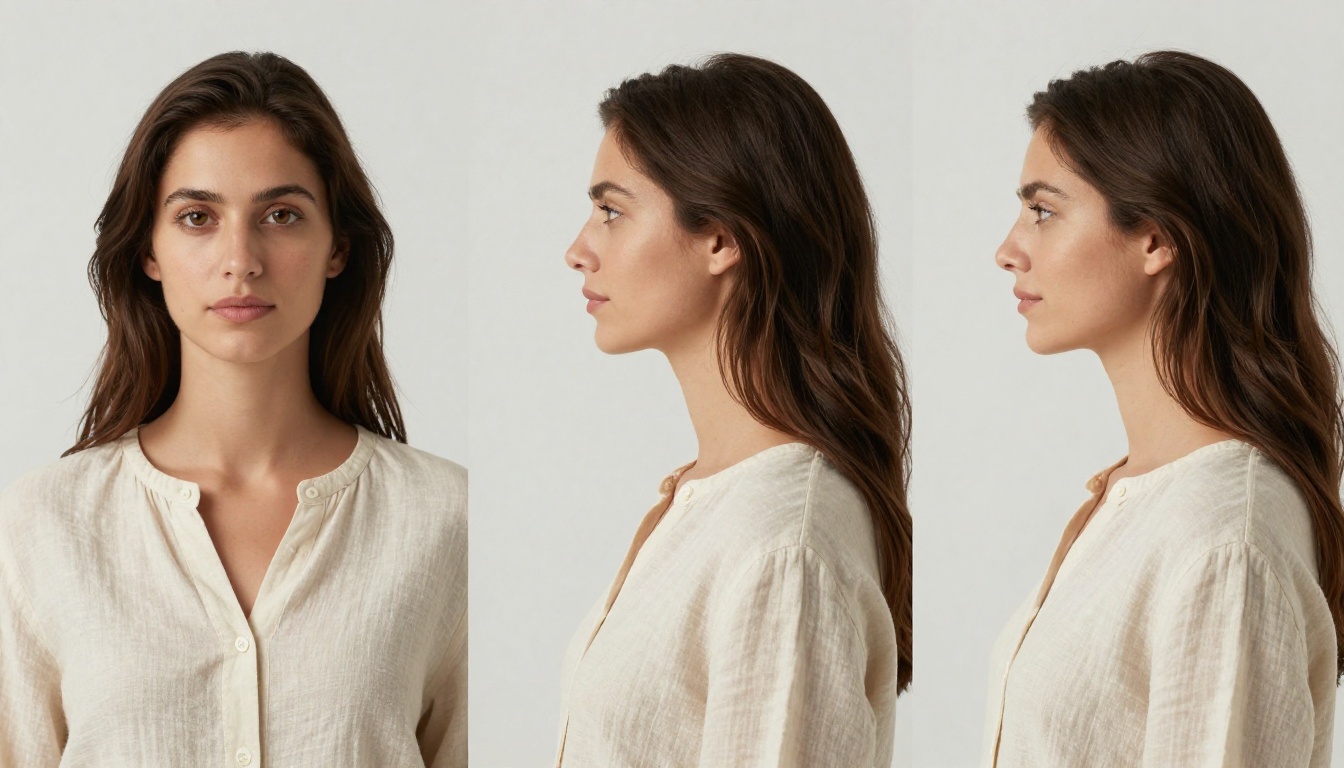
कई चेहरे के एंगल: सामने, तीन-चौथाई, प्रोफ़ाइल
इमेज में अलग-अलग लेकिन एक जैसी लाइटिंग
अलग-अलग एक्सप्रेशन: सामान्य, मुस्कुराता हुआ, दूर देखता हुआ
ट्रेनिंग फ़्रेम में कोई और प्रमुख चेहरा न हो
पूरी ट्रेनिंग में तीखी और अच्छी तरह फ़ोकस की हुई इमेज
💡 15 तीखी, अलग-अलग एंगल वाली इमेज हमेशा 40 धुंधली, एक जैसे एंगल वाली इमेज से बेहतर नतीजे देंगी। ट्रेनिंग डेटा पर क्वालिटी बनाम क्वांटिटी का नियम सीधे लागू होता है।
चेहरे की कंसिस्टेंसी के लिए सबसे अच्छे मॉडल
सभी मॉडल कैरेक्टर कंसिस्टेंसी को एक जैसे तरीके से नहीं संभालते। कुछ मॉडल अपनी बनावट में ही अलग-अलग प्रॉम्प्ट के बीच चेहरे की पहचान बनाए रखने के लिए बेहतर बने होते हैं।
Minimax का Image 01
Image 01 खास तौर पर कंसिस्टेंट कैरेक्टर जेनरेशन के लिए बना है। इसका विवरण साफ़ कहता है: "Generate Consistent Character Images।" यह मल्टी-इमेज रिक्वेस्ट संभालता है, जहाँ कैरेक्टर को अलग-अलग पोज़ और सेटिंग में बिल्कुल एक जैसा दिखना होता है, और यह सामान्य-उद्देश्य वाले मॉडल की तुलना में बहुत कम ड्रिफ़्ट के साथ ऐसा करता है।
अगर आपका मुख्य लक्ष्य फ़ोटो सीरीज़ में एक ही कंपैनियन को बनाए रखना है, तो Image 01 आपके वर्कफ़्लो में सबसे पहले टेस्ट करने लायक मॉडल है।
इमेज वेरिएशन के लिए Flux Redux Dev
Flux Redux Dev किसी सोर्स इमेज से इमेज वेरिएशन बनाता है। इसे अपना सबसे अच्छा और सबसे सटीक कैरेक्टर पोर्ट्रेट दें, और यह नए सीन और पोज़ बनाएगा, जबकि चेहरे की पहचान सोर्स से जुड़ी रहेगी। यह इमेज-टू-इमेज कंसिस्टेंसी टूल की तरह काम करता है: आपकी रेफ़रेंस इमेज चेहरे को थामे रखती है, और प्रॉम्प्ट तय करता है कि क्या बदलेगा।
कंपैनियन फ़ोटोग्राफ़ी के लिए यह बहुत काम का है, क्योंकि आप चेहरे के विवरण के टेक्स्ट के बजाय चेहरे की असली इमेज से शुरू कर रहे होते हैं।
RealVisXL v3 Multi ControlNet LoRA
RealVisXL v3 Multi ControlNet LoRA फ़ोटोरियलिस्टिक रेंडरिंग को ControlNet स्ट्रक्चर गाइडेंस और LoRA पर्सनलाइज़ेशन के साथ एक साथ जोड़ता है। आप इसे एक ही समय में पोज़ रेफ़रेंस और फ़ेस LoRA दोनों दे सकते हैं, और एक ही जेनरेशन से कैरेक्टर कंसिस्टेंसी और सटीक पोज़ कंट्रोल दोनों मिलते हैं।
ऐसी पोर्ट्रेट सीरीज़ के लिए, जहाँ आपके कंपैनियन को कई इमेज में खास बॉडी पोज़िशन में दिखना है, यह कॉम्बिनेशन बेहद कारगर है।
रियलिस्टिक चेहरों के लिए Qwen Image 2512
Qwen Image 2512 खास तौर पर "Sharper Text, Realistic Faces" के लिए बना है। बारीक चेहरे की डिटेल हाई फ़िडेलिटी के साथ रेंडर होती है: पोर्स की टेक्सचर, आँखों के खास आकार और त्वचा की प्राकृतिक विविधता, सब साफ़ आते हैं। जब आपकी कैरेक्टर बाइबल में ऐसे बारीक निशान हों जिन्हें धुंधला नहीं होने दे सकते, तो यह मज़बूत विकल्प है।
अधिकतम आउटपुट क्वालिटी के लिए Seedream 5 Pro
Seedream 5 Pro तीखा 2K पोर्ट्रेट आउटपुट देता है। सटीक, लॉक की हुई कैरेक्टर बाइबल और फ़िक्स्ड सीड के साथ यह असाधारण विज़ुअल क्वालिटी के साथ पोर्ट्रेट जेनरेट करता है। इसे तब इस्तेमाल करें जब फ़ाइनल इमेज की क्वालिटी उतनी ही मायने रखती हो जितनी पहचान को लॉक करना।
एंकर के रूप में रेफ़रेंस इमेज का इस्तेमाल
इमेज-टू-इमेज तरीका
एक बार आपके पास एक परफ़ेक्ट पोर्ट्रेट हो जाए, तो आगे की हर इमेज उसी पोर्ट्रेट से शुरू होनी चाहिए, केवल टेक्स्ट से नहीं। इमेज-टू-इमेज जेनरेशन आपके रेफ़रेंस को इनपुट के रूप में लेता है और नए प्रॉम्प्ट विवरण लागू करता है, साथ ही सोर्स इमेज की विज़ुअल पहचान बनाए रखता है।
स्ट्रेंथ पैरामीटर नियंत्रित करता है कि मॉडल सोर्स से कितना हटेगा:
0.2 से 0.4: सोर्स के बहुत करीब, केवल मामूली बदलाव
0.5 से 0.6: मध्यम बदलाव, आउटफ़िट और सेटिंग विश्वसनीय ढंग से बदल सकते हैं
0.7 से 0.85: ज़्यादा रचनात्मक आज़ादी, चेहरे की पहचान ढीली होने लगती है
कंपैनियन की कंसिस्टेंसी के लिए 0.4 से 0.6 की रेंज में रहने से नए सीन के लिए पर्याप्त वेरिएशन मिलता है, और चेहरा भी नहीं खोता।
PicassoIA Image Editor Pro अनलिमिटेड जेनरेशन क्रेडिट के साथ इमेज-टू-इमेज वर्कफ़्लो संभालता है, इसलिए कई सीन में इटरेट करने के लिए यह आदर्श है, बिना उपयोग के दबाव के।
सीन बदलने के लिए इनपेंटिंग
पूरी इमेज दोबारा जेनरेट करने के बजाय, इनपेंटिंग आपको बाकी सब कुछ लॉक रखते हुए खास हिस्से बदलने देती है। बैकग्राउंड बदलें। कपड़े बदलें। दिन का समय बदलें। चेहरा पूरी तरह अछूता रहता है, क्योंकि आपने उसे कभी मास्क नहीं किया।
वर्कफ़्लो सीधा है:
अपने सबसे अच्छे कैरेक्टर पोर्ट्रेट से शुरू करें
केवल वही हिस्सा मास्क करें जिसे बदलना है (बैकग्राउंड, आउटफ़िट, माहौल)
प्रॉम्प्ट में बताएँ कि नया हिस्सा कैसा दिखना चाहिए
जेनरेट करें, जिसमें बिना मास्क वाले हिस्से हूबहू सुरक्षित रहेंगे
P Image Edit सब-सेकंड एडिट और तेज़ इटरेशन के साथ इनपेंटिंग करता है। LoRA पर्सनलाइज़ेशन के साथ जटिल रीजन एडिटिंग के लिए, Qwen Image Edit Plus LoRA सटीक सीन बदलाव के दौरान पहचान को कंसिस्टेंट रखता है।
💡 इनपेंटिंग का सुनहरा नियम: मास्क में चेहरे को तब तक शामिल न करें जब तक आप खास तौर पर चेहरा ठीक न कर रहे हों। चेहरे वाले हिस्से को हर बार दोबारा पेंट करने पर ड्रिफ़्ट का खतरा रहता है।
कंसिस्टेंसी एंकर के रूप में 3D मॉडल
अपने कंपैनियन का 3D वर्ज़न बनाना एक ऐसी कंसिस्टेंसी जोड़ता है, जो टेक्स्ट-टू-इमेज कभी नहीं दे सकता: चेहरे के स्थिर अनुपात जो असली त्रि-आयामी स्पेस में मौजूद हैं। किसी भी एंगल से, किसी भी लाइटिंग में रेंडर करें, हड्डियों की बनावट भौतिक रूप से सही रहती है।
PicassoIA पर Create Character v1 एक रेफ़रेंस इमेज से 3D कैरेक्टर को ऑटो-रिग करता है, और आपको एक पोज़ेबल डिजिटल डबल देता है। इस मॉडल से रेंडर किए गए फ़्रेम इमेज-टू-इमेज जेनरेशन के लिए आदर्श इनपुट बनते हैं, क्योंकि देखने के एंगल के बावजूद चेहरे की ज्योमेट्री हमेशा एक जैसी रहती है।
Hunyuan 3D 3.1 फ़ोटो को हाई फ़िडेलिटी के साथ 3D मॉडल में बदलता है, और Rodin फ़ोटोग्राफ़िक स्रोतों से इस्तेमाल योग्य 3D एसेट बनाने में माहिर है। दोनों आपको वह देते हैं जो कोई सीड या प्रॉम्प्ट नहीं दे सकता: आपके कैरेक्टर के चेहरे की एक लगातार त्रि-आयामी ज्योमेट्री, जिसे स्थायी रेफ़रेंस एंकर के रूप में इस्तेमाल किया जा सके।
यह तरीका उन कंपैनियन के लिए खास तौर पर अच्छा काम करता है जो अलग-अलग बॉडी पोज़िशन में दिखते हैं, क्योंकि 3D ज्योमेट्री रोटेशन को संभालती है, बिना उन विकृतियों के जो प्रॉम्प्ट-आधारित इमेज-टू-इमेज कभी-कभी ले आता है।
तरीकों को मिलाना: मल्टी-लेयर स्टैक
कोई एक तरीका अकेले परफ़ेक्ट कंसिस्टेंसी नहीं देता। सबसे मज़बूत नतीजे तब आते हैं जब एक ही वर्कफ़्लो में कई तरीके एक साथ जोड़े जाते हैं:
तरीका
कंसिस्टेंसी की ताकत
सबसे अच्छा उपयोग
सिर्फ़ सीड लॉक
कम से मध्यम
वही प्रॉम्प्ट, छोटे बदलाव
सिर्फ़ कैरेक्टर बाइबल
मध्यम
स्थिर विवरण के साथ अलग-अलग सीन
सीड + कैरेक्टर बाइबल
मध्यम से उच्च
स्थिरता के साथ प्रॉम्प्ट पर पूरा नियंत्रण
इमेज-टू-इमेज
उच्च
रेफ़रेंस पोर्ट्रेट से सीन बदलना
LoRA ट्रेनिंग
बहुत उच्च
लंबी फ़ोटो सीरीज़
LoRA + इनपेंटिंग
सबसे उच्च
सटीक बदलाव, चेहरा पूरी तरह सुरक्षित
किसी कंपैनियन को कंटेंट सीरीज़ या स्टोरीटेलिंग प्रोजेक्ट में इस्तेमाल करने के लिए सुझाया गया तरीकों का सेट है: LoRA ट्रेनिंग + कैरेक्टर बाइबल + अलग-अलग सीन बदलने के लिए इनपेंटिंग। हर लेयर वैरिएंस के एक अलग प्रकार को संभालती है, और मिलकर वे लगभग हर विफलता के तरीके को कवर करती हैं।
बेहतर प्रॉम्प्ट बनाने के लिए LLM का इस्तेमाल
शुरू से एक विस्तृत, कंसिस्टेंट कैरेक्टर बाइबल लिखने के लिए सावधानी से सोचना पड़ता है। लार्ज लैंग्वेज मॉडल इसे मैन्युअली करने से कहीं तेज़ और ज़्यादा पूरी तरह बनाने में मदद कर सकते हैं।
एक संक्षिप्त कैरेक्टर विवरण को पूरे, विस्तृत इमेज प्रॉम्प्ट में फैलाना
कैरेक्टर ब्लॉक को बिना बदले अलग-अलग सीन विवरण बनाना
योजनाबद्ध जेनरेशन के बैच में प्रॉम्प्ट की कंसिस्टेंसी जाँचना
आपके कैरेक्टर की स्थापित एस्थेटिक में फ़िट होने वाले नए सेटिंग और परिदृश्य सुझाना
ऐसे सटीक शारीरिक विवरण लिखना जो मॉडल के वैरिएंस को कम करें
सबसे कुशल वर्कफ़्लो: अपनी कैरेक्टर बाइबल एक बार लिखें, आदर्श रूप से LLM की मदद से, ताकि वह उस स्पेसिफ़िसिटी तक पहुँचे जो जेनरेशन के वैरिएंस को कम करती है। फिर उसे स्थायी रूप से लॉक कर दें। वह ब्लॉक दोबारा कभी नहीं बदलता।
फ़ाइनल डिटेल के लिए सुपर-रेज़ोल्यूशन
अच्छी तरह लॉक किए गए कैरेक्टर को भी आख़िर में एक शार्पनिंग पास से फ़ायदा होता है, खास तौर पर क्लोज़-अप पोर्ट्रेट में, जहाँ चेहरे की बारीक टेक्सचर मायने रखती है।
Clarity Pro Upscaler फ़ोटोरियलिस्टिक AI अपस्केलिंग करता है, जो चेहरे की पहचान बदले बिना बारीक टेक्सचर जोड़ता है। पोर्स की डिटेल, बालों की अलग-अलग लटें और त्वचा की टेक्सचर की गहराई, सब चेहरे के खिसकने के बिना बेहतर होते हैं। यह आख़िरी कदम है जो AI पोर्ट्रेट को सचमुच फ़ोटोग्राफ़िक बनाता है।
Bria का Increase Resolution 2x से 4x अपस्केलिंग संभालता है, और इसकी प्रोसेसिंग लॉजिक में चेहरा संरक्षण बना हुआ है। जब आपको बड़े आउटपुट आकार चाहिए और मॉडल द्वारा नए चेहरे के विवरणों के हैलुसिनेशन का कोई जोखिम नहीं चाहिए, तो यह सुरक्षित विकल्प है।
दोनों टूल कंसिस्टेंसी पाइपलाइन के आख़िर में स्वाभाविक रूप से फ़िट होते हैं: अपने मेथड स्टैक से चेहरा लॉक करके इमेज जेनरेट करें, फिर फ़ाइनल करने के लिए अपस्केल करें।
PicassoIA पर अपना कंपैनियन बनाएँ
सबसे मुश्किल हिस्सा पहला पोर्ट्रेट है। एक बार आपके पास ऐसी इमेज हो जाए जिसमें चेहरा बिल्कुल सही हो, तो बाकी वर्कफ़्लो उसी से स्वाभाविक रूप से आगे बढ़ता है। अपने पहले कैरेक्टर शॉट्स के लिए Image 01 से शुरू करें, क्योंकि इसका कंसिस्टेंसी आर्किटेक्चर पहले सेशन को ज़्यादा उत्पादक बनाता है। उस पहले सेशन में ही अपनी कैरेक्टर बाइबल लिखें, जब प्रॉम्प्ट ताज़ा हों और नतीजे सामने दिख रहे हों।
फिर उन्हीं पहली इमेज को डेटासेट बनाकर अपनी LoRA ट्रेन करें। उस बिंदु से आगे, आपके कंपैनियन की एक स्थायी विज़ुअल पहचान होगी, जो उनके साथ किसी भी सीन, किसी भी सेटिंग और आपकी किसी भी कहानी में चलेगी।
picassoia.com/en/all-models पर पूरा मॉडल कलेक्शन ब्राउज़ करें, अपना शुरुआती मॉडल चुनें, और वह कंपैनियन बनाएँ जिसकी आपने कल्पना की है, जहाँ हर जेनरेशन पिछली जेनरेशन जैसी ही दिखे।