Les images générées par IA ont franchi un seuil qui rend la détection à l’œil nu presque impossible. Ce qui demandait autrefois un regard exercé, comme des mains déformées, des contours flous ou des proportions erronées, exige désormais une méthode systématique. Les artefacts sont devenus microscopiques, les rendus sont photoréalistes et les outils qui les produisent sont accessibles à quiconque dispose d’un navigateur. Cet article vous propose un système pratique, étape par étape, pour repérer les images de synthèse avant qu’elles ne vous piègent.
Pourquoi les images d’IA sont plus difficiles à démasquer aujourd’hui
Pendant des années, la méthode dominante de synthèse d’images était le GAN (Generative Adversarial Network), dans lequel deux réseaux de neurones s’affrontaient en un jeu du chat et de la souris pour produire des rendus réalistes. Les GAN laissaient des empreintes caractéristiques : des textures de peau qui scintillaient, des arrière-plans qui se fondaient en une bouillie abstraite et les fameuses mains déformées, restées célèbres.
Les modèles de diffusion ont tout changé. En partant d’un bruit pur et en affinant progressivement l’image vers une composition cohérente, ils produisent des résultats aux détails fins et constants, aux arrière-plans naturels et à l’anatomie nettement plus convaincante. Des plateformes comme PicassoIA proposent des dizaines de ces modèles, capables de générer des visages photoréalistes, des plans en pied et des décors complexes qui passent un coup d’œil distrait sans éveiller le moindre soupçon.
Le seuil du réalisme en 2027
Dans plusieurs études universitaires publiées au cours des deux dernières années, des participants humains ont jugé les visages générés par IA « plus dignes de confiance » que des photos de personnes réelles, avec des écarts statistiquement significatifs. La vallée de l’étrange n’en est plus vraiment une. Elle est devenue un plateau où les images de synthèse se tiennent confortablement à côté des images authentiques. Mais les failles subsistent. Il suffit de savoir où appuyer.
La raison fondamentale pour laquelle la détection reste possible tient au fait que les générateurs d’images apprennent des corrélations statistiques, et non des lois physiques. Ils savent comment les choses ont tendance à apparaître les unes à côté des autres d’après les données d’entraînement, mais ils ne simulent pas la gravité, la physique de la lumière ou l’anatomie humaine à partir de principes premiers. C’est dans cet écart que se trouve chaque méthode de détection fiable.
Les parties du corps que l’IA rate encore
L’anatomie humaine est extraordinairement complexe au niveau des détails de surface. La peau ne recouvre pas simplement les muscles ; elle se ride, se plisse, se froisse et s’étire de manière adaptée au contexte, selon la posture, l’âge, le type de tissu et la température ambiante. L’IA apprend à partir d’images de ces résultats, mais elle ne peut pas raisonner sur leurs causes sous-jacentes. Lorsqu’elle rencontre une configuration corporelle rare dans son jeu d’entraînement, elle produit le résultat statistiquement le plus probable, qui est souvent anatomiquement faux.
Les mains et les doigts sont le plus grand indice
Les mains restent le signal le plus fiable dans les images générées par IA. Avant toute chose, comptez les doigts. Observez les proportions de longueur des doigts : dans une main réelle, le majeur est le plus long, suivi de l’annulaire, puis de l’index, puis de l’auriculaire, le pouce étant nettement plus court et placé à part. Vérifiez l’alignement des articulations. Les trois jointures de chaque doigt doivent entretenir entre elles un rapport angulaire cohérent.
L’IA produit fréquemment six ou sept doigts, des doigts soudés, des ongles dont la taille varie d’un doigt à l’autre ou des articulations qui semblent changer de position lorsqu’on suit un doigt jusqu’au suivant. La membrane entre les doigts est aussi un indice fiable : dans une vraie main, la palmure interdigitale a une profondeur et un angle constants, que l’IA représente systématiquement soit trop peu profonds, soit trop profonds.
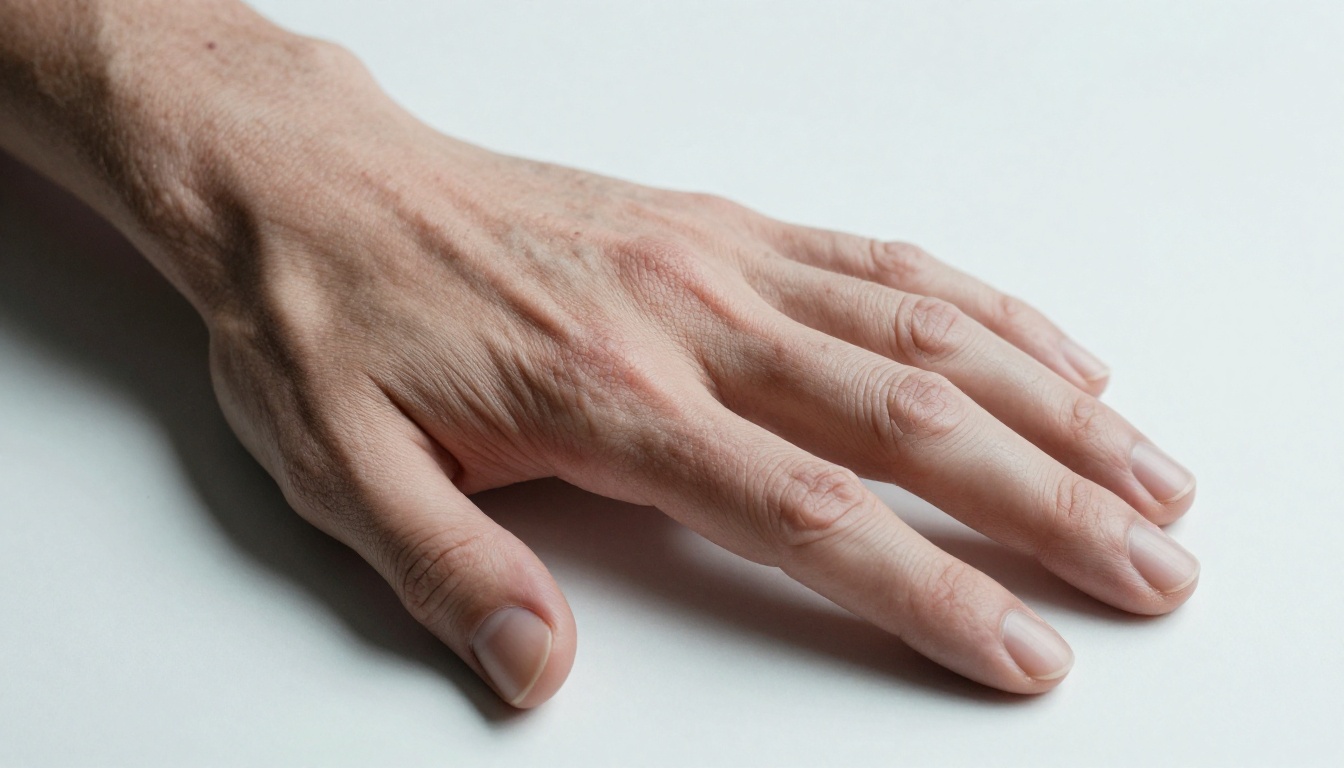
Examinez aussi le poignet. Les os du radius et du cubitus dessinent un profil précis et visible au niveau de l’articulation, qui change selon la rotation. Les poignets générés par IA sont souvent plats, symétriques et dépourvus des repères osseux subtils qui caractérisent l’anatomie réelle du poignet.
Des yeux trop parfaits
Les yeux des images d’IA présentent une étrangeté très particulière : ils sont souvent trop symétriques et trop vifs. Les vrais yeux ont une asymétrie subtile. Une paupière se situe généralement un peu plus bas que l’autre. L’iris est rarement parfaitement centré. Le blanc de l’œil laisse apparaître des motifs vasculaires discrets mais visibles, et il est rarement blanc pur, présentant généralement une teinte crème ou légèrement rosée sous un éclairage réel.
Les yeux générés par IA ont fréquemment des iris parfaitement centrés, avec des motifs radiaux symétriques, presque fractals. Les reflets lumineux (les petites zones brillantes dans l’iris) ne correspondent à aucune source lumineuse identifiable dans l’image environnante. Les cils sont trop uniformément répartis, de longueur trop égale, et se séparent souvent les uns des autres de façon anormalement nette.
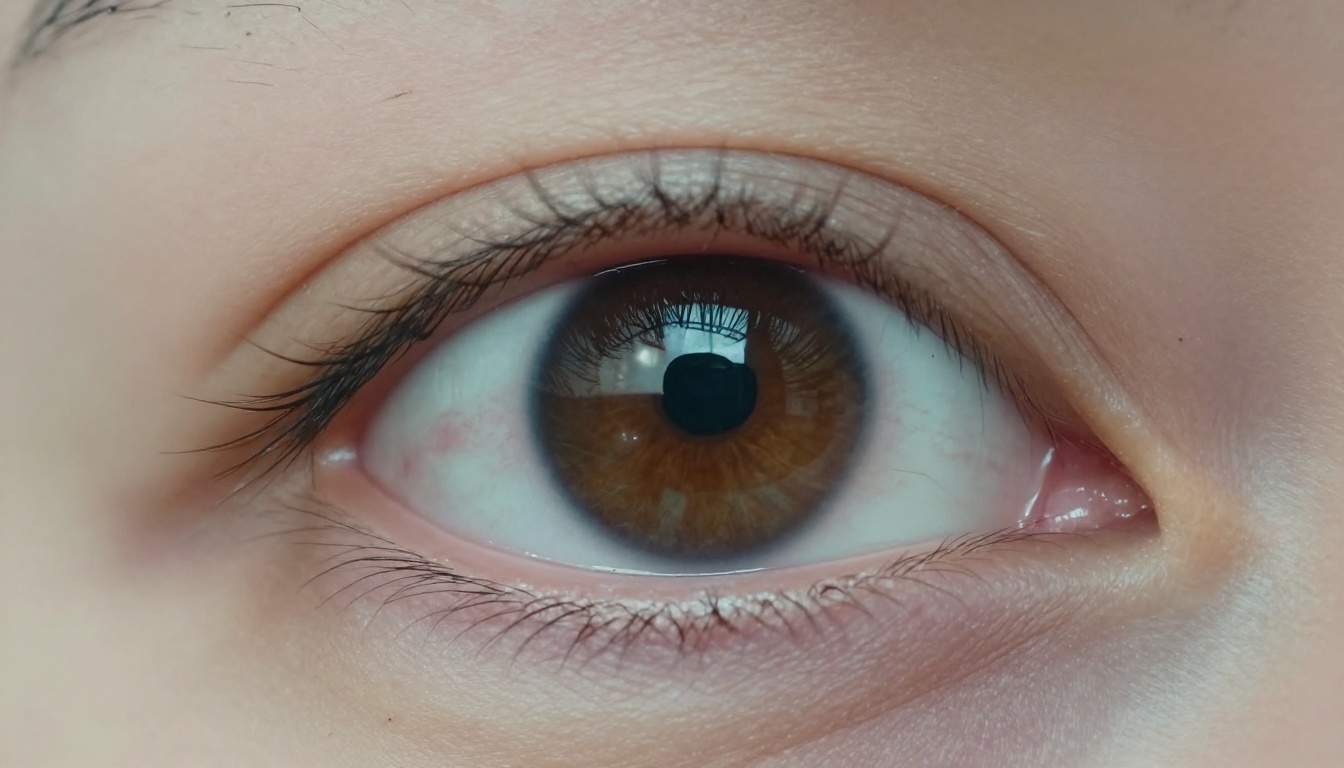
💡 Astuce : Utilisez le zoom par pincement de votre téléphone sur toute image suspecte. Examinez chaque œil séparément et comparez la forme de l’iris, la position de la pupille et l’emplacement des reflets lumineux. Des yeux identiques sont un signal d’alarme. Les vrais visages n’ont presque jamais des yeux parfaitement symétriques.
Les cheveux aux zones de transition
C’est là que les cheveux rencontrent un arrière-plan complexe que les modèles de diffusion peinent le plus visiblement. Maintenir la continuité de chaque mèche tout en rendant simultanément des éléments d’arrière-plan comme des arbres, une foule ou des murs exige du modèle la résolution d’un problème de raisonnement spatial très difficile. L’IA fusionne souvent les mèches entre elles sur les bords, donne aux contours de la chevelure un aspect peint ou crée de légers halos de couleur moyennée là où le détail des mèches individuelles devrait être visible.
Portez une attention particulière aux cheveux volants. Une vraie photo de cheveux foncés sur un ciel clair montre des mèches fines individuelles, avec une frisure et un mouvement naturels. L’IA les omet entièrement ou produit des mèches qui se fondent dans l’arrière-plan avec une qualité d’aquarelle, au lieu de se terminer naturellement.
Texte, logos et arrière-plans
Les lettres illisibles sont un signal déterminant
Demandez à n’importe quel générateur d’images par IA de produire une scène avec une signalétique lisible, un livre ouvert, une étiquette ou un t-shirt avec du texte : le résultat est presque toujours illisible. Les modèles de diffusion ne comprennent ni la langue ni la structure des lettres. Ils savent à quoi ressemblent statistiquement les motifs en forme de lettres, et reproduisent cette apparence approximative sans produire de mots réels.
Le résultat est plausible en miniature : on voit bien qu’il y a du « texte » dans l’image. À l’examen, les lettres se confondent les unes avec les autres, se répètent dans un ordre incorrect ou forment des suites qui ressemblent à des mots à distance, mais restent entièrement illisibles dès qu’on zoome.
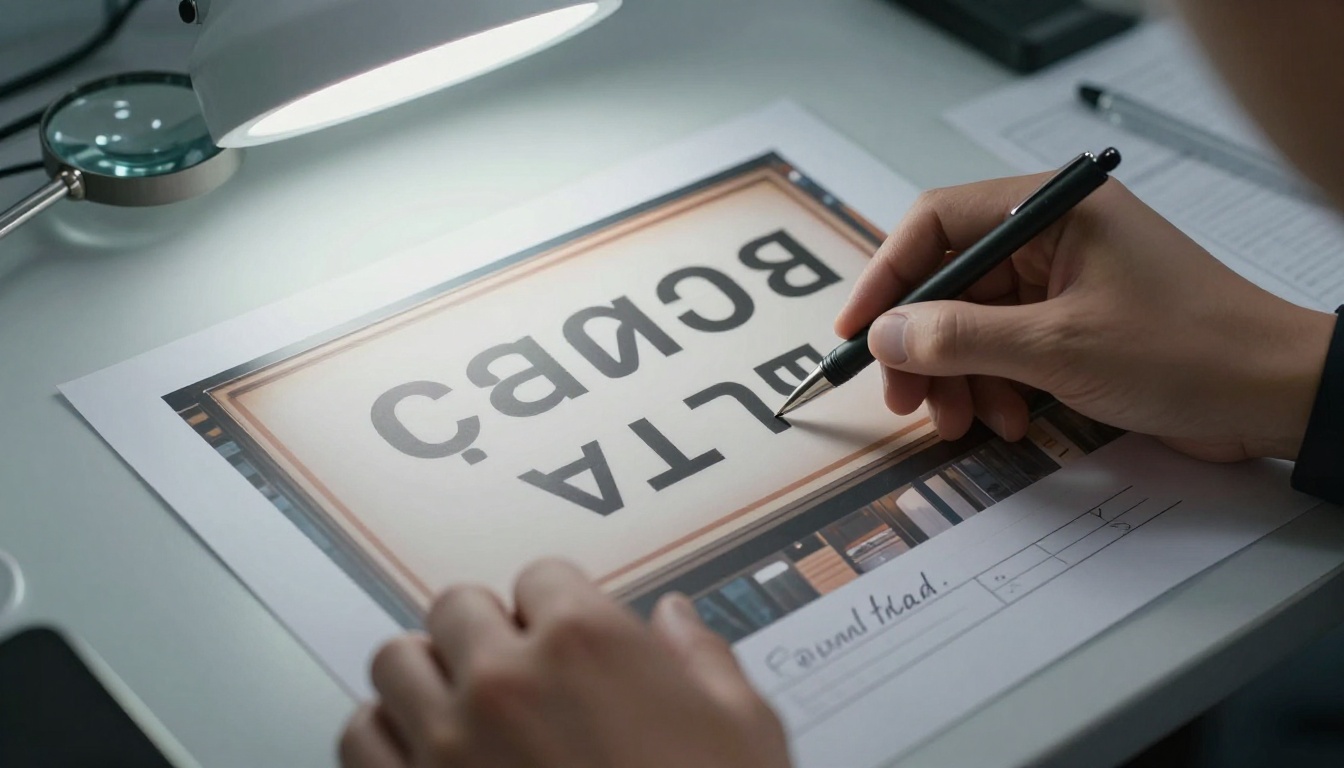
C’est l’un des contrôles les plus rapides que vous puissiez faire : zoomez sur tout texte visible dans une image. S’il n’est pas lisible, l’image est suspecte. Notez que certains modèles récents gèrent mieux le texte simple lorsqu’on le demande explicitement, mais les panneaux à plusieurs mots, les étiquettes de produits et les dos de livres restent systématiquement peu fiables pour une génération par IA.
Les motifs répétitifs dans les arrière-plans complexes
Lorsqu’elle génère des scènes complexes comme des forêts, des foules ou des surfaces carrelées, l’IA répète souvent ou reflète des fragments de texture pour remplir le cadre. Cela crée une répétition qu’aucune photo réelle ne contiendrait. La même formation rocheuse qui apparaît trois fois à intervalles réguliers, la même silhouette d’arbre reflétée au second plan, ou des carreaux de sol partageant exactement le même motif de fissures sont autant de signaux forts.
Analysez méthodiquement les arrière-plans en découpant l’image en grille et en comparant les sections. Les scènes de foule y sont particulièrement sujettes : si vous identifiez deux visages qui partagent la même structure osseuse et les mêmes proportions, l’image a presque certainement été générée de façon synthétique.
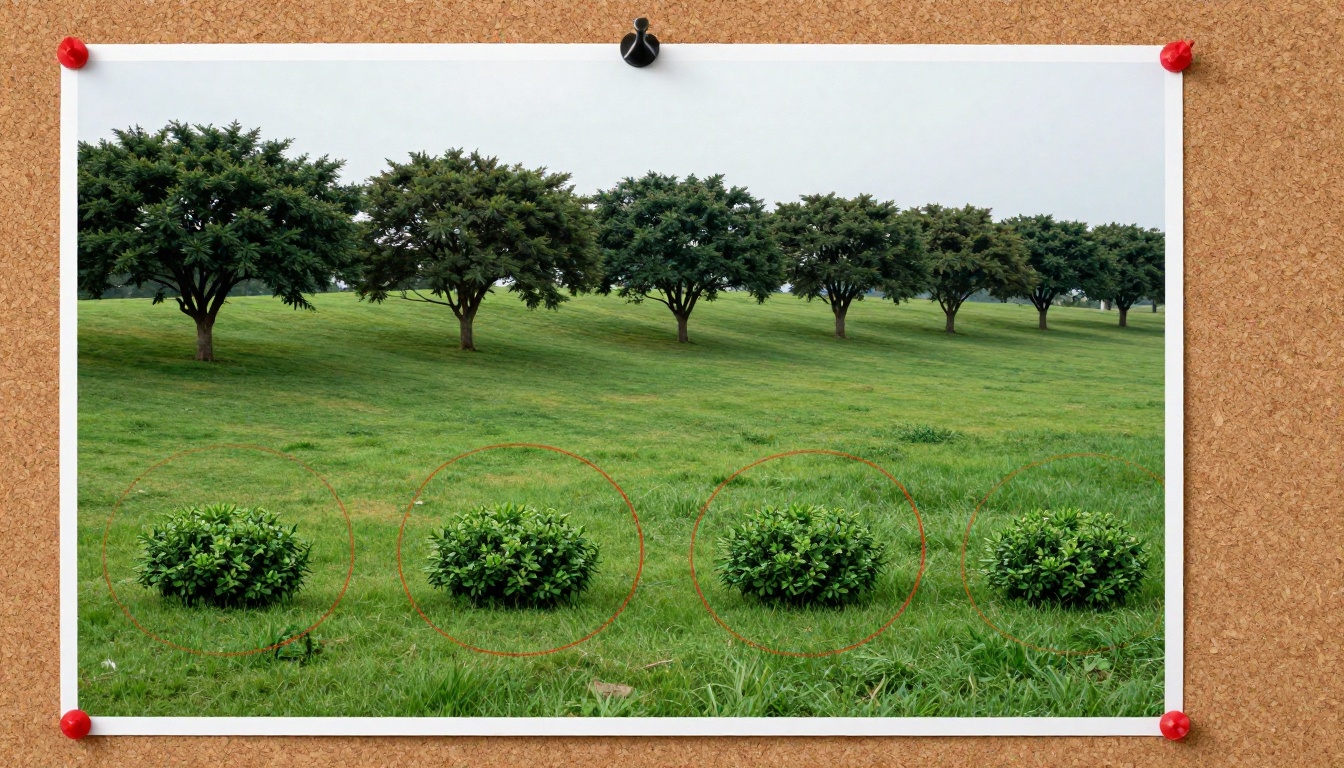
Cette catégorie de détection compte parmi les plus fiables, car les lois physiques sont absolues et l’IA ne les simule pas à partir de principes premiers.
Les directions d’ombre doivent être cohérentes
Dans une scène réelle, chaque source lumineuse projette des ombres dans une direction géométriquement cohérente avec la position de cette source. Si le soleil se trouve en haut à droite, chaque objet projette son ombre vers le bas à gauche, selon un angle cohérent avec la hauteur du soleil. Les générateurs d’images apprennent l’apparence des ombres, mais pas la physique qui gouverne leur direction et leur longueur.
Dans les scènes complexes comportant plusieurs objets, l’IA place fréquemment les ombres dans des directions incohérentes d’un objet à l’autre, comme si chaque objet était éclairé par un soleil différent. L’incohérence est souvent faible (peut-être 20 à 30 degrés d’écart), mais elle se répète sur plusieurs objets.
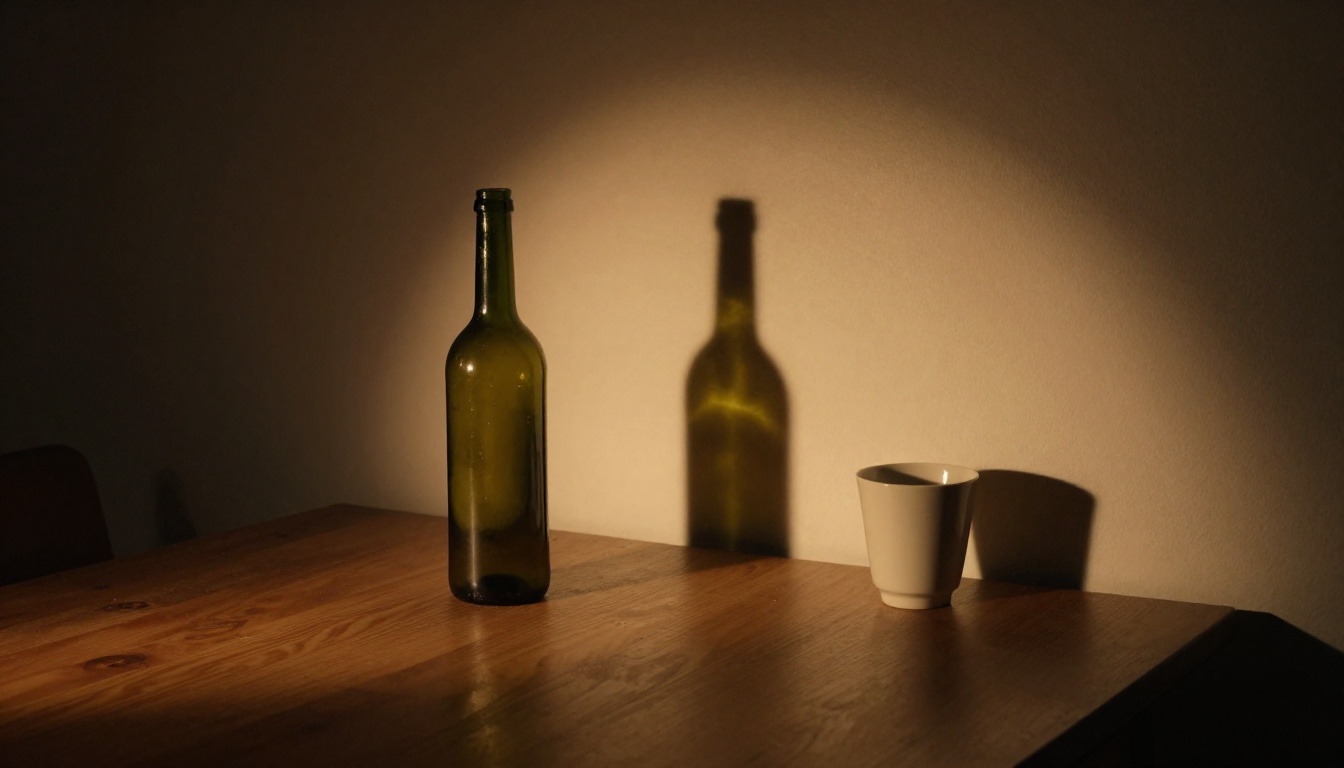
Vérifiez de façon méthodique : identifiez au moins trois objets dans l’image et suivez la direction de leurs ombres portées. Si elles divergent nettement, vous tenez un signal fort. Portez une attention particulière au plan du sol, où les ombres de plusieurs objets proches devraient converger vers un même point de fuite.
Les reflets qui violent la logique de la scène
Les surfaces réfléchissantes doivent refléter ce qui est physiquement présent dans la scène. Les yeux captent la lumière des sources actives. Les lunettes reflètent ce qui se trouve derrière le photographe. Les sols brillants renvoient le plafond et les murs. Les fenêtres la nuit reflètent l’intérieur ; les fenêtres en plein jour montrent l’extérieur.
Les reflets générés par IA montrent souvent des dégradés de ciel génériques, un flou abstrait ou des éléments de scène qui n’existent nulle part dans le cadre. Un contrôle particulièrement fiable concerne les lunettes de soleil : les verres doivent refléter la scène située devant le sujet, c’est-à-dire le photographe et son environnement. L’IA peuple souvent ces reflets de paysages issus d’un tout autre contexte.
💡 Astuce : Les fenêtres sont particulièrement révélatrices. Vérifiez que le reflet dans la fenêtre est cohérent avec le reste de l’éclairage et de l’environnement de l’image. Une scène d’intérieur nocturne devrait montrer l’intérieur de la pièce dans la vitre, et non un ciel extérieur.
Outils numériques de vérification des images
L’inspection visuelle vous mène déjà loin, mais les outils forensiques structurés vont plus loin lorsque les enjeux sont élevés, par exemple pour vérifier des images d’actualité, contrôler des revendications d’identité ou évaluer un contenu signalé comme désinformation.
Inspection des métadonnées EXIF
Chaque photo prise avec un appareil numérique intègre des métadonnées dans le fichier : marque et modèle de l’appareil, objectif, ISO, vitesse d’obturation, coordonnées GPS et horodatage. Les images générées par IA n’en ont aucune, ou elles contiennent des métadonnées clairement ajoutées après coup plutôt qu’intégrées au moment de la capture.
Utilisez des outils comme ExifTool (gratuit, en ligne de commande), Jeffrey’s Exif Viewer (gratuit, dans le navigateur) ou le panneau de métadonnées d’Adobe Bridge pour vérifier ces champs :
- Une marque et un modèle d’appareil photo sont-ils indiqués, ou le champ est-il vide ?
- Les données GPS éventuelles correspondent-elles au lieu de la scène revendiqué ?
- Le champ logiciel mentionne-t-il un micrologiciel d’appareil, ou désigne-t-il un outil d’IA ?
- L’horodatage de création est-il cohérent avec le contexte annoncé ?
Un enregistrement EXIF manquant ne confirme pas à lui seul une génération par IA, car supprimer les métadonnées avant publication est une pratique courante. Mais la combinaison de données d’appareil absentes et d’anomalies visuelles augmente nettement la probabilité d’une origine synthétique.
Recherche d’image inversée
Avant de consacrer beaucoup de temps à l’analyse, lancez une recherche d’image inversée. Si l’image a déjà été utilisée dans un autre contexte, vous pouvez remonter immédiatement à son origine.
| Outil | Idéal pour |
|---|
| Google Images | Couverture web la plus large, retrouve les quasi-doublons et les versions modifiées |
| TinEye | Suit les dates de premier import et remonte précisément à la source |
| Yandex Images | Meilleure correspondance de visages, particulièrement pour les portraits |
| Bing Visual Search | Efficace pour les objets, les monuments et l’identification de produits |
Si une photo prétendant illustrer un événement d’actualité récent n’a aucune présence antérieure sur le web, elle mérite un examen plus approfondi. Si elle remonte à un service de génération par IA ou à un site de banque d’images avec des métadonnées différentes, vous tenez votre réponse.
Logiciels de détection d’IA
| Outil | Approche de détection | Remarques |
|---|
| Hive Moderation | Classifieur à réseau de neurones entraîné sur les sorties de modèles de diffusion | Très bonne précision sur les modèles récents |
| Illuminarty | Détection d’artefacts dans les fréquences | Performant sur les images anciennes basées sur les GAN |
| AI or Not | Ensemble multimodèle | Rapide, dans le navigateur, avec une offre gratuite |
| Content Authenticity Initiative (C2PA) | Vérification cryptographique de la provenance | Concluant lorsque le créateur l’a intégrée |
| Google SynthID | Détection de filigrane | Ne détecte que les images générées par Google |
💡 Important : Aucun détecteur d’IA n’atteint 100 % de précision. Ces outils échouent sur les images lourdement retouchées ou compressées, et sur les images issues de modèles absents de leurs données d’entraînement. Considérez le résultat d’un détecteur comme un signal parmi d’autres, et non comme un verdict définitif.
Pour détecter quelque chose de façon fiable, il est utile de savoir comment cela a été fabriqué. Les modèles de diffusion modernes fonctionnent selon ces étapes :
- Partir d’une grille de bruit aléatoire pur, de la taille de l’image
- Appliquer un prompt textuel (ou une image de référence) comme signal de conditionnement
- Exécuter un processus de débruitage sur des dizaines d’itérations, chaque étape rendant l’image légèrement plus cohérente
- Produire le résultat débruité final sous forme d’image parfaitement nette au niveau du pixel
Le modèle ne comprend ni l’anatomie, ni la physique, ni la logique spatiale. Il a appris des relations statistiques entre des blocs de pixels à partir de milliards d’exemples d’entraînement. Les artefacts apparaissent précisément dans les configurations rares dans les données d’entraînement : mains dans des poses inhabituelles, scènes réfléchissantes complexes et arrière-plans denses nécessitant de nombreux éléments qui se chevauchent.
Artefacts de super-résolution
Beaucoup d’images générées par IA sont ensuite traitées par des outils d’upscaling pour augmenter leur résolution apparente et leur netteté. Des outils comme Real-ESRGAN et Clarity Pro Upscaler ajoutent des détails au niveau du pixel. Mais l’upscaling introduit ses propres artefacts : des contours sur-accentués, des textures de peau qui paraissent peintes plutôt que photographiées, et une qualité presque plastique sur les surfaces qui devraient présenter des variations naturelles de matière.
Lorsque vous rencontrez une image à la fois très haute résolution et dotée de détails anatomiques suspects, considérez qu’un upscaling a été appliqué après la génération initiale par IA. L’upscaler ajoute des détails qu’il ne peut pas réellement retrouver dans l’original (puisqu’il n’existe pas de capture photographique d’origine), ce qui produit une qualité visuelle hyperdétaillée mais fausse.
Comparer ces résultats avec des outils comme Topaz Image Upscale et Google Upscaler appliqués à de vraies photos est instructif : appliqués à des photos réelles, ces outils restaurent un grain naturel et conservent des textures de matière cohérentes, car des données d’image authentiques existent pour servir de référence.
Le domaine fréquentiel sous la surface
Au-delà de l’inspection visuelle, les chercheurs en forensique analysent les images dans le domaine fréquentiel. Les photos réelles issues de capteurs d’appareils présentent une répartition particulière des informations basses et hautes fréquences, qui reflète la physique optique et celle du capteur. Les images générées par IA ont une signature fréquentielle différente, détectable même après un post-traitement intensif ou une recompression de l’image.
C’est ainsi que les logiciels forensiques professionnels et des outils comme SynthID de Google peuvent identifier des images générées par IA qui passent entièrement l’inspection visuelle. Vous n’avez pas besoin de réaliser ces analyses vous-même, mais savoir que cette couche existe vous indique quand dépasser votre propre évaluation visuelle et faire appel à des outils institutionnels.
Forgez votre propre œil de référence
Le moyen le plus rapide d’acquérir un instinct de détection fiable est l’exposition contrôlée. Générez vous-même des images, examinez chaque artefact et constituez une base mentale de ce à quoi ressemble le « défaut » selon les niveaux de qualité et selon les différents modèles.
PicassoIA vous donne accès à des dizaines de modèles de génération d’images sur picassoia.com/en/all-models. Passez du temps à générer des prompts conçus spécifiquement pour révéler les faiblesses des modèles :
- « Personne tenant un panneau écrit à la main » (teste à la fois la gestion du texte et l’anatomie des mains)
- « Foule lors d’un concert, grand angle » (teste la répétition de l’arrière-plan et la diversité des visages)
- « Lunettes de soleil réfléchissantes, portrait en extérieur » (teste la cohérence des reflets)
- « Livres empilés avec des titres visibles sur les dos » (teste le texte à plusieurs mots)
- « Scène d’intérieur avec une lumière directionnelle dure » (teste la physique des ombres)
Chacun de ces prompts révèle de façon fiable les limites du modèle que vous utilisez. Les artefacts qu’ils produisent deviennent votre référence d’empreintes. Lorsque vous rencontrez une image suspecte dans la nature, vous disposez d’un catalogue mental pour la comparer, plutôt que de simples règles abstraites à appliquer consciemment.
💡 Flux de travail : Générez cinq images de mains avec différents modèles sur PicassoIA. Faites des captures d’écran des artefacts que vous remarquez. Lorsque vous voyez une image suspecte sur les réseaux sociaux, comparez la qualité des mains à votre jeu de référence. Une reconnaissance de formes construite à partir d’exemples réels surpasse systématiquement les listes de contrôle théoriques.
Il ne s’agit pas seulement d’une compétence technique. C’est une forme d’éducation aux médias, à l’heure où les images de synthèse circulent sur tous les canaux d’information que vous utilisez au quotidien. Plus vous créez et étudiez des images d’IA de façon délibérée, plus vous les repérerez avec fiabilité lorsque l’authenticité compte vraiment.
Liste de contrôle rapide


