AI-जनरेटेड इमेज अब उस मुकाम पर पहुँच गई हैं जहाँ आम नज़र से उन्हें पहचानना लगभग नामुमकिन है। जिस पहचान के लिए पहले एक प्रशिक्षित आँख चाहिए थी, जैसे टेढ़े हाथ, धुंधले किनारे और गलत अनुपात, अब उसके लिए एक व्यवस्थित तरीका चाहिए। आर्टिफ़ैक्ट इतने सूक्ष्म हो गए हैं, आउटपुट इतने फोटोरियलिस्टिक हैं, और उन्हें बनाने वाले टूल हर उस व्यक्ति के लिए उपलब्ध हैं जिसके पास ब्राउज़र है। यह लेख आपको सिंथेटिक इमेज को आपको धोखा देने से पहले पकड़ने की एक व्यावहारिक, चरण-दर-चरण प्रणाली देता है।
AI इमेज को अब पहचानना क्यों मुश्किल है
कई सालों तक इमेज सिंथेसिस का प्रमुख तरीका GAN (Generative Adversarial Network) था, जिसमें दो न्यूरल नेटवर्क बिल्ली-और-चूहे के खेल की तरह यथार्थवादी आउटपुट बनाने के लिए एक-दूसरे से मुकाबला करते थे। GAN अपने अलग निशान छोड़ते थे: त्वचा की बनावट जो झिलमिलाती थी, बैकग्राउंड जो अमूर्त घोल में धुल जाते थे, और कुख्यात रूप से विकृत हाथ।
डिफ़्यूज़न मॉडल ने सब कुछ बदल दिया। शुद्ध नॉइज़ से शुरू करके और धीरे-धीरे एक सुसंगत इमेज की ओर परिष्कृत करके, ये बारीक डिटेल में सुसंगत, प्राकृतिक बैकग्राउंड और कहीं ज़्यादा विश्वसनीय शरीर-रचना वाले आउटपुट देते हैं। PicassoIA जैसे प्लेटफ़ॉर्म इनमें से दर्जनों मॉडल होस्ट करते हैं, जो फोटोरियलिस्टिक चेहरे, पूरे-शरीर के शॉट और जटिल परिवेश वाले दृश्य बना सकते हैं, जो सरसरी नज़र में बिना किसी शक के निकल जाते हैं।
2027 में यथार्थता की सीमा
पिछले दो सालों में प्रकाशित कई अकादमिक अध्ययनों में, मानव प्रतिभागियों ने AI-जनरेटेड चेहरों को असली लोगों की फ़ोटो से "ज़्यादा भरोसेमंद" माना, और यह अंतर सांख्यिकीय रूप से महत्वपूर्ण था। अनकैनी वैली अब वैली नहीं रही। यह एक पठार बन गई है, जहाँ सिंथेटिक इमेज असली इमेज के बगल में आराम से बैठ जाती हैं। लेकिन दरारें अब भी मौजूद हैं। आपको बस यह जानना है कि दबाना कहाँ है।
पहचान अब भी संभव रहने की मुख्य वजह यह है कि AI इमेज जनरेटर सांख्यिकीय सहसंबंध सीखते हैं, भौतिकी के नियम नहीं। वे ट्रेनिंग डेटा के आधार पर जानते हैं कि चीज़ें एक-दूसरे के साथ आम तौर पर कैसी दिखती हैं, लेकिन वे गुरुत्वाकर्षण, प्रकाश की भौतिकी या मानव शरीर-रचना को बुनियादी सिद्धांतों से नहीं समझते। यही अंतर हर भरोसेमंद पहचान तरीके का आधार है।
वे शरीर के अंग जिन्हें AI अब भी गलत बनाता है
सतही डिटेल के स्तर पर मानव शरीर-रचना असाधारण रूप से जटिल है। त्वचा सिर्फ़ मांसपेशियों को ढकती नहीं है; वह मुद्रा, उम्र, ऊतक के प्रकार और आसपास के तापमान के आधार पर संदर्भ के अनुसार सिकुड़ती, मुड़ती, सलवटें बनाती और खिंचती है। AI उन परिणामों की इमेज से सीखता है, लेकिन उनके मूल कारणों पर तर्क नहीं कर सकता। जब उसे ट्रेनिंग सेट में दुर्लभ शरीर-संरचना मिलती है, तो वह सांख्यिकीय रूप से सबसे संभावित आउटपुट बनाता है, जो अक्सर शरीर-रचना के हिसाब से गलत होता है।
हाथ और उंगलियाँ सबसे बड़ा संकेत हैं
AI-जनरेटेड इमेज में हाथ अब भी सबसे भरोसेमंद संकेत हैं। कुछ और करने से पहले उंगलियाँ गिनें। उंगलियों की लंबाई का अनुपात देखें: असली हाथ में बीच की उंगली सबसे लंबी होती है, फिर अनामिका, फिर तर्जनी, फिर छोटी उंगली, और अंगूठा साफ़ तौर पर छोटा और अलग दिशा में होता है। नकल के जोड़ों का संरेखण जाँचें। हर उंगली के तीनों जोड़ों का एक-दूसरे के सापेक्ष कोण सुसंगत होना चाहिए।
AI अक्सर छह या सात उंगलियाँ, आपस में जुड़ी उंगलियाँ, आसपास की उंगलियों के बीच अलग-अलग आकार के नाखून, या ऐसे जोड़ बनाता है जो एक उंगली से दूसरी उंगली तक ट्रेस करने पर अपनी जगह बदलते दिखते हैं। उंगलियों के बीच की झिल्ली भी एक भरोसेमंद संकेत है: असली हाथों में इंटरडिजिटल झिल्ली की गहराई और कोण सुसंगत होते हैं, जिन्हें AI लगातार या तो बहुत उथला या बहुत गहरा दिखाता है।
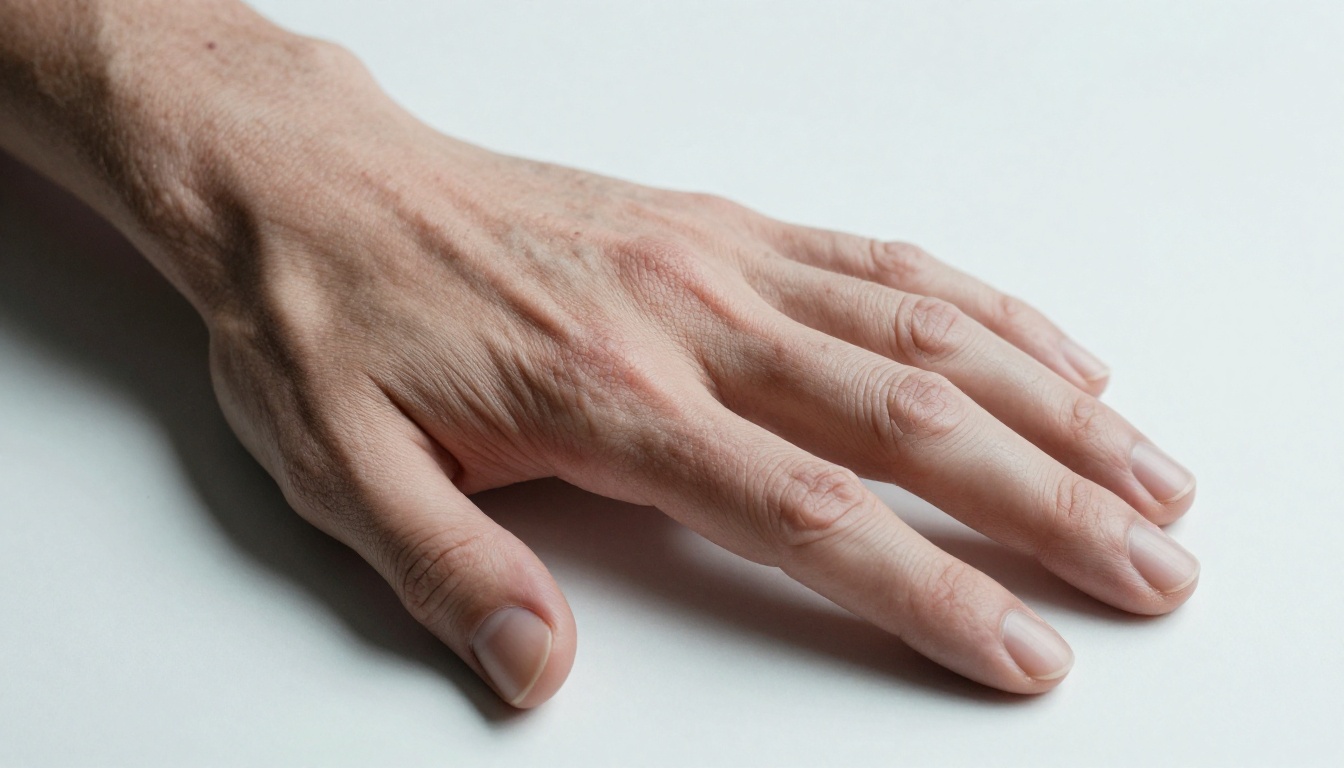
कलाई को भी जाँचें। रेडियस और अल्ना हड्डियाँ कलाई के जोड़ पर एक खास दिखने वाली रूपरेखा बनाती हैं, जो घूमने पर बदलती है। AI-जनरेटेड कलाइयाँ अक्सर सपाट, सममित होती हैं और उनमें असली कलाई की शरीर-रचना वाले सूक्ष्म हड्डी के निशान नहीं होते।
बहुत ज़्यादा परफ़ेक्ट दिखने वाली आँखें
AI इमेज में आँखों में एक बहुत खास तरह की गड़बड़ी होती है: वे अक्सर बहुत ज़्यादा सममित और बहुत ज़्यादा चमकीली होती हैं। असली आँखों में सूक्ष्म असममितता होती है। एक पलक आम तौर पर दूसरी से थोड़ी नीचे होती है। आईरिस शायद ही कभी पूरी तरह केंद्र में होता है। सफ़ेद हिस्से में न्यूनतम लेकिन दिखने वाले रक्त-वाहिका पैटर्न होते हैं, और वास्तविक रोशनी में वे शायद ही कभी शुद्ध सफ़ेद होते हैं, आम तौर पर हल्के क्रीम या गुलाबी रंग के दिखते हैं।
AI-जनरेटेड आँखों में अक्सर बिल्कुल केंद्रित आईरिस होते हैं, जिनमें रेडियली सममित, लगभग फ़्रैक्टल-जैसे पैटर्न होते हैं। कैचलाइट (आईरिस में छोटे चमकीले प्रतिबिंब) आसपास की इमेज में किसी पहचाने जा सकने वाले प्रकाश स्रोत से मेल नहीं खाते। पलकें बहुत समान रूप से बँटी होती हैं, लंबाई में बहुत एकसमान होती हैं, और अक्सर एक-दूसरे से असामान्य रूप से साफ़ तरीके से अलग दिखती हैं।
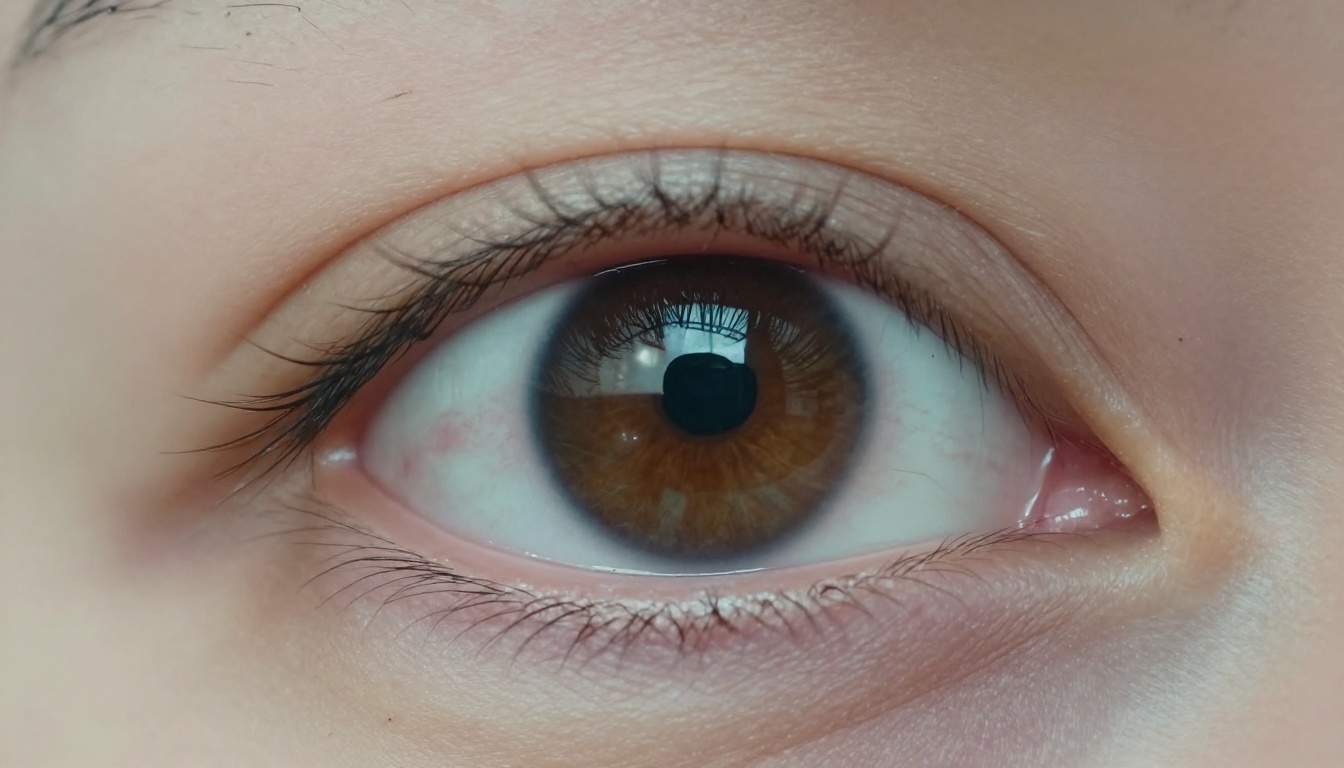
💡 टिप: किसी संदिग्ध इमेज पर अपने फ़ोन का पिंच-ज़ूम इस्तेमाल करें। हर आँख को अलग-अलग देखें और आईरिस का आकार, पुतली की स्थिति और कैचलाइट की जगह की तुलना करें। एक जैसी आँखें एक चेतावनी संकेत हैं। असली चेहरों में लगभग कभी भी पूरी तरह एक जैसी आँखें नहीं होतीं।
जहाँ बाल सीमा क्षेत्र में मिलते हैं
जहाँ बाल किसी जटिल बैकग्राउंड से मिलते हैं, वहीं डिफ़्यूज़न मॉडल सबसे साफ़ तौर पर संघर्ष करते हैं। पेड़ों, भीड़ या दीवारों जैसे बैकग्राउंड तत्वों को रेंडर करते हुए अलग-अलग बालों की लड़ी की निरंतरता बनाए रखने के लिए मॉडल को एक बहुत कठिन स्पेशियल तर्क समस्या हल करनी पड़ती है। AI किनारों पर अक्सर बालों की लड़ियों को आपस में मिला देता है, बालों की रूपरेखा पर पेंट किए जैसा रूप बनाता है, या औसत रंग के नरम हेलो बनाता है, जहाँ बारीक अलग-अलग बालों की डिटेल दिखनी चाहिए।
उड़ते बालों पर खास ध्यान दें। हल्के आसमान के सामने गहरे बालों की असली फ़ोटोग्राफ़ी में प्राकृतिक घुमाव और गति के साथ अलग-अलग पतले बाल दिखते हैं। AI या तो इन्हें पूरी तरह छोड़ देता है, या ऐसे बाल बनाता है जो वॉटरकलर जैसी गुणवत्ता के साथ बैकग्राउंड में धुलकर गायब हो जाते हैं, बजाय इसके कि वे स्वाभाविक रूप से खत्म हों।
टेक्स्ट, लोगो और बैकग्राउंड
गड़बड़ाए अक्षर एक निश्चित संकेत हैं
किसी भी AI इमेज जनरेटर से पढ़ने योग्य साइनबोर्ड, खुली किताब, लेबल, या टेक्स्ट वाली टी-शर्ट वाला दृश्य बनवाएँ, तो नतीजा लगभग हमेशा गड़बड़ाया हुआ होगा। डिफ़्यूज़न मॉडल भाषा या अक्षरों की बनावट नहीं समझते। वे सांख्यिकीय अर्थ में जानते हैं कि अक्षर-जैसे पैटर्न कैसे दिखते हैं, और वे उस अनुमानित रूप को दोहराते हैं, बिना असली शब्द बनाए।
थंबनेल के आकार पर आउटपुट विश्वसनीय लगता है: आप देख सकते हैं कि इमेज में "टेक्स्ट" है। करीब से देखने पर अक्षर एक-दूसरे में घुल जाते हैं, गलत क्रम में दोहराए जाते हैं, या ऐसी शृंखलाएँ बनाते हैं जो दूर से शब्दों जैसी लगती हैं, लेकिन ज़ूम करने पर पूरी तरह अपठनीय होती हैं।
यह सबसे तेज़ जाँचों में से एक है: इमेज में दिख रहे किसी भी टेक्स्ट को ज़ूम करें। अगर वह पढ़ने योग्य नहीं है, तो इमेज संदिग्ध है। ध्यान रहे कि कुछ नए मॉडल स्पष्ट प्रॉम्प्ट मिलने पर सरल टेक्स्ट बेहतर संभालते हैं, लेकिन कई-शब्दों वाले साइनबोर्ड, प्रोडक्ट लेबल और किताबों की स्पाइन AI जनरेशन में लगातार अविश्वसनीय रहते हैं।
जटिल बैकग्राउंड में दोहराव वाले पैटर्न
जब AI जंगल, भीड़ या टाइल वाली सतहों जैसे जटिल दृश्य बनाता है, तो वह फ़्रेम भरने के लिए अक्सर टेक्सचर के टुकड़ों को टाइल या मिरर करता है। इससे ऐसा दोहराव बनता है जो कोई असली फ़ोटो नहीं रखेगी। एक ही चट्टान की बनावट नियमित अंतराल पर तीन बार दिखना, मध्य-भूमि में एक ही पेड़ की आकृति का मिरर होना, या फ़र्श की टाइलों में एक जैसा दरार का पैटर्न होना, ये सभी मज़बूत संकेत हैं।
इमेज को ग्रिड में बाँटकर और हिस्सों की तुलना करके बैकग्राउंड को व्यवस्थित रूप से स्कैन करें। भीड़ वाले दृश्यों में यह खास तौर पर होता है: अगर आप दो ऐसे चेहरे पहचानते हैं जिनकी हड्डियों की संरचना और अनुपात एक जैसे हैं, तो इमेज लगभग निश्चित रूप से सिंथेटिक तरीके से बनी है।
लाइटिंग और भौतिकी AI को कैसे उजागर करती है
पहचान की यह श्रेणी सबसे भरोसेमंद में से एक है, क्योंकि भौतिकी के नियम अटल हैं और AI उन्हें बुनियादी सिद्धांतों से नहीं समझता।
परछाइयों की दिशा सुसंगत होनी चाहिए
असली दृश्य में हर प्रकाश स्रोत ऐसी परछाइयाँ डालता है जो स्रोत की स्थिति के अनुसार ज्यामितीय रूप से सुसंगत होती हैं। अगर सूरज ऊपर दाईं ओर है, तो हर वस्तु अपनी परछाईं नीचे बाईं ओर डालती है, और उसका कोण सूरज की ऊँचाई के अनुरूप होता है। AI इमेज जनरेटर परछाइयों का रूप सीखते हैं, लेकिन उनकी दिशा और लंबाई को नियंत्रित करने वाली भौतिकी नहीं।
जटिल, कई-वस्तु वाले दृश्यों में AI अक्सर परछाइयाँ ऐसी दिशाओं में डालता है जो वस्तुओं के बीच असंगत होती हैं, मानो हर वस्तु पर अलग सूरज की रोशनी पड़ रही हो। यह असंगति अक्सर छोटी होती है (शायद 20 से 30 डिग्री का विचलन), लेकिन कई वस्तुओं में सुसंगत रूप से दिखती है।
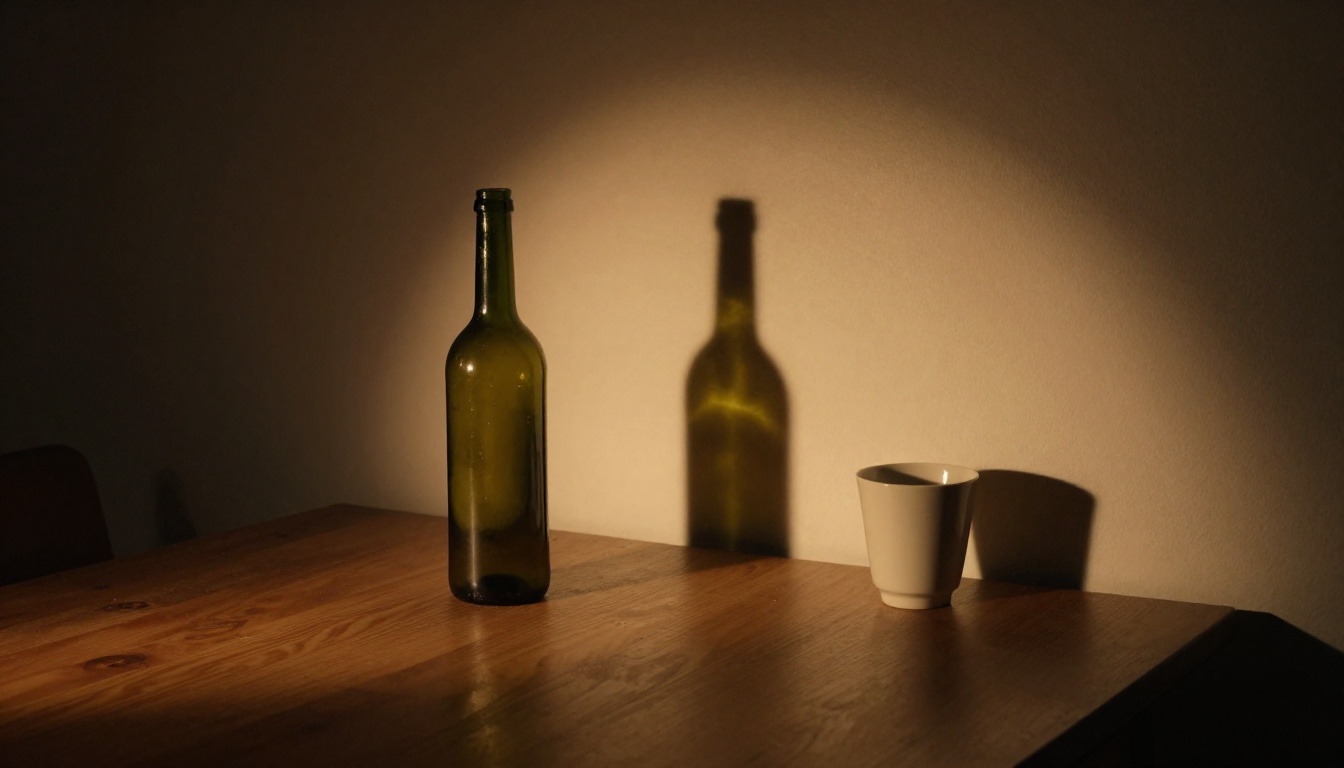
व्यवस्थित रूप से जाँचें: इमेज में कम से कम तीन वस्तुएँ पहचानें और देखें कि उनकी डाली गई परछाइयाँ किस दिशा में जाती हैं। अगर वे काफ़ी अलग हैं, तो आपको एक मज़बूत संकेत मिला है। ज़मीन के तल पर खास ध्यान दें, जहाँ पास की वस्तुओं की कई परछाइयाँ एक ही वैनिशिंग पॉइंट की ओर मिलनी चाहिए।
रिफ़्लेक्शन जो दृश्य के तर्क का उल्लंघन करते हैं
चमकदार सतहों को वही प्रतिबिंबित करना चाहिए जो दृश्य में भौतिक रूप से मौजूद है। आँखें उन सभी सक्रिय स्रोतों से रोशनी पकड़ती हैं। चश्मे उस चीज़ को प्रतिबिंबित करते हैं जो फ़ोटोग्राफ़र के पीछे है। चमकीले फ़र्श छत और दीवारों को दिखाते हैं। रात में खिड़कियाँ अंदरूनी हिस्सा प्रतिबिंबित करती हैं; दिन की रोशनी में खिड़कियाँ बाहरी दृश्य दिखाती हैं।
AI-जनरेटेड रिफ़्लेक्शन में अक्सर सामान्य आसमानी ग्रेडिएंट, अमूर्त ब्लर, या ऐसे दृश्य तत्व दिखते हैं जो फ़्रेम में कहीं मौजूद ही नहीं हैं। एक खास तौर पर भरोसेमंद जाँच धूप के चश्मे की है: लेंस में सब्जेक्ट के सामने का दृश्य दिखना चाहिए, यानी फ़ोटोग्राफ़र और आसपास का माहौल। AI अक्सर उन लेंस रिफ़्लेक्शन को किसी बिल्कुल अलग संदर्भ के दृश्यों से भर देता है।
💡 टिप: खिड़कियाँ बहुत ज़्यादा खुलासा करने वाली होती हैं। जाँचें कि खिड़की का रिफ़्लेक्शन इमेज की बाकी लाइटिंग और माहौल से मेल खाता है या नहीं। रात के इनडोर दृश्य में खिड़की में कमरे का अंदरूनी हिस्सा दिखना चाहिए, न कि बाहर का आसमान।
इमेज सत्यापन के डिजिटल टूल
दृश्य निरीक्षण आपको काफ़ी दूर तक ले जाता है, लेकिन जब दाँव ऊँचे हों, जैसे समाचार इमेज की पुष्टि करना, पहचान के दावों की जाँच करना, या गलत जानकारी के लिए चिह्नित कंटेंट का आकलन करना, तब संरचित फ़ॉरेंसिक टूल आपको और आगे ले जाते हैं।
EXIF मेटाडेटा जाँच
डिजिटल कैमरे से ली गई हर फ़ोटो फ़ाइल में मेटाडेटा एम्बेड करती है: कैमरा का मेक और मॉडल, लेंस, ISO, शटर स्पीड, GPS निर्देशांक और टाइमस्टैम्प। AI-जनरेटेड इमेज में इनमें से कुछ भी नहीं होता, या उनमें ऐसा मेटाडेटा होता है जो कैप्चर के समय एम्बेड होने के बजाय स्पष्ट रूप से बाद में जोड़ा गया होता है।
इन फ़ील्ड की जाँच के लिए ExifTool (मुफ़्त, कमांड-लाइन), Jeffrey's Exif Viewer (ब्राउज़र-आधारित और मुफ़्त), या Adobe Bridge के मेटाडेटा पैनल जैसे टूल इस्तेमाल करें:
- क्या कैमरा मेक और मॉडल सूचीबद्ध है, या फ़ील्ड खाली है?
- क्या कोई GPS लोकेशन डेटा दावा किए गए दृश्य के स्थान से मेल खाता है?
- क्या सॉफ़्टवेयर फ़ील्ड में कैमरा फ़र्मवेयर दिखता है, या किसी AI टूल का नाम है?
- क्या क्रिएशन टाइमस्टैम्प दावा किए गए संदर्भ से मेल खाता है?
अकेले गायब EXIF रिकॉर्ड यह पुष्टि नहीं करता कि इमेज AI-जनरेटेड है, क्योंकि प्रकाशित करने से पहले मेटाडेटा हटाना आम प्रथा है। लेकिन विज़ुअल गड़बड़ियों के साथ गायब कैमरा डेटा का संयोजन सिंथेटिक मूल की संभावना को काफ़ी बढ़ा देता है।
रिवर्स इमेज सर्च
गहन विश्लेषण में काफ़ी समय लगाने से पहले, रिवर्स इमेज सर्च चलाएँ। अगर इमेज पहले किसी अलग संदर्भ में इस्तेमाल हो चुकी है, तो आप उसका मूल तुरंत खोज सकते हैं।
| टूल | सबसे अच्छा किसके लिए |
|---|
| Google Images | वेब पर सबसे व्यापक कवरेज, निकट-डुप्लिकेट और संशोधित वर्ज़न खोजता है |
| TinEye | मूल अपलोड की तारीखों और सटीक स्रोत की ट्रैकिंग करता है |
| Yandex Images | सबसे मज़बूत चेहरा-मिलान, खासकर पोर्ट्रेट के लिए |
| Bing Visual Search | वस्तुओं, लैंडमार्क और प्रोडक्ट की पहचान के लिए प्रभावी |
अगर कोई फ़ोटो मौजूदा समाचार घटना की होने का दावा करती है, लेकिन उसकी वेब पर कोई पिछली मौजूदगी नहीं है, तो यह गहरी जाँच की माँग करती है। अगर वह किसी AI जेनरेशन सेवा या स्टॉक इमेज साइट तक पहुँचती है जिसका मेटाडेटा अलग है, तो आपको अपना जवाब मिल गया।
AI डिटेक्शन सॉफ़्टवेयर
| टूल | डिटेक्शन तरीका | नोट्स |
|---|
| Hive Moderation | डिफ़्यूज़न आउटपुट पर ट्रेन किया गया न्यूरल नेटवर्क क्लासिफ़ायर | नए मॉडल पर उच्च सटीकता |
| Illuminarty | फ़्रीक्वेंसी आर्टिफ़ैक्ट डिटेक्शन | पुरानी GAN-आधारित इमेज पर मज़बूत |
| AI or Not | मल्टी-मॉडल एन्सेम्बल | तेज़, ब्राउज़र-आधारित, मुफ़्त टियर उपलब्ध |
| Content Authenticity Initiative (C2PA) | क्रिप्टोग्राफ़िक प्रोवेनेंस सत्यापन | जब क्रिएटर ने इसे एम्बेड किया हो, तब निर्णायक |
| Google SynthID | वॉटरमार्क डिटेक्शन | केवल Google द्वारा बनाई गई इमेज पकड़ता है |
💡 महत्वपूर्ण: कोई भी AI डिटेक्टर 100% सटीकता हासिल नहीं करता। ये टूल भारी पोस्ट-प्रोसेस्ड या कंप्रेस्ड इमेज पर, और उन मॉडल की इमेज पर विफल होते हैं जो उनके ट्रेनिंग डेटा में नहीं थे। डिटेक्टर के आउटपुट को अंतिम फ़ैसला नहीं, बल्कि कई संकेतों में से एक संकेत मानें।
AI जनरेटर ये इमेज कैसे बनाते हैं
किसी चीज़ को भरोसेमंद तरीके से पहचानने के लिए यह जानना मदद करता है कि उसे कैसे बनाया गया है। आधुनिक डिफ़्यूज़न मॉडल इन चरणों से काम करते हैं:
- इमेज के आकार की शुद्ध रैंडम नॉइज़ की ग्रिड से शुरुआत करें
- टेक्स्ट प्रॉम्प्ट (या रेफ़रेंस इमेज) को कंडीशनिंग सिग्नल के रूप में लागू करें
- दर्जनों इटरेशन में डिनॉइज़िंग प्रक्रिया चलाएँ, जिसमें हर चरण इमेज को थोड़ा और सुसंगत बनाता है
- अंतिम डिनॉइज़्ड परिणाम को पिक्सल-परफ़ेक्ट इमेज के रूप में आउटपुट करें
मॉडल को शरीर-रचना, भौतिकी या स्पेशियल तर्क की कोई समझ नहीं होती। उसने अरबों ट्रेनिंग उदाहरणों के आधार पर पिक्सल के पैच के बीच सांख्यिकीय संबंध सीखे हैं। आर्टिफ़ैक्ट ठीक उन संरचनाओं में दिखते हैं जो ट्रेनिंग डेटा में दुर्लभ थीं: असामान्य मुद्राओं वाले हाथ, जटिल परावर्तक दृश्य, और कई ओवरलैपिंग तत्वों वाले घने बैकग्राउंड।
सुपर-रिज़ोल्यूशन आर्टिफ़ैक्ट
कई AI-जनरेटेड इमेज को बाद में उनका दिखने वाला रिज़ोल्यूशन और शार्पनेस बढ़ाने के लिए अपस्केलिंग टूल से गुज़ारा जाता है। Real-ESRGAN और Clarity Pro Upscaler जैसे टूल पिक्सल-स्तर की डिटेल जोड़ते हैं। लेकिन अपस्केलिंग अपने अलग आर्टिफ़ैक्ट लाती है: ज़्यादा शार्प किनारे, ऐसी त्वचा की बनावट जो फ़ोटो खींची हुई होने के बजाय पेंट की हुई लगती है, और उन सतहों पर लगभग प्लास्टिक जैसी गुणवत्ता जिनमें प्राकृतिक सामग्री की विविधता होनी चाहिए।
जब आपको एक ही समय पर उच्च रिज़ोल्यूशन और संदिग्ध शारीरिक डिटेल वाली इमेज मिले, तो मानें कि प्रारंभिक AI जनरेशन के बाद अपस्केलिंग लागू की गई थी। अपस्केलर ऐसी डिटेल जोड़ता है जो वह मूल इमेज से वास्तव में नहीं ला सकता (क्योंकि कोई मूल फ़ोटोग्राफ़िक कैप्चर मौजूद नहीं है), जिससे एक अति-विस्तृत-फिर-भी-गलत विज़ुअल गुणवत्ता बनती है।
असली फ़ोटो पर इस्तेमाल किए गए Topaz Image Upscale और Google Upscaler जैसे टूल से इसकी तुलना करना सिखाने वाला है: असली फ़ोटो पर लागू होने पर ये टूल प्राकृतिक ग्रेन बहाल करते हैं और सामग्री की बनावट को सुसंगत रखते हैं, क्योंकि संदर्भ के लिए असली इमेज डेटा मौजूद होता है।
सतह के नीचे फ़्रीक्वेंसी डोमेन
दृश्य निरीक्षण से आगे, फ़ॉरेंसिक शोधकर्ता इमेज का फ़्रीक्वेंसी डोमेन में विश्लेषण करते हैं। कैमरा सेंसर की असली फ़ोटो में कम-फ़्रीक्वेंसी और उच्च-फ़्रीक्वेंसी जानकारी का एक खास वितरण होता है, जो ऑप्टिकल और सेंसर भौतिकी को दर्शाता है। AI-जनरेटेड इमेज की फ़्रीक्वेंसी सिग्नेचर अलग होती है, और यह तब भी पहचानी जा सकती है जब इमेज को भारी पोस्ट-प्रोसेस या री-कंप्रेस किया गया हो।
इसी तरह पेशेवर फ़ॉरेंसिक सॉफ़्टवेयर, और Google के SynthID जैसे टूल, उन AI-जनरेटेड इमेज को पहचान सकते हैं जो दृश्य जाँच को पूरी तरह पार कर जाती हैं। आपको ये विश्लेषण खुद चलाने की ज़रूरत नहीं है, लेकिन यह परत मौजूद है यह जानना आपको बताता है कि कब अपने दृश्य आकलन से आगे बढ़कर संस्थागत टूल की मदद लेनी चाहिए।
अपनी खुद की संदर्भ नज़र बनाएँ
भरोसेमंद पहचान की सहज समझ पाने का सबसे तेज़ रास्ता नियंत्रित अभ्यास है। खुद इमेज बनाएँ, हर आर्टिफ़ैक्ट की जाँच करें, और अलग-अलग गुणवत्ता स्तरों और अलग-अलग मॉडल पर "गलत" कैसा दिखता है, इसका मानसिक डेटाबेस बनाएँ।
PicassoIA आपको picassoia.com/en/all-models पर दर्जनों इमेज जनरेशन मॉडल तक पहुँच देता है। ऐसे प्रॉम्प्ट बनाने में समय लगाएँ जो खास तौर पर मॉडल की कमज़ोरियाँ उजागर करने के लिए डिज़ाइन किए गए हों:
- "Person holding a handwritten sign" (टेक्स्ट हैंडलिंग और हाथ की शरीर-रचना, दोनों एक साथ जाँचता है)
- "कॉन्सर्ट में भीड़, वाइड एंगल" (बैकग्राउंड दोहराव और चेहरों की विविधता जाँचता है)
- "रिफ़्लेक्टिव धूप का चश्मा, बाहर का पोर्ट्रेट" (रिफ़्लेक्शन की सुसंगति जाँचता है)
- "स्पाइन पर दिखने वाले शीर्षकों वाली जमी हुई किताबें" (कई शब्दों वाला टेक्स्ट जाँचता है)
- "सख्त दिशात्मक लैंप रोशनी वाला इंटीरियर दृश्य" (परछाई की भौतिकी जाँचता है)
इनमें से हर प्रॉम्प्ट भरोसे के साथ उस मॉडल की सीमाएँ सामने लाता है जिसका आप इस्तेमाल कर रहे हैं। वे जो आर्टिफ़ैक्ट बनाते हैं, वही आपका फ़िंगरप्रिंट संदर्भ बन जाते हैं। जब आपको बाहर कोई संदिग्ध इमेज मिलती है, तो आपके पास तुलना के लिए मानसिक कैटलॉग होता है, न कि ऐसे अमूर्त नियम जिन्हें आपको सचेत रूप से लागू करना पड़े।
💡 वर्कफ़्लो: PicassoIA पर अलग-अलग मॉडल से हाथों की पाँच इमेज बनाएँ। जो आर्टिफ़ैक्ट दिखें, उनके स्क्रीनशॉट लें। जब आपको कोई संदिग्ध सोशल मीडिया इमेज मिले, तो हाथ की गुणवत्ता की तुलना अपने संदर्भ सेट से करें। असली उदाहरणों से बनी पैटर्न पहचान लगातार सैद्धांतिक चेकलिस्ट से बेहतर प्रदर्शन करती है।
यह सिर्फ़ तकनीकी कौशल नहीं है। यह उस दौर की मीडिया साक्षरता है, जब सिंथेटिक इमेज हर उस सूचना चैनल में बहती हैं जिसका आप रोज़ इस्तेमाल करते हैं। आप AI इमेज जितनी सोच-समझकर बनाएँगे और उनका अध्ययन करेंगे, जब प्रामाणिकता सच में मायने रखेगी तब उतने ही भरोसे से आप उन्हें पकड़ पाएँगे।
त्वरित संदर्भ चेकलिस्ट


