Générer un beau personnage IA une fois est facile. Obtenir ce même visage sur les 20 images suivantes, c’est là que la plupart des gens abandonnent. Le nez bouge légèrement, les yeux changent de forme, la mâchoire s’adoucit ou se durcit, et soudain vous avez une galerie pleine d’inconnues au lieu d’une seule personne cohérente d’une scène à l’autre. Pour la génération NSFW par IA, cette incohérence est l’un des problèmes les plus courants et les plus frustrants pour les créateurs, et elle a des solutions concrètes.
Pourquoi les visages des personnages se dégradent à chaque fois
Toute génération classique de texte vers image part d’un bruit aléatoire. Le modèle échantillonne une distribution de probabilités massive et construit une image qui correspond statistiquement à votre prompt. Cela signifie que deux générations avec exactement le même prompt produisent deux visages différents, car « belle femme aux yeux sombres et aux pommettes marquées » décrit simultanément des millions de visages possibles.
Le modèle n’a pas de mémoire. Aucune notion de « la même personne que la dernière fois ». Chaque génération est totalement indépendante.
Les limites du prompt détaillé
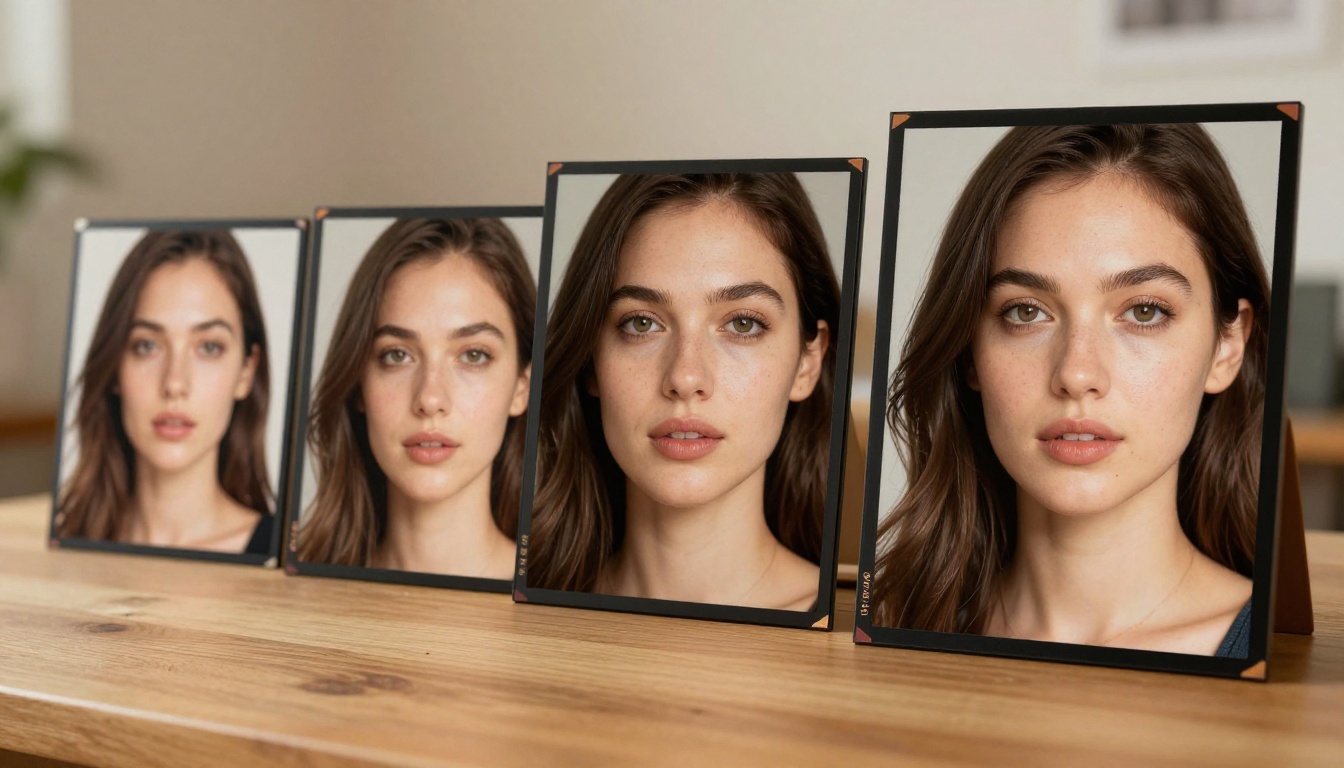
Le réflexe est d’écrire des descriptions de visage plus longues et plus précises. « Visage ovale, yeux noisette enfoncés, pommettes hautes, petit nez retroussé, lèvres pleines au teint naturel, peau olive claire, petit grain de beauté au-dessus de la lèvre droite. » La plupart des créateurs ont essayé. Cela ne fonctionne pas de façon fiable.
Les prompts détaillés resserrent légèrement la distribution sans la figer. Deux générations avec cette description exacte produisent encore des personnes nettement différentes. Vous obtiendrez peut-être la même esthétique générale, mais pas le même visage.
Ce problème ne se résout pas uniquement avec un meilleur prompting. La solution consiste à fournir au modèle une véritable image de référence, et non une description textuelle.
Ce que le verrouillage du visage signifie concrètement
Le « verrouillage du visage » désigne toute technique qui ancre une identité faciale précise dans les générations futures. Au lieu de décrire le visage avec des mots, vous fournissez au modèle une image de ce visage et lui demandez de préserver cette identité tout en modifiant librement le reste : tenue, arrière-plan, éclairage, pose, ambiance.
Le résultat correspond à ce que tout créateur NSFW sérieux veut vraiment : un personnage, une infinité de scénarios, tous indiscutablement la même personne.
Trois méthodes qui fonctionnent vraiment
Les plateformes d’IA modernes utilisent trois approches techniques distinctes pour la génération à visage verrouillé. Chacune présente des compromis différents en qualité, en souplesse et en temps de configuration.
Méthode 1 : édition d’image contextuelle
La plus récente, et la plus accessible. Des modèles comme Flux Kontext Pro et Flux Kontext Max acceptent une image existante en entrée et vous permettent de modifier des éléments précis tout en préservant explicitement le reste.
Vous fournissez votre image de référence canonique du personnage, puis rédigez des instructions textuelles décrivant uniquement ce que vous voulez changer : tenue, décor, éclairage, pose. Le modèle gère la préservation du visage en interne, sans configuration supplémentaire.
Cette approche ne demande aucun temps de préparation. C’est le chemin le plus rapide entre l’image de référence et une série cohérente autour du même personnage.
💡 Flux Kontext Pro est le point de départ recommandé pour la plupart des créateurs. Il ne demande ni entraînement ni configuration technique, et produit des résultats cohérents en quelques secondes dès que vous fournissez votre image de référence.
Méthode 2 : fine-tuning LoRA
Le LoRA (Low-Rank Adaptation) est la méthode la plus fidèle pour une cohérence profonde du personnage. Vous réunissez 15 à 30 images de votre personnage et entraînez un petit fichier d’adaptation qui s’injecte dans n’importe quelle génération, attirant le modèle vers ce visage précis au niveau fondamental.
Le compromis : l’entraînement demande du temps et des ressources. Mais une fois créé, un LoRA de personnage offre une cohérence qu’aucune autre méthode ne peut égaler. Le visage est en quelque sorte intégré à chaque résultat.
Sur PicassoIA, p-image-lora et flux-dev-lora prennent tous deux en charge le chargement direct de LoRA de personnage personnalisés pour la génération.
Méthode 3 : ControlNet avec référence de visage
ControlNet extrait les informations structurelles d’une image de référence et s’en sert pour guider le résultat. Les modes ControlNet spécifiques au visage capturent les repères faciaux (position des yeux, arête du nez, contour de la mâchoire) et obligent le modèle à reproduire cette structure.
Combiné à un LoRA de personnage, ControlNet vous donne un contrôle simultané sur l’identité et la structure du corps. Des modèles comme Realvisxl v3 Multi ControlNet LoRA et SDXL Multi ControlNet LoRA permettent d’empiler plusieurs signaux de contrôle dans une seule génération.
Les meilleurs modèles pour une génération NSFW à visage cohérent
Tous les modèles ne gèrent pas la génération à visage verrouillé de la même façon. Voici comment les meilleurs modèles de PicassoIA se comparent pour ce cas d’usage précis.
Flux Kontext Pro et Max
Conçus spécifiquement pour les modifications qui préservent l’identité. Flux Kontext Pro et Flux Kontext Max ont été pensés dès le départ autour de la notion d’édition cohérente de personnages à travers plusieurs scènes.
| Caractéristique | Flux Kontext Pro | Flux Kontext Max |
|---|
| Cohérence du visage | Excellente | Exceptionnelle |
| Résolution de sortie | Élevée | Très élevée |
| Vitesse de génération | Rapide | Modérée |
| Idéal pour | Itération et tests | Rendus finaux de qualité |
Realvisxl v3.0 Turbo
Realvisxl v3.0 Turbo est l’un des meilleurs modèles de base photoréalistes pour le travail de personnages NSFW. Son rendu de peau hyperréaliste se marie très bien avec les flux de travail à visage verrouillé. Lorsqu’un signal de LoRA ou de ControlNet facial est appliqué, ce modèle produit une texture de peau, un détail capillaire et un éclairage du visage parmi les plus convaincants de tous les modèles disponibles.
Flux 1.1 Pro Ultra
Flux 1.1 Pro Ultra excelle dans la création de personnages de base à haute fidélité. Utilisez-le pour générer votre image de référence canonique avant de charger cette référence dans Flux Kontext pour des variations de scène. La qualité d’image à la résolution native de ce modèle est exceptionnelle pour établir un personnage.
SDXL avec ControlNet
SDXL combiné à SDXL Multi ControlNet LoRA offre aux créateurs qui disposent déjà de LoRA de personnage entraînés sur SDXL une voie directe vers une génération à visage cohérent à grande échelle. La prise en charge du multi-ControlNet permet d’appliquer simultanément le contrôle du visage, de la pose et de la profondeur.
Construire un LoRA de personnage : ce qu’il faut
Si vous voulez une cohérence de visage à toute épreuve sur des centaines d’images au fil du temps, un LoRA de personnage entraîné est le bon investissement. Voici comment se déroule le processus.
Sélectionner les images d’entraînement
La qualité de votre LoRA dépend entièrement de vos données d’entraînement. Utilisez ces critères :
- 15 à 25 images au minimum pour un LoRA de personnage solide, 30 à 50 pour un résultat de qualité professionnelle
- Variété d’éclairage : incluez des images aux conditions d’éclairage différentes, pas seulement des mises en place de studio identiques
- Variété d’angles : de face, trois quarts, profil, légèrement au-dessus, légèrement en dessous
- Variété d’expressions : neutre, souriant, sérieux, regard détourné
- Visage bien visible : chaque image doit montrer clairement le visage, sans flou marqué, sans occlusion ni sursaturation
Charger et utiliser votre LoRA sur PicassoIA
Une fois entraîné, chargez votre LoRA de personnage dans p-image-lora ou flux-dev-lora sur PicassoIA. Le paramètre critique à maîtriser est le poids du LoRA :
| Plage de poids | Effet |
|---|
| 0,3 à 0,5 | Influence douce, laisse place à une variation créative du visage |
| 0,6 à 0,8 | Verrouillage fort du visage, plage recommandée |
| 0,9 à 1,0 | Contrôle rigide, peut introduire des artefacts |
Commencez à 0,75 et ajustez selon vos premières sorties. La plupart des LoRA de personnage donnent les meilleurs résultats entre 0,65 et 0,80. Au-delà de 0,9, on voit souvent apparaître des artefacts de texture de peau et des traits sursaturés.
💡 Règle essentielle avec un LoRA : arrêtez de décrire le visage dans votre prompt textuel. Ajouter des descriptions de visage en plus d’un LoRA crée des signaux contradictoires. Laissez le LoRA gérer tout le travail sur le visage. Réservez votre prompt textuel à la tenue, à l’environnement, à l’éclairage et à la pose.
ControlNet pour la pose et la structure
Le contrôle de l’identité et celui de la pose sont deux problèmes distincts. Le LoRA verrouille le visage. ControlNet verrouille la position du corps et la composition structurelle.
Contrôle OpenPose
ControlNet OpenPose extrait un squelette filaire d’une image de référence et oblige le modèle à produire le personnage dans cette position corporelle précise. Combiné à un LoRA de visage, vous contrôlez entièrement qui apparaît sur l’image et comment il est positionné.
C’est essentiel pour construire des récits NSFW en plusieurs scènes, où votre personnage doit apparaître dans des poses précises et prédéfinies, dans des décors différents.
Contrôle de la structure du visage
Les modes ControlNet spécifiques au visage capturent les positions des repères faciaux d’une référence et les imposent dans le résultat. L’écartement des yeux, la place du nez, la position de la bouche et le contour du visage sont tous transférés de la référence à la génération. Cela fonctionne particulièrement bien lorsque vous devez faire correspondre des angles de visage exacts d’une prise de vue à l’autre.
Realvisxl v3 Multi ControlNet LoRA permet d’empiler simultanément le ControlNet facial et OpenPose, vous donnant un contrôle structurel complet sur chaque génération d’une série.
Un flux de travail pratique, de la première image à la série complète
Voici le processus exact, étape par étape, pour construire une série NSFW à personnage au visage cohérent sur PicassoIA.
Étape 1 : créer la référence canonique
Ouvrez Flux Kontext Pro ou Flux 1.1 Pro Ultra. Rédigez un prompt détaillé centré sur le visage et l’identité du personnage. Générez plusieurs variations et sélectionnez-en une comme référence canonique. Notez le numéro de seed. Cette image sert d’ancre pour tout le reste.
Étape 2 : choisir votre méthode de cohérence
| Méthode | Idéal pour | Configuration requise |
|---|
| Flux Kontext Pro/Max | Itérations rapides, changements de scène | Aucune |
| Chargement de LoRA | Grands lots, cohérence profonde | Modérée |
| Multi ControlNet + LoRA | Précision structurelle maximale | Élevée |
| Face Swap AI | Remplacements ponctuels | Minimale |
Étape 3 : générer des variations de scène
Avec Flux Kontext Pro, fournissez votre image de référence canonique et utilisez des instructions courtes et claires qui décrivent uniquement ce qui change :
- « Changer la tenue pour un body en satin rouge, garder le visage identique »
- « Placer la scène dans une chambre à la lumière chaude du soir ambré, même personnage »
- « Pose assise jambes croisées, arrière-plan de terrasse extérieure, préserver le visage »
Le modèle lit le visage dans votre référence et l’applique automatiquement. Vous ne contrôlez que ce qui change.
Étape 4 : upscaler et finaliser
Une fois votre série de scènes générée, passez chaque image dans les outils de super-résolution de PicassoIA pour faire ressortir le détail complet de la texture de peau, des mèches de cheveux et du tissage des tissus, en 2x ou 4x. Les techniques de verrouillage du visage préservent bien l’identité à la résolution de base ; les détails fins apparaissent lors de l’upscaling.
💡 Générez toujours d’abord à la résolution de base pour confirmer la cohérence du visage, puis upscalez. Upscaler avant de confirmer la cohérence fait perdre du temps si le visage n’est pas juste.
Les erreurs qui cassent la cohérence du visage
La plupart des échecs de verrouillage du visage viennent d’une poignée d’erreurs récurrentes. Évitez-les en particulier.
Mélanger des signaux contradictoires
Lorsque vous utilisez un LoRA ou une image de référence pour contrôler le visage, supprimez toutes les descriptions de visage du prompt textuel. Ajouter « visage ovale, yeux en amande » à une génération guidée par LoRA crée un conflit de signaux. Le modèle tente de satisfaire simultanément le visage du LoRA et le visage décrit par le texte. Le résultat est un compromis moyenné et flou qui ne ressemble ni à l’un ni à l’autre.
Séparez clairement les rôles : le LoRA ou la référence gère le visage, le texte gère tout le reste.
Changer de modèle en cours de série
Flux Dev et Stable Diffusion 3.5 Large interprètent le même personnage différemment au niveau fondamental. Changer de modèle d’une image à l’autre dans une série garantit une incohérence visuelle, même si le verrouillage du visage fonctionne techniquement. Choisissez un modèle pour une série de personnages et restez-y.
Négliger la cohérence de l’éclairage
La cohérence du visage ne se résume pas à la structure osseuse. L’éclairage modifie considérablement la forme perçue d’un visage. Un éclairage latéral dur venant de la gauche crée des ombres totalement différentes d’une diffusion frontale douce, faisant paraître le même visage comme deux personnes différentes, même avec un verrouillage parfait.
Établissez une signature lumineuse pour votre personnage et incluez-la dans chaque prompt :
- Précisez la direction de la source lumineuse : « lumière chaude du matin venant du haut à gauche »
- Précisez la qualité des ombres : « ombres douces et diffuses, sans contraste marqué »
- Précisez la température de couleur : « lumière du jour neutre à 5500 K »
Un éclairage cohérent fait une différence perceptuelle plus grande que la plupart des créateurs ne le pensent.
Un poids de LoRA trop faible pour la mauvaise raison
Certains créateurs baissent le poids du LoRA pour éviter les effets de sursaturation, mais descendre sous 0,55 fait complètement céder la cohérence du visage. La zone idéale pour la plupart des LoRA de personnage se situe entre 0,65 et 0,80. Si vous observez une sursaturation, le problème vient généralement de la qualité des données d’entraînement ou d’un poids trop élevé, au-dessus de 0,85, et non de la plage de poids elle-même.
Le face swap comme alternative rapide
Lorsque l’entraînement d’un LoRA est peu pratique, Face Swap AI est un raccourci direct. Générez librement la scène souhaitée, puis appliquez un échange de visage pour remplacer le visage de la sortie par celui de votre personnage cible.
Cela fonctionne particulièrement bien pour :
- Les demandes ponctuelles où entraîner un LoRA représente un effort disproportionné
- L’application d’un visage de référence réel sur un corps et une tenue entièrement générés par IA
- Les contenus rapides qui n’ont pas vocation à faire partie d’une série de personnages en cours
L’outil Face Swap AI de PicassoIA gère le mélange réaliste des teintes de peau et la cohérence de l’éclairage à la frontière du visage, pour que le remplacement paraisse naturel plutôt que composé.
Maintenir la cohérence sur de longues séries
Les créateurs NSFW professionnels doivent souvent maintenir le même personnage sur des dizaines, voire des centaines d’images, pendant des semaines ou des mois. Quelques pratiques supplémentaires rendent cela durable.
Constituer une fiche de référence
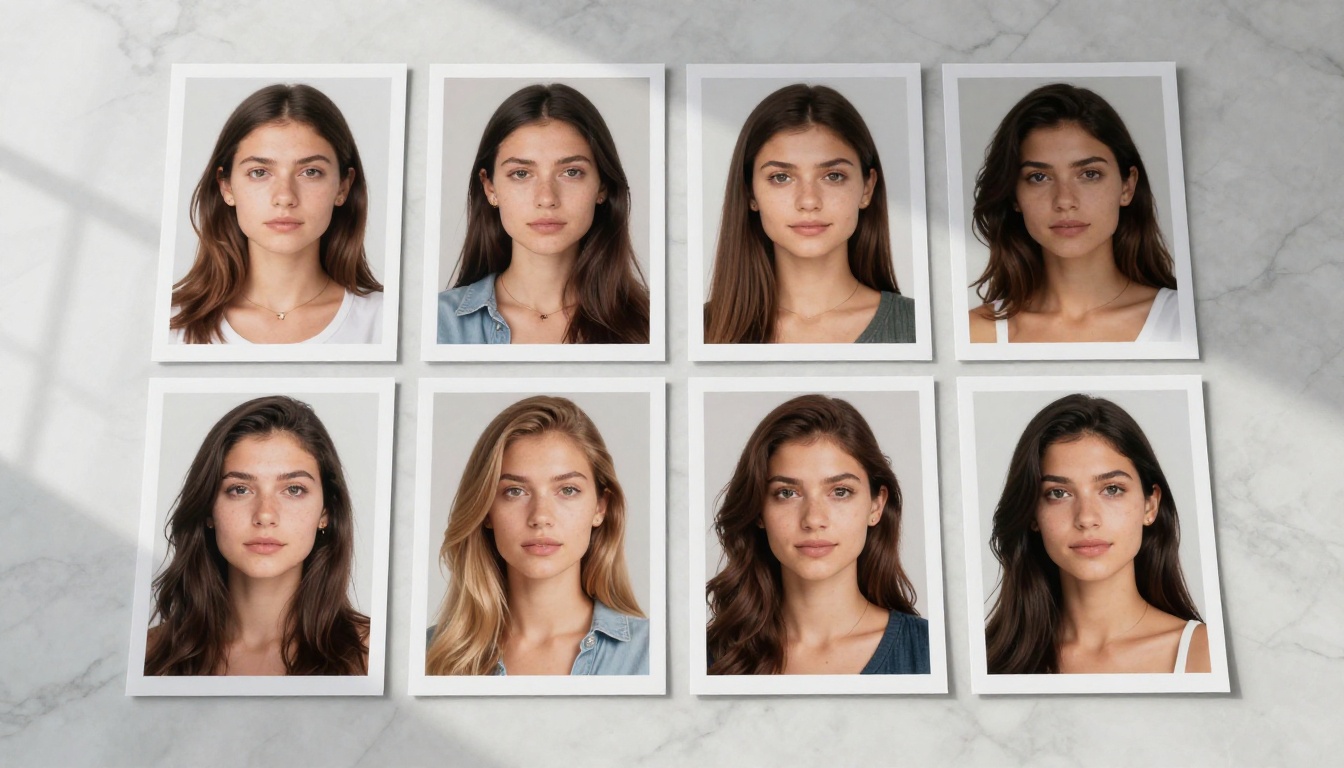
Une fois votre personnage canonique établi, générez une petite fiche de référence : le même visage sous plusieurs angles (de face, trois quarts gauche, trois quarts droit, profil), avec un éclairage neutre et constant. Cette fiche devient votre matériau source pour toutes les futures références de visage en ControlNet et vous offre plusieurs angles pour différentes compositions de scène.
Tout documenter
Tenez un dossier de personnage qui enregistre :
- Le modèle utilisé pour la référence canonique
- Le seed utilisé pour la génération canonique
- Le nom du fichier LoRA et le réglage du poids
- La description de l’éclairage de référence utilisée sur toute la série
- Des exemples de prompts ayant donné une bonne cohérence
Recréer un personnage de mémoire après plusieurs semaines d’interruption est bien plus difficile que d’ouvrir un document d’une page où chaque paramètre est noté.
Utiliser l’inpainting pour corriger le visage
Lorsqu’une génération de scène produit une excellente composition mais un visage légèrement incohérent, ne régénérez pas toute l’image. Utilisez l’inpainting pour sélectionner uniquement la zone du visage et la régénérer avec les paramètres complets de verrouillage du visage, en laissant le reste de l’image intact. Cela fait gagner beaucoup de temps lorsque l’arrière-plan, la pose et l’éclairage sont déjà corrects.
Commencez à construire votre personnage sur PicassoIA
Tout ce qui est décrit dans cet article est disponible sur PicassoIA, sans avoir à gérer des outils séparés, des environnements d’entraînement ou des configurations techniques. La plateforme réunit 91 modèles de texte vers image, dont Flux Kontext Pro, Flux Kontext Max, p-image-lora, flux-dev-lora, Realvisxl v3 Multi ControlNet LoRA et SDXL Multi ControlNet LoRA, avec l’échange de visage, l’inpainting et la super-résolution au même endroit.
Le moyen le plus rapide de voir le verrouillage du visage en action est d’ouvrir Flux Kontext Pro, de générer un personnage qui vous plaît, puis d’utiliser cette image pour créer trois ou quatre variations de scène avec des tenues et des décors différents. La différence avec une génération classique par texte seul saute immédiatement aux yeux.
Si vous voulez un contrôle plus poussé sur un personnage au long cours, chargez un LoRA entraîné dans flux-dev-lora ou essayez le pipeline multi-ControlNet avec Realvisxl v3 Multi ControlNet LoRA pour une précision structurelle totale. Dans les deux cas, votre personnage cesse de dériver et reste exactement celui que vous avez construit.


